
พื้นฐาน AI
การถดถอยเชิงเส้นคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การถดถอยเชิงเส้น โมเดลเป้าหมายต่อเนื่องเป็นการรวมเชิงเส้นของหนึ่งหรือหลายคุณลักษณะอินพุต ใช้สำหรับการทำนาย การประมาณค่า และเป็นฐานที่โปร่งใสเพื่อทำความเข้าใจว่ารุ่นที่ซับซ้อนกว่าเพิ่มคุณค่าอย่างมีนัยสำคัญหรือไม่
คำว่า ตัวแปรอิสระ และ ตัวแปรตาม บรรยายบทบาทในโมเดล ไม่ได้หมายถึงสาเหตุและผลลัพธ์ที่พิสูจน์แล้ว การถดถอยสามารถระบุความสัมพันธ์ได้แม้ว่าอคติการคัดเลือก ความเอนเอียงของการวัด หรือการสาเหตุย้อนกลับอาจอธิบายความสัมพันธ์นั้น
ประเด็นสำคัญ
- เป้าหมาย y ถูกโมเดลจากคุณลักษณะอินพุต X; เวอร์ชันเก่าของบทความได้สลับฉลากเหล่านี้ในคำอธิบายสูตรหนึ่งข้อ
- วิธีการค่าสัมประสิทธิ์แบบ Ordinary Least Squares (OLS) ลดผลรวมของกำลังสองของส่วนเหลือ
- การวินิจฉัยส่วนเหลือและสมมติฐานมีความสำคัญต่อการอ้างอิงและความไม่แน่นอน
- การทำ regularization แบบ Ridge และ Lasso ช่วยเมื่อมีตัวทำนายจำนวนมากหรือมีความสัมพันธ์กัน
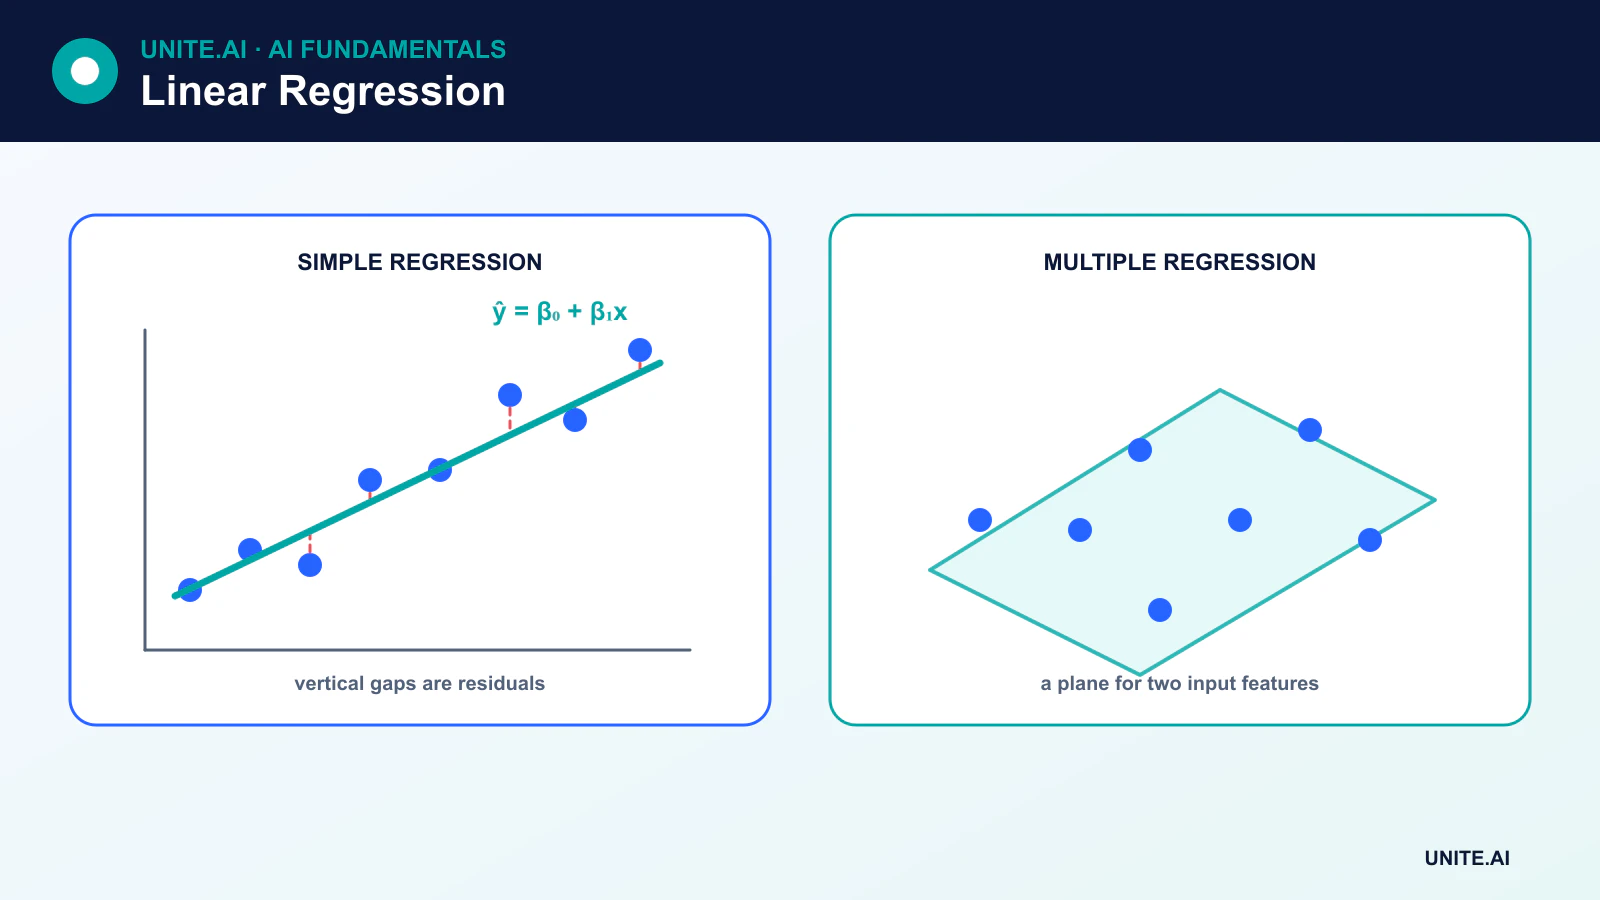
การถดถอยเชิงเส้นแบบง่าย
เมื่อมีคุณลักษณะหนึ่ง ตัวโมเดลคือ:
ŷ = β₀ + β₁x
β₀ คือจุดตัดแกนและ β₁ คือความชัน ส่วนเหลือสำหรับการสังเกต i คือ yᵢ - ŷᵢ วิธี Ordinary Least Squares (OLS) เลือกสัมประสิทธิ์ที่ทำให้ผลรวมของกำลังสองของส่วนเหลือน้อยที่สุด
ความชันประมาณการการเปลี่ยนแปลงคาดหวังของเป้าหมายที่สัมพันธ์กับการเปลี่ยนแปลงหนึ่งหน่วยของคุณลักษณะภายใต้โมเดลที่ฟิตแล้ว ไม่ควรอธิบายเป็นผลกระทบเชิงสาเหตุ เว้นแต่การออกแบบการศึกษาและสมมติฐานจะสนับสนุนการระบุเชิงสาเหตุ
การถดถอยเชิงเส้นหลายตัวแปร
เมื่อมี p คุณลักษณะ:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
แต่ละสัมประสิทธิ์จะตีความโดยคำนึงถึงคุณลักษณะอื่นที่รวมอยู่ การถดถอยหลายตัวแปรสามารถรวมตัวแปรเชิงประเภทผ่านการเข้ารหัส พหุนาม และปฏิสัมพันธ์ได้ แม้จะมีคุณลักษณะแปลงเช่น x² อยู่ก็ตาม โมเดลยังคงเป็น “เชิงเส้น” เพราะเป็นเชิงเส้นต่อสัมประสิทธิ์
สมมติฐานและการวินิจฉัย
สำหรับการทำนาย คำถามหลักคือโมเดลทั่วไปได้ดีแค่ไหน สำหรับการทดสอบสัมประสิทธิ์แบบคลาสสิกและช่วงเชื่อมั่น สมมติฐานเพิ่มเติมจึงมีความสำคัญ:
- ความเป็นเชิงเส้น: ค่าเฉลี่ยตามเงื่อนไขถูกแทนด้วยรูปแบบเชิงเส้นที่เลือก
- ข้อผิดพลาดอิสระหรือโมเดลอย่างถูกต้อง: การสังเกตซ้ำ กลุ่ม การกระจายเชิงพื้นที่ หรือเชิงเวลาอาจต้องโครงสร้างข้อผิดพลาดที่แตกต่าง
- ความแปรปรวนของข้อผิดพลาดคงที่: ความแปรปรวนที่ไม่สม่ำเสมอ (heteroscedasticity) มีผลต่อค่าเบี่ยงเบนมาตรฐานและการประเมินความไม่แน่นอน
- ความสัมพันธ์หลายตัวแปรจำกัด: ตัวทำนายที่สัมพันธ์กันอย่างสูงทำให้สัมประสิทธิ์แต่ละตัวไม่เสถียร
- การกระจายของส่วนเหลือ: ความเป็นปกติสำคัญต่อการอ้างอิงตัวอย่างขนาดเล็กบางกรณี ไม่ได้หมายความว่าทุกคุณลักษณะต้องเป็นปกติ
กราฟส่วนเหลือ, มาตรการ leverage และ influence, รวมถึงการตรวจสอบโดยผู้เชี่ยวชาญ สามารถระบุค่าผิดปกติ, ความไม่เป็นเชิงเส้น, การเปลี่ยนแปลงความแปรปรวน หรือการสังเกตที่มีอิทธิพลต่อการฟิตได้
การประเมินการทำนาย
- Mean absolute error (MAE) เฉลี่ยขนาดส่วนเหลือแบบสัมบูรณ์
- Mean squared error (MSE) ให้ความสำคัญกับข้อผิดพลาดใหญ่กว่า
- Root mean squared error (RMSE) นำข้อผิดพลาดกำลังสองกลับสู่หน่วยของเป้าหมาย
- R² เปรียบเทียบความแปรปรวนของส่วนเหลือกับฐานคงที่บนข้อมูลที่ประเมิน
R² ไม่ใช่ความแม่นยำ ไม่ได้ยืนยันสาเหตุ และอาจเป็นค่าลบบนข้อมูลทดสอบ การตรวจสอบควรสอดคล้องกับสภาพการทำนายจริง รวมถึงการแบ่งข้อมูลตามเวลา หรือกลุ่มเมื่อจำเป็น
Ridge, lasso, และ elastic net
Ridge regression เพิ่มโทษ L2 ที่ทำให้สัมประสิทธิ์หดตัวและทำให้ตัวทำนายที่สัมพันธ์กันเสถียรขึ้น Lasso เพิ่มโทษ L1 และสามารถทำให้สัมประสิทธิ์เป็นศูนย์ได้ Elastic net ผสานทั้งสอง วิธีเหล่านี้มักต้องการการสเกลคุณลักษณะให้สอดคล้องก่อนนำไปเปรียบเทียบโทษ
การทำ regularization แนะนำอคติเพื่อแลกกับความแปรปรวนที่ต่ำลงและสามารถลด การ overfitting ความแข็งแรงของโทษเลือกโดยการตรวจสอบความถูกต้อง ไม่ใช่ชุดทดสอบสุดท้าย
เมื่อการถดถอยเชิงเส้นไม่ใช่เครื่องมือที่เหมาะสม
โมเดลเชิงเส้นอาจล้มเหลวเมื่อความสัมพันธ์เป็นเชิงไม่เชิงเส้นอย่างรุนแรง, ข้อผิดพลาดขึ้นกับค่าก่อนหน้า, การกระจายของเป้าหมายต้องการการโมเดลเฉพาะ, หรือค่าผิดปกติไม่กี่ค่าเป็นสาเหตุของการสูญเสียกำลังสอง ต้นไม้ตัดสินใจ, โมเดลเชิงเส้นทั่วไป, โมเดลเชิงเวลา, การถดถอยแบบทนทาน หรือวิธีการไม่เชิงเส้นอาจเหมาะสมกว่า
แม้โมเดลซับซ้อนจะทำได้ดีกว่า การถดถอยเชิงเส้นยังคงเป็นฐานสำคัญ หากระบบขนาดใหญ่ไม่สามารถทำผลงานดีกว่าได้อย่างสม่ำเสมอ ความซับซ้อนที่เพิ่มขึ้นอาจไม่คุ้มค่า
สมมติฐานของโมเดล, การประมาณค่า, และการวินิจฉัย
การถดถอยเชิงเส้นโมเดลค่าเฉลี่ยตามเงื่อนไขของผลลัพธ์เชิงตัวเลขเป็นการบวกค่าคงที่กับตัวทำนายที่มีน้ำหนัก วิธี Ordinary Least Squares เลือกสัมประสิทธิ์ที่ทำให้ส่วนเหลือกำลังสองน้อยที่สุด สัมประสิทธิ์บรรยายการเปลี่ยนแปลงผลลัพธ์ที่คาดหวังเมื่อเปลี่ยนตัวทำนายหนึ่งหน่วยโดยที่ตัวแปรอื่นคงที่ตามโมเดลที่ระบุ นี่เป็นความสัมพันธ์ เว้นแต่สมมติฐานการระบุสาเหตุและการออกแบบการศึกษาอธิบายมากกว่านั้น หน่วย, การเข้ารหัส, การแปลง, ปฏิสัมพันธ์, และกลุ่มอ้างอิงกำหนดการตีความ ดังนั้นสัมประสิทธิ์ที่ไม่มีพจนานุกรมข้อมูลจึงไม่สมบูรณ์
การอ้างอิงแบบคลาสสิกพึ่งพาสมมติฐานเกี่ยวกับรูปแบบฟังก์ชัน, ข้อผิดพลาดอิสระ, ความแปรปรวนคงที่, และการกระจายของข้อผิดพลาดสำหรับการทดสอบและช่วงเชื่อมั่นบางประเภท กราฟส่วนเหลือเทียบกับค่าฟิตเปิดเผยความไม่เป็นเชิงเส้นหรือ heteroscedasticity; กราฟ Q–Q ประเมินพฤติกรรมหาง; มาตรการ leverage และ influence ระบุการสังเกตที่มีอิทธิพลต่อการประมาณค่า ตัวทำนายที่สัมพันธ์กันเพิ่มความไม่แน่นอนและทำให้สัมประสิทธิ์แต่ละตัวไม่เสถียร แม้ว่าการทำนายอาจยังคงเพียงพอ การใช้ค่าเบี่ยงเบนมาตรฐานที่ทนทาน, การแปลง, spline, โครงสร้างเชิงลำดับชั้น, หรือโมเดลอื่นอาจจำเป็นแทนการลบข้อมูลที่ไม่สะดวก
Regularization, evaluation, and responsible use
Ridge regression หดสัมประสิทธิ์ด้วยโทษ L2, ในขณะที่ lasso สามารถตั้งค่าบางค่าเป็นศูนย์ด้วยโทษ L1; elastic net ผสานทั้งสอง ควรทำมาตรฐานตัวทำนายเมื่อสเกลโทษต้องเปรียบเทียบได้และเลือกความแข็งแรงโดยการตรวจสอบความถูกต้องหรือ cross‑validation ประเมิน mean absolute error, root mean squared error, การกระจายส่วนเหลือ, การปรับเทียบตามช่วง, และความไม่แน่นอน พร้อมกับการแบ่งข้อมูลตามเวลา หรือกลุ่มที่สะท้อนการใช้งาน เปรียบเทียบกับ baseline ค่าเฉลี่ยและทางเลือกไม่เชิงเส้น แต่ยังคงใช้โมเดลเชิงเส้นเมื่อความโปร่งใสและเสถียรภาพมีคุณค่า
การคาดการณ์เกินช่วงของตัวทำนายที่สังเกตได้ตามเส้นที่ฟิตโดยไม่มีหลักฐานอาจอันตราย ควรตรวจสอบช่วงค่าคุณลักษณะ, การขาดข้อมูล, ส่วนเหลือ, และข้อผิดพลาดของกลุ่มย่อยในระบบการผลิต ช่วงคาดการณ์อธิบายความไม่แน่นอนของผลลัพธ์แต่ละรายการและกว้างกว่าช่วงความเชื่อมั่นของค่าเฉลี่ย; ทั้งสองต้องอาศัยสมมติฐาน หลีกเลี่ยงการควบคุมตัวแปรที่นำไปสู่อคติสาเหตุเมื่อเป้าหมายคือการประมาณผลกระทบ การถดถอยเชิงเส้นเป็นเครื่องมือที่แม่นยำสำหรับความสัมพันธ์ที่กำหนด ไม่ได้เป็นการรับประกันว่าทุกอย่างเป็นเชิงเส้นหรือว่าตัวสัมประสิทธิ์เป็นการแทรกแซง
Worked example: estimating delivery time
ทีมโลจิสติกส์โมเดลระยะเวลาการจัดส่งจากระยะทาง, ระดับการให้บริการ, ภูมิภาค, วันทำงาน, และสภาพอากาศที่ทราบ พวกเขาตรวจสอบรูปแบบส่วนเหลือที่ไม่เป็นเชิงเส้นและเพิ่ม spline และปฏิสัมพันธ์ที่มีเหตุผล แทนการถือสมการเชิงเส้นเป็นกฎฟิสิกส์แบบตรงๆ กลุ่มผู้ให้บริการและเส้นทางกำหนดการแบ่ง validation Mean absolute error, tail error, การครอบคลุมช่วง, และอคติระบบถูกรายงาน การจัดส่งที่ยกเลิกและข้อมูลที่บันทึกหลังการมาถึงถูกตัดออกหรือโมเดลอย่างชัดเจน
สัมประสิทธิ์ถูกบันทึกเป็นหน่วยและตรวจสอบความไม่เสถียรภายใต้ตัวทำนายที่สัมพันธ์กัน โมเดลปฏิเสธการคาดการณ์เกินช่วงระยะทางและภูมิภาคที่ตรวจสอบแล้ว ช่วงคาดการณ์มาพร้อมกับการประมาณค่าและการจัดตารางต่อไปใช้ความไม่แน่นอนนั้น การตรวจสอบติดตามช่วงค่าคุณลักษณะ, ส่วนเหลือ, การครอบคลุมช่วง, และอคติหลังการเปลี่ยนแปลงเครือข่าย การอ้างอิงเชิงสาเหตุเกี่ยวกับผู้ให้บริการหรือสภาพอากาศไม่ได้ทำจากสัมประสิทธิ์ที่ทำนาย; จำเป็นต้องมีการทดลองเชิงปฏิบัติหรือการระบุที่แข็งแรงเพื่อสนับสนุนการแทรกแซง
Implementation evidence and operational readiness
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้าง baseline ที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับจูน ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูดใจ
ก่อนเปิดใช้งานมอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการถอดถอน ใช้การเปิดตัวแบบขั้นเป็นขั้น, เก็บสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการฉีดความล้มเหลวโดยเจตนา Telemetry การทำงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและเจ้าของการตอบสนอง จากนั้นทบทวนหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงที่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่บำรุงรักษาต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
Frequently asked questions
Does linear regression require only one input variable?
ไม่ การถดถอยแบบง่ายมีตัวทำนายหนึ่งตัว ในขณะที่การถดถอยเชิงเส้นหลายตัวแปรสามารถใช้หลายตัวแปรเชิงตัวเลข, ตัวแปรเชิงประเภทที่เข้ารหัส, ตัวแปรที่แปลง, และปฏิสัมพันธ์ได้
Can linear regression prove causation?
ไม่ การตีความเชิงสาเหตุต้องอาศัยการออกแบบการวิจัยที่เชื่อถือได้และสมมติฐานเกี่ยวกับการคัดกรอง, การคัดเลือก, การวัด, และการแทรกแซง สัมประสิทธิ์ที่ใช้เพื่อการทำนายเพียงอย่างเดียวอธิบายความสัมพันธ์ในโมเดลที่ฟิตแล้วเท่านั้น
Primary references












