
พื้นฐาน AI
KNN (K-Nearest Neighbors) คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
K-nearest neighbors (KNN) ทำนายผลลัพธ์จากตัวอย่างการฝึกที่มีป้ายกำกับและอยู่ใกล้จุดสอบถามที่สุด สำหรับการจำแนกประเภท เพื่อนบ้านจะลงคะแนนให้กับคลาส ส่วนการถดถอย ค่าตัวเป้าหมายของพวกเขาจะถูกเฉลี่ยหรือรวมกันในรูปแบบอื่น
KNN เป็นวิธีเชิงตัวอย่างที่ไม่ทำการทั่วไป: การฝึกส่วนใหญ่เพียงเก็บตัวอย่างการฝึกและดัชนีการค้นหาแบบเลือกได้ ซึ่งไม่ได้ทำให้ไม่ต้องมีการแบ่งข้อมูลเป็นชุดฝึก, validation, และทดสอบ การประเมินบนข้อมูลที่ถือเป็นชุดทดสอบเป็นสิ่งจำเป็นสำหรับการเลือก k, เมตริกระยะทาง, การประมวลผลคุณลักษณะ, และกฎการลงคะแนน
ประเด็นสำคัญ
- KNN ทำนายแบบท้องถิ่น; ไม่ได้แบ่งชุดข้อมูลเป็นกลุ่มก่อน
- การสเกลคุณลักษณะเป็นสิ่งสำคัญเพราะระยะทางกำหนดว่าตัวอย่างใดถือเป็นเพื่อนบ้าน
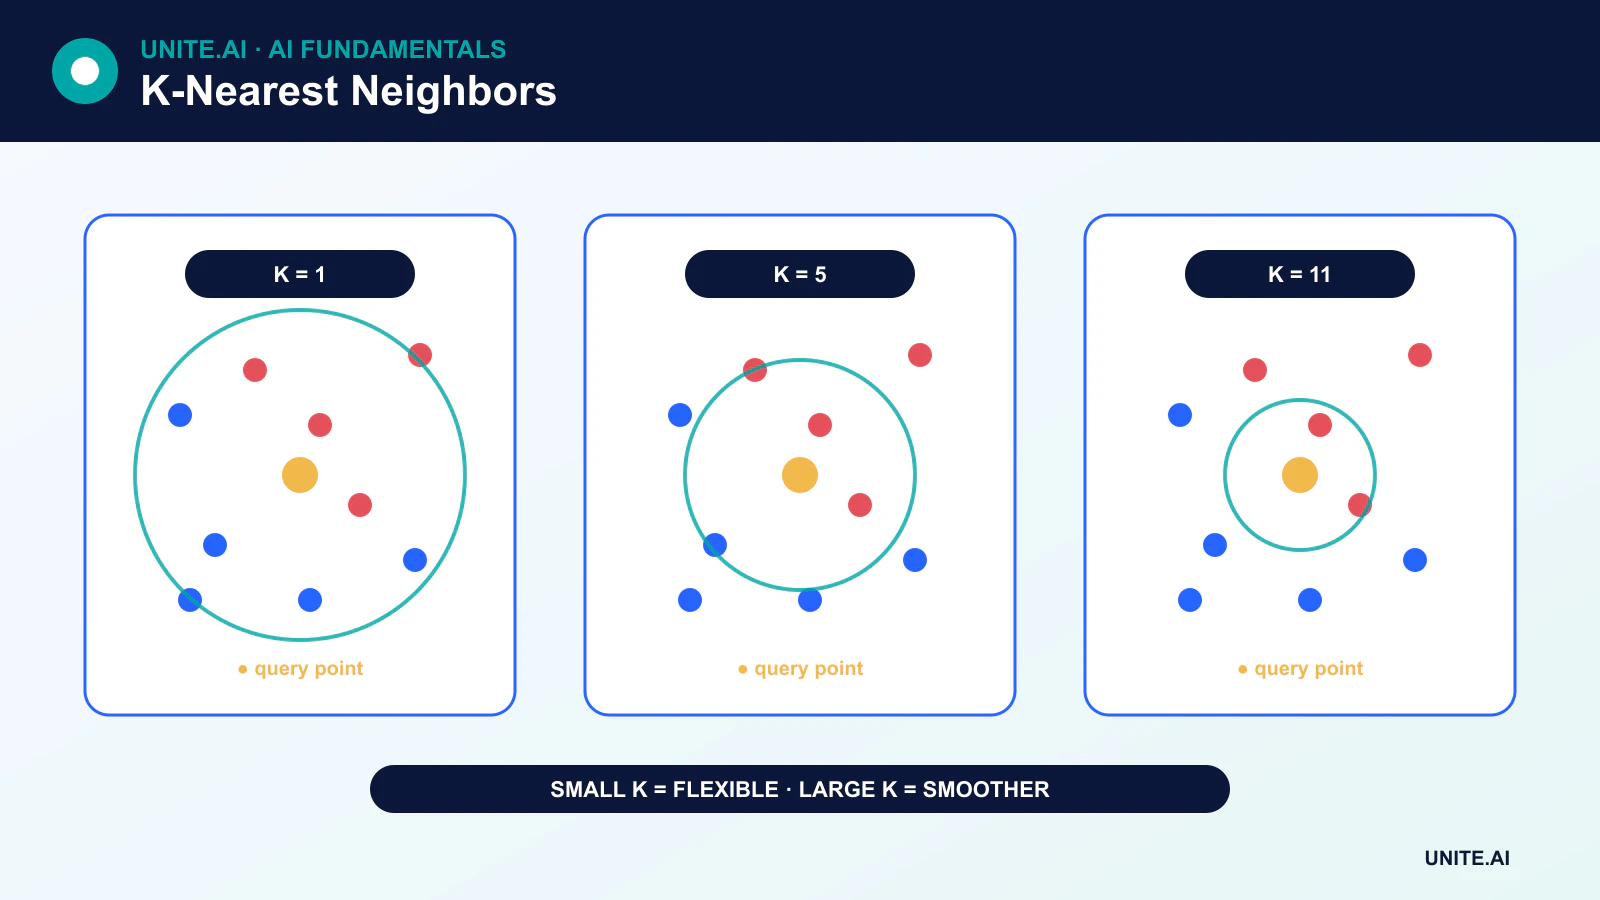
- k เล็กอาจทำให้เกิดเสียงรบกวน, ในขณะที่ k ใหญ่อาจทำให้โครงสร้างท้องถิ่นถูกทำให้เรียบ
- มิติสูง, คุณลักษณะที่ไม่เกี่ยวข้อง, ความไม่สมดุลของคลาส, และการค้นหาช้า สามารถจำกัดประสิทธิภาพได้
วิธีการทำงานของการจำแนกประเภทด้วย KNN
- แสดงผลสอบถามและตัวอย่างการฝึกในพื้นที่คุณลักษณะเดียวกัน
- คำนวณระยะทางจากสอบถามไปยังตัวอย่างการฝึก
- เลือกตัวอย่าง k ที่ใกล้ที่สุด
- ทำนายคลาสส่วนใหญ่หรือใช้การลงคะแนนแบบถ่วงน้ำหนักตามระยะทาง
การลงคะแนนแบบถ่วงน้ำหนักให้เพื่อนบ้านที่ใกล้เคียงมีอิทธิพลมากกว่า การเสมอคะแนนต้องมีกฎที่ระบุไว้, และเพื่อนบ้านที่อยู่ห่างเท่ากันแต่มีป้ายกำกับต่างกันอาจทำให้ผลลัพธ์ขึ้นกับลำดับหรือรายละเอียดการทำงานของระบบ
การถดถอยด้วย KNN
สำหรับการถดถอย การทำนายโดยทั่วไปจะเป็นค่าเฉลี่ยของเป้าหมายของเพื่อนบ้าน การถ่วงน้ำหนักตามระยะทางสามารถลดอิทธิพลของการสังเกตที่อยู่ไกลออกไปได้ เมื่อเป้าหมายท้องถิ่นมีค่าผิดปกติ มัธยฐานหรือการรวมแบบทนทานอาจเป็นประโยชน์
เมตริกระยะทาง
ระยะทางยูคลิดเป็นที่นิยมสำหรับคุณลักษณะต่อเนื่อง, ระยะทางแมนฮัตตันเป็นผลรวมของความแตกต่างเชิงสัมบูรณ์, และระยะทางโคไซน์เน้นที่ทิศทางมากกว่าขนาด. เมตริกอื่น ๆ ใช้กับข้อมูลแบบไบนารี, ประเภท, ภูมิศาสตร์, ลำดับ, หรือการฝังที่เรียนรู้
การเรียก KNN ว่า “ไม่พารามิเตอร์” หมายความว่าไม่สมมติรูปแบบฟังก์ชันที่มีมิติจำกัดคงที่สำหรับเส้นแบ่งการตัดสินใจ แต่ยังคงสมมติว่าการแทนค่าและเมตริกที่เลือกทำให้จุดที่อยู่ใกล้กันมีความสัมพันธ์กัน
ทำไมการสเกลจึงสำคัญ
หากคุณลักษณะหนึ่งมีช่วงจาก 0 ถึง 1 และอีกคุณลักษณะหนึ่งจาก 0 ถึง 100,000 ระยะทางยูคลิดทั่วไปจะถูกครอบงำโดยคุณลักษณะที่สอง การทำมาตรฐาน, การทำให้เป็นปกติ, หรือการแปลงเฉพาะโดเมนควรฝึกบนส่วนฝึกและนำไปใช้กับข้อมูล validation, test, และการผลิต
คุณลักษณะที่ไม่เกี่ยวข้องยังทำให้เพื่อนบ้านบิดเบี้ยว การเลือกคุณลักษณะ, การลดมิติ, หรือการแทนค่าที่เรียนรู้ได้สามารถช่วยได้, แต่การเลือกแต่ละครั้งต้องได้รับการตรวจสอบโดยไม่มีการรั่วไหลของข้อมูล
การเลือก k
เมื่อ k = 1 โมเดลอาจตามเสียงรบกวนและตัวอย่างที่ป้ายกำกับผิดพลาด เมื่อ k เพิ่มขึ้น การทำนายจะเรียบขึ้นและน้อยความไวต่อจุดเดียว หาก k มากเกินไป คลาสหรือบริเวณที่อยู่ไกลอาจครอบงำและโมเดลจะขาดการเรียนรู้
เลือก k ผ่านการทำ cross-validation บนข้อมูลฝึก สำหรับการจำแนกประเภทแบบสองคลาส k ที่เป็นเลขคี่จะลดการเสมอคะแนนแต่ไม่ขจัดได้เลย น้ำหนักคลาส, การแบ่งแบบ stratified, การเลือกเกณฑ์, และเมตริกที่เหมาะสมมีความสำคัญเมื่อคลาสไม่สมดุล
คำสาปของความมิติสูง
ในพื้นที่ที่มีมิติสูง ระยะทางอาจให้ข้อมูลน้อยลงเนื่องจากตัวอย่างกระจายและระยะทางที่ใกล้ที่สุดและไกลที่สุดมีความคล้ายคลึงกัน KNN อาจต้องการข้อมูลจำนวนมหาศาลเพื่อรักษาเพื่อนบ้านท้องถิ่นที่มีความหมาย นี่คือ คำสาปของความมิติสูง
การลดมิติ หรือการฝังแบบเฉพาะงานสามารถช่วยได้, แต่เรขาคณิตของการฝังควรได้รับการตรวจสอบเพื่อให้สอดคล้องกับแนวคิดความคล้ายคลึงที่ตั้งใจ
ประสิทธิภาพการค้นหา
การสอบถามแบบ brute-force จะเปรียบเทียบจุดใหม่กับทุกตัวอย่างที่เก็บไว้ KD trees และ ball trees เร่งความเร็วการค้นหาแบบแม่นยำบางส่วน แม้ประโยชน์ของมันจะลดลงในมิติสูง ดัชนี nearest-neighbor แบบประมาณค่าจะแลกกับการสูญเสียความครอบคลุมเล็กน้อยเพื่อความเร็วและประหยัดหน่วยความจำที่มากมาย แนวคิดนี้ยังเป็นพื้นฐานของ การค้นหาความคล้ายคลึงแบบเวกเตอร์
จุดแข็งและข้อจำกัด
KNN มีความเรียบง่าย, รองรับเส้นแบ่งการตัดสินใจที่ไม่เป็นระเบียบ, และให้คำอธิบายเชิงตัวอย่างที่เข้าใจง่าย แต่ก็อาจต้องการหน่วยความจำมาก, เปิดเผยตัวอย่างการฝึกที่ละเอียดอ่อน, ทำนายช้า, และทำงานได้แย่เมื่อระยะทางไม่มีความหมาย มันเป็น baseline ที่มีประโยชน์—ไม่ใช่วิธีที่โดยค่าเริ่มต้นจะมีความแม่นยำสูงในปัญหาส่วนใหญ่
ระยะทาง, เพื่อนบ้าน, และพฤติกรรมของไฮเปอร์พารามิเตอร์
K-nearest neighbors เก็บตัวอย่างการฝึกและทำนายจาก k ตัวที่ใกล้ที่สุดภายใต้ระยะทางที่เลือก การจำแนกใช้การลงคะแนนส่วนใหญ่หรือแบบถ่วงน้ำหนักตามระยะทาง; การถดถอยเฉลี่ยค่าเป้าหมายของเพื่อนบ้าน การสเกลเป็นสิ่งจำเป็นเพราะคุณลักษณะที่มีช่วงสูงอาจครอบงำระยะทางยูคลิด ข้อมูลเชิงประเภท, กระจาง, ลำดับ, หรือภูมิศาสตร์อาจต้องการระยะทางแบบ Hamming, cosine, edit, great-circle หรือระยะทางที่เรียนรู้ เมตริกเป็นสมมติฐานการโมเดลเกี่ยวกับความคล้ายคลึงและควรได้รับการตรวจสอบกับความหมายจริงของกรณีที่อยู่ใกล้กัน
k เล็กสร้างขอบเขตที่ยืดหยุ่น, ความแปรปรวนสูงและความไวต่อเสียงรบกวน; k ใหญ่ทำให้การทำนายเรียบและอาจลบโครงสร้างของกลุ่มย่อย k ที่เป็นเลขคี่เพียงหลีกเลี่ยงการเสมอคะแนนบางกรณีและไม่ใช่กฎทั่วไป เลือก k, ระยะทาง, การถ่วงน้ำหนัก, ชุดคุณลักษณะ, และการเตรียมข้อมูลภายใน cross-validation ความไม่สมดุลของคลาสอาจทำให้การลงคะแนนส่วนใหญ่ท้องถิ่นมองข้ามผลลัพธ์ที่หายาก ดังนั้นควรตรวจสอบการเรียกคืนต่อคลาสและองค์ประกอบของเพื่อนบ้าน ระยะทางในมิติสูงมีแนวโน้มกระจุกตัว, และคุณลักษณะที่ไม่เกี่ยวข้องทำให้เพื่อนบ้านเสื่อมคุณภาพ; การเลือก, การลดมิติ, หรือการฝังที่เรียนรู้สามารถช่วยได้
การทำดัชนี, ความไม่แน่นอน, และการดำเนินงานในสภาพแวดล้อมการผลิต
การสรุปผลแบบง่ายเปรียบเทียบสอบถามกับทุกจุดการฝึก KD trees และ ball trees ช่วยในมิติที่ต่ำที่เหมาะสม; ดัชนี nearest-neighbor แบบประมาณค่าจะแลกกับความแม่นยำเพื่อความเร็วและขนาด วัดการเรียกคืนของการค้นหาเพื่อนบ้านแยกจากคุณภาพการทำนาย หน่วยความจำรวมถึงคุณลักษณะที่เก็บ, ป้ายกำกับ, และโครงสร้างดัชนี การอัปเดตโดยแนวคิดง่ายแต่บางครั้งต้องสร้างดัชนีใหม่, รักษาความสอดคล้องของเวอร์ชัน, และการกระจายการลบ ปกป้องตัวอย่างการฝึกที่ละเอียดอ่อนเพราะการคืนค่าเพื่อนบ้านหรือระยะทางอาจเปิดเผยข้อมูล
KNN สามารถแสดงตัวอย่างที่ทำให้การทำนายเข้าใจได้, แต่ความใกล้เคียงไม่ได้หมายถึงสาเหตุหรือความเป็นธรรม ให้ข้อมูลระยะทาง, ความต่างของคะแนน, และกฎการงดลงคะแนนเมื่อเพื่อนบ้านกระจัดกระจายหรือขัดแย้ง ตรวจสอบระยะทางสอบถาม, ป้ายกำกับเพื่อนบ้าน, การเปลี่ยนแปลงของคุณลักษณะ, ความหน่วง, และผลลัพธ์ที่ยืนยันไว้ รักษาการเตรียมข้อมูลและเวอร์ชันดัชนีให้สอดคล้อง, และทดสอบผลลัพธ์แบบแม่นยำเทียบกับแบบประมาณหลังการเปลี่ยนแปลง KNN เป็น baseline ท้องถิ่นและวิธีการดึงข้อมูลที่มีประสิทธิภาพเมื่อระยะทางมีความหมาย; มันทำงานได้ยากเมื่อความคล้ายคลึงไม่สามารถแสดงด้วยคุณลักษณะที่มี
ตัวอย่างการทำงาน: KNN สำหรับการทดแทนสินค้า
ผู้ค้าปลีกแทนสินค้าด้วยคุณลักษณะเชิงตัวเลขที่มาตรฐาน, ความเข้ากันได้เชิงประเภท, และการฝังข้อความที่เรียนรู้, จากนั้นกำหนดระยะทางแบบถ่วงน้ำหนักที่ได้รับการตรวจสอบโดยผู้จัดสินค้า K และน้ำหนักถูกเลือกโดยใช้การเปิดตัวสินค้าภายหลัง, ไม่ใช่แถวรายการสุ่ม การประเมินตรวจสอบการเรียกคืนของสินค้าทดแทนที่เกี่ยวข้อง, คำแนะนำที่ไม่เข้ากัน, ระยะทาง, ความครอบคลุมของหมวดหมู่, และผลลัพธ์สำหรับสินค้าที่หายาก baseline ความนิยมแสดงว่าความคล้ายคลึงท้องถิ่นเพิ่มคุณค่าได้หรือไม่
ดัชนีแบบประมาณค่าถูกเปรียบเทียบกับเพื่อนบ้านที่แม่นยำเพื่อวัดการเรียกคืนและความหน่วง คำสอบถามที่ไม่มีรายการที่เข้ากันได้ใกล้เคียงจะคืนค่าไม่มีข้อเสนอแทนการบังคับให้เป็นเพื่อนบ้าน การลบสินค้าและการแก้ไขคุณลักษณะจะกระจายไปยังดัชนีผ่านการอัปเดตเวอร์ชัน การตรวจสอบติดตามการกระจายของระยะทาง, ผลลัพธ์ว่าง, การแทนที่, และผลลัพธ์เชิงพาณิชย์โดยไม่สับสนระหว่างการขายกับความเข้ากันได้จริง เงื่อนไขผู้จัดจำหน่ายที่ละเอียดอ่อนถูกตัดออกจากคำอธิบาย, และตัวอย่างที่คืนค่าจะเป็นหลักฐานของความคล้ายคลึง—not การอ้างว่าเป็นสินค้าที่เทียบเท่า
หลักฐานการนำไปใช้และความพร้อมในการดำเนินงาน
การตัดสินใจในสภาพแวดล้อมการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละรายการ สร้าง baseline ที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจได้รับบริการไม่เพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน, กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการตรวจสอบด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา Telemetry การดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพแบบออฟไลน์จะคงอยู่ ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
KNN มีขั้นตอนการฝึกหรือไม่?
มันมีการปรับพารามิเตอร์เพียงเล็กน้อย, แต่ยังคงมีกระบวนการพัฒนา: การเตรียมข้อมูลเรียนรู้จากข้อมูลฝึก, อาจสร้างดัชนี, และ k, เมตริก, น้ำหนัก, และคุณลักษณะถูกเลือกด้วย validation
KNN คือเดียวกับ K-means หรือไม่?
ไม่. KNN เป็นวิธีการทำนายแบบท้องถิ่นที่มีการกำกับดูแลเป็นหลัก K-means เป็นอัลกอริทึมการจัดกลุ่มแบบไม่กำกับดูแลที่ K คือจำนวนศูนย์กลางของกลุ่ม
แหล่งอ้างอิงหลัก












