
พื้นฐาน AI
การลดมิติคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การลดมิติ แสดงข้อมูลด้วยตัวแปรที่น้อยลงในขณะที่ยังคงรักษาข้อมูลที่มีประโยชน์ต่อภารกิจไว้ได้ มันสามารถลดการใช้พื้นที่จัดเก็บและสัญญาณรบกวน, ปรับปรุงการแสดงผล, ลดความซ้ำซ้อนของฟีเจอร์ และทำให้โมเดลต่อไปง่ายต่อการฝึกฝนขึ้น
ไม่มีวิธีใดที่รักษาความสัมพันธ์ทั้งหมดได้ การลดมิติที่มีประโยชน์จะเริ่มจากการระบุว่าควรเก็บอะไรไว้: ความแปรปรวน, การแยกคลาส, เพื่อนบ้านในระดับท้องถิ่น, รูปทรงเชิงพื้นที่ทั่วโลก, คุณภาพการกู้คืน หรือความสามารถในการอธิบาย
ประเด็นสำคัญ
- การคัดเลือกฟีเจอร์จะคงตัวแปรเดิมไว้; การสกัดฟีเจอร์จะสร้างพิกัดมิติที่ต่ำลงใหม่
- PCA เป็นวิธีเชิงเส้นและเน้นความแปรปรวน; t‑SNE และ UMAP เน้นโครงสร้างเพื่อนบ้านเพื่อการแสดงผล
- การฝังภาพเพื่อการแสดงผลอาจบิดเบือนระยะทาง, ขนาดของกลุ่มและการแยกเชิงทั่วโลก
- ทำการลดมิติเฉพาะบนข้อมูลการฝึกเท่านั้น, แล้วจึงใช้การแปลงที่ได้กับข้อมูลตรวจสอบและทดสอบ
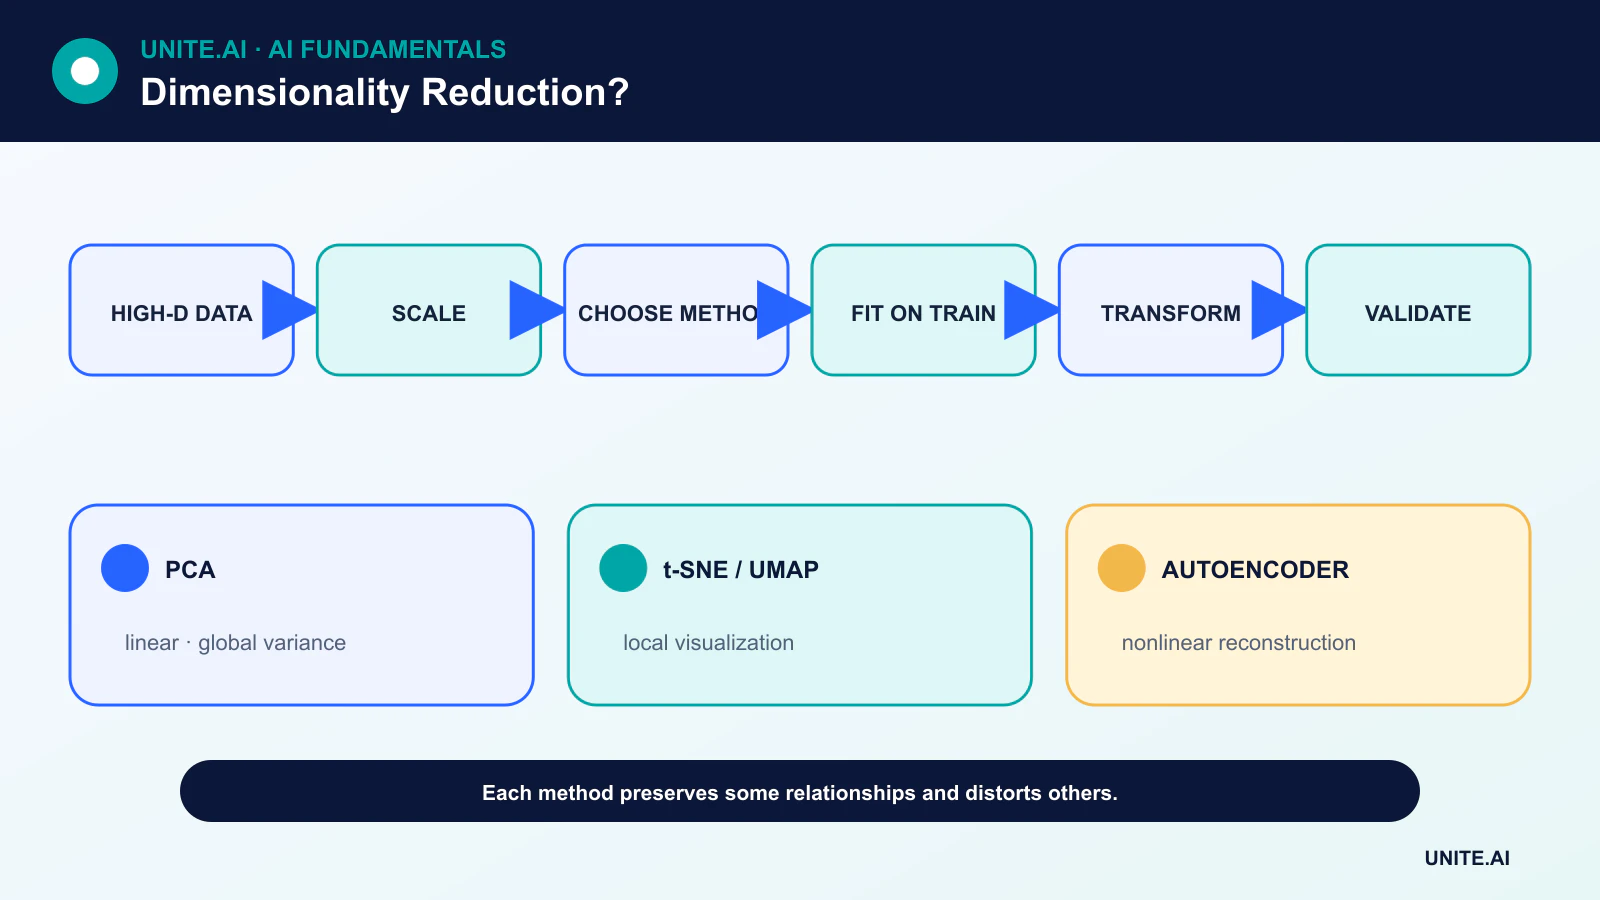
การคัดเลือกฟีเจอร์เทียบกับการฉายภาพ
การคัดเลือกฟีเจอร์จะลบตัวแปรโดยใช้กฎด้านโดเมน, การขาดข้อมูล, ความซ้ำซ้อน, การทดสอบเชิงพยากรณ์ หรือการทำให้เป็นระเบียบ มันคงความหมายเดิมของตัวแปรซึ่งสามารถช่วยในการกำกับดูแลและการอธิบายได้
วิธีการฉายภาพจะผสานตัวแปรเป็นพิกัดใหม่ สามารถจับโครงสร้างที่กระจายได้แต่ละพิกัดอาจยากต่อการตีความมากขึ้น autoencoder เรียนรู้การฉายภาพเชิงไม่เชิงเส้นผ่านการกู้คืน
PCA และ SVD
การวิเคราะห์องค์ประกอบหลัก (Principal Component Analysis) ระบุทิศทางตั้งฉากที่มีความแปรปรวนลดลงหลังจากทำการศูนย์ข้อมูล การแยกค่าเอกฐาน (Singular Value Decomposition) ให้วิธีการเชิงตัวเลขที่ใช้กันทั่วไป การปรับสเกลมีความสำคัญ: หน่วยวัดที่มีความแปรปรวนสูงอาจครอบงำองค์ประกอบได้
PCA เป็นวิธีเชิงกำหนดผลลัพธ์ยกเว้นสัญญาณและค่าอีเจนที่ซ้ำกัน รองรับการแปลงข้อมูลนอกชุดตัวอย่างและให้สรุปความแปรปรวนที่อธิบายได้ ความแปรปรวนสูงไม่ได้หมายความว่าจะเกี่ยวข้องกับภารกิจเสมอไป และองค์ประกอบเชิงเส้นไม่สามารถคลี่คลายทุกมานิโฟลด์โค้งได้
t‑SNE และ UMAP
t‑SNE สร้างการกระจายความน่าจะเป็นระหว่างเพื่อนบ้านและทำการปรับแผนที่มิติที่ต่ำซึ่งเน้นความคล้ายคลึงในระดับท้องถิ่น UMAP สร้างกราฟเพื่อนบ้านที่มีน้ำหนักและทำการปรับตัวแทนมิติที่ต่ำโดยมีเป้าหมายโครงสร้างท้องถิ่นที่เกี่ยวข้อง
ทั้งสองเป็นเครื่องมือสำรวจที่ทรงพลังแต่มีความอ่อนไหวต่อการเตรียมข้อมูลล่วงหน้า, มาตรวัดระยะทางและค่าพารามิเตอร์สูง พื้นที่ว่าง, พื้นที่กลุ่มและระยะห่างระหว่างกลุ่มในแผนภาพ 2 มิติไม่ควรได้รับการตีความเป็นความหมายในโลกจริงโดยอัตโนมัติ
วิธีการแบบมีผู้สอนและการแทนค่าที่รับรู้ภารกิจ
การวิเคราะห์แยกเชิงเส้น (Linear Discriminant Analysis) ใช้ป้ายกำกับคลาสเพื่อค้นหาการแยก ทำให้แตกต่างจาก PCA แบบไม่มีผู้สอน การเรียนรู้การแทนค่าด้วยเครือข่ายประสาทสามารถปรับเป้าหมายการพยากรณ์หรือการเปรียบเทียบแทนการกู้คืน
หากป้ายกำกับเป็นตัวนำการลดมิติ การฝึกและการปรับพารามิเตอร์ทั้งหมดต้องทำภายในกระบวนการฝึก มิฉะนั้นข้อมูลจากชุดทดสอบอาจรั่วไหลเข้าสู่การเลือกโมเดลและทำให้ผลลัพธ์ดูเป็นบวกเกินจริง
การเลือกและการตรวจสอบวิธีการ
เริ่มต้นด้วยการเตรียมข้อมูลล่วงหน้าและฐานเส้นง่าย ๆ สำหรับการบีบอัด ให้วัดการกู้คืนหรือประสิทธิภาพต่อเนื่องตามจำนวนมิติ สำหรับการแสดงผล ให้ทดสอบความเสถียรตามค่า seed และพารามิเตอร์สูงและเปรียบเทียบการคงรักษาเพื่อนบ้านกับความรู้ด้านโดเมน
สำหรับการใช้งานจริง ให้ถามว่าวิธีการนั้นสามารถแปลงบันทึกใหม่ได้หรือไม่, จัดการค่าที่ขาดอย่างไร, มีการเปลี่ยนแปลงเมื่อฝึกใหม่หรือไม่, และผู้ใช้ต้องการคำอธิบายฟีเจอร์ดั้งเดิมหรือไม่ Overfitting สามารถเกิดขึ้นในขั้นตอนการลดมิติได้เช่นเดียวกับโมเดลสุดท้าย
วิธีการลดมิติแบบเชิงเส้นและไม่เชิงเส้น
การลดมิติทำการแมปข้อมูลหลายมิติเป็นพิกัดที่น้อยลงในขณะที่คงโครงสร้างที่เลือกไว้ PCA ค้นหาทิศทางตั้งฉากที่มีความแปรปรวนสูงสุดหลังจากทำศูนย์ข้อมูล; จำเป็นต้องปรับสเกลเมื่อหน่วยวัดควรมีส่วนร่วมเท่าเทียมกัน Singular Value Decomposition คำนวณโครงสร้างอันดับต่ำที่เกี่ยวข้องและรองรับเมทริกซ์แบบกระจาย Linear Discriminant Analysis ใช้ป้ายกำกับเพื่อหาทิศทางแยกคลาส วิธีเหล่านี้ให้การแปลงที่ชัดเจน แต่ความแปรปรวนหรือการแยกคลาสอาจไม่คงข้อมูลที่จำเป็นต่อภารกิจต่อไป
วิธีการบนมานิโฟลด์เช่น t‑SNE และ UMAP สร้างเพื่อนบ้านและปรับโครงร่างมิติที่ต่ำ พวกเขามีประสิทธิภาพในการสำรวจแต่บิดเบือนระยะทางทั่วโลก, ความหนาแน่น, ขนาดกลุ่มและบางครั้งการแยก ผลลัพธ์ขึ้นกับการเตรียมข้อมูลล่วงหน้า, มาตรวัด, จำนวนเพื่อนบ้านหรือ perplexity, การเริ่มต้น, และค่า seed กลุ่มที่ดูดีในสองมิติอาจปรากฏแม้ไม่มีกลุ่มแยกชัด ใช้การตั้งค่าหลายแบบ, ระบายสีเฉพาะตามเมทาดาต้าที่ไม่ได้ใช้ในการฝึก, และตรวจสอบโครงสร้างที่ดูเหมือนจริงในพื้นที่เดิมหรือด้วยป้ายกำกับอิสระ
การคัดเลือกฟีเจอร์, การฝังข้อมูล, และการประเมินผล
การคัดเลือกฟีเจอร์คงตัวแปรเดิมผ่านตัวกรอง, ตัวห่อหุ้ม, หรือความสำคัญแบบอิงโมเดล; การเรียนรู้การแทนค่าสร้างฟีเจอร์แฝงใหม่โดยใช้ autoencoder หรือโมเดลที่มีผู้สอน การฉายแบบสุ่มคงระยะทางโดยประมาณภายใต้เงื่อนไขบางอย่างและให้ฐานเปรียบเทียบที่มีประสิทธิภาพ เลือกวิธีตามการบีบอัด, การแสดงผล, การลดสัญญาณรบกวน, ความเร็ว, การจัดเก็บ, หรือประสิทธิภาพของโมเดล ฝึกตัวลดมิติเฉพาะบนข้อมูลการฝึกเท่านั้น, แล้วแปลงชุดตรวจสอบและทดสอบ การลดมิติแบบมีผู้สอนต้องทำแบบซ้อนอยู่ภายใน cross‑validation เพื่อหลีกเลี่ยงการรั่วไหลของป้ายกำกับ
ประเมินความแปรปรวนที่อธิบายได้หรือการกู้คืนสำหรับการบีบอัดเชิงเส้น, ความน่าเชื่อถือและการคงรักษาเพื่อนบ้านสำหรับการแสดงผล, และความแม่นยำ, การปรับเทียบ, ความหน่วงเวลา, และความทนทานของผลลัพธ์ต่อไปสำหรับการพยากรณ์ วัดความเสถียรตามตัวอย่างและค่า seed ตรวจสอบว่าคลาสหายากหรือกลุ่มที่อ่อนไหวถูกบีบอัดหรือไม่และว่าการแปลงย้อนกลับเป็นไปได้หรือไม่ พิกัดที่ลดลงอาจยังคงมีข้อมูลส่วนบุคคล; แผนภาพสองมิติไม่ใช่การทำให้เป็นนิรนาม บันทึกการแปลง, ตัวปรับสเกล, ลำดับฟีเจอร์, และข้อจำกัด
การใช้งานในระบบผลิต
การให้บริการต้องใช้การแปลงที่ฝึกแล้วอย่างแม่นยำและสคีมาข้อมูลเข้า ตรวจสอบฟีเจอร์ที่ขาด, การเปลี่ยนแปลงช่วงค่า, การกระจายคะแนนขององค์ประกอบ, ความผิดพลาดการกู้คืน, และผลลัพธ์ต่อไป หากมีประเภทหรือเซนเซอร์ใหม่ปรากฏ ควรฝึกใหม่และเวอร์ชันทั้งหมดของ pipeline แทนการเพิ่มคอลัมน์โดยเงียบ การลดมิติสามารถปรับปรุงการคำนวณและลดสัญญาณรบกวนของโมเดลได้ แต่ก็อาจทิ้งสัญญาณอ่อนที่สำคัญต่อเหตุการณ์หายาก ถือว่ามันเป็นขั้นตอนการวัดที่เรียนรู้ซึ่งข้อมูลที่คงไว้และสูญเสียต้องได้รับการทดสอบเทียบกับการตัดสินใจ
ตัวอย่างการทำงาน: ลดฟีเจอร์พฤติกรรมลูกค้า
นักวิเคราะห์ทำมาตรฐานให้กับมาตรวัดพฤติกรรม 200 รายการและฝึก PCA เฉพาะกับลูกค้าที่ใช้ในการฝึกเท่านั้น การทำ cross‑validation เลือกจำนวนองค์ประกอบโดยอิงจากประสิทธิภาพการสูญเสียลูกค้าต่อเนื่องและความเสถียร ไม่ใช่แผนภาพกระจายสองมิติ การตรวจสอบโหลดดิ้งเพื่อดูแหล่งที่โดดเด่นและการขาดข้อมูล PCA, การคัดเลือกฟีเจอร์, การฉายแบบสุ่ม, และโมเดลที่ไม่ได้ลดมิติพร้อมการควบคุมเปรียบเทียบด้านการปรับเทียบ, ความหน่วงเวลา, และผลลัพธ์สำหรับกลุ่มลูกค้าที่หายาก ตัวอย่างซ้ำยังทดสอบว่าคอมโพเนนต์ชั้นนำและสรุปต่อเนื่องยังคงเสถียรหรือไม่
pipeline ที่ใช้งานจริงกำหนดลำดับฟีเจอร์, ตัวปรับสเกล, และคอมโพเนนต์และปฏิเสธเวอร์ชันสคีมาที่ขาด การตรวจสอบติดตามการกระจายของคอมโพเนนต์, ความผิดพลาดการกู้คืน, และผลลัพธ์ต่อเนื่อง การแสดงผลที่มีคลัสเตอร์ดูเหมือนจริงใช้เพื่อสร้างคำถาม ไม่ได้เพื่อกำหนดบุคลิกลูกค้า เนื่องจากคอมโพเนนต์แฝงยังคงบันทึกพฤติกรรม การเข้าถึงและการเก็บรักษายังคงอยู่ภายใต้การควบคุม หากคำนิยามแหล่งข้อมูลเปลี่ยนแปลง การแปลงและโมเดลทั้งหมดจะถูกสร้างใหม่และตรวจสอบแทนการฉายข้อมูลที่ไม่เข้ากันเข้าสู่คอมโพเนนต์เก่า
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจใช้งานจริงต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานที่ทำซ้ำได้และชุดประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาด, การเปลี่ยนแปลงการกระจาย, การขัดข้องของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วงเวลา, อัตราการผ่าน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการตรวจสอบด้วยความล้มเหลวที่ใส่เข้าโดยเจตนา โทรเมตรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, แล้วตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดการทำงานหรือแทนที่
คำถามที่พบบ่อย
การลดมิติทำให้โมเดลดีขึ้นเสมอหรือไม่?
ไม่. มันอาจทำให้ข้อมูลที่ใช้ทำนายหายไปหรือทำให้การอธิบายยากขึ้น เปรียบเทียบกับฐานที่ไม่มีการลดมิติบนข้อมูลที่แยกออกมาทดสอบ
กลุ่ม t‑SNE ที่แยกกันพิสูจน์ว่ามีคลาสจริงหรือไม่?
ไม่. แผนที่เป็นการแสดงผลที่ปรับให้เหมาะสมของความสัมพันธ์ระหว่างเพื่อนบ้านและอาจสร้างการแยกที่ดูเหมือนจริง ตรวจสอบความถูกต้องของกลุ่มด้วยหลักฐานอิสระ
อ้างอิงหลัก












