พื้นฐาน AI
การเรียนรู้ของเครื่องคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การเรียนรู้ของเครื่อง (ML) เป็นสาขาหนึ่งของปัญญาประดิษฐ์ที่ระบบเรียนรู้รูปแบบจากข้อมูลเพื่อให้สามารถทำการทำนาย การจำแนก การแนะนำ หรือการตัดสินใจได้โดยไม่ต้องให้ผู้พัฒนาเขียนกฎแยกต่างหากสำหรับทุกกรณีที่เป็นไปได้ ผลลัพธ์ไม่ได้เป็นเครื่องที่ “คิด” เหมือนมนุษย์ แต่เป็นโมเดลสถิติที่แมปอินพุตไปยังเอาต์พุตที่มีประโยชน์และสามารถประเมินได้บนข้อมูลที่ไม่ได้เห็นระหว่างการฝึกฝน
การเรียนรู้ของเครื่องเป็นส่วนหนึ่งของสาขากว้างของ AI ในขณะที่การเรียนรู้เชิงลึกเป็นกลุ่มของวิธีการเรียนรู้ของเครื่องที่สร้างขึ้นรอบเครือข่ายประสาทเทียมหลายชั้น ความแตกต่างนี้สำคัญ: ไม่ใช่ทุกระบบ AI ที่ใช้ ML และไม่ใช่ทุกปัญหา ML ที่ต้องการเครือข่ายประสาทเทียม
ประเด็นสำคัญ
- ML เรียนรู้ความสัมพันธ์จากตัวอย่างแทนการพึ่งพากฎที่เขียนด้วยมือเท่านั้น
- โมเดลที่มีประโยชน์ต้องสามารถทั่วไปกับข้อมูลใหม่ ไม่ใช่แค่จดจำชุดฝึกเท่านั้น
- การเรียนรู้แบบมีผู้สอน, แบบไม่มีผู้สอน, แบบกึ่งมีผู้สอน, แบบเรียนรู้ด้วยตนเอง, และการเรียนรู้แบบเสริมแรงแก้ไขปัญหาต่างประเภท
- คุณภาพของข้อมูล, การออกแบบการประเมิน, และการเฝ้าติดตามมีความสำคัญเท่ากับอัลกอริทึม
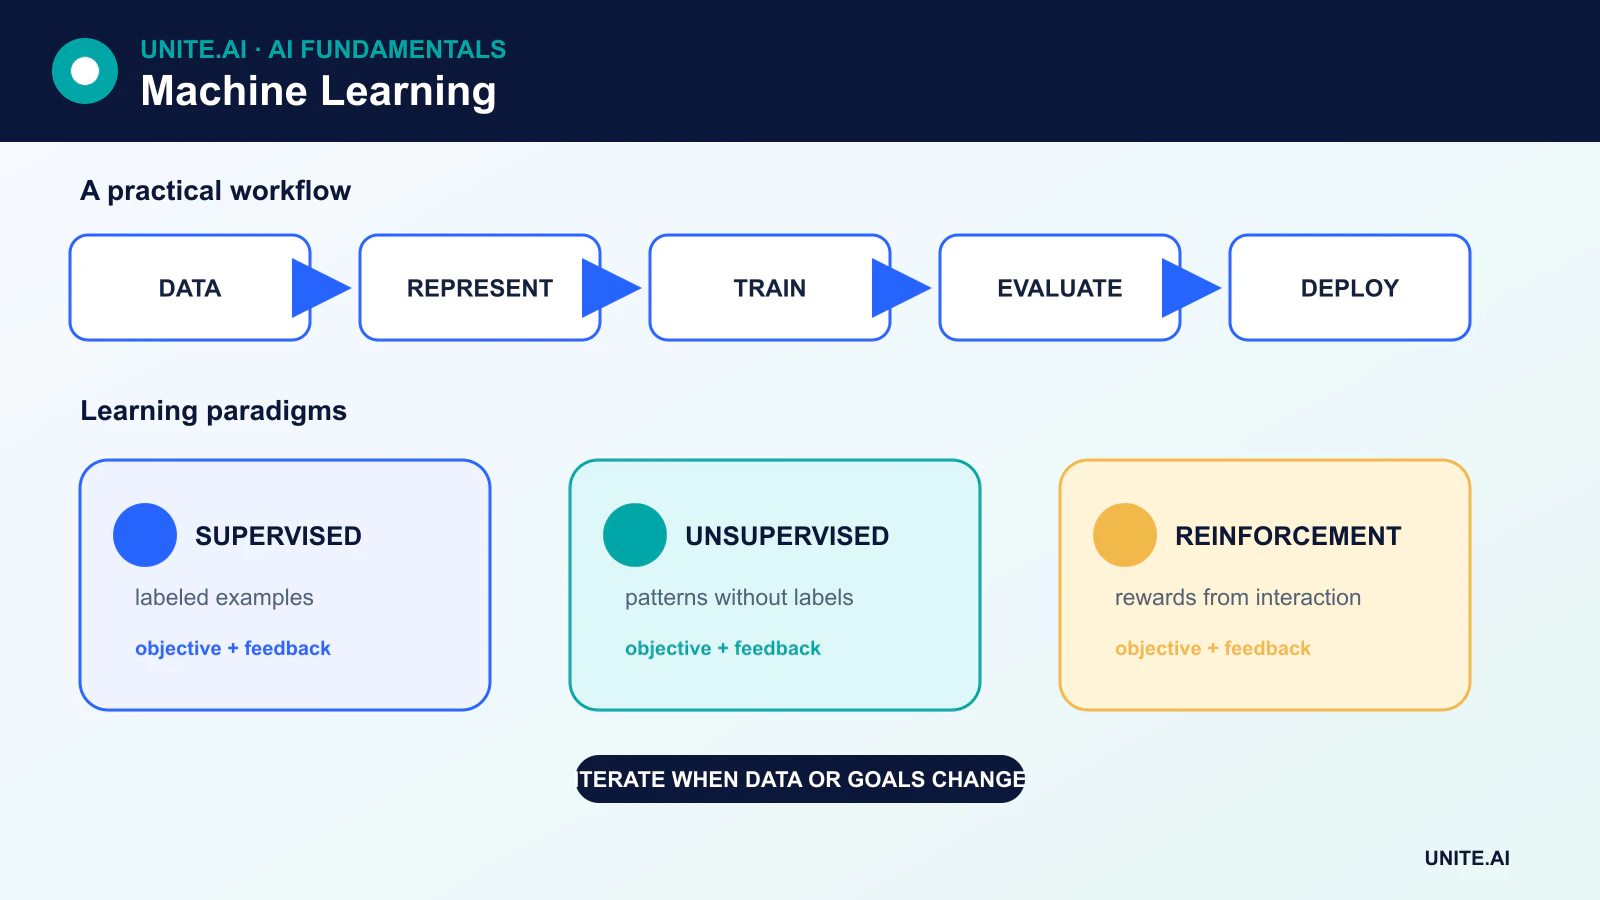
วิธีการทำงานของการเรียนรู้ของเครื่อง
โครงการ ML ส่วนใหญ่สามารถเข้าใจได้เป็นลำดับของหกขั้นตอน:
- กำหนดงาน. ให้ตัดสินใจว่าระบบควรทำนายหรือค้นหาอะไรและความสำเร็จหมายถึงอะไรในการใช้งานจริง
- รวบรวมและเตรียมข้อมูล. ทำความสะอาดบันทึก, จัดการค่าที่หายไป, สร้างคุณลักษณะที่เป็นประโยชน์, และบันทึกแหล่งที่มาของข้อมูล
- แบ่งข้อมูล. ชุดฝึกใช้เพื่อปรับโมเดล, ชุดตรวจสอบช่วยเลือกการตั้งค่า, และชุดทดสอบให้การประเมินสุดท้ายบนข้อมูลที่ยังไม่เคยใช้
- ฝึกโมเดล. อัลกอริทึมปรับพารามิเตอร์ของโมเดลเพื่อลดฟังก์ชันสูญเสียหรือบรรลุเป้าหมายการเรียนรู้อื่น
- ประเมินการทั่วไป. ตัวชี้วัดต้องสะท้อนงาน, ความสมดุลของคลาส, ค่าใช้จ่ายของข้อผิดพลาด, และประชากรที่โมเดลจะทำงาน
- นำไปใช้และเฝ้าติดตาม. ข้อมูลในโลกจริงอาจเปลี่ยนแปลง, ดังนั้นทีมต้องตรวจสอบการเปลี่ยนแปลง, การเสื่อมประสิทธิภาพ, ความลำเอียง, และความล้มเหลวในการดำเนินงาน
ตัวแปรที่ป้อนให้โมเดลมักเรียกว่า “คุณลักษณะ” (features) ในการเรียนรู้แบบมีผู้สอน คำตอบที่ต้องการเรียกว่า “ป้ายกำกับ” หรือ “เป้าหมาย” พารามิเตอร์ที่โมเดลเรียนรู้จะบันทึกความสัมพันธ์ระหว่างคุณลักษณะและผลลัพธ์; ไม่ได้เป็นฐานข้อมูลของกฎที่ชัดเจน
แนวคิดการเรียนรู้หลัก
การเรียนรู้แบบมีผู้สอน
ในการเรียนรู้แบบมีผู้สอน ตัวอย่างจะรวมทั้งอินพุตและเป้าหมายที่ทราบ โมเดลการจำแนกประเภทจะทำนายหมวดหมู่ เช่น ธุรกรรมเป็นการฉ้อโกงหรือไม่ โมเดลการถดถอยจะทำนายค่าต่อเนื่อง เช่น ความต้องการพลังงานที่คาดการณ์
อัลกอริทึมแบบมีผู้สอนที่พบบ่อยรวมถึง decision trees, support vector machines, K-nearest neighbors, linear regression และ logistic regression, gradient‑boosted trees, และ neural networks. เกณฑ์การจำแนกเช่น 0.5 เป็นการตัดสินใจที่เลือกหลังจากโมเดลให้คะแนนหรือความน่าจะเป็น; ไม่ใช่คุณสมบัติที่เปลี่ยนแปลงไม่ได้ของ logistic regression
การเรียนรู้แบบไม่มีผู้สอน
การเรียนรู้แบบไม่มีผู้สอนทำงานกับข้อมูลที่ไม่มีป้ายกำกับเป้าหมาย วัตถุประสงค์อาจเป็นการค้นหากลุ่ม, ตรวจจับการสังเกตที่ผิดปกติ, ประมาณการแจกแจง, หรือสร้างการแทนที่มิติที่ต่ำลง กลุ่ม (cluster) คือกลุ่มที่เสนอโดยกฎความคล้ายคลึง; ไม่ได้หมายความว่าจะเป็นคลาสที่มีความหมายในโลกจริงโดยอัตโนมัติ
ตัวอย่างรวมถึง K-means clustering, principal component analysis, density estimation, และรูปแบบบางอย่างของ autoencoders. Autoencoder เรียนรู้การสร้างสภาพใหม่ของอินพุตผ่านการแทนที่ที่บีบอัด ไม่ได้สร้างป้ายกำกับความจริงโดยอัตโนมัติ
การเรียนรู้แบบกึ่งมีผู้สอนและการเรียนรู้ด้วยตนเอง
การเรียนรู้แบบกึ่งมีผู้สอนผสมผสานชุดข้อมูลที่มีป้ายกำกับเล็กน้อยกับชุดข้อมูลที่ไม่มีป้ายกำกับขนาดใหญ่ การเรียนรู้ด้วยตนเองสร้างสัญญาณการฝึกจากข้อมูลเอง—เช่น การทำนายคำที่ถูกปิดบังหรือการจับคู่มุมมองที่แปลงแล้วสองภาพของภาพเดียว การเรียนรู้ด้วยตนเองเป็นหัวใจของหลาย pipeline ของ transformer และ foundation‑model สมัยใหม่ เนื่องจากสามารถใช้คอลเลกชันขนาดใหญ่ของข้อความ, ภาพ, เสียง หรือวิดีโอโดยไม่ต้องให้คนทำการป้ายกำกับทุกตัวอย่าง
การเรียนรู้แบบเสริมแรง
ในการเรียนรู้แบบเสริมแรง ตัวแทนทำการกระทำในสภาพแวดล้อมและได้รับรางวัลหรือค่าใช้จ่าย วัตถุประสงค์คือการเรียนรู้นโยบายที่ทำให้รางวัลสะสมคาดหวังสูงสุด ซึ่งแตกต่างจากการเรียนรู้แบบมีผู้สอนเพราะการกระทำที่ถูกต้องไม่ได้ถูกให้สำหรับทุกสถานะ และการกระทำหนึ่งอาจส่งผลต่อข้อมูลที่ตัวแทนเจอในขั้นต่อไป
การฝึก, การตรวจสอบ, และการทั่วไป
โมเดลที่ทำงานได้ดีบนตัวอย่างการฝึกอาจยังล้มเหลวบนข้อมูลใหม่ ความล้มเหลือนี้เรียกว่า overfitting ทีมงานลดปัญหานี้โดยใช้ความจุโมเดลที่เหมาะสม, regularization, cross‑validation, การเพิ่มข้อมูล, การป้องกันการรั่วไหล, และชุดทดสอบที่เป็นอิสระจริง
ไม่มีตัวชี้วัดเดียวที่ใช้ได้กับทุกงาน ML การจำแนกอาจต้องการ precision, recall, F1, calibration, หรือมาตรการที่คำนวณตามต้นทุนแทนความแม่นยำดิบ การถดถอยอาจใช้ mean absolute error, root mean squared error, หรือ loss เฉพาะโดเมน การจัดกลุ่มต้องการรูปแบบการประเมินภายในหรือการตรวจสอบภายนอกที่แตกต่าง ตัวชี้วัดควรสะท้อนว่าข้อผิดพลาดหมายถึงอะไรต่อผู้ใช้หรือองค์กร
อัลกอริทึมการเรียนรู้ของเครื่องเป็นเครื่องมือ ไม่ใช่การรับประกัน
อัลกอริทึมมีสมมติฐาน โมเดลเชิงเส้นสมมติรูปแบบความสัมพันธ์เฉพาะ K‑nearest neighbors สมมติว่าระยะทางที่เลือกแสดงความคล้ายคลึงที่มีความหมาย Naive Bayes สมมติว่าคุณลักษณะเป็นอิสระตามเงื่อนไขเมื่อกำหนดคลาส Decision trees แบ่งพื้นที่คุณลักษณะโดยใช้กฎการแยกที่เรียนรู้; ใบไม้ของต้นไม้มีการทำนายที่อิงจากกลุ่มของการสังเกตการฝึก ไม่ได้จำเป็นต้องเป็นการสังเกตเดียวต่อใบไม้
ดังนั้นการเลือกโมเดลจึงขึ้นอยู่กับขนาดข้อมูล, ประเภทของคุณลักษณะ, ความต้องการความหน่วง, ความต้องการการอธิบายผล, และค่าใช้จ่ายของความผิดพลาด โมเดลที่ง่ายกว่าอาจทำผลงานดีกว่าโมเดลที่ใหญ่กว่าเมื่อข้อมูลมีจำกัดหรือข้อจำกัดการดำเนินงานต้องการความเร็วและความโปร่งใส
การใช้การเรียนรู้ของเครื่อง
ML สนับสนุนการจัดอันดับการค้นหา, การแนะนำ, การพยากรณ์, การตรวจจับความผิดปกติ, การแปล, การรู้จำเสียง, computer vision, การบำรุงรักษาเชิงพยากรณ์, การตรวจจับการฉ้อโกง, และการวิเคราะห์ทางวิทยาศาสตร์ เทคนิคเดียวกันอาจทำให้ความลำเอียงในประวัติศาสตร์เพิ่มขึ้น, เปิดเผยข้อมูลที่ละเอียดอ่อน, หรือทำงานอย่างไม่คาดคิดเมื่อเกิดการเปลี่ยนแปลงการกระจาย การนำไปใช้ที่รับผิดชอบต้องมีเอกสาร, การควบคุมโดยมนุษย์เมื่อเหมาะสม, การทดสอบความปลอดภัย, และการเฝ้าติดตามอย่างต่อเนื่อง
จากการกำหนดปัญหาไปสู่การทดลองการเรียนรู้ของเครื่องที่มีความสมบูรณ์
โครงการการเรียนรู้ของเครื่องควรเริ่มด้วยการตัดสินใจและผลลัพธ์ที่สามารถวัดได้ ไม่ใช่อัลกอริทึม กำหนดหน่วยการทำนาย, เป้าหมาย, เวลาในการสังเกต, เวลาในการตัดสินใจ, คุณลักษณะที่มีอยู่, และค่าใช้จ่ายของแต่ละข้อผิดพลาด ตัวอย่างเช่น สำหรับโมเดล churn การใช้เหตุการณ์ที่บันทึกหลังการยกเลิกจะทำให้ข้อมูลรั่วออก สร้างกฎง่ายหรือฐานสถิติพื้นฐาน จากนั้นแบ่งข้อมูลตามเวลา, ลูกค้า, สถานที่, หรือขอบเขตอื่นที่สะท้อนการนำไปใช้ การแบ่งแถวแบบสุ่มอาจทำให้การสังเกตที่เกือบเหมือนกันอยู่ในชุดฝึกและชุดทดสอบและให้คะแนนที่ทำให้เข้าใจผิด
การสร้างคุณลักษณะ (feature engineering) แปลงบันทึกดิบเป็นการแทนที่ที่โมเดลสามารถใช้ได้ แต่ทุกคุณลักษณะต้องมีที่มาที่ไปและการรับประกันความพร้อมใช้งาน ทำการปรับมาตรฐาน, คำศัพท์, การเติมค่า, และการลดมิติเฉพาะบนข้อมูลฝึกเท่านั้น, จากนั้นนำการแปลงที่เรียนรู้ไปใช้กับข้อมูลตรวจสอบและทดสอบ Cross‑validation ประเมินความแปรผันระหว่างตัวอย่าง; ชุดทดสอบสุดท้ายที่ยังไม่ใช้ช่วยสนับสนุนการตัดสินใจปล่อยโมเดล เลือกตัวชี้วัดตามผลลัพธ์: precision และ recall สำหรับข้อผิดพลาดการจำแนกที่ไม่เท่ากัน, calibration เมื่อความน่าจะเป็นเป็นตัวขับเคลื่อนการกระทำ, และมาตรการที่คำนวณตามต้นทุนหรือประโยชน์เมื่อความผิดพลาดมีผลต่อการดำเนินงานที่แตกต่างกัน
การนำไปใช้, การเฝ้าติดตาม, และการดำเนินงานอย่างรับผิดชอบ
การสรุปผลในระบบผลิตซ้ำการแปลงทั้งหมดในช่วงการฝึกและส่งคืนการทำนายภายใต้ข้อจำกัดของความหน่วง, ปริมาณการทำงาน, และความพร้อมใช้งาน แพคเกจการเตรียมข้อมูลล่วงหน้าพร้อมโมเดล, ตรวจสอบ schema ของอินพุต, เวอร์ชันของศิลปวัตถุ, และเปรียบเทียบผลลัพธ์ระหว่างการทำงานแบบออฟไลน์และการให้บริการ เลือกเกณฑ์โดยอิงจากความสามารถในการดำเนินงานและการแลกเปลี่ยนข้อผิดพลาดแทนการตั้งค่าเริ่มต้นเป็น 0.5 ปล่อยใช้งานผ่านการประเมินแบบเงา, กลุ่มจำกัด, หรือการทดลองที่มีเมตริกส์เป็นแนวป้องกัน เก็บ fallback ที่กำหนดได้และเส้นทาง rollback สำหรับความล้มเหลวของการพึ่งพาหรือพฤติกรรมที่ยอมรับไม่ได้
เฝ้าติดตามคุณภาพของอินพุต, การเปลี่ยนแปลงของคุณลักษณะ, การกระจายของการทำนาย, calibration, ผลลัพธ์ของกลุ่มย่อย, ความหน่วง, ค่าใช้จ่าย, และป้ายกำกับที่ยืนยันเมื่อมาถึง การเปลี่ยนแปลง (drift) เป็นสัญญาณให้ตรวจสอบ ไม่ใช่หลักฐานอัตโนมัติว่าการฝึกใหม่จะช่วยได้ การฝึกใหม่ต้องมีข้อมูลที่ตรวจสอบ, การทดสอบที่ทำซ้ำได้, การอนุมัติ, และการเปรียบเทียบกับโมเดลปัจจุบัน บันทึกการใช้ที่ตั้งใจและการใช้ที่ไม่ถูกต้อง, สิทธิ์ข้อมูล, ความเป็นส่วนตัว, ความปลอดภัย, การแทรกแซงของมนุษย์, และการอุทธรณ์เมื่อผู้คนได้รับผลกระทบ การเรียนรู้ของเครื่องเป็นระบบการตัดสินใจที่ได้รับการบำรุงรักษา; ไฟล์โมเดลเป็นเพียงส่วนประกอบที่สามารถเปลี่ยนได้หนึ่งส่วน
ตัวอย่างการทำงาน: การทำนายการเสียของอุปกรณ์
ผู้ผลิตกำหนดการทำนายหนึ่งครั้งต่อเครื่อง‑วัน: ว่าการเสียที่ตรวจสอบแล้วจะเกิดขึ้นภายในเจ็ดวันโดยใช้ข้อมูลเทเลเมตรีที่มีอยู่ตั้งแต่ต้นวันนั้น แบ่งข้อมูลตามเครื่องและเวลา, เปรียบเทียบกับกฎที่อิงอายุและเกณฑ์, ปรับการเตรียมข้อมูลล่วงหน้าบนข้อมูลฝึก, และประเมินการเรียกคืนเหตุการณ์, การแจ้งเตือนเท็จ, ระยะเวลาตักเตือนล่วงหน้า, calibration, และความจุการบำรุงรักษา การเปลี่ยนเซ็นเซอร์และการปิดเครื่องตามแผนถูกจำลองเป็นบริบทการทำงานแทนที่จะถือเป็นการสังเกตปกติ
โมเดลแรกเริ่มทำงานในโหมดเงา การแจ้งเตือนแสดงเทเลเมตรีที่มีส่วนร่วมและความไม่แน่นอน แต่ผู้ดูแลตัดสินใจว่าจะตรวจสอบหรือไม่ ผลการค้นพบและสาเหตุที่ยืนยันกลายเป็นป้ายกำกับที่ควบคุม; การไม่มีใบสั่งงานไม่ได้ถือว่าไม่มีการเสีย การปล่อยใช้งานแบบขั้นเป็นขั้นใช้ขีดจำกัดการแจ้งเตือนและ fallback แบบแมนนวล พร้อมกับการเฝ้าติดตามสุขภาพเซ็นเซอร์, การเปลี่ยนแปลงอินพุต, precision ที่ตรวจสอบ, เวลาหยุดทำงาน, และการบำรุงรักษาที่ไม่จำเป็น การฝึกใหม่เกิดขึ้นเฉพาะหลังจากการตรวจสอบข้อมูลและเกณฑ์แสดงให้เห็นว่ามีแนวโน้มปรับปรุงเหนือระบบที่ใช้งานอยู่ในปัจจุบัน
หลักฐานการนำไปใช้และความพร้อมในการดำเนินงาน
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละอย่าง สร้างฐานที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับ calibration หรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทั้งหมดเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนการเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การ rollback, และการยุติ ใช้การปล่อยแบบขั้นเป็นขั้น, รักษา fallback ที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยการฉีดความล้มเหลวโดยเจตนา เทเลเมตรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการนำไปใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่บำรุงรักษาต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดที่ชัดเจนที่ควรปิดการทำงานหรือเปลี่ยนทดแทน
อ้างอิงหลัก