พื้นฐาน AI
การเรียนรู้เชิงลึกคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Deep learning คือครอบครัวของวิธีการเรียนรู้ของเครื่องที่ใช้เครือข่ายประสาทเทียมหลายชั้นเพื่อเรียนรู้การแทนข้อมูลที่มีประโยชน์ โมเดลเหล่านี้เป็นพื้นฐานของระบบสมัยใหม่หลายประเภทสำหรับภาษา ภาพ เสียง การแนะนำ การทำนายทางวิทยาศาสตร์ และ AI เชิงสร้างสรรค์
คำว่า deep หมายถึงจำนวนการแปลงระหว่างอินพุตและเอาต์พุต ไม่ได้หมายถึงเครื่องที่มีความเข้าใจลึกซึ้ง โมเดลเชิงลึกเรียนรู้ความสัมพันธ์เชิงตัวเลขที่เป็นประโยชน์ต่อวัตถุประสงค์การฝึกของมัน และประสิทธิภาพของมันยังต้องได้รับการทดสอบบนข้อมูลใหม่
ประเด็นสำคัญ
- การเรียนรู้เชิงลึกเป็นส่วนย่อยของ การเรียนรู้ของเครื่อง
- ชั้นต่าง ๆ แปลงเทนเซอร์โดยใช้พารามิเตอร์ที่เรียนรู้ การกระตุ้นเชิงไม่เชิงเส้น การทำให้เป็นมาตรฐาน และการดำเนินการอื่น ๆ
- การย้อนกลับ (Backpropagation) คำนวณเกรเดียนท์; ตัวปรับแต่งใช้เกรเดียนท์เหล่านั้นเพื่ออัปเดตพารามิเตอร์ที่สามารถฝึกได้ รวมถึงน้ำหนักและไบอัส
- CNNs, เครือข่ายวนซ้ำ, Transformers, Autoencoders, และโมเดลการแพร่กระจายมีโครงสร้างและจุดแข็งที่แตกต่างกัน
วิธีที่เครือข่ายประสาทเทียมเชิงลึกเรียนรู้
เครือข่ายประสาทเทียมรับข้อมูลเป็น เทนเซอร์ หรืออาเรย์หลายมิติของตัวเลข เทนเซอร์ภาพอาจบรรจุช่องสีพิกเซล ในขณะที่โมเดลภาษาใช้เวกเตอร์ที่แทนโทเคนแต่ละตัว แต่ละชั้นทำการแปลงที่สามารถหาอนุพันธ์ได้และส่งผลลัพธ์ต่อไปยังชั้นถัดไป
ในชั้นหนาแน่นพื้นฐาน โมเดลคำนวณผลรวมถ่วงน้ำหนักของอินพุต, เพิ่มไบอัสที่สามารถฝึกได้, แล้วจึงใช้ฟังก์ชันกระตุ้น:
output = activation(Wx + b)
ฟังก์ชันกระตุ้นทำให้เกิดความไม่เชิงเส้น หากไม่มีฟังก์ชันนี้ การวางชั้นเชิงเส้นธรรมดาติดกันหลายชั้นยังคงเป็นการแปลงเชิงเส้นเท่านั้น ReLU และรูปแบบย่อยของมันเป็นที่นิยมในชั้นซ่อน, ส่วนฟังก์ชันกระตุ้นที่ระดับเอาต์พุตขึ้นอยู่กับงาน
การฝึกมักทำตามสี่ขั้นตอน:
- การทำ forward pass สร้างการทำนาย
- ฟังก์ชัน loss วัดความแตกต่างระหว่างการทำนายกับวัตถุประสงค์
- Backpropagation ใช้กฎลูกโซ่เพื่อคำนวณเกรเดียนท์ของ loss ต่อแต่ละพารามิเตอร์ที่สามารถฝึกได้
- ตัวปรับแต่งเช่น stochastic gradient descent หรือ AdamW ปรับพารามิเตอร์
การทำซ้ำขั้นตอนเหล่านี้บนหลายแบตช์สามารถปรับปรุงโมเดลได้, แต่ loss การฝึกที่ต่ำไม่รับประกันพฤติกรรมที่เชื่อถือได้ในโลกจริง การตรวจสอบ, การทำให้เป็นปกติ, ข้อมูลที่เป็นตัวแทน, และการเฝ้าติดตามยังคงเป็นสิ่งสำคัญ
สถาปัตยกรรมการเรียนรู้เชิงลึกหลัก
เพอร์เซปตรอนหลายชั้น
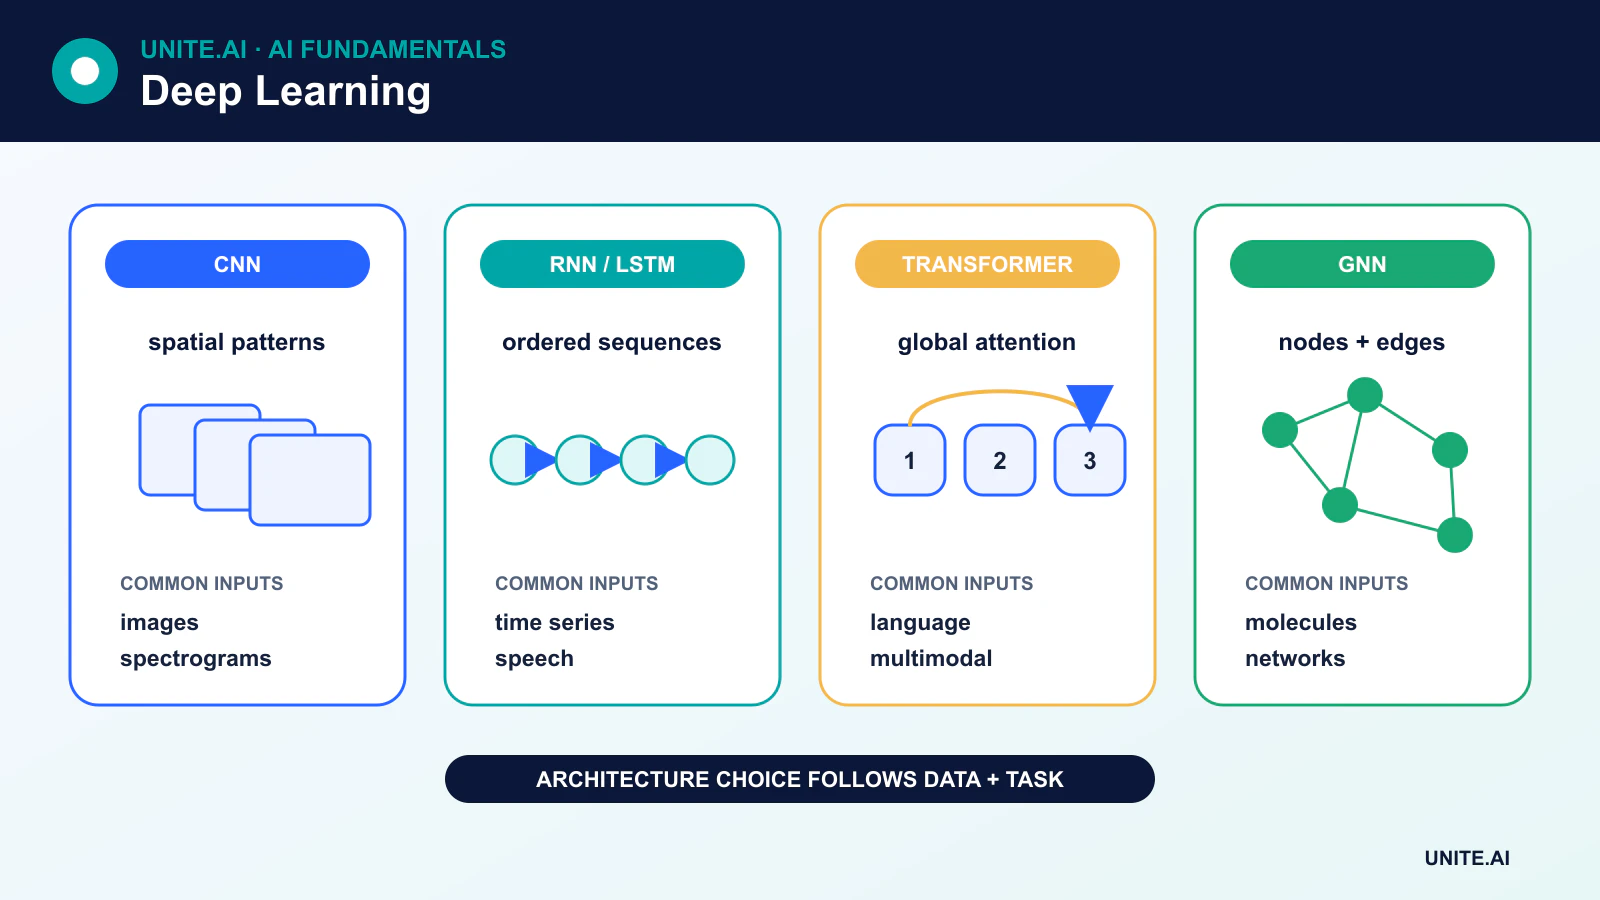
เพอร์เซปตรอนหลายชั้น (MLP) ใช้ชั้นที่เชื่อมต่อเต็มรูปแบบ ซึ่งหน่วยเอาต์พุตแต่ละหน่วยพึ่งพาข้อมูลอินพุตทั้งหมดจากชั้นก่อนหน้า MLP มีประโยชน์สำหรับคุณลักษณะแบบตารางและเป็นส่วนประกอบภายในระบบขนาดใหญ่, แต่ไม่ได้สมมติฐานเกี่ยวกับความเป็นท้องถิ่นของภาพหรือลำดับของข้อมูล
เครือข่ายประสาทเทียมแบบคอนโวลูชัน
เครือข่ายประสาทเทียมแบบคอนโวลูชัน (CNNs) ใช้ตัวกรองที่เรียนรู้ผ่านพื้นที่ท้องถิ่น การแชร์น้ำหนักทำให้มีประสิทธิภาพสำหรับกริดเช่นภาพและสเปคโตรแกรม CNNs ยังคงสำคัญสำหรับการมองเห็นและการใช้งานบนอุปกรณ์ขอบ, แม้ว่า vision transformers และโมเดลไฮบริดจะได้รับการใช้งานอย่างกว้างขวาง
เครือข่ายวนซ้ำ, LSTM, และ GRU
เครือข่ายประสาทเทียมวนซ้ำ (RNNs) ปรับสถานะซ่อนเมื่อประมวลผลลำดับ LSTM และ gated recurrent units ช่วยรักษาข้อมูลและลดปัญหา vanishing‑gradient ที่ทำให้ RNN พื้นฐานทำงานได้ยากกับการพึ่งพาระยะยาว พวกมันไม่ได้ขจัดข้อจำกัดของบริบทยาวทั้งหมด, แต่ยังคงมีประโยชน์สำหรับสัญญาณสตรีม, ข้อมูลชุดเวลา, และโมเดลลำดับที่กะทัดรัด
ทรานส์ฟอร์มเมอร์
ทรานส์ฟอร์มเมอร์ ใช้ attention เพื่อจำลองความสัมพันธ์ระหว่างองค์ประกอบของลำดับหรือชุด ความสามารถในการประมวลผลตำแหน่งหลายตำแหน่งพร้อมกันทำให้พวกมันแทนที่การวนซ้ำในระบบภาษาขนาดใหญ่ส่วนใหญ่, และรูปแบบของทรานส์ฟอร์มเมอร์ในปัจจุบันยังประมวลผลภาพ, เสียง, วิดีโอ, โปรตีน, และข้อมูลหลายโหมด
ออโต้เอนโค้ดเดอร์และโมเดลเชิงสร้าง
ออโต้เอนโค้ดเดอร์ บีบอัดอินพุตเป็นการแทนและสร้างอินพุตจากการแทนนั้นใหม่ ซึ่งสร้างวัตถุประสงค์การสร้างซูเปอร์ไวส์; แต่ไม่ได้แปลงข้อมูลที่ไม่มีป้ายเป็นตัวอย่างที่มีป้ายโดยอัตโนมัติ
เครือข่ายสร้างสรรค์แบบต่อสู้กัน (Generative adversarial networks) ฝึกตัวสร้างและตัวแยกโดยการแข่งขัน โมเดลการแพร่กระจาย (Diffusion models) เรียนรู้การย้อนกลับกระบวนการเพิ่มสัญญาณอย่างค่อยเป็นค่อยไป โมเดลทรานส์ฟอร์มเมอร์แบบอัตโนมัติสร้างโทเคนหรือหน่วยหนึ่งต่อครั้ง วิธีการเหล่านี้มีไดนามิกการฝึกที่แตกต่าง, ความสามารถในการควบคุม, และความต้องการคอมพิวเตอร์ที่แตกต่างกัน
ทำไมความลึกจึงช่วย—และทำไมสถาปัตยกรรมถึงสำคัญ
หลายชั้นทำให้โมเดลสามารถประกอบการแปลงที่ง่ายขึ้นเป็นการแปลงที่ซับซ้อนมากขึ้น ในการมองเห็น, คุณลักษณะที่เรียนรู้อาจพัฒนาจากพื้นผิวท้องถิ่นไปสู่รูปแบบเฉพาะงาน ในภาษา, ชั้น attention สร้างการแทนโทเคนที่ขึ้นกับบริบท คำอธิบายเหล่านี้เป็นการเข้าใจเชิงสัญชาตญาณที่เป็นประโยชน์, ไม่ใช่กฎคงที่ว่าชั้นแต่ละชั้นต้องเรียนรู้อะไร
เครือข่ายสมัยใหม่ยังพึ่งพาการเชื่อมต่อแบบ residual, การทำให้เป็นมาตรฐาน, การกำหนดค่าเริ่มต้นอย่างระมัดระวัง, การทำให้เป็นปกติ, และฮาร์ดแวร์ที่ปรับแต่ง การเพิ่มชั้นหรือพารามิเตอร์อย่างง่ายอาจทำให้โมเดลฝึกได้ยาก, ช้าลง, หรือเสี่ยงต่อ overfitting มากขึ้น ขนาดของโมเดลช่วยได้เฉพาะเมื่อข้อมูล, วัตถุประสงค์, การปรับแต่ง, และสภาพแวดล้อมการใช้งานสนับสนุน
การฝึกเทียบกับการสรุปผล (Inference)
การฝึก ปรับพารามิเตอร์และมักเป็นขั้นตอนที่ใช้คอมพิวเตอร์มากที่สุด การสรุปผล รันโมเดลที่ฝึกแล้วเพื่อสร้างเอาต์พุต การสรุปผลอาจยังคงมีค่าใช้จ่ายสูงสำหรับโมเดลขนาดใหญ่, จึงทำให้ทีมใช้การควบคุมจำนวนบิต (quantization), การสรุป (distillation), การทำแบตช์, การแคช, ความบาง (sparsity), และฮาร์ดแวร์พิเศษเช่น หน่วยประมวลผลประสาท (neural processing units)
ข้อจำกัดและการใช้ที่รับผิดชอบ
โมเดลเชิงลึกอาจสืบทอดอคติ, จำข้อมูลที่ละเอียดอ่อน, ล้มเหลวภายใต้การเปลี่ยนแปลงการกระจาย, และสร้างผลลัพธ์ที่ดูสมจริงแต่ไม่ถูกต้อง พวกมันยังอาจยากต่อการอธิบายและมีค่าใช้จ่ายสูงในการฝึก การประเมินควรครอบคลุมมากกว่าค่าเฉลี่ยของเบนช์มาร์ค: ทีมต้องการประสิทธิภาพระดับคลาสหรือกลุ่มย่อย, ความทนทาน, การปรับเทียบ, ความปลอดภัย, ความหน่วง, การใช้พลังงาน, และผลลัพธ์ของความล้มเหลว
การแทน, การปรับแต่ง, และการเลือกสถาปัตยกรรม
เครือข่ายเชิงลึกเรียนรู้การแทนต่อเนื่องผ่านชั้นที่มีพารามิเตอร์ การแปลงเชิงเส้นผสมอินพุต; การกระตุ้นเชิงไม่เชิงเส้นทำให้เครือข่ายประมาณฟังก์ชันซับซ้อน; การทำให้เป็นมาตรฐานและการเชื่อมต่อแบบ residual ช่วยการปรับแต่ง; attention, convolution, recurrence, หรือการดำเนินการแบบ state‑space เข้ารหัสสมมติฐานโครงสร้างที่แตกต่าง ความลึกเพิ่มจำนวนการแปลง ไม่ได้รับประกันความฉลาด สถาปัตยกรรมควรสะท้อนถึงโหมด, ปริมาณข้อมูล, ความหน่วง, หน่วยความจำ, และความไม่เปลี่ยนแปลงของงาน โมเดลคอนโวลูชันขนาดเล็กอาจทำผลงานดีกว่า transformer เมื่อข้อมูลจำกัดและโครงสร้างเชิงพื้นที่ท้องถิ่นเป็นหลัก
การฝึกคำนวณ loss, ทำอนุพันธ์ด้วย backpropagation, และอัปเดตพารามิเตอร์ด้วยตัวปรับแต่งเช่น stochastic gradient descent หรือ Adam ขนาดแบตช์, อัตราการเรียนรู้, ตารางการเรียน, การกำหนดค่าเริ่มต้น, การทำให้เป็นปกติ, และความแม่นยำเชิงตัวเลขมีผลต่อกัน กราฟของ loss การฝึกและ validation ช่วยแยกแยะ underfitting, overfitting, ความไม่เสถียร, และการรั่วไหล, แต่ไม่ได้ยืนยันความเป็นประโยชน์ในโลกจริง ใช้ข้อมูลประเมินอิสระ, การรันซ้ำเมื่อความแปรปรวนสำคัญ, การตัดส่วน, และการเปรียบเทียบกับ baseline ที่ง่ายกว่า จำนวนพารามิเตอร์ที่มากยังเพิ่มความต้องการการกำกับข้อมูล, การวางแผนคอมพิวเตอร์, และการกำหนดค่าที่ทำซ้ำได้
การให้บริการโมเดลเชิงลึกอย่างปลอดภัยและมีประสิทธิภาพ
การปรับใช้สามารถใช้ endpoint ที่โฮสต์, ตัวเร่งความเร็วเฉพาะ, เบราว์เซอร์, โทรศัพท์, หรืออุปกรณ์ฝังตัว การส่งออกและการคอมไพล์อาจรวมตัวดำเนินการ, ควบคุมจำนวนบิตของน้ำหนักและการกระตุ้น, หรือเปลี่ยนแปลงพฤติกรรมเชิงตัวเลข ดังนั้นต้องตรวจสอบศิลปวัตถุที่ปรับใช้แทนการตรวจสอบเฉพาะ checkpoint การฝึก วัด cold start, latency คงที่, throughput, หน่วยความจำ, พลังงาน, และคุณภาพที่ขนาดแบตช์และลำดับที่สมจริง วิธีการบีบอัด—การตัดส่วน, การสรุป, การควบคุมจำนวนบิต, และการปรับสเกลต่ำ—แลกเปลี่ยนขนาดหรือความเร็วกับความแม่นยำและความซับซ้อนของวิศวกรรม และต้องประเมินบนคลาสที่อ่อนไหวและกรณีขอบ
โมเดลเชิงลึกอาจล้มเหลวอย่างมั่นใจภายใต้การเปลี่ยนแปลงการกระจาย, อินพุตที่เป็นศัตรู, ความสัมพันธ์เทียม, และกลุ่มที่มีการแทนที่ไม่ดี เฝ้าติดตามการกระจายของอินพุตและเอาต์พุต, ผลลัพธ์ของงาน, การปรับเทียบ, การใช้ทรัพยากร, และเวอร์ชันของ dependencies ใช้การควบคุมการเข้าถึง, ศิลปวัตถุที่ลงนาม, ข้อมูลฝึกที่ได้รับการปกป้อง, การทดสอบความปลอดภัย (red teaming), และการจำกัดอัตราตามโมเดลภัยคุกคาม คำอธิบายเช่นแผนที่ความสำคัญ (saliency maps) หรือมุมมอง attention เป็นหลักฐานวินิจฉัย ไม่ใช่หลักฐานของสาเหตุ ผสานกับการทดสอบพฤติกรรม, การสร้างสถานการณ์ตรงกันข้าม, การตรวจสอบโดยมนุษย์, การตอบสนองต่อเหตุการณ์, และการกำหนดขอบเขตที่ชัดเจนสำหรับการตัดสินใจอัตโนมัติ
ตัวอย่างการทำงาน: การฝึกตัวตรวจจับข้อบกพร่องของภาพ
โรงงานรวบรวมภาพผลิตภัณฑ์จากกล้อง, ช่วงเวลา, วัสดุ, และประเภทข้อบกพร่องที่รู้จัก, จากนั้นแบ่งตามแบตช์การผลิตเพื่อให้รายการที่คล้ายกันไม่ข้ามพาร์ทิชัน โมเดลคอนโวลูชันขนาดเล็กเป็น baseline ที่เปรียบเทียบกับเครือข่ายเชิงลึกที่ผ่านการฝึกล่วงหน้า การเพิ่มข้อมูลจำลองแสงและมุมมองที่ตรวจสอบได้โดยไม่ลบข้อบกพร่อง การประเมินรายงานค่า recall ต่อข้อบกพร่อง, อัตราการปฏิเสธเท็จ, การปรับเทียบ, latency ของการสรุปผล, และความทนทานต่อเบลอ, แสงจ้า, การเปลี่ยนกล้อง, และสีวัสดุที่หายาก
โมเดลที่ส่งออกและโค้ดการปรับขนาด, สี, และการทำให้เป็นมาตรฐานที่แม่นยำถูกทดสอบบนฮาร์ดแวร์สายการผลิตเพื่อวัด throughput ต่อเนื่องและพฤติกรรมความร้อน กรณีที่ความเชื่อมั่นต่ำจะส่งต่อให้ผู้ตรวจสอบ; กฎอิสระหนึ่งหยุดสายการผลิตเมื่อเซ็นเซอร์สำคัญล้มเหลว ภาพจะถูกเก็บรักษาตามที่อนุญาตและศิลปวัตถุของโมเดลจะถูกลงนาม การเฝ้าติดตามเชื่อมการทำนายกับผลการตรวจสอบภายหลังและล็อตการผลิต กล้องหรือวัสดุใหม่จะกระตุ้นการประเมินใหม่อย่างควบคุม แทนการเรียนรู้ออนไลน์โดยไม่มีการตรวจสอบ
หลักฐานการดำเนินการและความพร้อมใช้งาน
การตัดสินใจเชิงผลิตต้องการมากกว่าการสาธิตที่สำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, dependencies, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของ dependencies, การใช้งานผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจได้รับบริการไม่เพียงพอ วัดคุณภาพงานร่วมกับการปรับเทียบหรือความไม่แน่นอน, latency, throughput, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนการเปิดตัว, กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวแบบขั้นเป็นขั้น, รักษา fallback ที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ถูกฉีดอย่างตั้งใจ Telemetry การทำงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะของ dependencies, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนเกินความจำเป็น กำหนดเกณฑ์การเตือนและเจ้าของการตอบสนอง, แล้วตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
อ้างอิงหลัก