
พื้นฐาน AI
CNN คืออะไร (Convolutional Neural Networks)

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
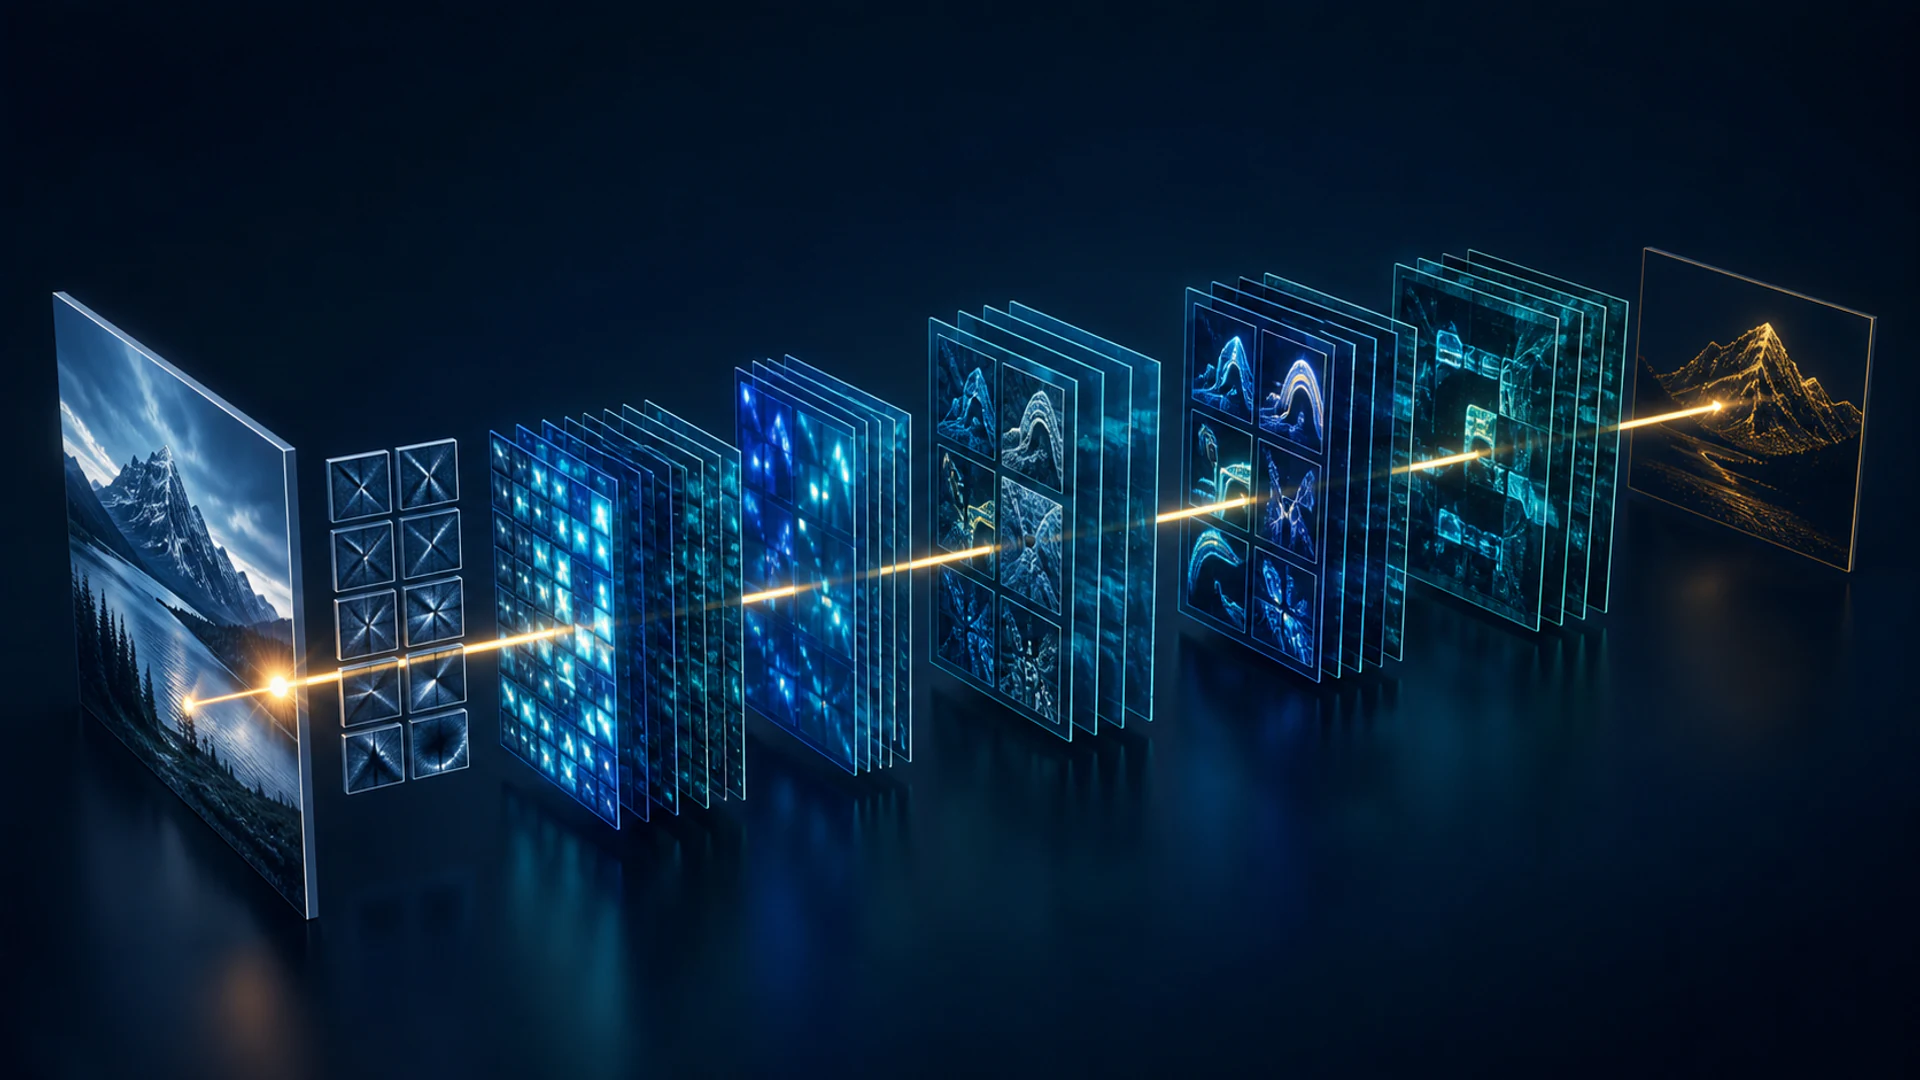
A convolutional neural network (CNN) คือสถาปัตยกรรมเครือข่ายประสาทที่ใช้ฟิลเตอร์ที่เรียนรู้ได้บนพื้นที่ท้องถิ่นของอินพุต CNN กลายเป็นพื้นฐานของ computer vision เนื่องจากสามารถตรวจจับรูปแบบได้โดยไม่คำนึงว่ารูปแบบนั้นปรากฏที่ใดและใช้พารามิเตอร์เดียวกันซ้ำทั่วภาพ
CNN ไม่ได้แปลงภาพจากรูปแบบที่ไม่เป็นตัวเลขเป็นตัวเลข—ภาพนั้นมาถึงแล้วในรูปของเทนเซอร์ของค่าพิกเซล จุดประสงค์ของมันคือการแปลงเทนเซอร์นั้นเป็นแผนที่คุณลักษณะที่มีประโยชน์สำหรับการจำแนกประเภท การตรวจจับ การแบ่งส่วน หรือภารกิจอื่น ๆ
ประเด็นสำคัญ
- การคอนโวลูชันผสานค่าตัวอินพุตท้องถิ่นกับเคอร์เนลที่เรียนรู้เพื่อสร้างแผนที่คุณลักษณะ
- Stride, padding, dilation, และ pooling ควบคุมความละเอียดเชิงพื้นที่และ receptive field
- การแชร์น้ำหนักทำให้ CNN มีประสิทธิภาพพารามิเตอร์มากกว่าการใช้เครือข่าย fully connected บนพิกเซลดิบ
- Vision transformers เป็นทางเลือกหนึ่ง แต่ CNN ยังคงแข็งแกร่งสำหรับระบบที่มีประสิทธิภาพและข้อมูลจำกัด
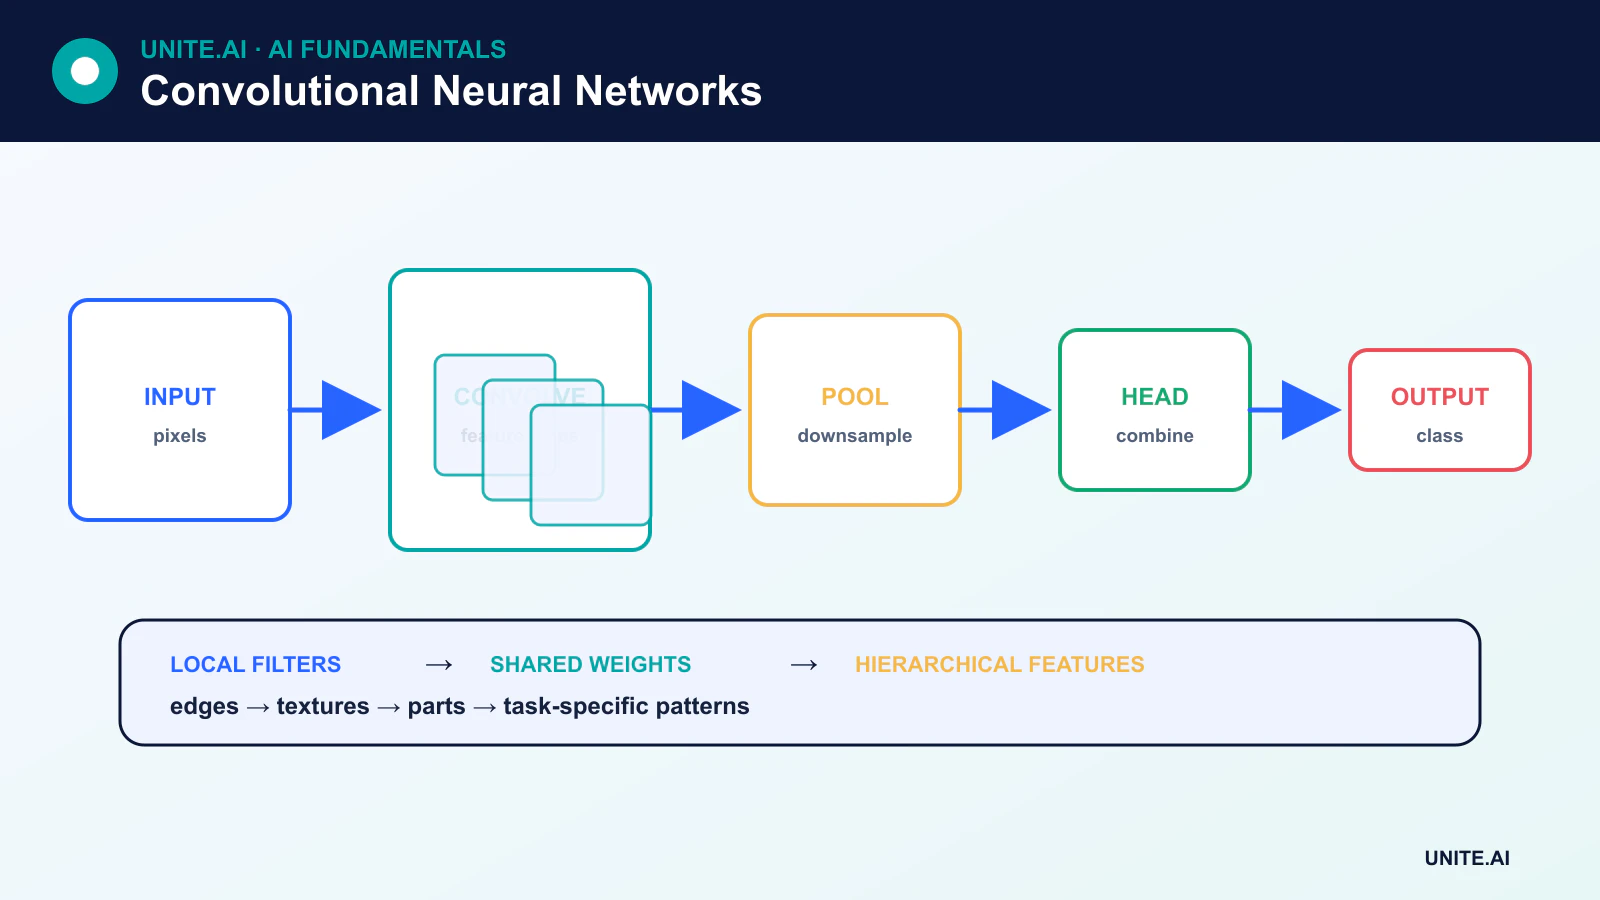
วิธีการทำงานของคอนโวลูชัน
เคอร์เนลคือกริดขนาดเล็กของน้ำหนักที่สามารถฝึกได้ ในแต่ละตำแหน่ง CNN จะคูณค่าของเคอร์เนลกับค่าตัวอินพุตที่สอดคล้องกัน, รวมผลลัพธ์และโดยปกติจะเพิ่ม bias การทำซ้ำขั้นตอนนี้ทั่วอินพุตจะสร้างแผนที่คุณลักษณะ
สำหรับภาพสี เคอร์เนลจะครอบคลุมทุกช่องอินพุต ชั้นหนึ่งจะใช้เคอร์เนลหลายตัวเพื่อสร้างหลายช่องเอาต์พุต ระหว่างการฝึก backpropagation จะคำนวณเกรเดียนต์สำหรับน้ำหนักเคอร์เนลเหล่านี้; การคอนโวลูชันไม่ได้สร้างชุดน้ำหนักคงที่ใหม่จากแต่ละภาพ
Stride, padding, และ dilation
- Stride ควบคุมระยะที่เคอร์เนลเคลื่อนที่ Stride ที่มากกว่าหนึ่งจะลดความละเอียดเชิงพื้นที่
- Padding เพิ่มค่าใส่รอบอินพุตเพื่อให้ข้อมูลขอบสามารถประมวลผลและขนาดผลลัพธ์สามารถควบคุมได้
- Dilation ทำให้ส่วนประกอบของเคอร์เนลห่างกัน เพิ่ม receptive field โดยไม่เพิ่มพารามิเตอร์อย่างสัดส่วน
receptive field คือบริเวณของอินพุตต้นฉบับที่สามารถมีอิทธิพลต่อหน่วยหนึ่ง ๆ การซ้อนคอนโวลูชันหลายชั้นทำให้ขนาดขยายขึ้น ทำให้ฟีเจอร์ในชั้นต่อมาสามารถรวมข้อมูลจากพื้นที่กว้างขึ้นได้
Activation, normalization, และ pooling
ชั้นคอนโวลูชันมักตามด้วยฟังก์ชันเปิดใช้งานแบบไม่เชิงเส้นและการทำ normalization Pooling จะสรุปข้อมูลในพื้นที่ท้องถิ่นโดยใช้การดำเนินการเช่นค่าสูงสุดหรือค่าเฉลี่ย คอนโวลูชันแบบ stride ที่เรียนรู้ได้ก็สามารถทำการลดขนาดได้เช่นกัน
Pooling ไม่ได้เป็นข้อบังคับ เครือข่ายสมัยใหม่หลายแบบใช้ global average pooling ใกล้กับเอาต์พุตแทนการแปลงแผนที่คุณลักษณะขนาดใหญ่เป็นสแตก fully connected วิธีนี้ช่วยลดพารามิเตอร์และให้เครือข่ายสามารถรวมหลักฐานเชิงพื้นที่ได้
สถาปัตยกรรม CNN สมัยใหม่
โมเดลวิชั่นทั่วไปประกอบด้วย stem, ลำดับของบล็อกฟีเจอร์, ขั้นตอนการลดขนาด, และหัวงาน (task head) การเชื่อมต่อแบบ residual ทำให้บล็อกสามารถเรียนรู้การปรับเปลี่ยนอินพุตและให้เส้นทางโดยตรงสำหรับข้อมูลและเกรเดียนต์ ความสำเร็จของเครือข่าย residual ทำให้การฝึก CNN ที่ลึกมากเป็นไปได้ในเชิงปฏิบัติ
หัวการจำแนกประเภท (classification heads) จะให้คะแนนคลาส หัวการตรวจจับ (detection heads) จะทำนายประเภทและกล่องสี่เหลี่ยม สถาปัตยกรรมการแบ่งส่วน (segmentation) จะเพิ่มเส้นทาง decoder เพื่อกู้คืนรายละเอียดเชิงพื้นที่ CNN backbone เดียวกันสามารถนำกลับมาใช้ใหม่ผ่าน transfer learning
สิ่งที่ชั้น CNN เรียนรู้
มักมีการแสดงภาพฟิลเตอร์ช่วงแรกที่ตอบสนองต่อขอบหรือพื้นผิวและการแสดงผลในชั้นลึกที่สอดคล้องกับส่วนหรือวัตถุ นี่เป็นแนวคิดที่มีประโยชน์แต่ไม่ใช่กฎตายตัว ฟีเจอร์ขึ้นอยู่กับงาน, สถาปัตยกรรม, ข้อมูล, วัตถุประสงค์, และกระบวนการฝึกบางหน่วยอาจรวมข้อมูลที่ไม่สามารถแมปกับแนวคิดของมนุษย์ได้อย่างชัดเจน
CNN กับ Vision Transformers
Vision transformers แบ่งภาพเป็นแพตช์และใช้ attention เพื่อจำลองความสัมพันธ์ระหว่างแพตช์ สามารถขยายขนาดได้อย่างมีประสิทธิภาพเมื่อมีชุดข้อมูลการฝึกล่วงหน้าขนาดใหญ่ CNN สร้างสมมติฐานเรื่อง locality และการแปล (translation) ไว้ในสถาปัตยกรรมโดยตรง ซึ่งทำให้มันมีประสิทธิภาพและใช้ข้อมูลได้ดีในสภาพแวดล้อมที่มีข้อมูลจำกัด
ระบบจริงหลายแบบผสานคอนโวลูชันและ attention สถาปัตยกรรมที่เหมาะสมขึ้นอยู่กับความแม่นยำ, ความหน่วง, หน่วยความจำ, ข้อมูลการฝึก, ฮาร์ดแวร์, และการใช้งาน—not on which family is newest.
ข้อจำกัดและข้อพิจารณาเชิงปฏิบัติ
CNN อาจไวต่อการเปลี่ยนแปลงการกระจาย, การรบกวนแบบ adversarial, ทางลัดของพื้นหลัง, และข้อมูลฝึกที่มีอคติ พวกมันไม่ได้เป็นอิสระต่อการเปลี่ยนตำแหน่ง, การหมุน, ขนาด, หรือมุมมอง การทำ augmentation และการเลือกสถาปัตยกรรมอาจช่วยเพิ่มความทนทานได้แต่ไม่รับประกัน
สำหรับการใช้งาน ควรวัด latency, หน่วยความจำ, throughput, และพฤติกรรมของกลุ่มย่อย การทำ quantization และ pruning สามารถลดค่าใช้จ่ายได้โดยเฉพาะสำหรับ edge AI แต่โมเดลที่ถูกบีบอัดต้องผ่านการตรวจสอบใหม่
คอนโวลูชัน, receptive fields, และบล็อก CNN สมัยใหม่
ชั้นคอนโวลูชันเลื่อนเคอร์เนลที่เรียนรู้ผ่านกริดและแชร์น้ำหนักระหว่างตำแหน่งต่าง ๆ ขนาดเคอร์เนล, stride, dilation, และ padding กำหนดรูปร่างเอาต์พุตและ receptive field ชั้นแรกมักตอบสนองต่อขอบหรือพื้นผิวในระดับท้องถิ่น; ชั้นลึกจะรวมข้อมูลจากพื้นที่กว้างขึ้น แม้การแสดงผลที่เรียนรู้จะไม่จำเป็นต้องแมปกับแนวคิดของมนุษย์อย่างชัดเจน Pooling หรือคอนโวลูชันแบบ stride จะลดความละเอียดเชิงพื้นที่ ช่อง (channels) ถือแผนที่คุณลักษณะ, ในขณะที่การคอนโวลูชันแบบ grouped และ depthwise separable จะแลกเปลี่ยนการผสมข้ามช่องเพื่อคำนวณที่ต่ำกว่า การเชื่อมต่อแบบ residual ทำให้เครือข่ายลึกมากง่ายต่อการปรับแต่ง
สำหรับความสูงและความกว้างของอินพุต, padding ควบคุมการจัดการขอบและ stride ควบคุมการสุ่มตัวอย่าง การลดขนาดอย่างรุนแรงอาจทำให้วัตถุเล็กหายไป; zero padding อาจสร้าง artefacts ที่ขอบ; dilation ขยายบริบทโดยไม่เพิ่มพารามิเตอร์อย่างเท่ากันแต่สามารถทำให้เกิด gridding Batch normalization พึ่งพาสถิติการฝึก, ในขณะที่ทางเลือกอื่นอาจทำงานได้ดีใน batch ขนาดเล็ก สถาปัตยกรรมสมัยใหม่ผสาน bottlenecks, ฟีเจอร์หลายสเกล, attention, หรือ inverted residuals เลือกสถาปัตยกรรมโดยพิจารณาความละเอียดของงาน, แบนด์วิดท์หน่วยความจำ, latency, และฮาร์ดแวร์เป้าหมาย มากกว่าความแม่นยำของการจำแนกภาพเพียงอย่างเดียว
การฝึก, การตีความ, และการใช้งาน
ใช้ augmentation ที่รักษา label และสะท้อนความแปรผันจริง, แบ่งข้อมูลตามหัวข้อหรือฉากก่อนทำ augmentation การเรียนรู้แบบ transfer learning เป็นเรื่องปกติ: แทนที่หัวงาน, ฝึกมัน, แล้วค่อยค่อยเปิดการฝึกของ backbone อย่างระมัดระวัง ประเมินประสิทธิภาพตามคลาส, การสอบเทียบ, ความทนทานต่อการเบลอ, การบีบอัด, แสง, สเกล, การครอป, และการรบกวนแบบ adversarial วิธีการ visualize เช่น แผนที่คุณลักษณะและ saliency สามารถเปิดเผยทางลัดได้ แต่ผลลัพธ์ขึ้นกับวิธีและ baseline ยืนยันการพึ่งพาที่สงสัยด้วยภาพ counterfactual, การทดสอบ occlusion, หรือการเปลี่ยนแปลงชุดข้อมูล
CNN ที่ส่งออกอาจถูก fuse, quantize, หรือคอมไพล์สำหรับ GPU, NPU, เบราว์เซอร์, หรือไมโครคอนโทรลเลอร์ ตรวจสอบกราฟที่ใช้งานรวมถึงขั้นตอน preprocessing และ postprocessing บนอุปกรณ์ที่ตรงกัน วัด latency, หน่วยความจำ, พลังงาน, และพฤติกรรมความร้อน; การ decode อินพุตอาจเป็นคอขวดของโมเดลขนาดเล็ก ตรวจสอบสถิติของกล้องและภาพ, การกระจายผลลัพธ์, และข้อผิดพลาดที่ยืนยัน โมเดลที่มีลายเซ็น, ช่องทางอัปเดตที่ปกป้อง, และการล้มเหลวของเซนเซอร์อย่างราบรื่นเป็นส่วนหนึ่งของการออกแบบผลิตภัณฑ์ CNN มี bias ของ locality ที่มีประโยชน์ แต่ไม่ได้ทำความเข้าใจวัตถุหรือฉากเชิงสาเหตุโดยอัตโนมัติ
ตัวอย่างการทำงาน: การใช้งาน CNN บนกล้องตรวจสอบ
CNN จำแนกข้อบกพร่องบนพื้นผิวจากภาพ line‑scan ความละเอียดสูง วิศวกรทำการตัดภาพเป็น tiles พร้อมส่วนทับเพื่อให้ข้อบกพร่องเล็ก ๆ ยังอยู่หลังการลดขนาด, เก็บพิกัดเพื่อการตรวจสอบ, และตรวจสอบ augmentation กับความแปรผันเชิงแสงจริง CNN residual และโมเดล depthwise ที่เบากว่าเปรียบเทียบที่ recall เท่ากัน การทดสอบรวมถึงข้อบกพร่องที่ขอบ, แสงจ้า, การบีบอัด, การเคลื่อนไหว, ชุดวัสดุ, และการเปลี่ยนกล้อง พร้อมกันนี้จัดสรรล็อตการผลิตอิสระสำหรับการประเมินขั้นสุดท้าย
การคอมไพล์ทำการ fuse และ quantize โมเดลสำหรับ edge accelerator แต่กราฟที่ใช้งานจริงจะเปรียบเทียบกับอ้างอิงในกรณีข้อบกพร่องที่ละเอียด การ decode, การตัดภาพ, การ inference, และ latency ของการรวมวัดจากต้นจนจบ ระบบทำเครื่องหมายพิกเซลตายและการเปลี่ยนแปลงค่า exposure แยกจากข้อบกพร่องของผลิตภัณฑ์ ผู้ปฏิบัติงานสามารถตรวจสอบ tiles ต้นฉบับและแก้ไขผลลัพธ์ โมเดลและการเปลี่ยนกล้องจะค่อย ๆ ปรับใช้ และสายการผลิตยังคงมีขั้นตอนตรวจสอบด้วยมืออย่างปลอดภัยเมื่อ pipeline วิชั่นไม่พร้อมใช้งาน
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจผลิตต้องมีมากกว่าการสาธิตที่สำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การขัดข้องของ dependencies, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการสอบเทียบหรือความไม่แน่นอน, latency, throughput, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดตัว มอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การ rollout แบบขั้นเป็นขั้น, เก็บ fallback ที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยการฉีดความล้มเหลวโดยเจตนา Telemetry การปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นโมเดลหรือกฎ, สถานะ dependencies, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, แล้วตรวจสอบหลักฐานจากโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์เปลี่ยน ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
CNN จำเป็นต้องใช้ pooling เสมอหรือไม่?
ไม่จำเป็น CNN สามารถลดขนาดด้วยคอนโวลูชันแบบ stride และสามารถรักษาความละเอียดสำหรับการพยากรณ์แบบหนาแน่นได้ Pooling เป็นเครื่องมือออกแบบหนึ่ง ไม่ใช่ข้อกำหนดที่กำหนดลักษณะของโมเดล
ฟิลเตอร์ของ CNN ถูกออกแบบด้วยมือหรือไม่?
ใน CNN ที่ผ่านการฝึก ค่าของเคอร์เนลส่วนใหญ่จะถูกเรียนรู้จากข้อมูล ซึ่งต่างจากฟิลเตอร์วิชั่นแบบคลาสสิกที่กำหนดค่าสัมประสิทธิ์ล่วงหน้าเพื่อทำงานเช่นการตรวจจับขอบ
อ้างอิงหลัก












