ไลบรารี Python
10 ไลบรารี Python ที่ดีที่สุดสำหรับการประมวลผลภาษาธรรมชาติ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
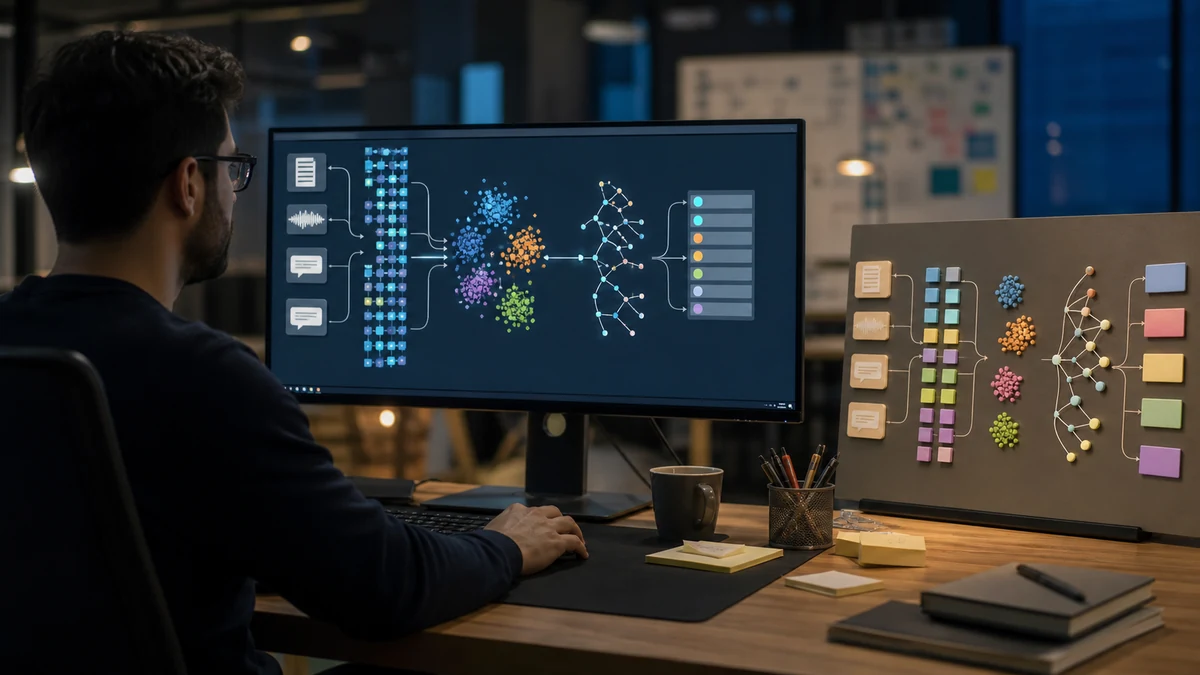
ไลบรารี Python สำหรับการประมวลผลภาษาธรรมชาติที่ดีที่สุดขึ้นอยู่กับงานที่คุณต้องทำ การสร้างคำตอบ การค้นหาเอกสารที่เกี่ยวข้อง การดึงชื่อองค์กร และการจัดประเภทใบแจ้งปัญหาจากฝ่ายสนับสนุน ล้วนเป็นโจทย์ที่แตกต่างกัน โมเดลขนาดใหญ่ที่ฝึกไว้ล่วงหน้าอาจมีประโยชน์ แต่ไปป์ไลน์เชิงสถิติขนาดเล็กกว่าอาจทำงานได้เร็วกว่า มีค่าใช้จ่ายต่ำกว่า และประเมินผลได้ง่ายกว่า เมื่อใช้กับงานที่กำหนดขอบเขตไว้อย่างแคบ
เราได้ประเมินไลบรารีทั้ง 10 รายการอย่างเป็นอิสระ โดยพิจารณาความสามารถ เอกสารประกอบ ข้อจำกัดในการใช้งานจริง ความเข้ากันได้กับระบบนิเวศ และความเหมาะสมกับเวิร์กโฟลว์ด้านล่าง Transformers โดดเด่นด้านการเข้าถึงโมเดลที่ฝึกไว้ล่วงหน้า spaCy เหมาะกับไปป์ไลน์ประมวลผลภาษาสำหรับใช้งานจริง และ Sentence Transformers เหมาะกับการค้นคืนข้อมูล การจัดอันดับนี้สะท้อนดุลยพินิจด้านบรรณาธิการ ไม่ใช่ผลการทดสอบเปรียบเทียบความเร็วหรือความแม่นยำแบบตัวต่อตัวที่จัดทำขึ้นใหม่
คู่มือนี้ครอบคลุมทั้งไลบรารีสำหรับทำงานเฉพาะด้านและโครงสร้างพื้นฐานสนับสนุน โดย Tokenizers และ Datasets ช่วยสร้างระบบประมวลผลภาษาธรรมชาติ แต่ไม่สามารถใช้แทนโมเดลหรือไปป์ไลน์วิเคราะห์ที่สมบูรณ์ได้ เราตรวจสอบความเข้ากันได้และการบำรุงรักษาจากเอกสารอย่างเป็นทางการและข้อมูลเมตาของแพ็กเกจ ณ เดือนตุลาคม 2026
เปรียบเทียบไลบรารี Python ที่ดีที่สุดสำหรับการประมวลผลภาษาธรรมชาติ
| เครื่องมือ AI | เหมาะที่สุดสำหรับ | ฟีเจอร์ |
|---|---|---|
| Transformers | โมเดลภาษาที่ฝึกไว้ล่วงหน้าและการสร้างข้อความ | โมเดล PyTorch; การอนุมาน; การปรับแต่งโมเดล; ไปป์ไลน์สำหรับงานต่าง ๆ |
| spaCy | ไปป์ไลน์ประมวลผลภาษาสำหรับใช้งานจริง | การตัดคำ; การรู้จำเอนทิตี; การวิเคราะห์โครงสร้างประโยค; กฎ; คอมโพเนนต์ที่กำหนดเอง |
| Sentence Transformers | เวกเตอร์ฝังตัว; การค้นคืนเชิงความหมาย; การจัดอันดับซ้ำ | ตัวเข้ารหัสแบบหนาแน่นและแบบเบาบาง; ตัวเข้ารหัสแบบไขว้; การค้นคืนแบบหลายเวกเตอร์ |
| scikit-learn | แบบจำลองพื้นฐานที่มีประสิทธิภาพสำหรับการจัดประเภทข้อความ | TF-IDF; คุณลักษณะแบบเบาบาง; ตัวจำแนกประเภท; ไปป์ไลน์; การประเมินผล |
| Stanza | การวิเคราะห์ภาษาหลายภาษา | การกำกับข้อมูลด้วยโครงข่ายประสาทเทียม; สัณฐานวิทยา; การวิเคราะห์โครงสร้างประโยคแบบพึ่งพา; เอนทิตี |
| NLTK | เรียนรู้การประมวลผลภาษาธรรมชาติและสำรวจคลังข้อความ | การตัดคำ; การตัดคำให้เหลือราก; คลังข้อความ; WordNet; อัลกอริทึมแบบดั้งเดิม |
| Gensim | โมเดลหัวข้อและเวกเตอร์ฝังตัวของคำแบบดั้งเดิม | LDA; LSI; Word2Vec; FastText; คลังข้อความแบบสตรีม |
| Flair | การรู้จำเอนทิตีแบบกำหนดเองและการกำกับป้ายลำดับข้อมูล | ตัวกำกับป้ายที่ฝึกไว้ล่วงหน้า; การจัดประเภทข้อความ; เวกเตอร์ฝังตัว; การฝึกแบบกำหนดเอง |
| Tokenizers | การตัดคำย่อยแบบกำหนดเอง | การประมวลผลที่ขับเคลื่อนด้วย Rust; BPE; WordPiece; Unigram; การจัดแนว |
| Datasets | การเตรียมชุดข้อมูลและการทดลองประมวลผลภาษาธรรมชาติที่ทำซ้ำได้ | การโหลด; พื้นที่จัดเก็บที่ใช้ Arrow; การแปลงข้อมูล; การสตรีม; การแก้ไขเวอร์ชัน |
1. Transformers
Hugging Face Transformers เป็นตัวเลือกแรกของเราเมื่อโปรเจกต์ประมวลผลภาษาธรรมชาติอาศัยโมเดลภาษาที่ฝึกไว้ล่วงหน้า ไลบรารีนี้มีคำจำกัดความของโมเดล ตัวตัดคำและตัวประมวลผล เครื่องมือสำหรับการอนุมาน และอินเทอร์เฟซสำหรับการฝึก เพื่อรองรับงานต่าง ๆ เช่น การสร้างข้อความ การจัดประเภท การตอบคำถาม และการดึงข้อมูล ความครอบคลุมที่หลากหลายทำให้ไลบรารีนี้เป็นรากฐานที่มีประโยชน์สำหรับทีมที่ต้องการเปรียบเทียบสถาปัตยกรรมโมเดลหลายแบบ แทนที่จะเลือกใช้บริการโฮสต์เพียงรายเดียว
แนวทางด้านความเข้ากันได้เปลี่ยนไปแล้ว โดย Transformers v5 มุ่งเน้นที่ PyTorch และยุติการรองรับแบ็กเอนด์ TensorFlow และ Flax รุ่นก่อนหน้า ไม่ควรคาดหวังว่าบทแนะนำรุ่นเก่าที่โหลดโมเดล TensorFlow จะทำงานได้โดยไม่เปลี่ยนแปลงบนการติดตั้งเวอร์ชันปัจจุบัน แอปพลิเคชันที่ใช้อยู่ควรตรวจสอบคลาสของโมเดล API สำหรับงาน และไลบรารีที่ต้องพึ่งพา ก่อนอัปเกรด การติดตั้งแพ็กเกจสำเร็จไม่ได้ยืนยันว่าเวิร์กโฟลว์รุ่นเก่ายังคงเข้ากันได้
ไลบรารีนี้ไม่ได้ทำให้เช็กพอยต์ทุกตัวมีความแม่นยำ ราคาที่เข้าถึงได้ หรือความเหมาะสมต่อการใช้งานเชิงพาณิชย์เท่ากัน ควรเลือกโมเดลตามภาษา งาน ใบอนุญาต และงบประมาณด้านฮาร์ดแวร์ แล้วประเมินด้วยอินพุตที่เป็นตัวแทนของการใช้งานจริง สำหรับตัวจำแนกประเภทขนาดเล็กที่ใช้จัดเส้นทางใบแจ้งปัญหา แบบจำลองพื้นฐานเชิงสถิติที่เรียบง่ายกว่าอาจดูแลใช้งานได้ง่ายกว่า Transformers ได้รับการจัดอันดับนี้จากการเข้าถึงโมเดลและความยืดหยุ่น แต่การตัดสินใจว่าจะนำไปใช้งานจริงหรือไม่ยังต้องพิจารณาในระดับเช็กพอยต์แต่ละตัว
ข้อดีและข้อเสีย
- ระบบนิเวศของโมเดลที่ฝึกไว้ล่วงหน้าครอบคลุมกว้างขวาง
- รองรับทั้งการอนุมานและการปรับใช้โมเดล
- ใช้คำจำกัดความของโมเดลร่วมกันได้ในเครื่องมือหลากหลายชนิด
- โมเดลขนาดใหญ่อาจต้องใช้ทรัพยากรประมวลผลจำนวนมาก
- การเปลี่ยนแปลงเวอร์ชันหลักจำเป็นต้องทบทวนแผนการย้ายระบบ
ดูเอกสารประกอบของ Transformers
2. spaCy
spaCy เป็นจุดเริ่มต้นที่เราแนะนำสำหรับสร้างไปป์ไลน์ใช้งานจริง ซึ่งแปลงข้อความให้เป็นข้อมูลทางภาษาศาสตร์ที่มีโครงสร้าง โดยรวมการตัดแบ่งข้อความเป็นหน่วยย่อย การรู้จำเอนทิตี การกำกับป้าย การวิเคราะห์โครงสร้างประโยค และองค์ประกอบที่กำหนดเองไว้ในรูปแบบเอกสารที่สอดคล้องกัน แนวทางนี้มีประโยชน์เป็นพิเศษเมื่อแอปพลิเคชันต้องการคำกำกับที่เชื่อถือได้และกฎทางธุรกิจ แทนที่จะใช้คำตอบที่สร้างขึ้นอย่างอิสระซึ่งต้องนำมาตีความภายหลัง
จุดเด่นของเครื่องมือนี้คือการนำองค์ประกอบต่าง ๆ มาประกอบกัน ทีมสามารถผสานตัวรู้จำเอนทิตีที่ผ่านการฝึกเข้ากับกฎการจับคู่ที่ระบุไว้อย่างชัดเจน เพิ่มการประมวลผลเฉพาะโดเมน และบรรจุผลลัพธ์เป็นไปป์ไลน์ที่นำกลับมาใช้ซ้ำได้ ตัวอย่างเช่น การประมวลผลใบแจ้งหนี้หรือข้อความขอความช่วยเหลืออาจต้องใช้ทั้งชื่อองค์กรที่ระบบเรียนรู้มาและตัวระบุผลิตภัณฑ์ที่ตรงตามรูปแบบ การรวมการทำงานเหล่านี้ไว้ในไปป์ไลน์เดียวช่วยให้ตรวจสอบขอบเขตระหว่างการคาดการณ์เชิงสถิติกับกฎที่กำหนดแน่นอนได้ง่ายขึ้น
แพ็กเกจภาษามีขนาดและความครอบคลุมแตกต่างกัน และไปป์ไลน์ที่ผ่านการฝึกต้องตรงกับ spaCy เวอร์ชันที่ติดตั้ง คำสั่งตรวจสอบอย่างเป็นทางการช่วยระบุแพ็กเกจที่เข้ากันไม่ได้หลังการอัปเกรด ควรทดสอบประสิทธิภาพขององค์ประกอบที่เปิดใช้งานจริง เพราะการประมวลผลที่ใช้ทรานส์ฟอร์เมอร์อาจมีรูปแบบการใช้ทรัพยากรต่างจากไปป์ไลน์ขนาดเล็ก spaCy ไม่เหมาะกับการสร้างเนื้อหาแบบปลายเปิดโดยตรงเท่าใดนัก แต่ยังเป็นตัวเลือกที่แข็งแกร่งเมื่อต้องการประมวลผลข้อความอย่างมีโครงสร้างและทำซ้ำได้
ข้อดีและข้อเสีย
- ผสานกฎเข้ากับองค์ประกอบที่เรียนรู้จากข้อมูล
- API สำหรับเอกสารและไปป์ไลน์ที่ทำงานสอดคล้องกัน
- เครื่องมือสำหรับจัดแพ็กเกจและตรวจสอบความเข้ากันได้ที่มีประโยชน์
- ความสามารถแตกต่างกันไปตามแพ็กเกจภาษา
- เวิร์กโฟลว์การสร้างเนื้อหาต้องใช้องค์ประกอบเพิ่มเติม
3. Sentence Transformers
Sentence Transformers เป็นตัวเลือกที่แนะนำได้ตรงจุดที่สุดสำหรับการค้นหาเชิงความหมาย การวัดความคล้ายคลึงของเอกสาร การตรวจจับเอกสารซ้ำ และระบบดึงข้อมูล อินเทอร์เฟซที่ออกแบบตามลักษณะงานช่วยให้สร้างตัวแทนข้อมูลที่นำไปใช้ได้จริงและคะแนนความเกี่ยวข้องได้ง่ายกว่าการประกอบเวิร์กโฟลว์แบบเดียวกันจากไลบรารีโมเดลทั่วไป เครื่องมือนี้มีประโยชน์เป็นพิเศษเมื่อโจทย์หลักคือการค้นหาหลักฐานที่เหมาะสม ก่อนที่องค์ประกอบอื่นจะสร้างคำตอบ
ชุดเครื่องมือรุ่นปัจจุบันรองรับมากกว่าการสร้างเวกเตอร์หนึ่งชุดต่อประโยค โดยมีเอกสารประกอบสำหรับเวกเตอร์ฝังตัวแบบหนาแน่น ตัวเข้ารหัสแบบเบาบาง ตัวจัดอันดับใหม่แบบ cross-encoder และโมเดลหลายเวกเตอร์ พร้อมรองรับข้อมูลหลายรูปแบบสำหรับเช็กพอยต์บางรายการ วิธีเหล่านี้มีต้นทุนแตกต่างกัน กล่าวคือ ระบบดึงข้อมูลช่วยคัดกรองคลังข้อมูลขนาดใหญ่ให้แคบลงได้ ขณะที่ตัวจัดอันดับใหม่ใช้การคำนวณมากขึ้นเพื่อเปรียบเทียบคำค้นกับชุดตัวเลือกที่มีขนาดเล็กกว่า การเลือกใช้ร่วมกันอย่างเหมาะสมขึ้นอยู่กับข้อกำหนดด้านความเกี่ยวข้องและเวลาแฝง
โมเดลและดัชนีต้องใช้รูปแบบข้อมูล จำนวนมิติ วิธีให้คะแนนความคล้ายคลึง และการประมวลผลล่วงหน้าที่ตรงกัน โดยทั่วไป การเปลี่ยนโมเดลเวกเตอร์ฝังตัวจำเป็นต้องสร้างตัวแทนข้อมูลของเอกสารขึ้นใหม่ ไม่ใช่แค่เปลี่ยนชื่อโมเดล ควรทดสอบการดึงข้อมูลด้วยคำถามที่สมจริงและตัวอย่างเชิงลบที่แยกแยะได้ยาก รวมถึงคำศัพท์เฉพาะในโดเมนของคุณ ไลบรารีนี้เป็นชั้นการสร้างโมเดลที่แข็งแกร่ง แต่การจัดเก็บ ตัวกรองสิทธิ์เข้าถึง การอัปเดตเอกสาร และการดำเนินงานของบริการค้นหายังคงต้องออกแบบแยกต่างหาก
ข้อดีและข้อเสีย
- อินเทอร์เฟซสำหรับการดึงข้อมูลและการวัดความคล้ายคลึงที่ออกแบบมาโดยเฉพาะ
- รองรับแนวทางการเข้ารหัสและการจัดอันดับใหม่หลายรูปแบบ
- รองรับการฝึกและการประเมินผล
- การเปลี่ยนรูปแบบตัวแทนข้อมูลอาจทำให้ต้องสร้างดัชนีใหม่
- โครงสร้างพื้นฐานสำหรับการค้นหายังคงเป็นส่วนที่ต้องจัดการแยกต่างหาก
ดูเอกสารประกอบของ Sentence Transformers
4. scikit-learn
scikit-learn ควรอยู่ในรายชื่อเครื่องมือ NLP ยุคใหม่ที่น่าพิจารณา เพราะแอปพลิเคชันประมวลผลข้อความที่มีประโยชน์หลายอย่างไม่จำเป็นต้องใช้โมเดลภาษาขนาดใหญ่ ไลบรารีนี้มีเครื่องมือแปลงข้อความเป็นเวกเตอร์ ตัวจำแนกประเภทแบบดั้งเดิม วิธีจัดกลุ่ม และเครื่องมือประเมินผล โดยมีอินเทอร์เฟซแมชชีนเลิร์นนิงที่พัฒนาเต็มที่แล้ว สำหรับการตรวจจับสแปม การส่งต่อทิกเก็ตไปยังทีมที่เกี่ยวข้อง หรือการจัดหมวดหมู่เอกสาร มักเป็นวิธีที่ชัดเจนที่สุดในการสร้างค่าฐานที่ใช้งานได้ ก่อนเพิ่มความซับซ้อนของโครงข่ายประสาทเทียม
เวิร์กโฟลว์ทั่วไปจะผสานคุณลักษณะจากคำหรืออักขระเข้ากับตัวจำแนกประเภทเชิงเส้น น้ำหนัก TF-IDF ช่วยลดอิทธิพลของคำที่พบบ่อย ส่วนเอ็นแกรมอักขระช่วยจับรูปแบบการสะกดที่แตกต่างกันหรือส่วนของคำได้ ไปป์ไลน์ช่วยรวมการสกัดคุณลักษณะกับตัวประมาณค่าไว้ด้วยกัน ควรฝึกไปป์ไลน์ทั้งหมดนี้โดยใช้เฉพาะข้อมูลฝึกในแต่ละชุดแบ่งสำหรับการประเมินผล เพื่อป้องกันไม่ให้ข้อมูลจากตัวอย่างที่กันไว้ทดสอบรั่วไหลเข้าสู่การตัดสินใจเรื่องคำศัพท์และการกำหนดน้ำหนัก
ตัวแทนข้อมูลเหล่านี้มีข้อจำกัด กล่าวคือ ไม่สามารถจับความหมายตามบริบทได้เช่นเดียวกับตัวเข้ารหัสที่ผ่านการฝึกล่วงหน้า และคำศัพท์ที่ไม่คุ้นเคยอาจทำให้ประสิทธิภาพลดลง อย่างไรก็ตาม การอนุมานที่รวดเร็วบน CPU และการตรวจสอบข้อผิดพลาดที่ทำได้ตรงไปตรงมาเป็นข้อได้เปรียบด้านการปฏิบัติงานที่มีค่า เราจัด scikit-learn ไว้ก่อนหน้าไลบรารีเฉพาะทางหลายตัว เพราะผู้อ่านควรตรวจสอบให้แน่ใจก่อนว่า ตัวจำแนกประเภทขนาดเล็กที่วัดผลได้แก้ปัญหาได้แล้วหรือไม่ ก่อนยอมรับภาระของระบบให้บริการที่มีค่าใช้จ่ายสูงกว่ามาก
ข้อดีและข้อเสีย
- เวิร์กโฟลว์ค่าฐานที่มีประสิทธิภาพและเหมาะกับ CPU
- มีเครื่องมือเลือกโมเดลและประเมินผลในตัว
- ตรวจสอบคุณลักษณะข้อความแบบเบาบางได้ง่าย
- ความเข้าใจภาษาตามบริบทมีข้อจำกัด
- ต้องใช้ข้อมูลที่ติดป้ายกำกับอย่างเป็นตัวแทนสำหรับงานแบบมีผู้สอน
ดูเอกสารประกอบของ scikit-learn
5. Stanza
Stanza เป็นตัวเลือกที่เหมาะอย่างยิ่งเมื่อหัวใจสำคัญคือโครงสร้างทางภาษาศาสตร์ในหลายภาษา ชุดเครื่องมือ Python ของ Stanford สามารถแบ่งส่วนข้อความ สร้างรูปคำพื้นฐานและคำกำกับลักษณะทางสัณฐานวิทยา ระบุชนิดของคำ วิเคราะห์ความสัมพันธ์แบบพึ่งพา และรู้จำเอนทิตีได้ ประโยชน์ของเครื่องมือนี้เห็นได้ชัดเป็นพิเศษในโครงการวิจัยหรือวิเคราะห์ที่ต้องการคำกำกับทางภาษาศาสตร์ซึ่งเปรียบเทียบกันได้ แทนที่จะใช้เพียงเวกเตอร์ฝังประโยคหรือสรุปที่สร้างขึ้น
ไปป์ไลน์แบบเนทีฟใช้ PyTorch และทรัพยากรภาษาที่ดาวน์โหลดได้ ความพร้อมใช้งานของตัวประมวลผลแตกต่างกันไป ดังนั้นการที่ภาษาหนึ่งปรากฏในแค็ตตาล็อกไม่ได้หมายความว่างานกำกับคำอธิบายทุกประเภทจะได้รับการรองรับอย่างมีประสิทธิภาพเท่าเทียมกัน สำหรับชุดข้อมูลหลายภาษา ให้เลือกตัวประมวลผลและโมเดลแยกตามภาษา และประเมินกรณีที่ท้าทาย เช่น การสลับภาษา การสะกดแบบไม่เป็นทางการ หรือข้อความที่อยู่นอกขอบเขตข้อมูลฝึกของโมเดลอย่างมาก
Stanza ยังมีส่วนเชื่อมต่อ Python สำหรับ Stanford CoreNLP ด้วย แต่บริการ Java ดังกล่าวแยกจากไปป์ไลน์แบบเนทีฟ และไม่จำเป็นสำหรับการใช้งาน Stanza ทั่วไป ความแตกต่างนี้สำคัญต่อการวางแผนการพึ่งพาและการนำระบบไปใช้งาน เราแนะนำ Stanza เมื่อความครอบคลุมด้านภาษาศาสตร์สำคัญกว่าการใช้ทรัพยากรระบบให้น้อยที่สุด ส่วนกรณีที่เครื่องมือใดเครื่องมือหนึ่งให้คำกำกับที่ต้องการได้ ควรเปรียบเทียบเวลาแฝงและการใช้หน่วยความจำกับไปป์ไลน์ spaCy ที่เหมาะสม
ข้อดีและข้อเสีย
- เน้นการประมวลผลภาษาศาสตร์หลายภาษาอย่างชัดเจน
- มีคำกำกับทางไวยากรณ์อย่างละเอียด
- มีไปป์ไลน์ Python แบบเนทีฟและไคลเอนต์ CoreNLP แยกต่างหาก
- ความครอบคลุมของงานแตกต่างกันไปตามภาษา
- ไปป์ไลน์โครงข่ายประสาทอาจเพิ่มความต้องการทรัพยากรระบบ
6. NLTK
Natural Language Toolkit ยังคงเป็นหนึ่งในเครื่องมือที่ดีที่สุดสำหรับทำความเข้าใจว่าไปป์ไลน์ NLP กำลังทำงานอย่างไร โดยรวบรวมการตัดคำ การตัดปัจจัยคำ การกำกับชนิดคำ การวิเคราะห์ไวยากรณ์ ทรัพยากรทางศัพท์ และการเข้าถึงคลังข้อความไว้ด้วยกัน ในรูปแบบที่เหมาะกับการเรียนการสอนและการทดลอง การที่เครื่องมือนี้อยู่ในอันดับนี้สะท้อนถึงความลึกซึ้งด้านการศึกษาและความยืดหยุ่นในการวิเคราะห์ ไม่ได้หมายความว่าเป็นระบบประมวลผลมาตรฐานสำหรับบริการใช้งานจริงทุกประเภท
สำหรับนักศึกษาหรือนักวิจัย ความสามารถในการตรวจสอบตัวแทนข้อมูลระหว่างขั้นตอนการประมวลผลถือเป็นประโยชน์ คุณสามารถเปรียบเทียบวิธีตัดคำ สำรวจความสัมพันธ์ทางศัพท์ หรือดูว่าตัวจำแนกประเภทแบบดั้งเดิมตอบสนองต่อคุณลักษณะต่าง ๆ อย่างไร โดยไม่ต้องเริ่มจากการใช้งานโมเดลขนาดใหญ่ก่อน การทดลองเหล่านี้ยังช่วยให้ผู้ปฏิบัติงานเข้าใจว่าเหตุใดการเลือกวิธีเตรียมข้อมูลจึงส่งผลต่อผลลัพธ์ในขั้นตอนถัดไปอย่างมีนัยสำคัญ โดยเฉพาะเมื่อมีการปฏิเสธความหมาย ชื่อเฉพาะ และคำศัพท์เฉพาะทาง
ทรัพยากรจำนวนมากต้องดาวน์โหลดแยกต่างหาก ดังนั้นในการนำระบบไปใช้งาน ควรระบุและจัดเตรียมข้อมูลที่จำเป็นไว้ให้ครบ แทนที่จะพึ่งการดาวน์โหลดแบบโต้ตอบขณะระบบทำงาน ต้องตรวจสอบสิทธิ์การใช้งานทรัพยากรและความครอบคลุมด้านภาษาแยกต่างหาก สำหรับแอปพลิเคชันที่มีปริมาณการใช้งานสูง ให้ใช้ NLTK เฉพาะในส่วนที่ทรัพยากรหรืออัลกอริทึมบางอย่างเพิ่มคุณค่า แล้วเปรียบเทียบเวิร์กโฟลว์ทั้งหมดกับไลบรารีเฉพาะทางอื่น ๆ จุดเด่นที่สุดของ NLTK คือช่วยให้แนวคิดด้านการประมวลผลภาษาเข้าใจได้ง่ายและตรวจสอบได้
ข้อดีและข้อเสีย
- สื่อการเรียนรู้และการเข้าถึงคลังข้อความยอดเยี่ยม
- รองรับฟังก์ชัน NLP แบบดั้งเดิมอย่างครอบคลุม
- ขั้นตอนการประมวลผลระหว่างทางโปร่งใส
- ต้องจัดการทรัพยากรแยกต่างหาก
- ไม่ใช่ชุดระบบให้บริการโครงข่ายประสาทสมัยใหม่ที่พร้อมใช้งานทันที
7. Gensim
Gensim เป็นไลบรารีเฉพาะทางสำหรับการสร้างแบบจำลองหัวข้อ การสร้างตัวแทนคำแบบดั้งเดิม และการวิเคราะห์ความคล้ายคลึงในชุดข้อความ ยังคงมีประโยชน์เมื่อโครงการต้องการธีมที่ตีความได้หรือเวกเตอร์ฝังที่ฝึกในเครื่อง แทนความสามารถของโมเดลเชิงสร้างสรรค์ ขอบเขตการใช้งานที่เฉพาะเจาะจงนี้เป็นข้อดีสำหรับนักวิเคราะห์ที่ต้องการเห็นความเชื่อมโยงอย่างชัดเจนระหว่างคลังข้อความกับโครงสร้างทางสถิติที่สกัดได้
เวิร์กโฟลว์แบบสตรีมช่วยให้ประมวลผลคลังข้อความได้โดยไม่ต้องเก็บเอกสารทุกชิ้นไว้ในหน่วยความจำพร้อมกัน โมเดลอย่าง LDA หรือ LSI ช่วยสำรวจชุดข้อมูลได้ ขณะที่ Word2Vec และ FastText รองรับการเรียนรู้ตัวแทนคำในระดับคำ วิธีเหล่านี้ตอบโจทย์ต่างจากตัวเข้ารหัสประโยคสมัยใหม่ กล่าวคือ การแจกแจงหัวข้อช่วยในการวิเคราะห์ชุดข้อความได้ แต่ไม่ควรถือโดยอัตโนมัติว่าเป็นตัวแทนที่ดีที่สุดสำหรับการตอบคำถามค้นหาด้วยภาษาธรรมชาติ
การเตรียมข้อมูลเป็นส่วนหนึ่งของการออกแบบโมเดล ซึ่งรวมถึงการกรองคลังคำ การจัดการวลี และการกำหนดขอบเขตเอกสาร ควรประเมินความคงเส้นคงวาและประโยชน์ของหัวข้อ แทนที่จะพิจารณาเพียงป้ายกำกับหัวข้อที่ดูน่าสนใจ ตรวจสอบความเข้ากันได้กับชุดเครื่องมือ Python ด้านวิทยาศาสตร์ที่ติดตั้งอยู่ก่อนอัปเกรดสภาพแวดล้อมเดิม Gensim ได้รับตำแหน่งนี้จากเวิร์กโฟลว์ทางสถิติที่เป็นที่ยอมรับ ส่วนผู้ที่พัฒนาระบบค้นคืนข้อมูลแบบเข้าใจบริบทควรเปรียบเทียบกับ Sentence Transformers แทนที่จะคิดว่าเครื่องมือทั้งสองใช้แทนกันได้
ข้อดีและข้อเสีย
- เครื่องมือเฉพาะทางสำหรับการสร้างแบบจำลองหัวข้อและเวกเตอร์ฝัง
- รองรับเวิร์กโฟลว์ประมวลผลคลังข้อความแบบสตรีม
- มีประโยชน์ต่อการวิเคราะห์คลังข้อมูลที่ตีความผลได้
- การแทนข้อมูลแบบดั้งเดิมมีข้อจำกัดด้านบริบท
- ผลลัพธ์ขึ้นอยู่กับการเตรียมคลังข้อมูลเป็นอย่างมาก
8. Flair
Flair เป็นตัวเลือกที่ใช้งานได้จริงสำหรับทีมที่ทำงานด้านการรู้จำเอนทิตีที่มีชื่อ การกำกับป้ายกำกับลำดับ และงานจัดประเภทข้อความที่เกี่ยวข้อง โดยมีอินเทอร์เฟซที่ใช้งานง่ายสำหรับโมเดลที่ฝึกไว้ล่วงหน้า รวมถึงเครื่องมือสำหรับฝึกระบบเฉพาะงาน จุดเด่นคือช่วยให้เปลี่ยนจากประโยคที่ใส่คำกำกับไว้ไปเป็นโมเดลที่ระบุช่วงข้อความหรือป้ายกำกับตามที่โครงการต้องการได้โดยตรงค่อนข้างง่าย
การออกแบบที่เน้นการฝังเวกเตอร์ช่วยให้ทดลองใช้การแทนข้อมูลรูปแบบต่าง ๆ ได้ โดยยังคงแนวทางการทำนายและการฝึกที่สอดคล้องกัน สำหรับโครงการดึงข้อมูลเฉพาะสาขา แนวทางนี้ช่วยให้เปรียบเทียบได้ว่าการปรับปรุงคุณลักษณะหรือการใส่คำกำกับที่ดีขึ้นส่งผลมากกว่ากัน ควรประเมินช่วงข้อความให้ครบถ้วน ไม่ใช่ดูเฉพาะโทเค็นแต่ละตัว เพราะระบบที่ตรวจพบชื่อองค์กรได้เพียงบางส่วนอาจยังใช้กับแอปพลิเคชันปลายทางไม่ได้
ระบบนิเวศสำหรับการนำ Flair ไปใช้งานมีขอบเขตแคบกว่าไลบรารีอเนกประสงค์ที่ครอบคลุมที่สุด จึงควรใส่ใจกับความเข้ากันได้ของไลบรารีที่ต้องพึ่งพา ก่อนนำไปใช้ร่วมกับชุดโมเดลที่ใหม่กว่า ให้ตรวจสอบเวอร์ชันของ Python และไลบรารีสำหรับการเรียนรู้เชิงลึกที่รุ่นดังกล่าวรองรับ เราแนะนำ Flair เมื่อการกำกับป้ายกำกับแบบกำหนดเองเป็นโจทย์หลักด้านวิศวกรรม และทีมมีข้อมูลฝึกที่เหมาะสม สำหรับงานประมวลผลทางธุรกิจที่มีกฎเกณฑ์จำนวนมาก หรืองานประยุกต์ใช้การสร้างเนื้อหาในวงกว้าง ตัวเลือกอื่นในรายการนี้เป็นจุดเริ่มต้นที่เหมาะสมกว่า
ข้อดีและข้อเสีย
- เวิร์กโฟลว์การกำกับป้ายกำกับด้วยโมเดลที่ฝึกไว้ล่วงหน้าใช้งานง่าย
- รองรับโมเดลกำกับป้ายกำกับลำดับแบบกำหนดเอง
- เหมาะสำหรับทดลองใช้การแทนข้อมูลรูปแบบต่าง ๆ
- ต้องตรวจสอบการทำงานร่วมกันของไลบรารีที่ต้องพึ่งพา
- คุณภาพขึ้นอยู่กับคำกำกับข้อมูลเฉพาะสาขาและการเลือกโมเดล
9. Tokenizers
Hugging Face Tokenizers เป็นโครงสร้างพื้นฐานสำหรับแปลงข้อความเป็นหน่วยที่โมเดลใช้ประมวลผลได้ โดยมีการทำโทเค็นย่อยที่รวดเร็ว พร้อมขั้นตอนที่เกี่ยวข้อง ได้แก่ การปรับรูปแบบข้อความให้เป็นมาตรฐาน การแบ่งโทเค็นเบื้องต้น การประมวลผลภายหลัง และการถอดรหัส เครื่องมือนี้อยู่ในรายการเพราะคุณภาพและความเร็วในการประมวลผลโทเค็นอาจกลายเป็นคอขวดสำคัญเมื่อฝึกโมเดลหรือประมวลผลคลังข้อความขนาดใหญ่
ตัวตัดโทเค็นไม่ได้มีเพียงไฟล์คลังคำศัพท์เท่านั้น กฎการปรับรูปแบบข้อความให้เป็นมาตรฐานและการกำหนดขอบเขตส่งผลต่อการจับคู่ข้อความกับรหัสโทเค็น ขณะที่ข้อมูลการจัดแนวช่วยเชื่อมโทเค็นกลับไปยังข้อความต้นฉบับ เรื่องนี้สำคัญกับงานดึงข้อมูลที่ช่วงข้อความซึ่งโมเดลทำนายต้องอ้างอิงอักขระได้อย่างถูกต้อง เมื่อต้องฝึกคลังคำศัพท์แบบกำหนดเอง ควรตรวจสอบภาษา เครื่องหมายวรรคตอน รหัสระบุที่ไม่คุ้นเคย และศัพท์เฉพาะของสาขาที่เป็นตัวแทนของข้อมูลจริง แทนที่จะมุ่งปรับปรุงเพียงค่าสถิติการบีบอัดโดยเฉลี่ย
สำหรับโมเดลที่ฝึกไว้ล่วงหน้าแล้ว ให้ใช้ตัวตัดโทเค็นที่โมเดลนั้นกำหนดไว้ เว้นแต่คุณตั้งใจเปลี่ยนโมเดลและฝึกองค์ประกอบที่เกี่ยวข้องใหม่ การเปลี่ยนตัวตัดโทเค็นโดยไม่มีเหตุผลอาจทำให้ความหมายของโทเค็นใช้ไม่ได้และทำให้ผลลัพธ์แย่ลง นักพัฒนาแอปพลิเคชันส่วนใหญ่ใช้ตัวตัดโทเค็นผ่าน Transformers ได้โดยไม่ต้องกำหนดค่าไลบรารีระดับล่างนี้โดยตรง เลือกใช้ Tokenizers โดยตรงเมื่อต้องควบคุมการฝึกคลังคำศัพท์ พฤติกรรมการจัดแนว หรือประสิทธิภาพการประมวลผลเบื้องต้นโดยเฉพาะ
ข้อดีและข้อเสีย
- ประมวลผลโทเค็นได้รวดเร็วและเข้าถึงได้ผ่าน Python
- ปรับแต่งขั้นตอนการประมวลผลได้
- การจัดแนวรองรับงานที่อิงตามช่วงข้อความ
- ไม่สามารถวิเคราะห์ความหมายได้ด้วยตัวเอง
- การเปลี่ยนตัวตัดโทเค็นอาจทำให้สมมติฐานของโมเดลที่ฝึกไว้ล่วงหน้าใช้ไม่ได้
10. Datasets
Hugging Face Datasets จัดเตรียมชั้นข้อมูลสำหรับการทดลองด้าน NLP และไปป์ไลน์การฝึกโมเดล ช่วยโหลดคลังข้อมูลสาธารณะหรือส่วนตัว ใช้การแปลงข้อมูล จัดการการแบ่งชุดข้อมูล และทำงานกับชุดข้อมูลที่มีขนาดใหญ่เกินกว่าจะเก็บไว้ในออบเจ็กต์ Python ในหน่วยความจำได้อย่างสะดวก เครื่องมือนี้ไม่ใช่โมเดลภาษาหรือตัวแยกวิเคราะห์ แต่รวมอยู่ในรายการนี้เพราะความน่าเชื่อถือของ NLP ขึ้นอยู่กับคุณภาพและความสามารถในการทำซ้ำของไปป์ไลน์ข้อมูลนำเข้ามากเพียงใด
ชุดข้อมูลที่รองรับด้วย Arrow และการสตรีมเป็นวิธีจัดการคลังข้อมูลขนาดใหญ่ที่แตกต่างกัน ชุดข้อมูลที่แมปเข้าหน่วยความจำเหมาะกับการประมวลผลเบื้องต้นที่ทำซ้ำได้และการเข้าถึงข้อมูลแบบมีดัชนี ส่วนการสตรีมช่วยลดความจำเป็นในการดาวน์โหลดคลังข้อมูลทั้งชุดก่อนเริ่มงาน ควรเลือกรูปแบบการเข้าถึงอย่างรอบคอบ เพราะการสตรีมทำให้ต้องปรับสมมติฐานเรื่องการเข้าถึงแบบสุ่ม การสับเปลี่ยนข้อมูล และการอ่านข้อมูลซ้ำหลายรอบ
กำหนดเวอร์ชันของชุดข้อมูลให้แน่นอน และบันทึกการแปลงข้อมูลควบคู่ไปกับเวอร์ชันของโมเดลและตัวตัดโทเค็น ก่อนแปลผลคะแนนการประเมิน ให้ตรวจสอบสิทธิ์การใช้งาน ข้อมูลซ้ำ คุณภาพของป้ายกำกับ และการทับซ้อนระหว่างชุดฝึกกับชุดทดสอบ ไลบรารีนี้ช่วยให้จัดการข้อมูลได้สะดวกขึ้น แต่ไม่ได้รับรองว่าชุดข้อมูลจากชุมชนจะเหมาะกับงานของคุณ เราแนะนำให้ใช้เป็นองค์ประกอบสนับสนุนเมื่อโจทย์คือการนำเข้าข้อมูลและการประมวลผลเบื้องต้นที่ทำซ้ำได้ โดยเฉพาะเมื่อใช้ร่วมกับ Transformers หรือ Sentence Transformers
ข้อดีและข้อเสีย
- API สำหรับโหลดและแปลงข้อมูลที่สอดคล้องกัน
- รองรับชุดข้อมูลขนาดใหญ่และการประมวลผลแบบสตรีม
- เป็นรากฐานที่มีประโยชน์สำหรับการทดลองที่ทำซ้ำได้
- คุณยังคงต้องรับผิดชอบต่อคุณภาพและการอนุญาตให้ใช้ชุดข้อมูล
- การประมวลผลแบบสตรีมต้องอาศัยสมมติฐานเกี่ยวกับรูปแบบการเข้าถึงข้อมูลที่แตกต่างออกไป
ความเข้ากันได้และการบำรุงรักษา: สิ่งที่ควรตรวจสอบ
Transformers v5: Hugging Face ได้ปรับทิศทางไลบรารีให้มุ่งเน้น PyTorch และยุติการรองรับ TensorFlow/Flax ในฐานะแบ็กเอนด์ ตรวจสอบข้อกำหนดในการย้ายระบบก่อนนำตัวอย่างเก่ามาใช้ ความเข้ากันได้ระหว่างไลบรารีก็สำคัญเช่นกัน กล่าวคือ เวอร์ชันล่าสุดของทุกการพึ่งพาไม่ได้หมายความว่าจะใช้ร่วมกันได้อย่างมีการรองรับเสมอไป
ข้อกำหนดของ Python: ณ เวลาที่ตรวจสอบ PyPI ระบุว่า Transformers 5.19.0 และ Datasets 5.1.0 ต้องใช้ Python 3.10 ขึ้นไป ขณะที่ scikit-learn 1.9.1 ต้องใช้ Python 3.11 ขึ้นไป เมื่อตั้งค่าสภาพแวดล้อม ให้ตรวจสอบข้อมูลเมตาของแพ็กเกจ Transformers, Datasets และ scikit-learn เวอร์ชันปัจจุบัน ข้อกำหนดเหล่านี้เป็นเพียงเวอร์ชันขั้นต่ำของแพ็กเกจ ไม่ได้รับประกันว่าการพึ่งพา GPU หรือส่วนขยายทุกตัวจะทำงานร่วมกับตัวแปลภาษาเวอร์ชันใหม่ทุกเวอร์ชันได้
เหตุใด fastText จึงไม่ติด 10 อันดับแรกอีกต่อไป: ที่เก็บซอร์สโค้ดอย่างเป็นทางการถูกเก็บเข้าคลังในเดือนมีนาคม 2024 โมเดลที่มีอยู่และระบบที่ใช้งานมานานยังคงมีประโยชน์ได้ แต่การที่โครงการต้นทางถูกเก็บเข้าคลังเป็นปัจจัยสำคัญที่ควรคำนึงถึงเมื่อพัฒนาซอฟต์แวร์ใหม่ เราใช้ scikit-learn แทนในบทบาทเครื่องมือพื้นฐานสำหรับการจำแนกข้อความแบบครอบคลุม แต่ไม่ได้ใช้แทนความสามารถทุกอย่างของ fastText โดยเฉพาะทรัพยากรสำหรับระบุภาษาที่ฝึกไว้ล่วงหน้า
เลือกเวิร์กโฟลว์ก่อนเลือกไลบรารี
- การจำแนกข้อความ: สร้างค่าพื้นฐานโดยใช้ TF-IDF และตัวจำแนกเชิงเส้น จากนั้นจึงเปรียบเทียบกับตัวเข้ารหัสที่ฝึกไว้ล่วงหน้า หากข้อผิดพลาดบ่งชี้ว่าความซับซ้อนที่เพิ่มขึ้นนั้นคุ้มค่า
- การดึงข้อมูลจากช่องต่าง ๆ: พิจารณาว่าช่องใดต้องใช้กฎที่ตรงตามเงื่อนไขทุกประการ และช่องใดต้องใช้การรู้จำเอนทิตีที่เรียนรู้จากข้อมูล ประเมินทั้งช่วงข้อความทั้งหมดและรูปแบบผลลัพธ์ที่ต้องการ
- การสร้างระบบค้นหาเชิงความหมาย: วัดว่าระบบค้นคืนค้นหาหลักฐานที่เกี่ยวข้องได้หรือไม่ ก่อนประเมินคำตอบของตัวสร้าง เพิ่มขั้นตอนจัดอันดับซ้ำเฉพาะเมื่อการเพิ่มความเกี่ยวข้องคุ้มกับเวลาแฝงที่เพิ่มขึ้น
- การวิเคราะห์ข้อความหลายภาษา: ตรวจสอบภาษา ตัวประมวลผล และโมเดลที่รองรับโดยเฉพาะ ทดสอบทั้งภาษาถิ่น ภาษาที่ไม่เป็นทางการ และข้อความที่ผสมหลายภาษา
- การฝึกหรือปรับโมเดล: ติดตามรุ่นของชุดข้อมูล การกำหนดค่าโทเค็นไนเซอร์ จุดตรวจสอบของโมเดล และเวอร์ชันของการพึ่งพาไปพร้อมกัน
แบ่งข้อมูลสำหรับการประเมินให้สะท้อนการใช้งานจริง เอกสารจากลูกค้ารายเดียวกัน การสนทนาเดียวกัน หรือแหล่งข้อมูลที่ซ้ำกัน ไม่ควรปะปนข้ามชุดฝึกและชุดทดสอบ วัดคุณภาพของงาน เวลาแฝง และการใช้หน่วยความจำไปพร้อมกัน พร้อมตรวจสอบข้อผิดพลาดแยกตามภาษาและประเภทเอกสาร แยกใบอนุญาตของไลบรารีออกจากใบอนุญาตและข้อจำกัดที่เกี่ยวข้องกับน้ำหนักโมเดลและชุดข้อมูลที่ฝึกไว้ล่วงหน้า
หากโครงการของคุณต้องใช้การสร้างข้อความ คู่มือของเราเกี่ยวกับโมเดล LLM แบบโอเพนซอร์สและเปิดเผยน้ำหนักจะกล่าวถึงการเลือกโมเดล ส่วนการเปรียบเทียบฐานข้อมูลสำหรับแอปพลิเคชัน AIจะกล่าวถึงตัวเลือกด้านการจัดเก็บข้อมูลที่อาจใช้ร่วมกับไลบรารีสำหรับการค้นคืน
ควรเลือกไลบรารี NLP สำหรับ Python ตัวใด
เริ่มด้วย Transformers สำหรับโมเดลภาษาที่ฝึกไว้ล่วงหน้า spaCy สำหรับเวิร์กโฟลว์การประมวลผลแบบมีโครงสร้างที่นำไปใช้งานจริง หรือ Sentence Transformers สำหรับเวกเตอร์ฝังตัวและการจัดอันดับตามความเกี่ยวข้อง หากเป็นงานจำแนกประเภทที่กำหนดขอบเขตไว้แคบ ควรนำ scikit-learn มาเปรียบเทียบตั้งแต่แรก แทนที่จะมองเป็นเพียงตัวเลือกเสริมภายหลัง
เลือก Stanza สำหรับการกำกับข้อมูลทางภาษาศาสตร์หลายภาษา NLTK สำหรับการเรียนรู้และสำรวจคลังข้อมูลภาษา Gensim สำหรับโมเดลหัวข้อและเวกเตอร์ฝังตัวแบบดั้งเดิม และ Flair สำหรับการกำกับป้ายลำดับข้อมูลแบบกำหนดเอง เครื่องมือเหล่านี้มีคุณค่าเพราะเหมาะกับงานเฉพาะด้าน ดังนั้นการอยู่ในอันดับที่ต่ำกว่าในรายการนี้จึงไม่ได้หมายความว่าเครื่องมือเหล่านี้ด้อยกว่าในงานเฉพาะทางของตน
ใช้ Tokenizers เมื่อต้องการควบคุมการแบ่งข้อความเป็นโทเค็น และใช้ Datasets เมื่อการเตรียมข้อมูลเป็นความท้าทายหลัก ระบบ NLP ที่มีประโยชน์ส่วนใหญ่มักผสานเครื่องมือเหล่านี้เพียงไม่กี่ตัว เริ่มจากเวิร์กโฟลว์ที่เรียบง่ายที่สุดซึ่งตอบโจทย์ข้อกำหนดของคุณ แล้วค่อยเพิ่มความซับซ้อนเมื่อผลการวัดข้อผิดพลาดแสดงให้เห็นว่าจำเป็น