
พื้นฐาน AI
RNNs และ LSTMs คืออะไรในการเรียนรู้เชิงลึก?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Recurrent neural networks (RNNs) ประมวลผลลำดับโดยอัปเดตสถานะซ่อน (hidden state) ตามเวลา Long short-term memory (LSTM) เป็นเครือข่าย RNN ที่มีเกต (gated) เพื่อรักษาและควบคุมข้อมูลได้อย่างมีประสิทธิภาพมากกว่าหน่วย recurrent พื้นฐาน
RNNs และ LSTMs เคยครอบงำงานด้านภาษาหลายอย่าง แต่แชทบอทขนาดใหญ่สมัยใหม่ส่วนใหญ่ใช้ transformers โมเดล recurrent ยังคงมีประโยชน์สำหรับการสตรีม, ซีรีส์เวลา, การพูด, การควบคุม, และระบบที่มีข้อจำกัดด้านทรัพยากร ที่สถานะแบบเพิ่มขึ้นและความหน่วงต่ำเป็นสิ่งสำคัญ
ประเด็นสำคัญ
- RNN ใช้พารามิเตอร์เดียวกันซ้ำในทุกขั้นตอนของลำดับและส่งต่อสถานะซ่อนต่อไป
- การฝึกผ่านเวลาอาจทำให้เกิดการหายไปหรือการระเบิดของ gradient
- LSTM เพิ่มสถานะเซลล์และเกต input, forget, และ output
- Transformers จัดการความสัมพันธ์ระยะไกลและการฝึกแบบขนานต่างกัน; ไม่มีสถาปัตยกรรมใดที่ดีที่สุดสำหรับการใช้งานทุกกรณี
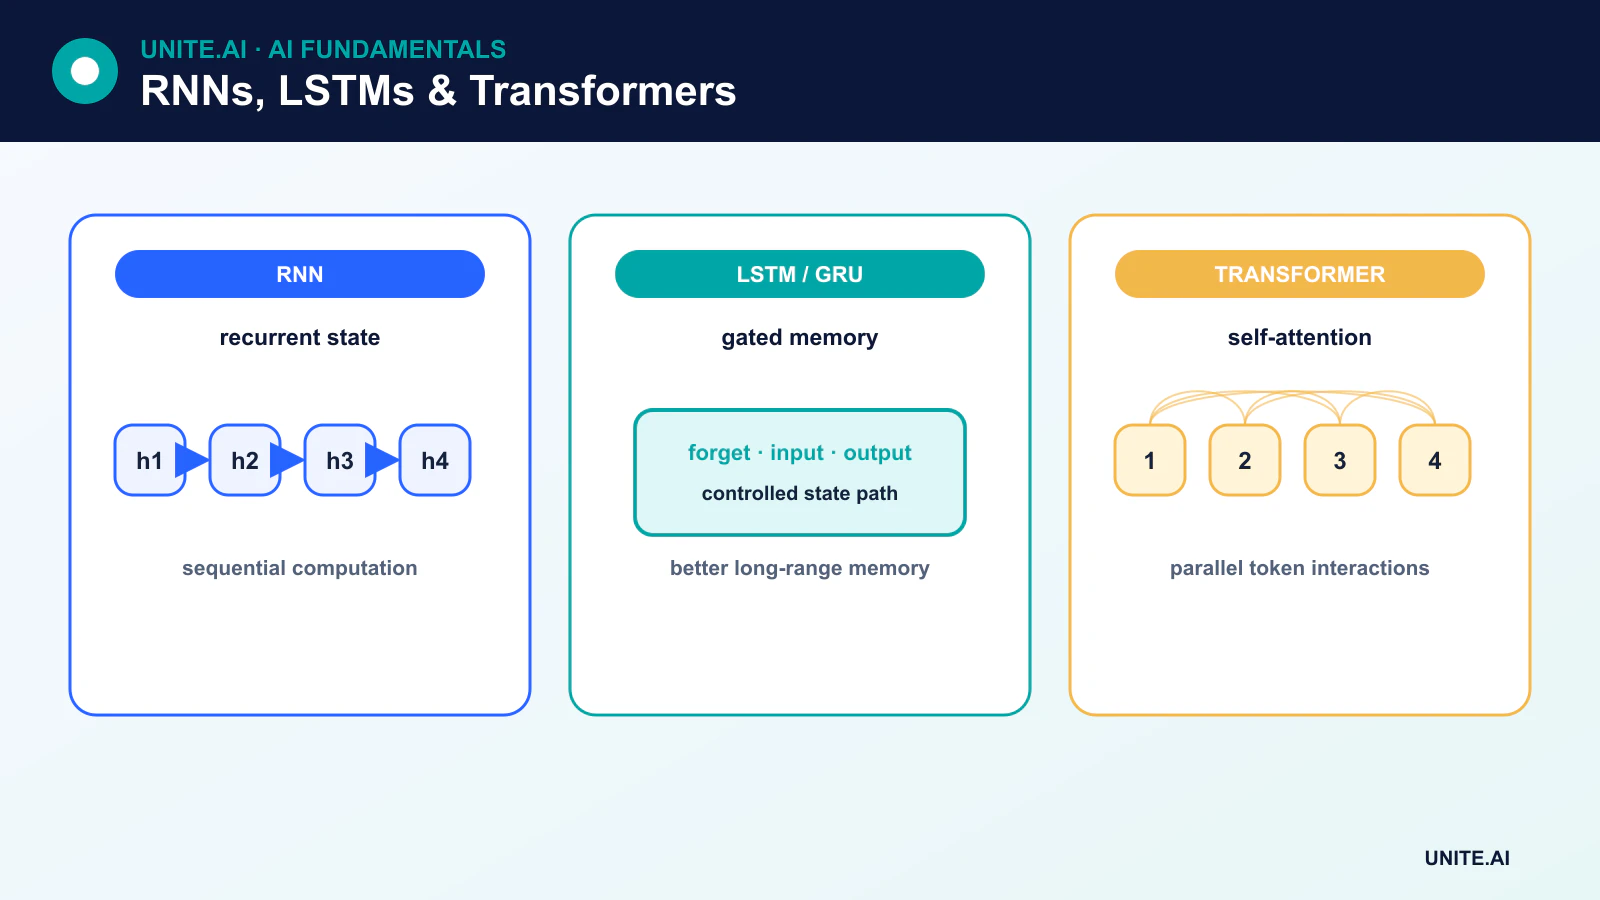
การทำงานของ RNN พื้นฐาน
ที่ขั้นตอน t หน่วย recurrent อย่างง่ายจะรวมอินพุตปัจจุบัน xₜ กับสถานะซ่อนก่อนหน้า hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
สถานะซ่อนเป็นสรุปที่เรียนรู้ซึ่งใช้สำหรับขั้นตอนถัดไปและขึ้นอยู่กับงานอาจเป็นผลลัพธ์ด้วย แผนภาพ “unrolled” แสดงสำเนาแต่ละขั้นตอนเวลา แต่สำเนาทั้งหมดใช้พารามิเตอร์ร่วมกัน ผลลัพธ์ไม่ได้ถูกคัดลอกกลับเป็นอินพุตดิบใหม่; การ recurrence จะส่งผ่านสถานะซ่อนผ่านการแปลงที่กำหนด
การทำ backpropagation ผ่านเวลา
RNNs ถูกฝึกด้วย backpropagation ผ่านเวลา (BPTT) ลำดับที่ unrolled สร้างกราฟคอมพิวเตอร์เชิงลึก, และ backpropagation คำนวณว่าค่าขาดทุนขึ้นอยู่กับพารามิเตอร์ recurrent ที่แชร์อย่างไร
การคูณซ้ำ ๆ อาจทำให้ gradient ลดลงจนศูนย์หรือเพิ่มขึ้นโดยไม่มีขอบเขต Gradient ที่หายไปทำให้การเรียนรู้ความสัมพันธ์ระยะยาวเป็นไปไม่ได้; Gradient ที่ระเบิดทำให้การอัปเดตไม่เสถียร การคลิป gradient ช่วยแก้ปัญหา gradient ระเบิด, ในขณะที่การใช้เกต, การเริ่มต้น, การทำ normalization, และช่วงการฝึกที่สั้นลงสามารถช่วยได้
ภายในเซลล์ LSTM
LSTM รักษา cell state cₜ นอกเหนือจากสถานะซ่อน hₜ. เกตของมันเป็นการควบคุมที่เรียนรู้และขึ้นกับข้อมูล:
- The forget gate ควบคุมว่ารักษาสถานะเซลล์ก่อนหน้าเท่าใด
- The input gate ควบคุมว่าข้อมูลผู้สมัครจะถูกเขียนเข้าไปเท่าใด
- The output gate ควบคุมว่าข้อมูลเซลล์จะส่งผลต่อสถานะซ่อนเท่าใด
เอาต์พุตของ sigmoid ระหว่างศูนย์ถึงหนึ่งทำหน้าที่เป็นเกตแบบอ่อน, ในขณะที่ผู้สมัครที่ผ่านการแปลงด้วย tanh ให้เนื้อหาใหม่ เส้นทาง cell-state แบบบวกช่วยให้ gradient คงอยู่, แต่ LSTM ไม่รับประกันหน่วยความจำไม่จำกัดหรือขจัดปัญหาการเพิ่มประสิทธิภาพทั้งหมด
GRU และการ recurrence แบบสองทิศทาง
Gated recurrent unit (GRU) รวมกลไกเกตเข้าด้วยกันในเซลล์ recurrent ที่เรียบง่ายโดยไม่มี cell state แบบ LSTM แยกออก GRU สามารถฝึกได้เร็วกว่าและทำงานได้คล้ายกันในบางงาน
RNN แบบสองทิศทางประมวลผลลำดับที่ครบแล้วในทั้งสองทิศทางและรวมสถานะเข้าด้วยกัน สามารถใช้บริบทในอนาคตสำหรับการแท็กหรือการเข้ารหัส, แต่ไม่เหมาะกับการสตรีมเชิงสาเหตุเมื่ออินพุตในอนาคตยังไม่พร้อม
โมเดล Sequence-to-sequence
RNN แบบ Encoder-Decoder แปลงลำดับหนึ่งเป็นอีกลำดับหนึ่ง Attention ถูกนำมาใช้เพื่อให้ decoder สามารถอ้างอิงสถานะ encoder ต่าง ๆ แทนการพึ่งพาเวกเตอร์คงที่หนึ่งตัว งานสายนี้นำไปสู่สถาปัตยกรรม transformer ที่แทนที่การ recurrence ด้วยบล็อกที่ใช้ attention
RNNs กับ Transformers
Transformers ประมวลผลตำแหน่งการฝึกแบบขนานและสร้างเส้นทาง attention สั้น ๆ ระหว่างโทเคนที่ห่างไกล RNNs ประมวลผลสถานะตามลำดับ, จำกัดการขนานแต่ให้สถานะ recurrent ขนาดคงที่ระหว่างการสตรีม การสรุปผลของ Transformer อาจต้องใช้แคช key‑value ที่เพิ่มขึ้น, ในขณะที่ RNN บีบอัดประวัติลงในสถานะซ่อนและอาจสูญเสียรายละเอียด
เลือกตามความยาวของลำดับ, ขนาดข้อมูล, ฮาร์ดแวร์, ความหน่วง, หน่วยความจำ, และว่าหน้าที่เป็นแบบออฟไลน์หรือสตรีม สถาปัตยกรรมแบบไฮบริดและ state‑space ให้การแลกเปลี่ยนเพิ่มเติม
กรณีการใช้งานปัจจุบัน
RNNs และ LSTMs ยังคงมีความสำคัญต่อการพยากรณ์, การตรวจจับความผิดปกติ, การประมวลผลเซนเซอร์, ส่วนประกอบการพูด, การเขียนด้วยมือ, การควบคุมแบบฝัง, และการสร้างโมเดลลำดับความหน่วงต่ำ พวกมันไม่ใช่คำอธิบายเริ่มต้นสำหรับโมเดลภาษาใหญ่หรือ AI chatbot ปัจจุบัน
Recurrence, เกต, และหน่วยความจำของลำดับ
เครือข่ายประสาทแบบ recurrent ประมวลผลลำดับโดยรวมอินพุตปัจจุบันกับสถานะซ่อนที่นำมาจากขั้นตอนก่อนหน้า น้ำหนักที่แชร์ทำให้รองรับความยาวลำดับที่เปลี่ยนแปลงได้, และการ unroll เปิดเผยการคำนวณตามเวลาเพื่อการฝึก RNN พื้นฐานสามารถแสดงความขึ้นต่อกันเชิงเวลาได้ แต่ gradient ที่คูณซ้ำ ๆ ผ่านลำดับยาวมักหายไปหรือระเบิด การ backpropagation แบบตัดส่วนจำกัดหน่วยความจำและการคำนวณ, ในขณะที่การคลิป gradient ควบคุมการอัปเดตสุดขีด สถานะซ่อนเป็นสรุปที่เรียนรู้, ไม่ใช่การเก็บข้อมูลที่ถูกต้องของทุกโทเคนก่อนหน้า
เครือข่าย Long short-term memory เพิ่ม cell state และเกต input, forget, และ output ที่ควบคุมการเขียน, การเก็บรักษา, และการเปิดเผยข้อมูล Gated recurrent units ใช้โครงสร้าง reset และ update ที่เรียบง่ายกว่า รุ่นสองทิศทางใช้บริบทในอนาคตและจึงไม่สามารถสตรีมแบบสาเหตุได้โดยไม่มีความล่าช้า โมเดล recurrent ที่ stacked, residual, และเสริมด้วย attention เพิ่มความจุ Padding และ mask ต้องป้องกันไม่ให้องค์ประกอบลำดับเทียมส่งผลต่อสถานะหรือ loss, และควรรีเซ็ตสถานะที่ขอบเขตลำดับจริงเพื่อหลีกเลี่ยงการรั่วไหลระหว่างตัวอย่าง
การฝึก, การเปรียบเทียบ, และการให้บริการแบบ stateful
RNNs และ LSTMs ยังคงมีประโยชน์สำหรับการสตรีม, โมเดลบนอุปกรณ์ที่กะทัดรัด, ซีรีส์เวลา, และงานที่สถานะเชิงลำดับมีประสิทธิภาพ Transformers ทำการฝึกแบบขนานและโมเดลการโต้ตอบระยะไกลต่างกันแต่อาจต้องการหน่วยความจำและแคชที่ใหญ่กว่า เปรียบเทียบสถาปัตยกรรมตามความแม่นยำ, ความหน่วง, throughput, หน่วยความจำ, พลังงาน, และประสิทธิภาพเมื่อความยาวลำดับเปลี่ยนแปลง ประเมินการพยากรณ์ด้วยการแบ่งเวลาแบบ rolling, ภาษาโดยใช้เมตริกที่รับรู้ลำดับ, และการตรวจจับความผิดปกติด้วยการวัดระดับเหตุการณ์ ตรวจสอบความล้มเหลือหลังจากช่วงเวลายาว, การเปลี่ยนแปลงระบอบ, ตัวอย่างที่หายไป, และขอบเขตลำดับที่กะทันหัน
การปรับใช้แบบ stateful ต้องเชื่อมสถานะซ่อนกับเซสชันที่ถูกต้อง, กำหนดอายุ, เข้ารหัสหากเป็นข้อมูลสำคัญ, และรีเซ็ตหลังจากข้อผิดพลาดหรือการเปลี่ยนแปลงโมเดล เหตุการณ์ที่ลำดับผิดหรือซ้ำซ้อนอาจทำให้สถานะเสียหาย; ควรใส่ timestamp, หมายเลขลำดับ, และความเป็น idempotent ตรวจสอบอายุของสถานะ, ความยาวลำดับ, การหายไป, การเบี่ยงเบนของผลลัพธ์, และความหน่วง การควอนติฟายต้องการการตรวจสอบที่อ่อนไหวต่อเกต เนื่องจากการเปลี่ยนแปลงตัวเลขเล็ก ๆ สามารถสะสมตามเวลา หน่วยความจำของ RNN ทำให้มีบริบท, แต่ก็อาจเก็บข้อมูลส่วนตัวหรือข้อมูลล้าสมัยไว้, ดังนั้นการเก็บรักษาและการควบคุมผู้ใช้ควรอยู่ในออกแบบ
ตัวอย่างทำงาน: LSTM สำหรับสตรีมเซนเซอร์ลำดับ
ยูทิลิตี้ใช้ LSTM เพื่อพยากรณ์โหลดระยะสั้นจากการวัดล่าสุด, ปฏิทิน, และสภาพอากาศ ลำดับถูกสร้างด้วยลำดับเวลาที่เคร่งครัด; สถานะซ่อนรีเซ็ตที่ขอบเขต feeder, และ padding ถูก mask baseline แบบ seasonal‑naive และ gradient‑boosted ถูกเปรียบเทียบกับ LSTM ผ่านหน้าต่าง rolling การทดสอบครอบคลุมช่วงเวลาที่หายไป, สภาพอากาศล่าช้า, วันหยุด, การขัดข้อง, และความยาวลำดับที่เกินการฝึกปกติ
บริการสตรีมเชื่อมสถานะกับ feeder หนึ่ง, ปฏิเสธข้อมูลซ้ำที่ลำดับผิด, และกำหนดอายุสถานะหลังจากช่วงเวลายาวหรือการอัปเดตโมเดล การพยากรณ์สถิติที่ปลอดภัยจะทดแทนผลลัพธ์เมื่อเซนเซอร์หรือสถานะไม่ถูกต้อง การสรุปผลแบบ quantized ถูกตรวจสอบบนลำดับยาวเพื่อหาการเบี่ยงเบนที่สะสม การเฝ้าติดตามบันทึกอายุของสถานะ, การหายไป, ความหน่วง, ความเอนเอียง, และข้อผิดพลาดของช่วงเวลา โมเดลจะฝึกใหม่เฉพาะหลังจากการเปลี่ยนแปลงกริดและผลลัพธ์ที่ตรวจสอบแสดงว่าความสัมพันธ์เชิงเวลา ที่เรียนรู้แล้วไม่สามารถทั่วไปได้อีกต่อไป
หลักฐานการใช้งานและความพร้อมในการปฏิบัติ
การตัดสินใจเชิงผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้าง baseline ที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของขึ้นต่อ, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, throughput, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน, กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษา fallback ที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยการฉีดความล้มเหลวโดยเจตนา Telemetry การปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพของขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลสำคัญที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
LSTM ดีกว่า RNN พื้นฐานเสมอหรือไม่?
ไม่. เกตช่วยแก้ปัญหาความขึ้นต่อกันระยะยาวหลายกรณีแต่เพิ่มการคำนวณและพารามิเตอร์ RNN พื้นฐานอาจเพียงพอสำหรับลำดับสั้นและง่าย, และสถาปัตยกรรมอื่นอาจดีกว่าสำหรับบริบทที่ยาวมาก
LSTM สามารถประมวลผลประวัติไม่จำกัดได้หรือไม่?
ไม่. สถานะของมันมีความจุจำกัด, gradient และข้อมูลการฝึกกำหนดขอบเขต, และรายละเอียดที่สำคัญอาจถูกเขียนทับ ประสิทธิภาพในบริบทยาวต้องวัดจริงแทนการสรุปจากชื่อสถาปัตยกรรม
อ้างอิงหลัก












