
พื้นฐาน AI
Ensemble Learning คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
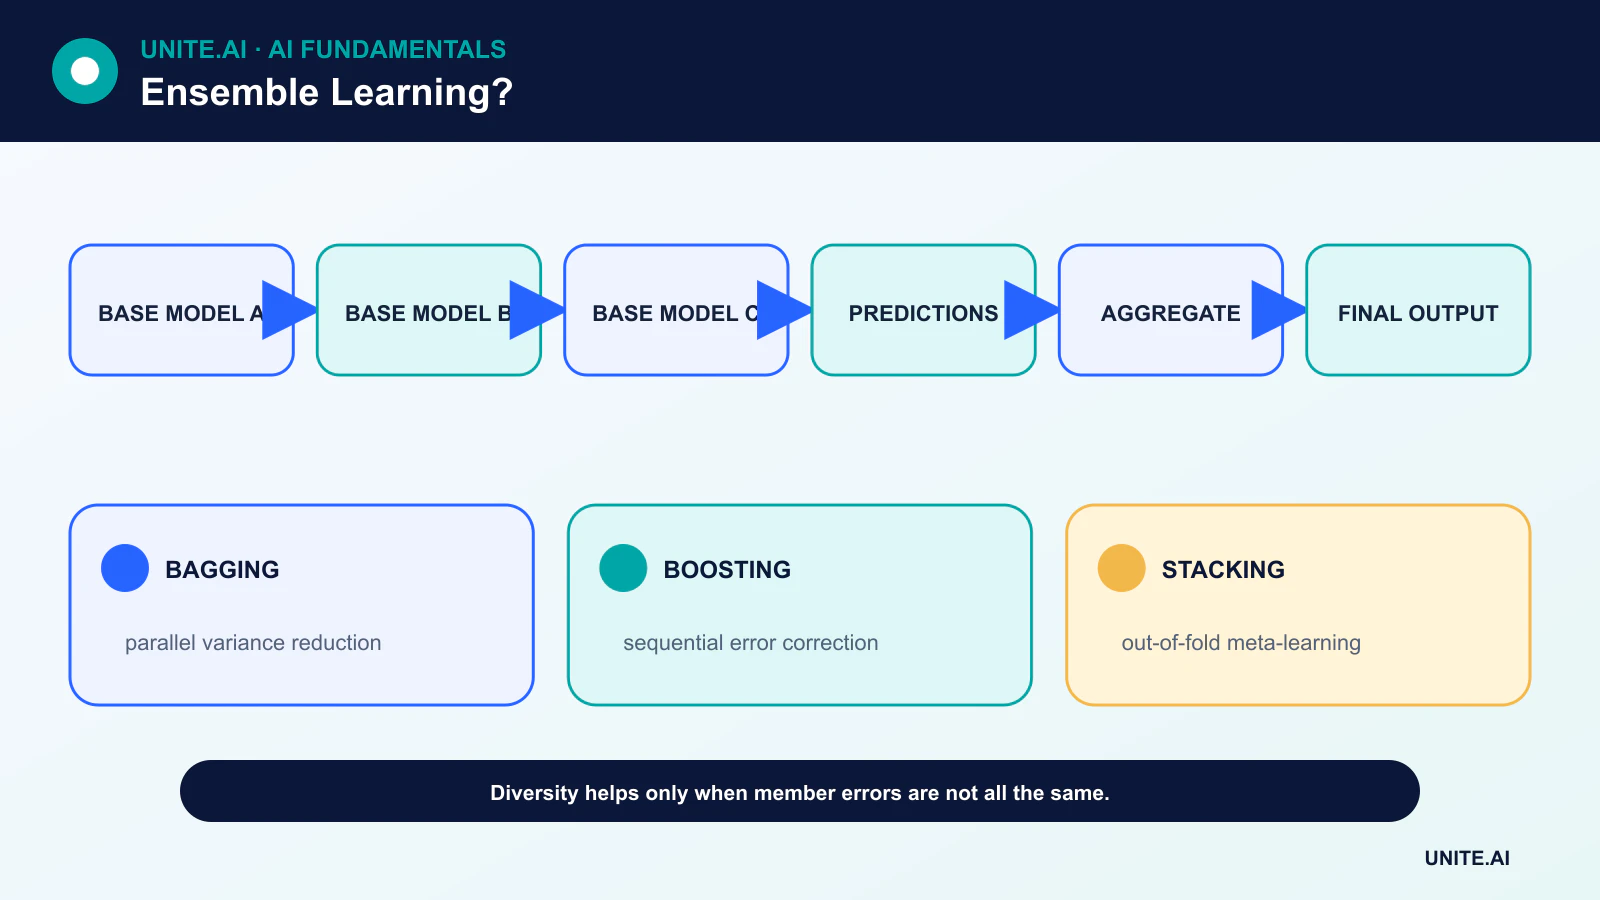
Ensemble learning รวมการทำนายจากหลายโมเดล แนวคิดหลักคือโมเดลที่มีข้อผิดพลาดต่างกันสามารถให้ผลลัพธ์ที่แม่นยำหรือเสถียรยิ่งขึ้นเมื่อผลลัพธ์ของพวกมันถูกเฉลี่ย, โหวต หรือส่งต่อให้กับเมตา-เลิร์นเนอร์
การเพิ่มโมเดลไม่เพียงพอ หากสมาชิกทุกคนเรียนรู้วิธีลัดเดียวกัน ข้อผิดพลาดของพวกเขาจะสัมพันธ์กันและ ensemble อาจเพียงแค่มั่นใจมากขึ้นในความผิดพลาดเดียวกัน
ประเด็นสำคัญ
- Ensemble จะทำงานได้ดีที่สุดเมื่อโมเดลสมาชิกแต่ละตัวมีประโยชน์และทำข้อผิดพลาดที่แตกต่างกันอย่างมีนัยสำคัญ
- Bagging ฝึกสมาชิกแบบขนานบนข้อมูลที่สุ่มซ้ำ; Boosting ฝึกผู้เรียนแบบต่อเนื่องเพื่อแก้ไขข้อผิดพลาด
- Stacking ฝึกเมตาโมเดลบนการทำนาย out-of-fold ไม่ใช่การทำนายในตัวอย่างเดียว
- การเพิ่มความแม่นยำต้องถ่วงดุลกับความหน่วง, การปรับเทียบ, ความสามารถอธิบายผลและต้นทุนการบำรุงรักษา
การโหวตและการเฉลี่ย
Hard voting เลือกคลาสที่ได้รับโหวตมากที่สุด Soft voting เฉลี่ยความน่าจะเป็นของคลาส โดยทั่วไปหลังการปรับเทียบ Ensemble สำหรับการถดถอยมักจะเฉลี่ยค่าทำนายเชิงตัวเลข เวอร์ชันที่ใช้ค่าน้ำหนักจะให้อิทธิพลมากกว่ากับสมาชิกที่แข็งแกร่งกว่า
การเฉลี่ยสามารถลดความแปรปรวนเมื่อข้อผิดพลาดไม่ได้สัมพันธ์อย่างสมบูรณ์แบบ แต่ไม่สามารถแก้ไขข้อบกพร่องของข้อมูลที่แชร์, ข้อผิดพลาดของป้ายกำกับ หรือกลุ่มย่อยที่หายไป ความหลากหลายควรวัดจากความไม่เห็นด้วยและการทับซ้อนของข้อผิดพลาด ไม่ใช่สันนิษฐานจากชื่อโมเดลที่แตกต่างกัน
Bagging และ Random Forests
Bootstrap aggregating ฝึกโมเดลบนชุดข้อมูลที่สุ่มซ้ำและทำการเฉลี่ย โมเดล ต้นไม้ตัดสินใจ มีความแปรปรวนสูง ทำให้เป็นตัวเลือกธรรมชาติสำหรับ bagging
Random forests เพิ่มการเลือกฟีเจอร์แบบสุ่มที่การแยกทำให้ความสัมพันธ์ระหว่างต้นไม้ลดลง ตัวอย่าง out-of-bag สามารถประมาณประสิทธิภาพได้ แต่ชุดทดสอบสุดท้ายที่ยังไม่ถูกใช้ยังคงมีคุณค่าสำหรับการเลือกโมเดลและการอ้างอิงการนำไปใช้งาน
Boosting
Boosting สร้างโมเดลเชิงบวกในหลายขั้นตอน ผู้เรียนภายหลังจะมุ่งเน้นที่ตัวอย่างหรือรูปแบบส่วนเหลือที่ ensemble ปัจจุบันจัดการได้ไม่ดี AdaBoost ปรับน้ำหนักตัวอย่าง; การบูสต์แบบเกรเดียนท์ ฝึกผู้เรียนให้สอดคล้องกับกราดิเอนท์ลบของฟังก์ชันสูญเสียที่เลือก
ต้นไม้ที่บูสต์สามารถจำลองความสัมพันธ์เชิงตารางที่ซับซ้อนได้ แต่ต้นไม้ลึก, รอบมากเกินไปและการรั่วไหลยังอาจ ฝึกเกิน ได้ อัตราการเรียนรู้, ความลึกของต้นไม้, การสุ่มตัวอย่างย่อยและการหยุดก่อนล่วงหน้าเป็นการควบคุมสำคัญ
Stacking และ Blending
Stacking สร้างโมเดลระดับสองที่เรียนรู้วิธีการรวมการทำนายของโมเดลฐาน เพื่อหลีกเลี่ยงการรั่วไหล ทุกแถวการฝึกสำหรับเมตาโมเดลต้องมาจากโมเดลฐานที่ไม่ได้ฝึกบนแถวนั้น การทำ cross-validation สร้างการทำนาย out-of-fold เหล่านี้
Blending ใช้ชุด holdout แยกสำหรับเมตาโมเดล ซึ่งง่ายกว่าแต่ลดข้อมูลที่ใช้ฝึก ทั้งสองวิธีต้องการการเตรียมข้อมูลและการควบคุมเวอร์ชันเดียวกันในขั้นตอน inference
การแลกเปลี่ยนเชิงปฏิบัติการ
Ensemble อาจเพิ่มการใช้หน่วยความจำ, การคำนวณและโหมดความล้มเหลว มันอาจยากต่อการอธิบาย, ปรับเทียบและอัปเดตอย่างสม่ำเสมอ Distillation สามารถบีบอัด Ensemble ให้เป็นโมเดลขนาดเล็กกว่าได้ แต่ต้องประเมินนักเรียน (student) อย่างอิสระ
การคัดเลือกเชิงปฏิบัติกำหนดเปรียบเทียบประสิทธิภาพ, ความหน่วงส่วนท้าย, การปรับเทียบ, การใช้ทรัพยากรและต้นทุนข้อผิดพลาด บางครั้งโมเดลที่มีการปรับสม่ำเสมอดีหนึ่งตัวอาจดีกว่าการเพิ่มความแม่นยำเล็กน้อยจากสแตกที่เปราะบาง
ทำไม Ensemble จึงทำงาน
Ensemble learning รวมหลายโมเดลเพื่อให้ข้อผิดพลาดของพวกมันบางส่วนหักล้างกันหรือจุดแข็งของแต่ละโมเดลครอบคลุมพื้นที่ต่าง ๆ Bagging ฝึกโมเดลบนข้อมูลที่สุ่มซ้ำและทำการเฉลี่ยการทำนาย เพื่อลดความแปรปรวน; Random forests เพิ่มการเลือกฟีเจอร์แบบสุ่มเพื่อทำให้ต้นไม้ไม่สัมพันธ์กัน Boosting ฝึกผู้เรียนแบบต่อเนื่องเพื่อมุ่งเน้นที่ข้อผิดพลาดส่วนเหลือ ซึ่งมักลดอคติแต่เพิ่มความไวต่อสัญญาณรบกวนและการปรับจูน Stacking ฝึกเมตาโมเดลบนการทำนายของโมเดลฐาน ความหลากหลายต้องมีประโยชน์: การเฉลี่ยโมเดลที่เหมือนกันเพิ่มต้นทุนโดยไม่มีการลดข้อผิดพลาดอย่างมีนัยสำคัญ
ความสัมพันธ์ระหว่างข้อผิดพลาดกำหนดประโยชน์ ความหลากหลายอาจมาจากตัวอย่างข้อมูล, ฟีเจอร์, อัลกอริทึม, ไฮเปอร์พารามิเตอร์, การเริ่มต้นแบบสุ่ม หรือช่วงเวลา Hard voting ลบความมั่นใจ; soft voting เฉลี่ยความน่าจะเป็นแต่ต้องการการปรับเทียบที่สอดคล้อง Regression สามารถเฉลี่ยหรือใช้การรวมแบบทนทาน ใน stacking การทำนาย out-of-fold เป็นสิ่งจำเป็น — การฝึกเมตาโมเดลบนการทำนายของโมเดลฐานจากข้อมูลที่ฝึกเดียวกันทำให้เกิดการรั่วไหล ควรรักษา baseline การเฉลี่ยแบบง่ายก่อนนำคอมไบเนอร์ที่ซับซ้อนมาใช้
การประเมิน, การปรับเทียบ, และความไม่แน่นอน
เปรียบเทียบสมาชิกแต่ละตัวและ ensemble บนชุดข้อมูล hold-out ที่มีการเตรียมข้อมูลเดียวกัน รายงานเมตริกของงาน, การปรับเทียบ, ข้อผิดพลาดของกลุ่มย่อย, ความแปรปรวนระหว่าง folds หรือ seeds, และต้นทุนทรัพยากร Ensemble สามารถปรับปรุงคุณภาพเฉลี่ยได้ในขณะที่ปกปิด blind spot ที่แชร์จากข้อมูลหรือป้ายกำกับที่ทั่วไป ตรวจสอบความไม่เห็นด้วย: อาจระบุความไม่แน่นอน, แต่โมเดลที่ผิดอย่างมั่นใจและสัมพันธ์กันอาจเห็นด้วย ปรับเทียบ ensemble สุดท้าย ไม่ใช่เฉพาะสมาชิก, และตรวจสอบเกณฑ์การละเว้นต่อความสามารถในการตรวจสอบและผลกระทบ
การประมาณค่า out-of-bag มีประโยชน์สำหรับโมเดลที่ทำ bagging แต่ไม่สามารถแทนที่การทดสอบสุดท้ายที่เป็นตัวแทนการใช้งานจริงได้ สำหรับข้อมูลเชิงเวลา ควรหลีกเลี่ยงการสุ่มซ้ำที่ทำให้ลำดับเสียหาย สำหรับการใช้งานที่เกี่ยวกับความปลอดภัย ควรทดสอบความล้มเหลวของสมาชิก, โมเดลที่ล้าสมัย, และอินพุตแบบโจมตี Ensemble ที่ใช้ค่าน้ำหนักอาจ overfit ข้อมูล validation เมื่อมีการลองผู้สมัครหลายคน บันทึกการคัดเลือกผู้สมัครและใช้การ validation แบบซ้อนเมื่อการปรับจูนมีขอบเขตกว้าง
การให้บริการและการบำรุงรักษา
Ensemble เพิ่มการใช้หน่วยความจำ, ความหน่วง, พลังงาน, และการพึ่งพาเชิงปฏิบัติการ Distillation อาจบีบอัดพฤติกรรมที่รวมกันเป็นโมเดลเดียว พร้อมความต้องการการ validation ใหม่ เวอร์ชันสมาชิก, การเตรียมข้อมูล, ค่าน้ำหนัก, และการ routing เป็นศิลปวัตถุเดียว; กำหนดพฤติกรรมเมื่อสมาชิกหมดเวลา หรือให้ผลลัพธ์ที่ไม่ถูกต้อง ตรวจสอบการทำนายของสมาชิกและความไม่เห็นด้วยเพื่อให้การล้มเหลวแบบเงียบเห็นได้ ถอนสมาชิกที่ซ้ำซ้อนและฝึกใหม่โดยตั้งใจ Ensemble ปรับปรุงการทำนายเมื่อความหลากหลายของข้อผิดพลาดเป็นจริง แต่ไม่สามารถทำให้ข้อมูลฝึกที่มีอคติหรือเป้าหมายที่ไม่ถูกต้องกลายเป็นหลักฐานที่เชื่อถือได้
ตัวอย่างการทำงาน: Ensemble สำหรับการแจ้งเตือนสภาพอากาศรุนแรง
ทีมพยากรณ์รวมชุดคุณลักษณะจากโมเดลฟิสิกส์, ต้นไม้ gradient-boosted, โมเดลลำดับประสาท, และฐานสถิติที่ปรับเทียบแล้ว การทำนาย out-of-fold ฝึกเมตาโมเดลแบบง่าย และการประเมินใช้พายุในอนาคตที่ไม่ได้ใช้ในการฝึกสมาชิกเลย เมตริกรวมถึงการเรียกคืนเหตุการณ์, การเตือนเท็จ, ระยะเวลาเตือนล่วงหน้า, การปรับเทียบ, ประสิทธิภาพเชิงภูมิศาสตร์, และความน่าเชื่อถือในสภาวะสุดขั้วที่หายาก การตรวจสอบความสัมพันธ์ของข้อผิดพลาดของสมาชิกทำเพราะข้อมูลอินพุตที่แชร์อาจสร้าง blind spot ที่แชร์
การให้บริการเก็บรักษาการทำนายแต่ละรายการและผลลัพธ์ที่รวมกัน หากสมาชิกไม่พร้อมใช้งาน ระบบจะใช้การกำหนดค่าที่ลดลงและผ่านการตรวจสอบล่วงหน้า แทนการปรับค่าใหม่อย่างเงียบ ความไม่เห็นด้วยกระตุ้นการตรวจสอบเพิ่มเติมแต่ไม่ได้ถือเป็นความไม่แน่นอนในทุกกรณี การตรวจสอบติดตามการเปลี่ยนแปลงของสมาชิก, ความหน่วง, และผลลัพธ์ของพายุ โดยค่าน้ำหนักอัปเดตเฉพาะผ่านการ validation ที่ควบคุม คำเตือนสาธารณะยังคงอยู่ภายใต้กระบวนการตัดสินใจของหน่วยงานอุตุนิยมวิทยาที่ได้รับอนุญาต; Ensemble ปรับปรุงหลักฐานแต่ไม่เปลี่ยนแปลงนโยบายการเตือนโดยอัตโนมัติ
หลักฐานการใช้งานและความพร้อมเชิงปฏิบัติการ
การตัดสินใจในระดับผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการถอดถอน ใช้การเปิดตัวแบบขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยการใส่ความล้มเหลวโดยเจตนา Telemetry เชิงปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษาที่บันทึกไว้, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
Random forest เป็น Ensemble หรือไม่?
ใช่. มันรวมต้นไม้ตัดสินใจแบบสุ่มหลายต้นโดยปกติผ่านการโหวตหรือการเฉลี่ย.
โมเดลที่เหมือนกันสามารถสร้าง Ensemble ที่มีประโยชน์ได้หรือไม่?
พวกมันสามารถทำได้หากข้อมูลการฝึก, การเริ่มต้นหรือการสุ่มสร้างข้อผิดพลาดที่แตกต่างอย่างเพียงพอ, แต่การทำซ้ำเพียงอย่างเดียวไม่ให้ประโยชน์ใด ๆ
อ้างอิงหลัก












