พื้นฐาน AI
Few-Shot Learning คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Few-shot learning ศึกษาว่าโมเดลสามารถปรับตัวให้ทำงานหรือจำแนกคลาสใหม่ได้อย่างไรจากตัวอย่างที่มีป้ายกำกับเพียงไม่กี่ตัวอย่างเท่านั้น ในชุดมาตรฐานแบบคลาสสิก หนึ่งเอพิโซดจะให้ชุดสนับสนุน—เช่นห้าคลาสที่มีหนึ่งหรือห้าตัวอย่างต่อคลาส—และให้โมเดลจำแนกคำถามที่ไม่เคยเห็น
คำนี้ยังใช้สำหรับการเรียนรู้ในบริบท (in‑context learning) ซึ่งโมเดลภาษาแบบ pretrained จะได้รับตัวอย่างสาธิตไม่กี่ตัวในพรอมต์โดยไม่ต้องอัปเดตพารามิเตอร์ การตั้งค่านี้มีเป้าหมายใช้ตัวอย่างน้อย แต่ใช้กลไกการปรับตัวที่ต่างกันและต้องการการออกแบบการประเมินที่แตกต่างกัน
ประเด็นสำคัญ
- N‑way K‑shot หมายถึง N คลาสและ K ตัวอย่างสนับสนุนที่มีป้ายกำกับต่อคลาส
- วิธีการเรียนรู้เมตริก (metric‑learning) จะเปรียบเทียบคำถามกับการแทนค่าที่เรียนรู้จากตัวอย่างสนับสนุน
- เมตา‑learning ปรับแต่งโดยอาศัยหลายงานเพื่อให้งานใหม่สามารถเรียนรู้ได้อย่างรวดเร็ว
- ตัวอย่างจำนวนเล็กน้อยทำให้ข้อผิดพลาดของป้ายกำกับ การรั่วไหล ความคลุมเครือของคลาสและความไม่แน่นอนเพิ่มขึ้น ดังนั้นฐานเปรียบเทียบและการรายงานความเชื่อมั่นจึงสำคัญ
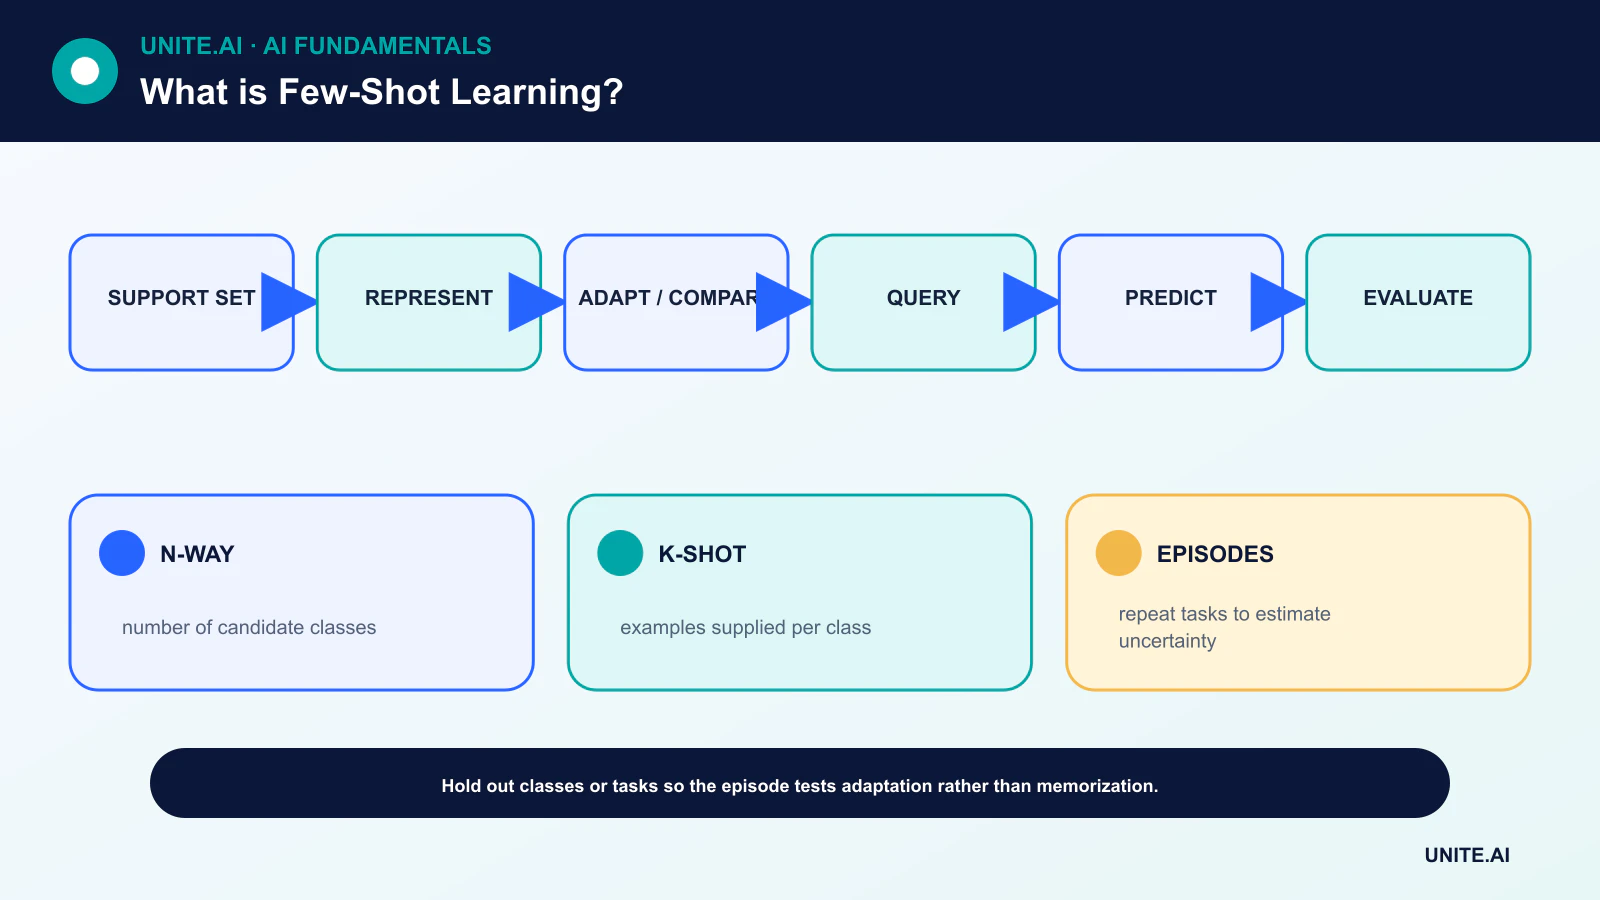
เอพิโซด, ชุดสนับสนุนและชุดคำถาม
เอพิโซดแบบ few‑shot แยกชุดสนับสนุนที่มีป้ายกำกับขนาดเล็กออกจากชุดคำถามที่ใช้สำหรับการประเมิน ในระหว่างการเมตา‑training โมเดลจะเห็นเอพิโซดจำนวนมาก การประเมินที่แข็งแกร่งจะเก็บคลาส, งาน หรือโดเมนทั้งหมดไว้เป็นชุดทดสอบเพื่อให้เอพิโซดวัดการปรับตัวแทนการจดจำ
รายงานการกระจายของความแม่นยำจากหลายเอพิโซดแทนการใช้ตัวอย่างเดียวที่สะดวกเปรียบเทียบกับฐานเปรียบเทียบแบบ nearest‑neighbor อย่างง่ายและ linear; วิธีที่ซับซ้อนซึ่งไม่สามารถเอาชนะการแทนค่าที่ฝึกดีพร้อมกับตัวจำแนกพื้นฐานอาจไม่คุ้มค่ากับความซับซ้อนของมัน
การเรียนรู้เมตริกและต้นแบบ
Matching networks และวิธีการที่เกี่ยวข้องจะฝังตัวอย่างสนับสนุนและคำถามลงในพื้นที่ที่เวกเตอร์ใกล้เคียงควรมีป้ายกำกับเดียวกัน Prototypical networks จะเฉลี่ยการฝังของชุดสนับสนุนสำหรับแต่ละคลาสและจำแนกคำถามตามระยะห่างจากต้นแบบของคลาสเหล่านั้น
สิ่งนี้เชื่อมการเรียนรู้ few‑shot กับคุณภาพของการแทนค่า โมเดล deep‑learning ที่ผ่านการฝึกล่วงหน้าอาจจัดระเบียบคุณลักษณะที่เกี่ยวข้องได้ดีแล้ว ในขณะที่การแทนค่าที่ไม่ตรงกันอาจทำให้ระยะทางทุกค่าเป็นข้อมูลที่ทำให้เข้าใจผิด
เมตา‑learning แบบออพติไมซ์เซชัน
Model‑Agnostic Meta‑Learning มองหาพารามิเตอร์ที่สามารถปรับตัวได้ด้วยขั้นตอนการคำนวณเกรเดียนท์จำนวนเล็กน้อย วิธีอื่น ๆ จะเรียนรู้ตัวออพติไมเซอร์, การเริ่มต้น หรือกฎการอัปเดตพารามิเตอร์ ลูปภายนอกจะประเมินประสิทธิภาพหลังการปรับตัวข้ามงานต่าง ๆ
เมตา‑learning สมมติว่ามีโครงสร้างที่เป็นประโยชน์ซึ่งแชร์ระหว่างงานฝึกและงานเป้าหมาย เมื่อการกระจายของเป้าหมายแตกต่างอย่างชัดเจน การปรับตัวอย่างรวดเร็วอาจล้มเหลว การตรวจสอบควรเปลี่ยนจำนวนช็อต, จำนวนคลาส, โดเมนและความยากของงาน แทนการถือว่าเบนช์มาร์คหนึ่งเป็นสากล
การเรียนรู้แบบถ่ายโอนและกลยุทธ์ระดับข้อมูล
Transfer learning มักเป็นจุดเริ่มต้นที่มีประสิทธิภาพสูงสุด: ค้างตัวเข้ารหัสที่ผ่านการฝึกล่วงหน้า, ฝึกหัวเล็ก ๆ, แล้วทำการ fine‑tune อย่างเลือกสรรหากมีข้อมูลเพียงพอ การเพิ่มข้อมูล (data augmentation) สามารถสร้างความไม่เปลี่ยนแปลงได้ แต่ตัวอย่างสังเคราะห์ที่ไม่เป็นจริงอาจทำให้อคติเพิ่มขึ้นหรือสร้างทางลัด
Active learning สามารถจัดลำดับความสำคัญของตัวอย่างที่ต้องทำป้ายกำกับได้ ในขณะที่ semi‑supervised learning สามารถใช้ข้อมูลที่ไม่มีป้ายกำกับเพิ่มเติม กลยุทธ์เหล่านี้เป็นการเสริมกัน ไม่ใช่คำพ้องสำหรับการเรียนรู้ few‑shot
การใช้ few‑shot prompting แตกต่าง
Transformer สามารถสรุปรูปแบบจากการสาธิตที่วางในบริบทของมัน ไม่จำเป็นต้องอัปเดตพารามิเตอร์อย่างต่อเนื่อง ลำดับ, การใช้คำและความสมดุลของป้ายกำกับสามารถเปลี่ยนผลลัพธ์ได้อย่างมีนัยสำคัญ และตัวอย่างอาจใช้ส่วนใหญ่ของหน้าต่างบริบท
ใช้ชุดประเมินที่เป็นตัวแทน, ทำเวอร์ชันของแต่ละพรอมต์และการสาธิต, และทดสอบตัวเลือก zero‑shot, few‑shot และ fine‑tuned ชุดสนับสนุนขนาดเล็กไม่สามารถสนับสนุนข้ออ้างระดับประชากรอย่างแข็งแรงได้ โดยเฉพาะในกรณีที่หายากหรือมีความสำคัญต่อความปลอดภัย
รูปแบบการเรียนรู้ few‑shot และการสร้างงาน
Few‑shot learning มีเป้าหมายให้ทำงานจากตัวอย่างที่มีป้ายกำกับจำนวนเล็กมาก ในวิธีการแบบเมตริก ตัวเข้ารหัสจะแมปตัวอย่างเข้าสู่พื้นที่ที่ต้นแบบหรือเพื่อนบ้านที่ใกล้ที่สุดเป็นตัวแทนของคลาส การเมตา‑learning แบบออพติไมซ์เซชันฝึกการเริ่มต้นหรือกฎการอัปเดตเพื่อการปรับตัวอย่างรวดเร็ว Transfer learning ทำ fine‑tune โมเดลที่ผ่านการฝึกล่วงหน้าในชุดเป้าหมายขนาดเล็ก In‑context learning ให้ตัวอย่างในพรอมต์โดยไม่อัปเดตน้ำหนัก กลไกเหล่านี้แตกต่างกัน ดังนั้นข้ออ้างควรระบุว่าพารามิเตอร์มีการเปลี่ยนแปลงหรือไม่, การฝึกล่วงหน้าเป็นอย่างไร, และวิธีการเลือกตัวอย่าง
การประเมินควรแยกคลาส, งาน, หัวข้อ หรือโดเมนของการฝึกและการทดสอบตามการอ้างว่ามีการทั่วไปอย่างไร เอพิโซด N‑way K‑shot มี N คลาสและ K ตัวอย่างสนับสนุนต่อคลาส พร้อมด้วยตัวอย่างคำถามเพื่อการให้คะแนน เอพิโซดที่ทำซ้ำจะประมาณความแปรปรวนจากการเลือกชุดสนับสนุน สำหรับการ prompting ลำดับตัวอย่าง, การใช้คำของป้ายกำกับ, รูปแบบ, และความคล้ายของการสาธิตสามารถเปลี่ยนผลลัพธ์อย่างมีนัยสำคัญ เปรียบเทียบกับฐานเปรียบเทียบ zero‑shot, nearest‑neighbor, linear‑probe และ fine‑tuning ปกติโดยใช้การแทนค่าและงบประมาณข้อมูลเดียวกัน
คุณภาพข้อมูล, ความไม่แน่นอน, และการถ่ายโอนเชิงลบ
เมื่อมีตัวอย่างน้อย กรณีที่มีป้ายกำกับผิดหรือกรณีที่ไม่ปกติมีอิทธิพลมากเกินไป ควรกำหนดกฎการอธิบาย, ตรวจสอบแต่ละรายการสนับสนุน, และเก็บผลลัพธ์ที่ไม่ทราบหรือยอมไม่ตอบ การเพิ่มข้อมูลและตัวอย่างสังเคราะห์ช่วยได้เฉพาะเมื่อรักษางานและเพิ่มความแปรผันที่สมจริง โมเดลที่ผ่านการฝึกล่วงหน้าอาจถ่ายโอนทางลัดหรืออคติจากโดเมนต้นทาง ทดสอบกรณีนอกโดเมน, กลุ่มหายาก, และความไวต่อการลบตัวอย่างสนับสนุนหนึ่งรายการ รายงานช่วงความเชื่อมั่นข้ามงานและสุ่ม seed แทนการใช้พรอมต์ที่เป็นประโยชน์เดียว
Active learning สามารถขอป้ายกำกับในกรณีที่ให้ข้อมูลสำคัญได้ ในขณะที่วิธี semi‑supervised ใช้ข้อมูลที่ไม่มีป้ายกำกับเพิ่มเติม การเรียกค้นสามารถเลือกการสาธิตที่เกี่ยวข้องแบบไดนามิกได้แต่ต้องหลีกเลี่ยงการรั่วไหลของป้ายกำกับทดสอบ การปรับตัวอาจโอเวอร์ฟิตได้เร็ว ดังนั้นควรจำกัดการอัปเดต, ใช้การทำ regularization, และตรวจสอบด้วยตัวอย่างแยก สำหรับงานที่มีความเสี่ยงสูง ป้ายกำกับไม่กี่ตัวมักไม่เพียงพอที่จะตัดสินใจอัตโนมัติ ใช้โมเดลเพื่อจัดลำดับความสำคัญหรือช่วยตรวจสอบจนกว่าจะมีหลักฐานผลลัพธ์เพียงพอ
การดำเนินงานในผลิตภัณฑ์
ทำเวอร์ชันของโมเดลฐาน, การฝังหรือเทมเพลตพรอมต์, การสาธิต, สคีมาป้ายกำกับ, และพารามิเตอร์การปรับตัว ปกป้องตัวอย่างเนื่องจากพรอมต์หรือกราเดียนท์อาจเปิดเผยข้อมูลที่ละเอียดอ่อน ตรวจสอบประสิทธิภาพเมื่อคลาสและภาษามีการเปลี่ยนแปลง, และอัปเดตตัวอย่างสนับสนุนผ่านการตรวจสอบที่กำกับ ไม่ใช่การทำป้ายกำกับอัตโนมัติ การเรียนรู้ few‑shot ลดความต้องการของเป้าหมายที่มีป้ายกำกับโดยใช้โครงสร้างที่มีอยู่ก่อน; แต่ไม่ได้ขจัดความจำเป็นของการประเมินที่เป็นตัวแทน, การกำหนดงานอย่างระมัดระวัง, ความเชี่ยวชาญด้านโดเมน, หรือการสำรองที่ปลอดภัยเมื่อภารกิจใหม่อยู่นอกขอบเขตที่มี
ตัวอย่างการทำงาน: การจำแนกแบบ few‑shot สำหรับผลิตภัณฑ์ใหม่
ทีมสนับสนุนต้องการป้ายกำกับการส่งต่อสำหรับผลิตภัณฑ์ที่มีเพียงห้าตัวอย่างที่ตรวจสอบต่อปัญหา พวกเขาเปรียบเทียบต้นแบบที่ใกล้ที่สุดใน embedding ที่ผ่านการฝึกล่วงหน้า, หัวแบบ linear, การ fine‑tune ที่ประหยัดพารามิเตอร์, และการ prompting ในบริบท ครอบครัวผลิตภัณฑ์, ลูกค้า, และข้อความต่อมาถูกแยกออกจากเมตา‑training และการเลือกโมเดล การสุ่มชุดสนับสนุนหลายครั้งรายงานค่า recall ของคลาส, การปรับเทียบ, ความแปรปรวน, และความไวต่อการสาธิตที่มีป้ายกำกับผิดหนึ่งรายการ
ข้อความที่ความมั่นใจต่ำหรือไม่มีการสนับสนุนจะถูกส่งต่อไปยังการสนับสนุนทั่วไป, และผู้ตรวจสอบแก้ไขป้ายกำกับผ่านคิวที่กำกับ ตัวอย่างจะถูกทำให้ไม่ระบุตัวตน, ทำเวอร์ชัน, และไม่เคยเลือกจากชุดทดสอบสุดท้าย การตรวจสอบติดตามคำศัพท์ใหม่, อัตราคลาส, การแก้ไข, และความไม่เห็นด้วย เมื่อมีป้ายกำกับเพียงพอ ระบบ few‑shot จะถูกเปรียบเทียบกับการฝึกแบบมีผู้สอนแบบปกติ การตั้งค่าอย่างรวดเร็วเป็นประโยชน์, แต่ไม่ทำให้การอัตโนมัติเป็นเหตุผลหากประสิทธิภาพยังไม่เสถียรหรือหากผลิตภัณฑ์ใหม่แตกต่างอย่างมากจากกลุ่มงานก่อนหน้า
หลักฐานการดำเนินการและความพร้อมใช้งาน
การตัดสินใจในผลิตภัณฑ์ต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้างฐานเปรียบเทียบที่ทำซ้ำได้และชุดประเมินที่ทำเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนขึ้นต่อ, การใช้ผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยการฉีดข้อผิดพลาดโดยเจตนา เทเลเมตรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะส่วนขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, แล้วตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
การเรียนรู้แบบหนึ่งช็อต (one‑shot learning) เป็นเหมือนการเรียนรู้แบบไม่กี่ช็อต (few‑shot learning) หรือไม่?
One‑shot learning เป็นกรณีพิเศษที่มีตัวอย่างสนับสนุนที่มีป้ายกำกับหนึ่งตัวต่อคลาสหรือภารกิจ ส่วน zero‑shot learning ใช้ตัวอย่างเป้าหมายที่ไม่มีป้ายกำกับเลย
การเรียนรู้แบบ few‑shot ขจัดความต้องการข้อมูลหรือไม่?
ไม่ การเรียนรู้แบบ few‑shot ย้ายความพึ่งพาไปสู่ข้อมูลการฝึกล่วงหน้า, งานที่เกี่ยวข้อง, การแทนค่าและสมมติฐาน ป้ายกำกับเป้าหมายมีจำนวน少, แต่ประวัติการเรียนรู้ทั้งหมดมักจะมาก
อ้างอิงหลัก