
พื้นฐาน AI
เครือข่ายประสาทเทียมคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
เครือข่ายประสาทเทียม คือโมเดลคณิตศาสตร์ที่มีพารามิเตอร์ซึ่งสร้างจากชั้นของการดำเนินการที่เชื่อมต่อกัน ในระหว่างการฝึกเครือข่ายจะปรับพารามิเตอร์เพื่อให้ข้อมูลเข้าแมปไปยังผลลัพธ์ที่มีประโยชน์ เครือข่ายประสาทเทียมสามารถประมาณความสัมพันธ์เชิงไม่เชิงเส้นที่ซับซ้อนและเรียนรู้การแทนค่าต่าง ๆ โดยตรงจากข้อความ ภาพ เสียง ชุดข้อมูลเวลา และข้อมูลอื่น ๆ
ชื่อของมันได้รับแรงบันดาลใจจากประสาทชีวภาพในเชิงประวัติศาสตร์ แต่เครือข่ายสมัยใหม่เป็นระบบวิศวกรรมมากกว่าการจำลองสมองอย่างสมจริง คำว่า “neurons” และ “learning” เป็นคำย่อที่สะดวกและไม่ควรสับสนว่าเป็นหลักฐานของการรับรู้แบบมนุษย์
ประเด็นสำคัญ
- นิวรอนคำนวณผลรวมเชิงถ่วงน้ำหนัก เพิ่มค่าไบอัสที่ฝึกได้ และใช้ฟังก์ชันกระตุ้น
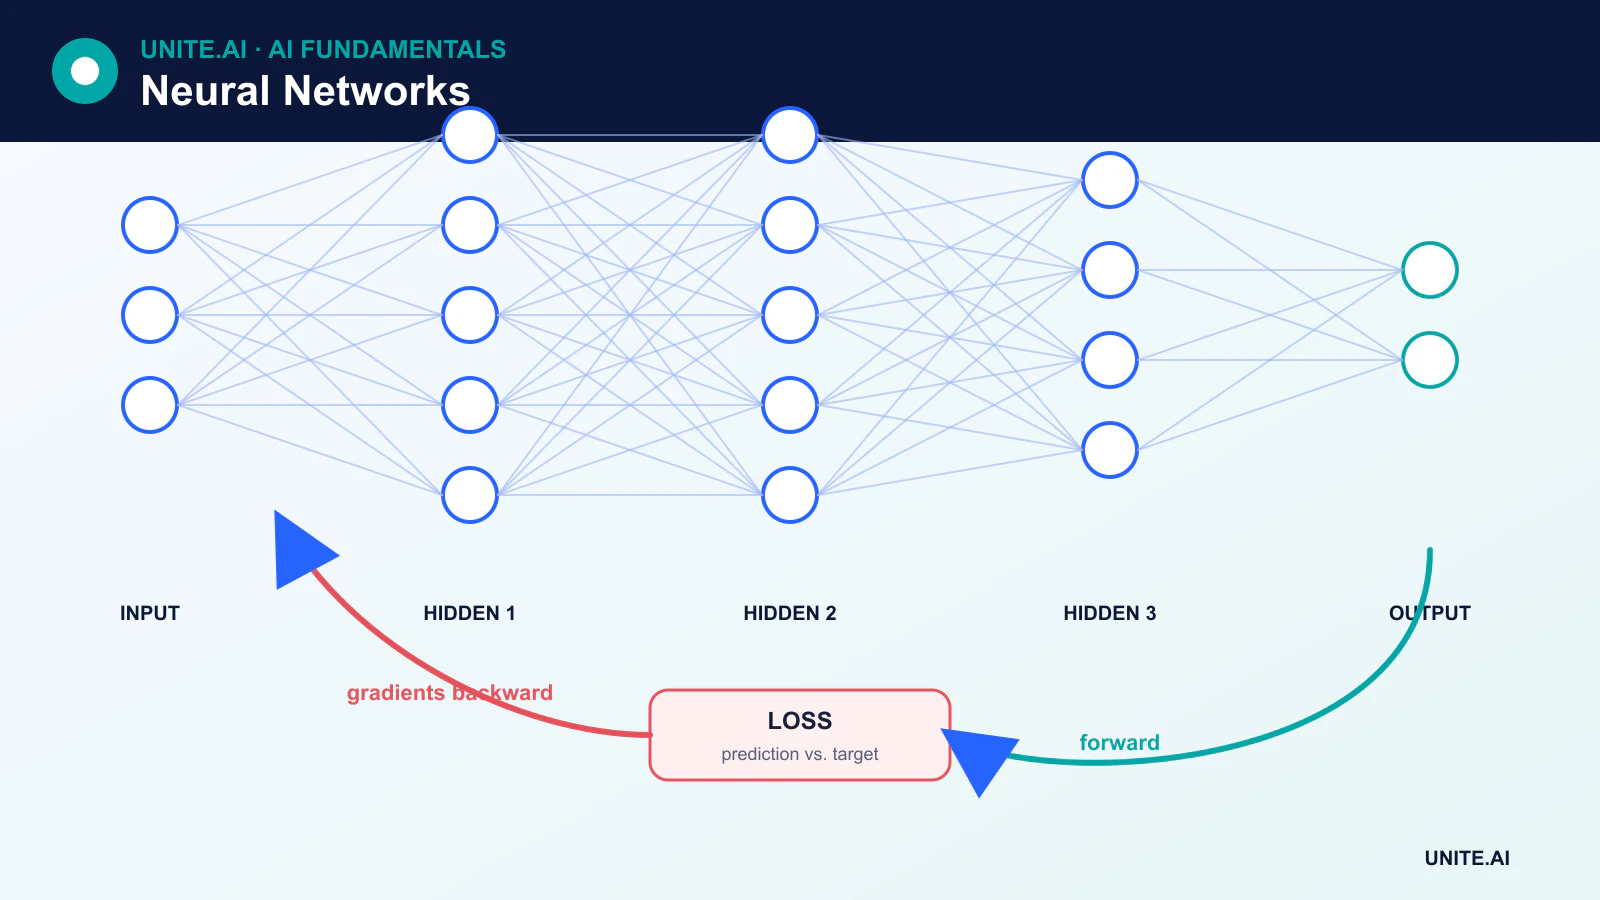
- การส่งผ่านแบบต่อหน้า (forward pass) สร้างการคาดการณ์; ฟังก์ชัน loss วัดความผิดพลาด; การย้อนกลับ (backpropagation) คำนวณเกรเดียนต์; ตัวปรับค่า (optimizer) ปรับพารามิเตอร์
- MLP, CNN, RNN, และ transformer จัดการการเชื่อมต่อในรูปแบบที่แตกต่างกัน
- การเพิ่มจำนวนชั้นหรือพารามิเตอร์ไม่ได้รับประกันว่าจะทำให้โมเดลดีขึ้นหรือเชื่อถือได้มากขึ้นโดยอัตโนมัติ
จากนิวรอนเทียมเดี่ยวสู่เครือข่าย
สำหรับเวกเตอร์อินพุต x หน่วยพื้นฐานคำนวณดังนี้:
z = Wx + boutput = activation(z)
W มีน้ำหนักที่ฝึกได้และ b เป็นไบอัสที่ฝึกได้ ฟังก์ชันกระตุ้นทำให้เกิดความไม่เชิงเส้น น้ำหนักไม่ได้ “ผ่าน” ฟังก์ชันกระตุ้นด้วยตนเอง; ฟังก์ชันกระตุ้นถูกนำไปใช้กับผลรวมเชิงถ่วงน้ำหนักและไบอัส
Multilayer Perceptron (MLP) สร้างจากชั้นหนาแน่น (dense layers) ชั้นอินพุตแทนคุณลักษณะ, ชั้นซ่อนทำการแปลง, และชั้นเอาต์พุตออกแบบตามภารกิจ—เช่น logits ของคลาสหรือค่าการถดถอย
วิธีที่เครือข่ายประสาทเรียนรู้
- โมเดลเริ่มต้นพารามิเตอร์ที่ฝึกได้
- การส่งผ่านแบบต่อหน้าประมวลผลแบชและสร้างการคาดการณ์
- ฟังก์ชัน loss เปรียบเทียบการคาดการณ์กับเป้าหมายการฝึก
- การย้อนกลับ ใช้กฎลูกโซ่เพื่อคำนวณเกรเดียนต์
- ตัวปรับค่า เช่น stochastic gradient descent หรือ AdamW ปรับน้ำหนักและไบอัส
การย้อนกลับกลายเป็นหัวใจของการฝึกเครือข่ายประสาทผ่านงานวิจัยหลายทศวรรษ; มันไม่ได้ถูกสร้างขึ้นครั้งแรกในยุค deep‑learning ล่าสุด เฟรมเวิร์กสมัยใหม่ใช้การแยกอนุพันธ์แบบย้อนกลับ (reverse‑mode automatic differentiation) เพื่อให้ผู้ปฏิบัติงานไม่ต้องคำนวณเกรเดียนต์ด้วยตนเองทุกขั้นตอน
ทำไมฟังก์ชันกระตุ้นถึงสำคัญ
หากไม่มีฟังก์ชันกระตุ้นเชิงไม่เชิงเส้นหลายชั้นเชิงเส้นธรรมดาจะถูกรวมเป็นการแปลงเชิงเส้นเดียว ReLU ถูกใช้อย่างกว้างขวางเนื่องจากเรียบง่ายและมีประสิทธิภาพ GELU และ SiLU เป็นฟังก์ชันที่พบบ่อยในสถาปัตยกรรมสมัยใหม่ Sigmoid และ softmax ยังคงมีประโยชน์สำหรับการตีความผลลัพธ์บางประเภท แต่ sigmoid อาจอิ่มตัวในชั้นซ่อนและทำให้เกรเดียนต์หายไป
สถาปัตยกรรมเครือข่ายประสาทหลัก
Convolutional neural networks
CNNs ใช้ฟิลเตอร์ที่เรียนรู้ผ่านพื้นที่ใกล้เคียงและแชร์พารามิเตอร์ระหว่างตำแหน่ง คุณสมบัตินี้ทำให้ CNN มีประสิทธิภาพสำหรับภาพและสัญญาณแบบกริดอื่น ๆ
Recurrent networks
RNNs, LSTMs, and GRUs ปรับสถานะซ่อนตามลำดับ พวกมันยังคงมีประโยชน์สำหรับงานสตรีมและซีรีส์เวลา แม้ว่าการทำซ้ำจะจำกัดการประมวลผลแบบขนานและอาจประสบปัญหากับการพึ่งพาระยะยาว
Transformers
Transformers ใช้ attention เพื่อสร้างการแทนค่าที่ขึ้นกับบริบท การเชื่อมต่อแบบ residual, การทำ normalization, ข้อมูลตำแหน่ง, และบล็อก feed‑forward เป็นส่วนสำคัญของสถาปัตยกรรม Transformers ปัจจุบันเป็นพื้นฐานของโมเดลภาษาขนาดใหญ่และโมเดลหลายโหมด
Autoencoders and generative networks
Autoencoders เรียนรู้การแทนค่าผ่านการสร้างใหม่ GANs, โมเดล diffusion, และเครือข่าย autoregressive สร้างตัวอย่างใหม่โดยใช้วัตถุประสงค์และขั้นตอนการฝึกที่แตกต่างกัน
ส่วนประกอบที่ทำให้เครือข่ายลึกสามารถฝึกได้
ระบบสมัยใหม่ใช้มากกว่าชั้นและฟังก์ชันกระตุ้น การเชื่อมต่อแบบ residual ทำให้ข้อมูลและเกรเดียนต์ข้ามบล็อกได้ การทำ normalization ทำให้ฟังก์ชันกระตุ้นเสถียร การทำ regularization, การเพิ่มข้อมูล, dropout, และการสลายน้ำหนัก (weight decay) สามารถลด overfitting ชั้น embedding แปลงรายการเชิงสัญลักษณ์เช่นโทเคนเป็นเวกเตอร์ Attention ทำให้การแทนค่าพึ่งพาองค์ประกอบอื่นแบบไดนามิก
จุดแข็งและข้อจำกัด
เครือข่ายประสาทสามารถเรียนรู้คุณลักษณะจากข้อมูลดิบมิติสูงและขยายตัวตามข้อมูลและการคำนวณได้ แต่พวกมันอาจต้องการชุดข้อมูลขนาดใหญ่, ฮาร์ดแวร์เฉพาะ, และการปรับจูนอย่างระมัดระวัง การคาดการณ์ของพวกมันอาจไม่เที่ยงตรง, มีความเปราะบางต่อการเปลี่ยนแปลงการกระจาย, เสี่ยงต่อการโจมตีแบบ adversarial, หรืออธิบายได้ยาก
สถาปัตยกรรมควรสอดคล้องกับภารกิจและข้อจำกัดการใช้งาน สำหรับปัญหาแบบตารางหลาย ๆ รายการ โมเดลแบบ tree ensemble หรือโมเดลเชิงเส้นอาจเร็วกว่าและตรวจสอบได้ง่ายกว่า สำหรับแอปพลิเคชันที่มีความเสี่ยงสูง ประสิทธิภาพของโมเดลต้องประเมินตามกลุ่มย่อยและโหมดความล้มเหลว ไม่ใช่แค่เกณฑ์สรุปรวม
ชั้น, ฟังก์ชันกระตุ้น, และการไหลของข้อมูล
เครือข่ายประสาทประกอบด้วยฟังก์ชันที่มีพารามิเตอร์ แต่ละหน่วยสร้างการผสมเชิงถ่วงน้ำหนักของอินพุต, เพิ่มไบอัส, แล้วส่งผลลัพธ์ผ่านฟังก์ชันกระตุ้นเช่น ReLU, sigmoid, tanh หรือ GELU การจัดชั้นทำให้เกิดคุณลักษณะเชิงลำดับชั้นและขอบเขตการตัดสินใจเชิงไม่เชิงเส้น ความกว้างควบคุมจำนวนหน่วยต่อชั้น; ความลึกควบคุมการแปลงต่อเนื่อง; การเชื่อมต่อและการแชร์น้ำหนักกำหนดสถาปัตยกรรม ผลลัพธ์ของเครือข่ายขึ้นกับการเตรียมข้อมูล, พารามิเตอร์, การทำ normalization, และโหมดการสรุปผลร่วมกัน นิวรอนเป็นการดำเนินการทางคณิตศาสตร์ ไม่ใช่นิวรอนชีวภาพหรือแนวคิดที่มีความหมายอิสระ
การส่งผ่านแบบต่อหน้าคำนวณการคาดการณ์; loss วัดความผิดพลาด; การย้อนกลับใช้กฎลูกโซ่คำนวณเกรเดียนต์; ตัวปรับค่าอัปเดตพารามิเตอร์ การเริ่มต้น, อัตราการเรียนรู้, สถิติแบช, เส้นทาง residual, และการทำ normalization มีผลต่อว่าเกรเดียนต์จะหายไป, ระเบิด, หรือยังคงมีประโยชน์ Regularization รวมถึง weight decay, dropout, การเพิ่มข้อมูล, การหยุดก่อนเวลา, และข้อจำกัดสถาปัตยกรรม การวางกราฟการฝึกและการตรวจสอบ, ตรวจสอบสถิติเกรเดียนต์และฟังก์ชันกระตุ้น, และเปรียบเทียบการรันหลายครั้ง เครือข่ายขนาดใหญ่สามารถจดจำข้อมูลฝึกได้, ในขณะที่เครือข่ายขนาดเล็กอาจเกิดการ underfit หรือพลาดโครงสร้างที่จำเป็น
การเลือกสถาปัตยกรรม, การประเมิน, และการใช้งาน
Multilayer perceptrons ประมวลผลเวกเตอร์คงที่; convolutional networks ใช้โครงสร้างท้องถิ่น; recurrent และ state‑space models ประมวลผลลำดับ; transformers ใช้ attention; graph networks แลกเปลี่ยนข้อมูลตามขอบเชื่อมต่อ การผสมผสานเป็นเรื่องปกติ เลือกตาม inductive bias, ข้อมูล, ขนาดลำดับหรือภาพ, ความหน่วง, หน่วยความจำ, ความอธิบายได้, และฮาร์ดแวร์ที่มีอยู่ ประเมินเทียบกับ baseline แบบเชิงเส้นหรือ tree และทำการ ablation เพื่อเรียนรู้ว่าความซับซ้อนใดสำคัญ จำนวนพารามิเตอร์เพียงอย่างเดียวไม่พยากรณ์คุณภาพ, ต้นทุนการสรุปผล, หรือความต้องการข้อมูล
การให้บริการต้องมีการแช่แข็งการเตรียมข้อมูล, กราฟที่ส่งออกหรือคอมไพล์, การตรวจสอบเชิงตัวเลข, และการทดสอบทรัพยากรภายใต้โหลดจริง การควบคุมขนาด (quantization) และการตัดแต่ง (pruning) สามารถลดขนาดได้แต่อาจเปลี่ยนพฤติกรรมของคลาสหายาก ตรวจสอบอินพุต, เอาต์พุต, การเทียบมาตรฐาน, ความหน่วง, และผลลัพธ์ที่ยืนยัน; ทดสอบการโจมตีแบบ adversarial และข้อมูลที่เปลี่ยนแปลง ปกป้องโมเดล, ขึ้นต่อ, และข้อมูลผ่าน artifacts ที่ลงลายมือ, การควบคุมการเข้าถึง, และการตรวจสอบซัพพลายเชน คำอธิบายจากการกระตุ้นหรือ saliency ต้องอาศัยการตรวจสอบเชิงสาเหตุและพฤติกรรม เครือข่ายประสาทเป็นตัวประมาณฟังก์ชันที่ยืดหยุ่น ไม่ได้เป็นการรับประกันความเข้าใจ, ความจริง, หรือความทนทาน
ตัวอย่างการทำงาน: ตัวพยากรณ์ความต้องการไฟฟ้าแบบประสาท
ผู้ค้าปลีกคาดการณ์ความต้องการสินค้ารายสัปดาห์จากยอดขาย, โปรโมชั่น, ราคา, วันหยุด, ความพร้อม, และสภาพอากาศ เครือข่ายถูกเปรียบเทียบกับ baseline แบบ seasonal‑naive, linear, และ tree โดยใช้การแบ่งเวลาถอยหลัง โปรโมชั่นในอนาคตจะรวมเฉพาะเมื่อทราบล่วงหน้าที่เวลา forecast, ส่วนการขาดสต็อกจะถูกโมเดลเนื่องจากยอดขายที่สังเกตอาจต่ำกว่าความต้องการ การประเมินใช้ weighted absolute error, bias, interval coverage, และผลลัพธ์ตามความเร็วของสินค้าและร้านค้า
กระบวนการให้บริการเวอร์ชันฟีเจอร์, โมเดล, และช่วงเวลาจะปฏิเสธการพยากรณ์เมื่ออินพุตที่ต้องการล้าสมัย ผู้วางแผนเห็นช่วงเวลาและสามารถแก้ไขด้วยเหตุผลที่บันทึกไว้ ระบบตรวจสอบตรวจจับฟีดที่หายไป, การเปลี่ยนแปลงของ error, bias, และพยากรณ์ที่แปลกประหลาด; ผลลัพธ์ทางธุรกิจแยกจากความแม่นยำของพยากรณ์เพราะนโยบายการสั่งซื้อก็ส่งผลต่อสินค้าคงคลัง การอัปเดตโมเดลจะทำเป็นเงาในหลายรอบ และโมเดลพยากรณ์เดิมยังคงใช้ได้สำหรับการ rollback ในช่วงฤดูกาลหรือเมื่อซัพพลายเออร์หยุดชะงัก
หลักฐานการใช้งานและความพร้อมในการดำเนินการ
การตัดสินใจในระดับผลิตต้องอาศัยมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับจูน ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของขึ้นต่อ, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการเทียบมาตรฐานหรือความไม่แน่นอน, ความหน่วง, throughput, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้กำหนดอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การ rollback, และการยกเลิก ใช้วิธี rollout แบบขั้นตอน, รักษา fallback ที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการฉีดความล้มเหลวโดยเจตนา Telemetry การดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะขึ้นต่อ, การแก้ไขโดยมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนเกินความจำเป็น กำหนดเกณฑ์การแจ้งเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงที่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษาข้อมูล, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
ทุกเครือข่ายประสาทเป็น deep learning หรือไม่?
ไม่ใช่ เครือข่ายขนาดเล็กที่มีชั้นซ่อนหนึ่งชั้นก็เป็นเครือข่ายประสาท ส่วน deep learning โดยทั่วไปหมายถึงสถาปัตยกรรมที่มีหลายขั้นตอนการประมวลผลที่เรียนรู้ได้ ขอบเขตนี้เป็นการกำหนดตามธรรมเนียม ไม่ใช่เกณฑ์วิทยาศาสตร์ที่เข้มงวด
เครือข่ายประสาทเก็บข้อมูลการฝึกของมันหรือไม่?
พวกมันเก็บพารามิเตอร์ที่เรียนรู้ไว้ ไม่ใชสำเนาข้อมูลชุดฝึกที่สามารถค้นหาได้ อย่างไรก็ตาม โมเดลขนาดใหญ่สามารถจดจำและสร้างตัวอย่างการฝึกเดี่ยวได้ ซึ่งทำให้เกิดความเสี่ยงด้านความเป็นส่วนตัวและลิขสิทธิ์ที่ต้องทดสอบ
อ้างอิงหลัก












