
พื้นฐาน AI
การทำ Gradient Descent คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Gradient descent คือวิธีการเพิ่มประสิทธิภาพที่ปรับพารามิเตอร์ของโมเดลเพื่อทำให้ฟังก์ชันเป้าหมายลดลง ในการฝึกเครือข่ายประสาทเทียม เป้าหมายนี้มักจะเป็นค่าความสูญเสียที่คำนวณจากตัวอย่างต่าง ๆ Gradient ชี้ไปในทิศทางของการเพิ่มสูงสุดในระดับท้องถิ่น ดังนั้น Gradient descent จึงก้าวไปในทิศทางตรงกันข้าม
Gradient บรรยายความไวในระดับท้องถิ่น; ขนาดของมันไม่ได้เป็นการวัดโดยตรงว่าโมเดล “เรียนรู้” อย่างเร็วแค่ไหน ความก้าวหน้าจริงยังขึ้นอยู่กับอัตราการเรียนรู้, ความโค้ง, สัญญาณรบกวน, การกำหนดพารามิเตอร์, สถานะของออพติไมเซอร์, และข้อมูล
ประเด็นสำคัญ
- Backpropagation คำนวณ Gradient, ในขณะที่ Gradient descent ใช้ Gradient เหล่านั้นเพื่ออัปเดตพารามิเตอร์
- การทำ Optimisation แบบ Mini-batch เป็นวิธีการปฏิบัติที่เป็นมาตรฐานสำหรับการเรียนรู้เชิงลึก
- อัตราการเรียนรู้ควบคุมขนาดการอัปเดตและอาจตามกำหนดการแทนที่จะลดลงหลังจากทุกขั้นตอน
- Momentum, AdamW, การคลิปและการทำ Normalization แก้ปัญหาการเพิ่มประสิทธิภาพที่แตกต่างกัน
กฎการอัปเดตพื้นฐาน
สำหรับเวกเตอร์พารามิเตอร์ θ, อัตราการเรียนรู้ η, และค่าความสูญเสีย L:
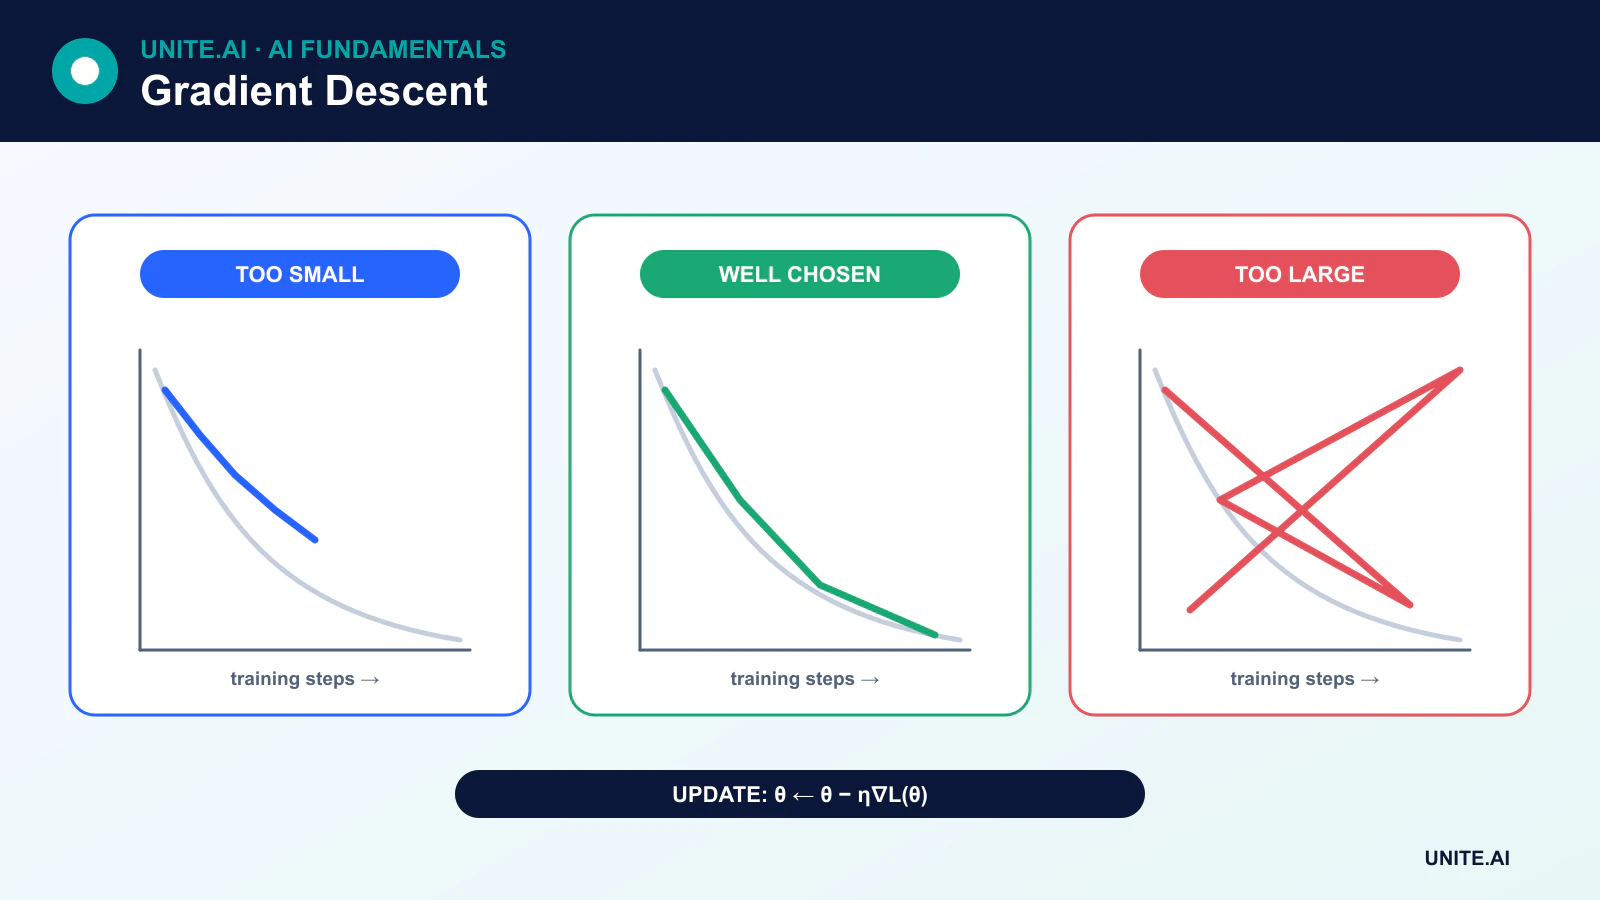
θ ← θ - η∇L(θ)
Gradient ∇L(θ) มีอนุพันธ์ย่อยหนึ่งค่าต่อพารามิเตอร์ การลบออกทำให้เคลื่อนที่ลงลงในระดับท้องถิ่น จุดคงที่มี Gradient เป็นศูนย์ แต่อาจเป็นค่าน้อยสุด, ค่าสูงสุด, จุดอาน, หรือพื้นที่แบน พื้นผิวค่าความสูญเสียของการเรียนรู้เชิงลึกเป็นแบบไม่เป็นคอนเวกซ์ ดังนั้นการฝึกไม่รับประกันว่าจะพบค่าต่ำสุดทั่วโลกที่เป็นเอกลักษณ์หรือค่าความสูญเสียศูนย์
วิธีการแบบ Batch, Stochastic, และ Mini-batch
Batch gradient descent
Batch gradient descent คำนวณ Gradient โดยใช้ชุดข้อมูลการฝึกทั้งหมดสำหรับแต่ละการอัปเดต การประมาณค่ามีความเสถียรแต่สามารถใช้เวลาและหน่วยความจำมาก และการอัปเดตหนึ่งครั้งอาจใช้ประโยชน์จากเครื่องเร่งประมวลผลสมัยใหม่ไม่เต็มที่
Stochastic gradient descent
Stochastic gradient descent อย่างเคร่งครัดใช้ตัวอย่างหนึ่งที่สุ่มเลือกสำหรับแต่ละการอัปเดต Gradient ของมันมีสัญญาณรบกวน ซึ่งอาจช่วยการสำรวจพื้นผิวค่าความสูญเสีย แต่การทำงานกับตัวอย่างเดียวอาจไม่มีประสิทธิภาพบนฮาร์ดแวร์แบบขนาน
Mini-batch gradient descent
การฝึก Mini-batch ประมาณค่า Gradient จากชุดย่อยของตัวอย่าง มันสมดุลสัญญาณรบกวนสถิติด้วยการดำเนินการเมทริกซ์ที่มีประสิทธิภาพและเป็นวิธีที่ใช้ทั่วไปใน deep learning ขนาด Batch มีผลต่อหน่วยความจำ, ปริมาณการทำงาน, สัญญาณรบกวนของ Gradient, การทำ Normalization, และบางครั้งต่อการทั่วไปของโมเดล
การเลือกอัตราการเรียนรู้
อัตราที่ใหญ่เกินไปอาจพุ่งข้ามพื้นที่ที่มีประโยชน์หรือทำให้เกิดการเบี่ยงเบน อัตราที่เล็กเกินไปอาจทำให้การฝึกช้าเกินไปหรือหยุดนิ่งในพื้นที่แบน ขนาดที่ดีที่สุดขึ้นอยู่กับออพติไมเซอร์, ขนาด Batch, โมเดล, การเริ่มต้น, และเป้าหมาย
กำหนดการสามารถอุ่นเครื่องอย่างค่อยเป็นค่อยไป, ลดลงตามจุดสำคัญ, ตามโคไซน์, หรือตอบสนองต่อความก้าวหน้าของการตรวจสอบ ความเร็วไม่จำเป็นต้องลดลงอย่างต่อเนื่องหลังจากทุกการอัปเดต การเริ่มต้นใหม่แบบอุ่นและกำหนดการแบบวงจรจะเพิ่มอัตราโดยเจตนาในช่วงของการฝึก
Momentum
Momentum รักษาค่าเฉลี่ยเคลื่อนที่แบบเอ็กซ์โปเนนเชียลของ Gradient ที่ผ่านมา มันสามารถเร่งความก้าวหน้าในทิศทางที่สม่ำเสมอและลดการสั่นในทิศทางที่ชันและแคบ Momentum แบบ Nesterov ประเมินหรือประมาณ Gradient หลังจากมองไปข้างหน้าตามทิศทางของ Momentum
ออพติไมเซอร์แบบปรับตัว
RMSProp ปรับขนาดการอัปเดตโดยใช้ค่าเฉลี่ยเคลื่อนที่ของ Gradient ที่ยกกำลังสอง Adam ผสานโมเมนต์แรกที่คล้าย Momentum กับการสเกลโมเมนต์ที่สอง AdamW แยกการสลายน้ำหนักออกจากการอัปเดต Gradient แบบปรับตัวและถูกใช้กันอย่างแพร่หลายสำหรับ Transformers
ออพติไมเซอร์แบบปรับตัวมักทำให้การฝึกในช่วงแรกง่ายขึ้น แต่ไม่ได้หมายความว่าจะเหนือกว่าโดยอัตโนมัติสำหรับทุกโมเดลหรือเป้าหมายการทั่วไปสุดท้าย การเปรียบเทียบออพติไมเซอร์ต้องใช้กำหนดการที่ตรงกันและการปรับจูนอย่างระมัดระวัง
การคลิปและการสะสม Gradient
การคลิป Gradient จำกัดนอร์มหรือค่าของ Gradient เพื่อลดผลกระทบของ Gradient ที่ระเบิดโดยเฉพาะในการฝึกแบบ Recurrent หรือที่ไม่เสถียร การสะสม Gradient จะรวม Gradient จากหลาย Batch ขนาดเล็กก่อนการอัปเดต ทำให้ได้ Batch ที่มีประสิทธิภาพใหญ่ขึ้นเมื่อหน่วยความจำจำกัด
การตรวจสอบการเพิ่มประสิทธิภาพ
ติดตามค่าความสูญเสียของการฝึกและการตรวจสอบ, ตัวชี้วัดงาน, อัตราการเรียนรู้, นอร์มของ Gradient, นอร์มของพารามิเตอร์, และข้อผิดพลาดเชิงตัวเลข ค่าความสูญเสียการฝึกที่ลดลงพร้อมกับประสิทธิภาพการตรวจสอบที่แย่ลงบ่งชี้ถึง overfitting, ไม่ใช่ความสำเร็จของการเพิ่มประสิทธิภาพที่ควรดำเนินต่อโดยอัตโนมัติ
การเพิ่มประสิทธิภาพทำให้ค่าตามเป้าหมายที่กำหนดลดลง ค่าความสูญเสียต่ำไม่ได้พิสูจน์ว่าข้อมูล, ตัวชี้วัด, หรือพฤติกรรมในโลกจริงเหมาะสม การรั่วไหล, ป้ายกำกับที่แย่, และเป้าหมายที่ไม่สอดคล้องอาจทำให้ได้โมเดลที่เพิ่มประสิทธิภาพดีแต่เป็นอันตราย
เรขาคณิตของการเพิ่มประสิทธิภาพและกฎการอัปเดต
Gradient descent ปรับพารามิเตอร์ในทิศทางตรงกันข้ามกับ Gradient ของค่าความสูญเสีย Full-batch descent ใช้ทุกตัวอย่างการฝึกต่อขั้นตอน; stochastic descent ใช้หนึ่งตัวอย่าง; วิธี Mini-batch ประมาณค่า Gradient จากชุดย่อยและเป็นวิธีหลักใน deep learning อัตราการเรียนรู้กำหนดขนาดขั้นตอน ขนาดเล็กเกินไปทำให้เสียการคำนวณหรือหยุดนิ่ง; ขนาดใหญ่เกินไปทำให้สั่นหรือเบี่ยงเบน Momentum สะสมทิศทางเคลื่อนที่, ในขณะที่วิธีปรับตัวเช่น Adam ปรับสเกลพิกัดโดยใช้โมเมนต์ของ Gradient ความลำเอียงโดยนัยที่แตกต่างกันของพวกมันอาจทำให้ได้โมเดลที่มีค่าความสูญเสียการฝึกคล้ายกันแต่การทั่วไปต่างกัน
พื้นผิวค่าความสูญเสียในเครือข่ายประสาทมีพื้นที่แบนและคม, จุดอาน, ความสมมาตร, และทิศทางที่มีสภาพไม่ดี การสเกลฟีเจอร์, การทำ Normalization, การเริ่มต้น, การเชื่อมต่อ Residual, และการปรับสภาพล่วงหน้าปรับเปลี่ยนเรขาคณิตที่ออพติไมเซอร์เห็น กำหนดการสามารถอุ่นเครื่อง, ลดลง, วงจร, หรือตอบสนองต่อที่ราบเรียบ Weight decay แตกต่างจากการเพิ่มโทษ L2 เพียงอย่างเดียวในออพติไมเซอร์บางตัว ขนาด Batch มีผลต่อสัญญาณรบกวน, หน่วยความจำ, ความขนาน, และระยะอัตราการเรียนรู้ ดังนั้นการเปรียบเทียบออพติไมเซอร์ต้องใช้งบประมาณการฝึกที่ตรงกันและการปรับจูนอย่างระมัดระวัง
การวินิจฉัย, ความสามารถทำซ้ำ, และการหยุด
ติดตามค่าความสูญเสียของการฝึกและการตรวจสอบ, ตัวชี้วัดงาน, นอร์มของ Gradient และพารามิเตอร์, อัตราการเรียนรู้, ปริมาณการทำงาน, และคำเตือนเชิงตัวเลข การเบี่ยงเบนอาจมาจาก Batch ที่เสียหาย, ป้ายกำกับไม่ถูกต้อง, ความแม่นยำผสมที่ไม่เสถียร, หรือการลดค่าความสูญเสียที่ผิดพลาด ที่ราบเรียบอาจบ่งชี้ถึงความจุไม่พอ, การกระตุ้นที่อิ่มตัว, ฟีเจอร์ที่แย่, การทำ Regularization มากเกินไป, หรือปัญหากำหนดการ Overfitting ต้องการข้อมูล, การเพิ่มข้อมูล, การทำ Regularization, หรือการหยุดก่อนเวลา ไม่ใช่การอ้างว่าออพติไมเซอร์ล้มเหลว ตรวจสอบข้อผิดพลาดที่เป็นตัวอย่างและเปรียบเทียบฐานเส้นง่ายก่อนเพิ่มความซับซ้อนของการฝึก
ความสามารถทำซ้ำต้องอาศัย seed, ลำดับข้อมูล, โค้ด, การตั้งค่า, เวอร์ชันของฮาร์ดแวร์และไลบรารี แม้บางเคอร์เนลของเครื่องเร่งจะยังคงไม่กำหนดได้ บันทึก checkpoint พร้อมสถานะของออพติไมเซอร์และ scheduler เพื่อให้การฝึกสามารถดำเนินต่อได้อย่างสม่ำเสมอ เลือก checkpoint ตามเกณฑ์การตรวจสอบที่กำหนดล่วงหน้าและสำรองชุดทดสอบที่ยังไม่ถูกใช้ ในการฝึกแบบกระจายยืนยันขนาด Batch ที่มีประสิทธิภาพ, การเฉลี่ย Gradient, และการจัดการกับ worker ที่ล้มเหลว การเพิ่มประสิทธิภาพทำให้ค่าตามเป้าหมายที่เลือกบนข้อมูลที่มีลดลง; แต่มันไม่ได้รับประกันความเป็นไปได้ที่ปรับเทียบ, การให้เหตุผลเชิงสาเหตุ, ความเป็นธรรม, ความปลอดภัย, หรือประโยชน์ในโลกจริง
ตัวอย่างทำงาน: การปรับจูนออพติไมเซอร์สำหรับโมเดลภาษา
ทีมกำหนด tokenizer, ลำดับข้อมูล, โมเดล, batch ที่มีประสิทธิภาพ, และงบประมาณ token สำหรับการฝึก, จากนั้นเปรียบเทียบ SGD พร้อม Momentum และ AdamW ตามกำหนดการอัตราการเรียนรู้ที่มีเหตุผล การอุ่นเครื่อง, การลดลง, การสลายน้ำหนัก, การคลิป, และความแม่นยำถูกบันทึก แต่ละตัวเลือกทำงานหลาย seed, และการตรวจสอบใช้ช่วงเวลาที่แยกออกพร้อมการประเมินงาน ปริมาณการทำงานและพลังงานถูกรายงานพร้อมกับค่าความสูญเสียเพื่อไม่ให้เลือกออพติไมเซอร์ที่ดีกว่าเล็กน้อยโดยมีค่าใช้จ่ายที่ไม่สมเหตุสมผล
การวินิจฉัยเปิดเผยว่าความไม่เสถียรมาจาก shard ของข้อมูลหนึ่ง, ขนาดขั้นตอนที่มากเกินไป, การไหลต่ำ, หรือสถาปัตยกรรมของโมเดลหรือไม่. Checkpoint รักษาสถานะของออพติไมเซอร์และ scheduler และถูกดำเนินต่อในชุดทดสอบ การเลือกขั้นสุดท้ายอิงตามคุณภาพและความทนทานของการตรวจสอบ ไม่ใช่ค่าความสูญเสียการฝึกที่ต่ำที่สุด ชุดทดสอบที่ปิดไว้จะทำครั้งเดียวหลังการเลือก การสรุปผลการผลิตจะถูกปรับเทียบและตรวจสอบแยกต่างหาก เพราะความสำเร็จของออพติไมเซอร์ในระหว่างการฝึกล่วงหน้าไม่ได้ทำให้พฤติกรรมปลอดภัยหรือเป็นความจริง
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดประเมินที่มีเวอร์ชันก่อนการปรับจูน ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงทุกขั้นตอนและเกณฑ์เพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนการเปิดใช้งาน กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยุติ ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการฉีดความล้มเหลวโดยเจตนา Telemetry การปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสมมติว่าประสิทธิภาพแบบออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดใช้งานหรือแทนที่
คำถามที่พบบ่อย
Gradient descent จะถึงค่าน้อยสุดทั่วโลกเสมอหรือไม่?
ไม่. สำหรับวัตถุประสงค์แบบคอนเวกซ์ เงื่อนไขที่เหมาะสมให้การรับประกันที่แข็งแรง วัตถุประสงค์ของเครือข่ายลึกเป็นแบบไม่คอนเวกซ์ และออพติไมเซอร์ในทางปฏิบัตมักมองหาโซลูชันที่มีประโยชน์แทนที่จะพิสูจน์ว่าพบค่าน้อยสุดทั่วโลกที่เป็นเอกลักษณ์
ทำไม Gradient ศูนย์จึงอาจทำให้เข้าใจผิด?
Gradient ศูนย์หรือเล็กมากอาจบ่งชี้ถึงค่าน้อยสุด, ค่าสูงสุด, จุดอาน, การอิ่มตัว, หรือที่ราบเรียบ แก้ไขการฝึกต้องพิจารณาประวัติความสูญเสีย, ความโค้ง, ขนาดพารามิเตอร์, และประสิทธิภาพการตรวจสอบ
แหล่งอ้างอิงหลัก












