พื้นฐาน AI
การโอเวอร์ฟิตคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
โอเวอร์ฟิต เกิดขึ้นเมื่อโมเดลจับรูปแบบหรือสัญญาณรบกวนที่ทำงานได้ดีเกินไปบนข้อมูลฝึกฝน แต่ไม่สามารถทั่วไปไปยังตัวอย่างใหม่ได้ โมเดลที่โอเวอร์ฟิตอาจมีข้อผิดพลาดในการฝึกต่ำมากในขณะที่ประสิทธิภาพในการตรวจสอบหรือในโลกจริงแย่ลงอย่างมาก
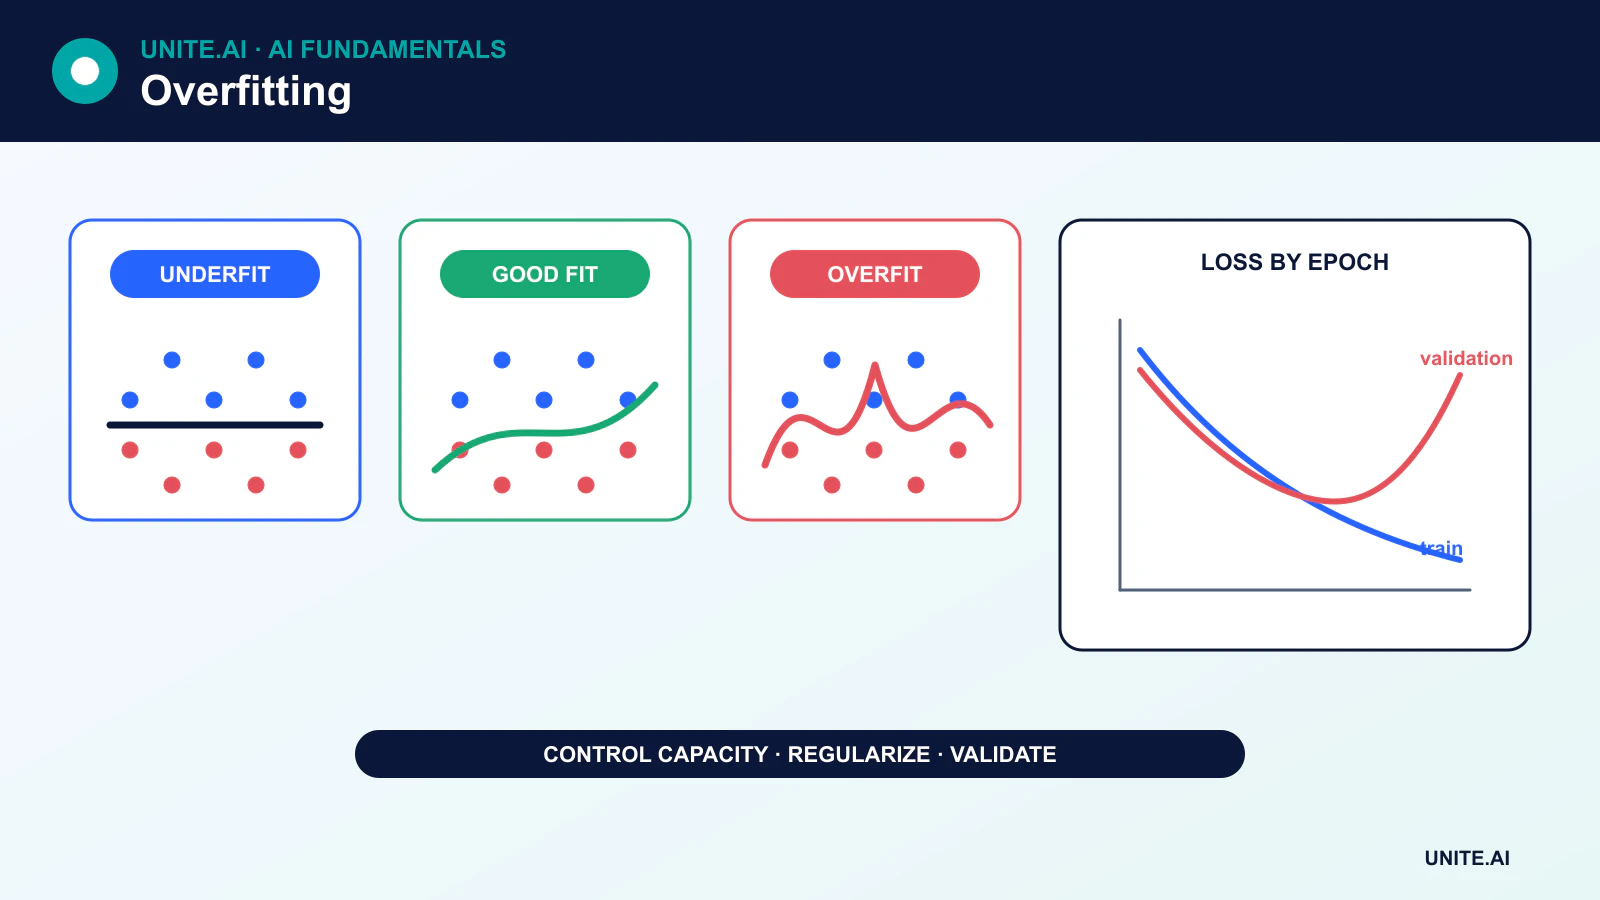
ปัญหาตรงข้ามคือ อันเดอร์ฟิต: โมเดลหรือกระบวนการฝึกไม่สามารถจับสัญญาณได้เพียงพอแม้บนชุดฝึก การสร้างโมเดลที่ดีต้องสมดุลระหว่างการฟิตและการทั่วไป แทนที่จะไล่ตามประสิทธิภาพการฝึกที่สมบูรณ์แบบ
ประเด็นสำคัญ
- ประสิทธิภาพการฝึกเพียงอย่างเดียวไม่สามารถวินิจฉัยการทั่วไปได้.
- การหยุดก่อนควรอิงพฤติกรรมการตรวจสอบ ไม่ควรทำการตัดสินใจซ้ำบนชุดทดสอบสุดท้าย.
- ข้อมูลเพิ่มสามารถช่วยได้ แต่ฟีเจอร์หรือความจุที่เพิ่มขึ้นอาจทำให้โอเวอร์ฟิตแย่ลงเช่นกัน.
- การทำเรกูลาไรเซชัน, การเพิ่มข้อมูล, การทำครอสวาลิเดชัน, การป้องกันการรั่วไหล, และการประเมินที่เหมาะสมจัดการกับสาเหตุที่แตกต่างกัน.
การฟิต, การอันเดอร์ฟิต, และการโอเวอร์ฟิต
โมเดลอันเดอร์ฟิตเมื่อสมมติฐานของมันเข้มงวดเกินไป, ฟีเจอร์ละเลยสัญญาณสำคัญ, การเพิ่มประสิทธิภาพไม่เพียงพอ, หรือการฝึกไม่เพียงพอ การเพิ่มฟีเจอร์หรือความจุที่เกี่ยวข้องอาจช่วยได้ แต่การเพิ่มฟีเจอร์โดยไม่มีเหตุผลอาจเพิ่มสัญญาณรบกวนและทำให้เกิดโอเวอร์ฟิต
โมเดลโอเวอร์ฟิตเมื่อความจุที่มีประสิทธิภาพสูงเกินกว่าข้อมูลในชุดฝึก ตัวอย่างเช่น ต้นไม้ตัดสินใจ ที่ลึกซึ่งสร้างใบไม้ขนาดเล็ก, พหุนามที่ตามการเปลี่ยนแปลงแบบสุ่ม, หรือเครือข่ายประสาทเทียมที่จดจำตัวอย่าง
บทบาทของข้อมูลฝึก, การตรวจสอบ, และการทดสอบ
- ข้อมูลฝึก ปรับพารามิเตอร์ของโมเดล.
- ข้อมูลตรวจสอบ เลือกสถาปัตยกรรม, ไฮเปอร์พารามิเตอร์, เกณฑ์, และเวลาการหยุด.
- ข้อมูลทดสอบ ให้การประมาณค่าขั้นสุดท้ายหลังจากการเลือกทั้งหมดเสร็จสิ้น.
หากชุดทดสอบถูกใช้เป็นแนวทางการตัดสินใจซ้ำ ๆ มันจะกลายเป็นส่วนหนึ่งของกระบวนการพัฒนาและไม่สามารถให้การประมาณค่าที่ไม่ลำเอียงได้อีกต่อไป การทำครอสวาลิเดชันสามารถใช้ข้อมูลที่จำกัดได้อย่างมีประสิทธิภาพมากขึ้น แต่การทำพรีโพรเซสและการเลือกฟีเจอร์ต้องทำภายในแต่ละโฟลด์ของการฝึก
การหยุดก่อน
ระหว่างการฝึก, ค่าความสูญเสียของการฝึกมักจะลดลงต่อเนื่อง ค่าความสูญเสียของการตรวจสอบอาจลดลงในตอนแรกแล้วเพิ่มขึ้นในภายหลังเมื่อโมเดลเริ่มเชี่ยวชาญกับสัญญาณรบกวนของการฝึก การหยุดก่อนจะบันทึกเช็คพอยท์ที่มีวัตถุประสงค์การตรวจสอบที่ดีที่สุดหรือหยุดเมื่อการตรวจสอบไม่พัฒนาขึ้นเป็นระยะเวลาที่กำหนด
เช็คพอยท์ที่ถูกต้องไม่ใช่ที่มีค่าความสูญเสียการฝึกต่ำที่สุด แต่เป็นชุดทดสอบสุดท้ายที่แยกออกมาซึ่งจะประเมินหลังจากการหยุดก่อนและการตัดสินใจปรับแต่งเสร็จสิ้น
วิธีการทำเรกูลาไรเซชัน
การลงโทษน้ำหนัก
การทำเรกูลาไรเซชันแบบ L2 หรือการสลายน้ำหนักช่วยลดค่าพารามิเตอร์ที่ใหญ่เกินไป การทำเรกูลาไรเซชันแบบ L1 สามารถส่งเสริมค่าสัมประสิทธิ์ที่กระจายเป็นสแปร์ ผลของมันขึ้นอยู่กับโมเดลและออพติมไลเซอร์; ตัวอย่างเช่น AdamW แยกการสลายน้ำหนักออกจากการอัปเดตแบบปรับตัว
ดรอปเอาท์และการทำเรกูลาไรเซชันแบบสโตคาสติก
ดรอปเอาท์ทำการปิดบังการกระตุ้นแบบสุ่มระหว่างการฝึก วิธีอื่น ๆ เช่น การตัดเส้นทาง, การรบกวนฟีเจอร์, หรือการทำให้ป้ายกำกับเรียบเนียน เทคนิคเหล่านี้เปลี่ยนวัตถุประสงค์การฝึกและต้องถูกปิดใช้งานหรือจัดการอย่างเหมาะสมในขั้นตอนการสรุปผล
การเพิ่มข้อมูล
การเพิ่มข้อมูลสร้างความหลากหลายที่สมจริง เช่น การตัด, การหมุน, สัญญาณรบกวน, หรือการพาราเฟรส ซึ่งควรคงไว้ซึ่งเป้าหมาย การแปลงที่ไม่ถูกต้องอาจเปลี่ยนป้ายกำกับและทำร้ายโมเดล สำหรับงานคอมพิวเตอร์วิชัน เครื่องมืออย่าง Albumentations ช่วยในการสร้างไพป์ไลน์ที่ควบคุมได้
การควบคุมความจุ
ต้นไม้ที่ตื้นกว่า, พารามิเตอร์น้อยลง, การเลือกฟีเจอร์, การตัดแต่ง, และคลาสสมมติฐานที่ง่ายกว่า สามารถลดความแปรปรวนได้ การตัดแต่งต้นไม้ทำตามเกณฑ์ ไม่ใช่การลบรายละเอียดที่เรียนรู้แบบสุ่ม
การรั่วไหลของข้อมูลอาจดูเหมือนประสิทธิภาพที่ยอดเยี่ยม
การรั่วไหลเกิดขึ้นเมื่อข้อมูลที่ไม่สามารถใช้ได้ในขณะทำการพยากรณ์เข้ามาในขั้นตอนการฝึกหรือการประเมิน ตัวอย่างทั่วไปรวมถึงการทำการปรับสเกลบนชุดข้อมูลทั้งหมด, การแบ่งบันทึกที่ซ้ำกันข้ามโฟลด์, การใช้ข้อมูลในอนาคตเพื่อทำนายอดีต, หรือการรวมฟีเจอร์ที่ได้มาจากเป้าหมาย
การรั่วไหลไม่ใช่การโอเวอร์ฟิตทั่วไป แต่สร้างช่องว่างที่ทำให้เข้าใจผิดระหว่างผลลัพธ์ออฟไลน์และการใช้งานจริง กลยุทธ์การแบ่งข้อมูลควรคำนึงถึงเวลา, ตัวตน, สถานที่, และกระบวนการสร้างข้อมูล
การเปลี่ยนแปลงการกระจายเป็นปัญหาแยกต่างหาก
โมเดลอาจทั่วไปต่อการกระจายของชุดทดสอบได้แต่ยังล้มเหลวเมื่อข้อมูลการผลิตเปลี่ยนแปลง อุปกรณ์ใหม่, นโยบาย, ประชากร, ฤดูกาล, หรือพฤติกรรมแบบกดดันอาจทำให้ความสัมพันธ์ระหว่างอินพุตและเป้าหมายเปลี่ยนไป การเฝ้าติดตามและการประเมินผลเป็นระยะจำเป็นแม้ว่าโมเดลต้นฉบับจะไม่โอเวอร์ฟิต
การวินิจฉัยโอเวอร์ฟิต
ใช้เส้นโค้งการเรียนรู้, ความแปรปรวนของครอสวาลิเดชัน, เมตริกกลุ่มย่อย, การสอบเทียบ, และการตรวจสอบข้อผิดพลาด หากประสิทธิภาพการฝึกและการตรวจสอบทั้งสองแย่ ให้มุ่งเน้นที่อันเดอร์ฟิต, ฟีเจอร์, ป้ายกำกับ, หรือการเพิ่มประสิทธิภาพ หากการฝึกแข็งแรงแต่การตรวจสอบอ่อนลง ให้ตรวจสอบความจุ, การรั่วไหล, การทำเรกูลาไรเซชัน, และความเป็นตัวแทนก่อนที่จะเก็บข้อมูลเพิ่ม
ทำไมโอเวอร์ฟิตจึงเกิดขึ้นและจะตรวจจับได้อย่างไร
โอเวอร์ฟิตเกิดขึ้นเมื่อโมเดลเรียนรู้รูปแบบที่ลดข้อผิดพลาดในการฝึกแต่ไม่สามารถทั่วไปต่อประชากรเป้าหมาย สาเหตุรวมถึงความจุที่มากเกินไปเมื่อเทียบกับข้อมูลที่มีประสิทธิภาพ, สัญญาณรบกวนของป้ายกำกับ, เอนทิตีที่ซ้ำกัน, การเลือกฟีเจอร์ที่ยืดหยุ่น, การรั่วไหล, และการปรับจูนกับชุดตรวจสอบเดียวกัน ช่องว่างที่ขยายขึ้นระหว่างประสิทธิภาพการฝึกและการตรวจสอบเป็นหลักฐานทั่วไป แต่ช่องว่างเล็ก ๆ ไม่ได้ปฏิเสธการโอเวอร์ฟิตหากทั้งสองชุดมีการปนเปื้อนหรือแตกต่างจากการใช้งานจริง เส้นโค้งการเรียนรู้ตามปริมาณข้อมูลและความจุช่วยแยกความแปรปรวนจากอคติ
การรั่วไหลเป็นเรื่องหลอกลวงเป็นพิเศษ: ข้อมูลในอนาคต, รายการซ้ำ, การทับซ้อนของหัวข้อ, การทำพรีโพรเซสบนข้อมูลทั้งหมด, หรือป้ายกำกับที่เข้ารหัสในเมทาดาต้าสามารถให้คะแนนที่ดีมากบนข้อมูลที่แยกออกได้ แบ่งตามหน่วยที่จะเป็นใหม่เมื่อใช้งานจริง—ผู้ป่วย, ลูกค้า, เครื่องจักร, สถานที่, หรือเวลา—ก่อนทำการแปลงหรือเพิ่มข้อมูล เก็บชุดทดสอบสุดท้ายให้ปิดไว้ขณะเลือกฟีเจอร์, สถาปัตยกรรม, และเกณฑ์ หากทีมตรวจสอบผลทดสอบซ้ำ ๆ ชุดทดสอบจะกลายเป็นชุดตรวจสอบอีกชุดหนึ่งและต้องการการเปลี่ยนหรือการแก้ไขอย่างเป็นทางการ
การทำเรกูลาไรเซชัน, การเลือกโมเดล, และการเปลี่ยนแปลงในการผลิต
ลดโอเวอร์ฟิตด้วยข้อมูลที่เป็นตัวแทนมากขึ้น, ความจุต่ำลง, การสลายน้ำหนัก, ดรอปเอาท์, การหยุดก่อน, การเพิ่มข้อมูล, การรวมหลายโมเดล, หรือข้อจำกัดที่สะท้อนโครงสร้างโดเมน แต่ละวิธีมีข้อแลกเปลี่ยน: การเพิ่มข้อมูลอาจบิดเบือนป้ายกำกับ, ดรอปเอาท์เปลี่ยนการเพิ่มประสิทธิภาพ, และการรวมหลายโมเดลเพิ่มค่าใช้จ่ายในการให้บริการ การทำครอสวาลิเดชันประมาณความแปรผันของการเลือก, แต่โฟลด์แบบกลุ่มหรือคำนึงถึงเวลาต้องรักษาขอบเขตการใช้งานจริง เปรียบเทียบกับโมเดลง่ายและรายงานความไม่แน่นอนผ่านโฟลด์หรือเมล็ดพันธุ์แทนการเลือกรันที่ดีที่สุด
การผลิตอาจเปิดเผยรูปแบบการล้มเหลวของการทั่วไปที่แตกต่างเมื่ออินพุต, ผู้ใช้, สิ่งจูงใจ, หรือการวัดผลเปลี่ยนแปลง เฝ้าติดตามการกระจายของฟีเจอร์และการทำนาย, การสอบเทียบ, ผลลัพธ์ของกลุ่มย่อย, และความจริงพื้นฐานที่ล่าช้า อย่าฝึกใหม่โดยอัตโนมัติจากฟีดแบ็กที่ไม่ได้ตรวจสอบ; การตัดสินใจของโมเดลเองอาจกำหนดป้ายกำกับที่โมเดลจะเห็นในภายหลัง วินิจฉัยว่าความล้มเหลวมาจากการเปลี่ยนแปลง, ท่อข้อมูล, การเปลี่ยนนโยบาย, หรือเป้าหมายที่ไม่ถูกต้อง โอเวอร์ฟิตถูกควบคุมโดยการออกแบบการทดลองและระเบียบวัฏจักรชีวิต ไม่ใช่การตั้งค่าเรกูลาไรเซชันเดียว
ตัวอย่างทำงาน: การกำจัดการรั่วไหลในโมเดลการฉ้อโกง
ตัวจำแนกการฉ้อโกงเริ่มต้นให้คะแนนสูงมากเนื่องจากเหตุการณ์บัตรและผู้ค้าแบบซ้ำปรากฏในแถวการฝึกและทดสอบแบบสุ่ม, และข้อมูลการเรียกคืนที่บันทึกหลายสัปดาห์ต่อมาถูกใช้เป็นฟีเจอร์ ทีมงานทำการสร้างเวลาที่ฟีเจอร์แต่ละตัวพร้อมใช้งานใหม่, ลบฟิลด์หลังการตัดสินใจ, จัดกลุ่มตามบัญชี, และใช้การแบ่งตามเวลาแบบต่อหน้า ผลการทำงานลดลงอย่างชัดเจนแต่ตอนนี้ประมาณการการตัดสินใจจริงได้ มีฐานกฎง่ายและเส้นโค้งการเรียนรู้ช่วยกำหนดความซับซ้อนของโมเดลที่ต้องการ
การทำเรกูลาไรเซชันและการหยุดก่อนถูกปรับแต่งเฉพาะภายในโฟลด์ประวัติ การประเมินสุดท้ายรายงานความแม่นยำที่ระดับความจุการตรวจสอบ, การเรียกคืน, การสอบเทียบ, และต้นทุนตามประเภทการฉ้อโกงและกลุ่มลูกค้า ในการผลิต ป้ายกำกับที่ยืนยันมาถึงล่าช้าและมีอคติจากธุรกรรมที่ได้รับการตรวจสอบ ดังนั้นการเฝ้าติดตามจะแยกการเปลี่ยนแปลงคะแนนจากการประมาณผลลัพธ์ การฝึกใหม่ใช้กรณีที่ตัดสินแล้วและทำการเล่นซ้ำตามนโยบายปัจจุบัน โครงการเลือกคะแนนที่ซื่อสัตย์ต่ำกว่าแทนคะแนนสูงที่รั่วไหลซึ่งไม่สามารถอยู่รอดในการใช้งานจริงได้
หลักฐานการนำไปใช้และความพร้อมในการดำเนินงาน
การตัดสินใจในขั้นตอนการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การขัดข้องของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการสอบเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการประมวลผล, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา เทเลเมทรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบต่อการตอบสนอง จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
โมเดลง่าย ๆ สามารถโอเวอร์ฟิตได้หรือไม่?
ได้. การเลือกฟีเจอร์ซ้ำ, การปรับเกณฑ์, หรือการประเมินบนชุดข้อมูลที่ถือเป็นการแยกเดียวกันสามารถทำให้กระบวนการพัฒนาโอเวอร์ฟิตได้แม้ว่าโมเดลสุดท้ายจะเรียบง่าย
ข้อมูลการฝึกเพิ่มขึ้นเสมอจะแก้ปัญหาโอเวอร์ฟิตได้หรือไม่?
ไม่. ข้อมูลที่เป็นตัวแทนและมีป้ายกำกับที่ถูกต้องสามารถช่วยได้, แต่ข้อมูลที่ซ้ำ, มีอคติ, รั่วไหล, หรืออยู่นอกโดเมนอาจไม่ช่วย. วัตถุประสงค์การเรียนรู้และการออกแบบการประเมินยังคงมีความสำคัญ
อ้างอิงหลัก