
พื้นฐาน AI
แบคโพรพาเกชันคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Backpropagation คืออัลกอริทึมที่ใช้คำนวณว่าการสูญเสียของ เครือข่ายประสาทเทียม เปลี่ยนแปลงอย่างไรตามพารามิเตอร์ที่สามารถฝึกได้. มันใช้กฎลูกโซ่ของแคลคูลัสย้อนกลับผ่านการดำเนินการที่บันทึกระหว่างการส่งต่อไปข้างหน้า.
Backpropagation คำนวณเกรเดียนท์; แต่โดยตัวมันเองไม่ได้กำหนดการอัปเดต. ตัวเพิ่มประสิทธิภาพเช่น stochastic gradient descent หรือ AdamW ใช้เกรเดียนท์เหล่านั้นเพื่อปรับน้ำหนัก, ไบอัส, และพารามิเตอร์ที่สามารถฝึกได้อื่น ๆ.
ประเด็นสำคัญ
- การส่งต่อไปข้างหน้าสร้างค่ากลางและให้ผลการทำนาย.
- ฟังก์ชันสูญเสียแปลงผลการทำนายและเป้าหมายให้เป็นวัตถุประสงค์การฝึกแบบสเกลาร์.
- Backpropagation ใช้อนุพันธ์ท้องถิ่นและกฎลูกโซ่เพื่อคำนวณเกรเดียนท์ของพารามิเตอร์อย่างมีประสิทธิภาพ.
- เฟรมเวิร์กสมัยใหม่ดำเนินการแยกความแตกต่างอัตโนมัติแบบย้อนกลับบนกราฟการคำนวณ.
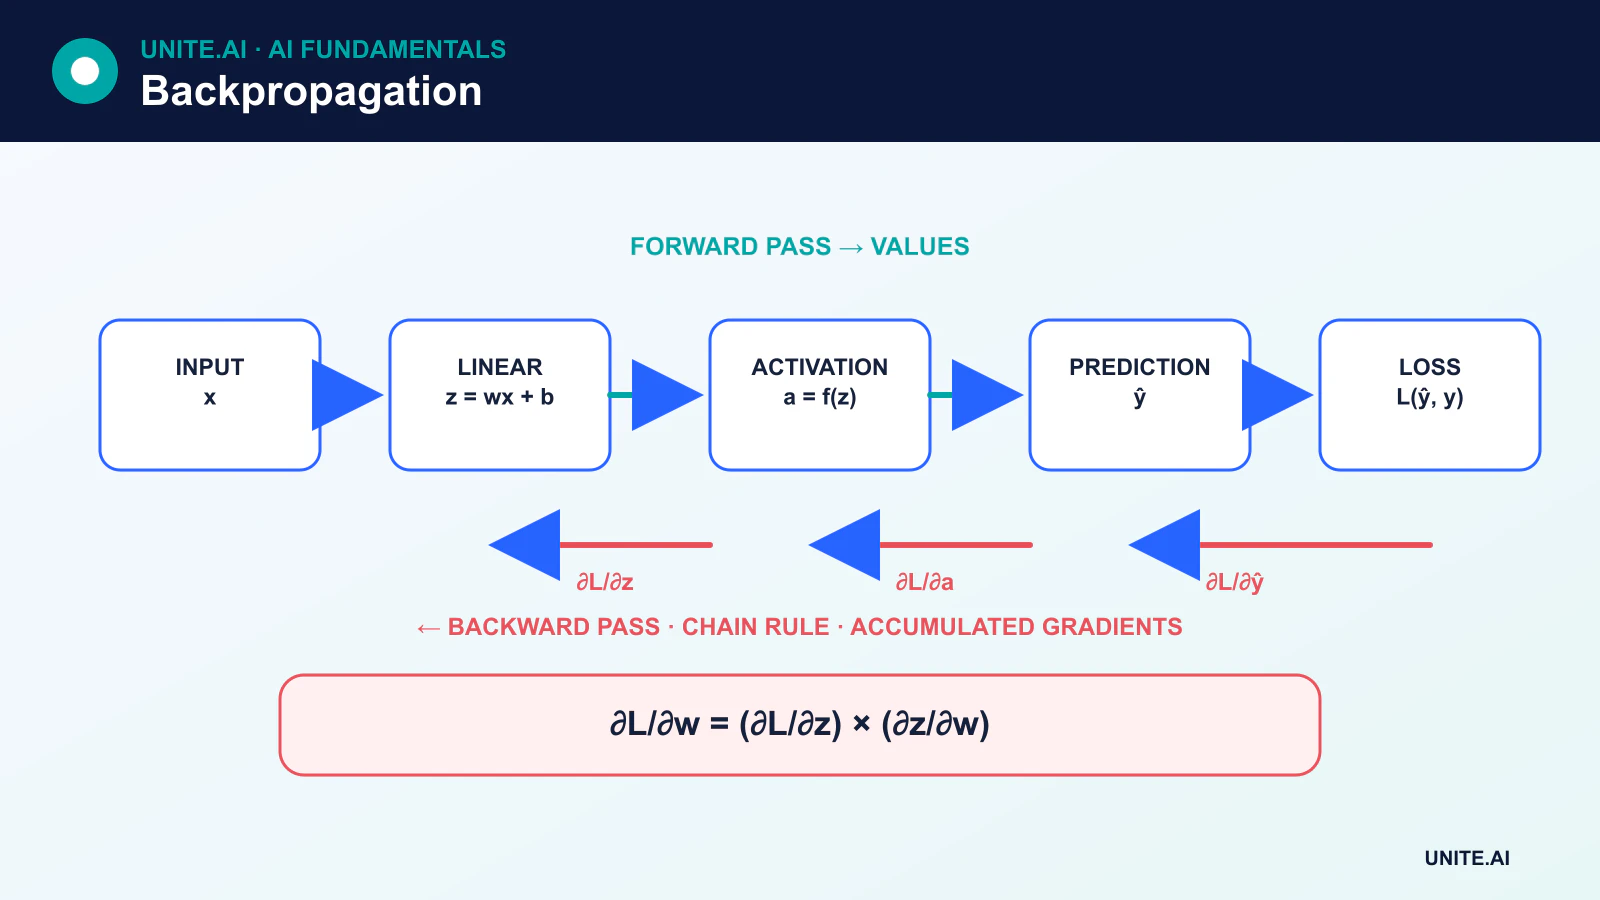
การส่งต่อไปข้างหน้า
พิจารณาหน่วยง่าย ๆ:
z = wx + bŷ = activation(z)
อินพุตคือ x ในขณะที่ w และ b เป็นพารามิเตอร์น้ำหนักและไบอัสที่สามารถฝึกได้. ไบอัสมักจะเปลี่ยนแปลงระหว่างการฝึกเช่นเดียวกับน้ำหนัก. เครือข่ายรวมหลายการดำเนินการเช่นนี้ พร้อมด้วยการทำ normalization, attention, convolution, การเชื่อมต่อแบบ residual หรือบล็อกที่สามารถหาอนุพันธ์ได้อื่น ๆ.
การส่งต่อไปข้างหน้าจะประเมินการดำเนินการเหล่านั้นและให้ผลการทำนาย. การสูญเสียเช่น cross-entropy หรือ mean squared error ใช้วัดวัตถุประสงค์. การสูญเสียที่เหมาะสมที่สุดขึ้นอยู่กับงานและการตีความผลลัพธ์.
กฎลูกโซ่
หากการสูญเสีย L ขึ้นอยู่กับค่ากลาง z, และ z ขึ้นอยู่กับพารามิเตอร์ w, กฎลูกโซ่ให้ว่า:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
เครือข่ายเชิงลึกมีหลายเส้นทาง. Backpropagation เดินกราฟการคำนวณย้อนกลับ, สะสมส่วนร่วมเมื่อค่าหนึ่งมีผลต่อการสูญเสียผ่านหลายเส้นทาง. ผลลัพธ์คือเกรเดียนท์สำหรับทุกพารามิเตอร์ที่สามารถฝึกได้ที่มีส่วนร่วมในการคำนวณแบบส่งต่อไปข้างหน้า.
ตัวอย่างเชิงตัวเลขขนาดเล็ก
สมมติ ŷ = wx + b, โดยที่ x = 2, w = 3, และ b = 1. การทำนายคือ 7. หากเป้าหมายคือ 5 และการสูญเสียคือ L = ½(ŷ – y)², แล้ว:
- ∂L/∂ŷ = ŷ – y = 2
- ∂ŷ/∂w = x = 2
- ∂L/∂w = 2 × 2 = 4
- ∂L/∂b = 2 × 1 = 2
ตัวเพิ่มประสิทธิภาพจึงสามารถย้าย w และ b ไปในทิศทางลบของเกรเดียนท์ได้. สูตรนี้เป็นสูตรเฉพาะสำหรับหน่วยเชิงเส้นที่เลือกและการสูญเสียแบบกำลังสอง; กฎแบคโพรพาเกชันสากลคือกฎลูกโซ่บนกราฟจริง, ไม่ใช่สมการ “ข้อผิดพลาด” ที่กำหนดไว้หนึ่งเดียว.
แบคโพรพาเกชันเทียบกับการลงเกรเดียนท์
Gradient descent คือวิธีการเพิ่มประสิทธิภาพ. Backpropagation ให้เกรเดียนท์ที่จำเป็น. ขั้นตอนการฝึกมักจะเป็นดังนี้:
- ล้างหรือรีเซ็ตเกรเดียนท์ที่เก็บไว้.
- รันการส่งต่อไปข้างหน้า.
- คำนวณการสูญเสีย.
- รันการส่งกลับ.
- นำการอัปเดตของตัวเพิ่มประสิทธิภาพไปใช้.
การแยกแนวคิดเหล่านี้ทำให้เข้าใจ momentum, AdamW, การสะสมเกรเดียนท์, และการฝึกแบบความแม่นยำผสมได้ง่ายขึ้น.
การแยกความแตกต่างอัตโนมัติ
เฟรมเวิร์กเช่น PyTorch บันทึกการดำเนินการและสร้างกราฟระหว่างการส่งต่อไปข้างหน้า. การแยกความแตกต่างอัตโนมัติแบบย้อนกลับจึงคำนวณผลคูณเวกเตอร์-จาคอเบียนอย่างมีประสิทธิภาพจากผลลัพธ์กลับไปยังพารามิเตอร์. วิธีนี้ทั่วไปกว่าการเขียนโค้ดอนุพันธ์ด้วยตนเองสำหรับเครือข่ายคงที่และเป็นพื้นฐานของเฟรมเวิร์ก deep learning สมัยใหม่.
บางการดำเนินการไม่สามารถหาอนุพันธ์ได้หรือมีอนุพันธ์ที่ไม่เสถียร. เฟรมเวิร์กกำหนด subgradients หรือแนวทางที่ระบุไว้ในบางกรณี, แต่ผู้ปฏิบัติก็ต้องเข้าใจเทนเซอร์ที่แยกออก, การดำเนินการแบบ in-place, และความแม่นยำเชิงตัวเลข.
เกรเดียนท์หายไปและระเบิด
การคูณซ้ำผ่านหลายชั้นหรือหลายขั้นตอนเวลาอาจทำให้เกรเดียนท์มีค่ามากหรือน้อยเกินไป. เกรเดียนท์หายไปทำให้การเรียนรู้ในชั้นต้นช้าลง; เกรเดียนท์ระเบิดทำให้การอัปเดตไม่เสถียร. การกระตุ้นแบบครอบครัว ReLU, การเริ่มต้นอย่างระมัดระวัง, การเชื่อมต่อแบบ residual, การทำ normalization, การทำ recurrence แบบ gated, และการคลิปเกรเดียนท์ช่วยได้, แต่ไม่มีวิธีใดเป็นการรักษาที่สากล.
การตรวจสอบเกรเดียนท์
การตรวจสอบเกรเดียนท์ด้วยวิธี finite-difference เปรียบเทียบเกรเดียนท์เชิงวิเคราะห์หรืออัตโนมัติกับการประมาณเชิงตัวเลข. วิธีนี้ช้าแต่มีประโยชน์สำหรับการดีบักการดำเนินการที่กำหนดเอง. การตรวจสอบนอร์มของเกรเดียนท์และการตรวจจับค่า NaN หรือค่าอนันต์สามารถเปิดเผยความไม่เสถียรระหว่างการฝึก.
กฎลูกโซ่ผ่านกราฟการคำนวณ
Backpropagation คำนวณเกรเดียนท์ของการสูญเสียสเกลาร์ต่อพารามิเตอร์ที่สามารถหาอนุพันธ์ได้อย่างมีประสิทธิภาพ. การส่งต่อไปข้างหน้าบันทึกค่ากลางในกราฟการคำนวณ. เริ่มจากการสูญเสีย, การแยกความแตกต่างอัตโนมัติแบบย้อนกลับใช้กฎลูกโซ่, คูณอนุพันธ์ท้องถิ่นและสะสมส่วนร่วมเมื่อเส้นทางมาบรรจบ. สำหรับเลเยอร์ y=f(x,w), ความไวของสัญญาณจากบนลงล่างต่อ y จะรวมกับอนุพันธ์บางส่วนเพื่อให้ได้ความไวสำหรับ x และ w. Backpropagation คำนวณเกรเดียนท์; ตัวเพิ่มประสิทธิภาพตัดสินใจว่าพารามิเตอร์จะเปลี่ยนแปลงอย่างไร.
เลเยอร์เชิงเส้นง่าย ๆ ให้ y=Wx+b. เกรเดียนท์สำหรับ W คือผลคูณภายนอกของเกรเดียนท์จากบนลงล่างกับอินพุต, เกรเดียนท์สำหรับ b เป็นผลรวมของค่าจากบนลงล่าง, และเกรเดียนท์ของอินพุตคูณด้วยเมทริกซ์น้ำหนักที่ถูก transpose. การกระตุ้นเพิ่มอนุพันธ์แบบองค์ประกอบ. Convolution, normalization, attention, และการใช้ซ้ำแบบ recurrent ทำตามหลักการกราฟเดียวกันแต่ต้องการรูปแบบเทนเซอร์ที่ถูกต้อง, broadcasting, masking, และการแชร์พารามิเตอร์. เฟรมเวิร์กจะปล่อยการกระตุ้นที่บันทึกหลังการย้อนกลับหากไม่ได้เก็บไว้, ดังนั้นหน่วยความจำมักเพิ่มขึ้นตามขนาด batch, ความลึก, และความยาวลำดับ.
ความล้มเหลวของเกรเดียนท์, การตรวจสอบ, และแนวปฏิบัติวิศวกรรม
ผลคูณของอนุพันธ์หลายตัวอาจหายไปหรือระเบิด. การกระตุ้นแบบคล้าย ReLU, การเริ่มต้นอย่างระมัดระวัง, normalization, การเชื่อมต่อ residual, gating, และการคลิปเกรเดียนท์จัดการกับกลไกต่าง ๆ. การกระตุ้นที่อิ่มตัวและการดำเนินการที่ไม่สามารถหาอนุพันธ์ได้อาจบล็อกสัญญาณที่มีประโยชน์; การแบคโพรพาเกชันแบบตัดทอนจำกัดประวัติของลำดับ; ความแม่นยำผสมอาจทำให้ค่า underflow หากไม่มีการสเกลการสูญเสีย. เกรเดียนท์ระเบิดเป็นอาการ, ดังนั้นการคลิปควรทำพร้อมกับการตรวจสอบอัตราการเรียนรู้, ข้อมูล, สถาปัตยกรรม, และข้อผิดพลาดเชิงตัวเลข แทนการปกปิด.
ตรวจสอบการดำเนินการที่กำหนดเองด้วยการตรวจสอบเกรเดียนท์แบบ finite-difference บนอินพุต double-precision ขนาดเล็ก, หลีกเลี่ยงจุดที่ไม่สามารถหาอนุพันธ์ได้. ตรวจสอบนอร์มของเกรเดียนท์, ค่า NaN, พารามิเตอร์ที่ไม่ทำงาน, และว่าเกรเดียนท์ถึงโมดูลที่คาดไว้หรือไม่. ล้างเกรเดียนท์ที่สะสมอย่างตั้งใจและแยกพฤติกรรมการฝึกจากการประเมินสำหรับ dropout และ normalization. การทำ checkpoint จะคำนวณการกระตุ้นใหม่เพื่อประหยัดหน่วยความจำ; การฝึกแบบกระจายต้องรวมเกรเดียนท์อย่างสอดคล้อง. การลดลงของการสูญเสียในการฝึกแสดงว่ามีเส้นทางการเพิ่มประสิทธิภาพ, ไม่ได้หมายความว่าเกรเดียนท์ถูกต้องตามแนวคิด, ข้อมูลไม่มีการรั่วไหล, หรือโมเดลมีความทั่วไป.
ตัวอย่างทำงาน: ตรวจสอบเลเยอร์ประสาทเทียมที่กำหนดเอง
วิศวกรหนึ่งได้ทำการนำเลเยอร์สเปกตรัมที่สามารถหาอนุพันธ์ได้มาสำหรับเครือข่ายเสียง. การทดสอบ double-precision ขนาดเล็กเปรียบเทียบเกรเดียนท์อัตโนมัติกับ finite differences กลางบนอินพุตและพารามิเตอร์, โดยยกเว้นจุดที่การดำเนินการถูกทำให้ไม่สามารถหาอนุพันธ์ได้โดยเจตนา. รูปทรง, broadcasting, padding, และการแปลง complex-to-real ได้รับกรณีแยกต่างหาก. การทดสอบตรวจสอบการสะสมของเกรเดียนท์เมื่อพารามิเตอร์ถูกใช้ซ้ำและยืนยันว่าเฟรมเสียงที่ถูกมาสก์ไม่ให้เกรเดียนท์.
ระหว่างการฝึก, แดชบอร์ดติดตามนอร์มของเกรเดียนท์และการกระตุ้น, ค่า NaN, พารามิเตอร์ที่ไม่ทำงาน, และการสเกลการสูญเสีย. batch ที่ทำให้เสียโดยเจตนายืนยันว่าการตรวจสอบจะจับเอาต์พุตที่ไม่เป็นจำนวนจริงก่อนการอัปเดตของตัวเพิ่มประสิทธิภาพ. ความแม่นยำผสมและการนำออกมาประยุกต์ใช้ถูกเปรียบเทียบกับอ้างอิง. การทดสอบต่อเนื่องจาก checkpoint รวมสถานะของตัวเพิ่มประสิทธิภาพและลำดับสุ่ม. เลเยอร์จะไม่ได้รับการยอมรับเพียงเพราะการสูญเสียรวมลดลง; ต้องมีหลักฐานที่สอดคล้องของเกรเดียนท์หน่วย, ความเสถียรเชิงตัวเลข, และการทั่วไปของ downstream.
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจเชิงผลิตต้องการมากกว่าการสาธิตที่สำเร็จ. กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละอย่าง. สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับแต่ง. ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุน. วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณผ่าน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย. บันทึกการแปลงทุกขั้นตอนและเกณฑ์เพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด.
ก่อนเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก. ใช้การปล่อยแบบขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ฉีดเข้าโดยเจตนา. เทเลเมทรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น. กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่. ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง. ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่.
คำถามที่พบบ่อย
แบคโพรพาเกชันอัปเดตน้ำหนักหรือไม่?
Backpropagation คำนวณเกรเดียนท์. ตัวเพิ่มประสิทธิภาพนำการอัปเดตไปใช้โดยใช้เกรเดียนท์เหล่านั้น, อัตราการเรียนรู้, และอาจมีสถานะเช่น momentum หรือ adaptive moments.
แบคโพรพาเกชันเป็นแบบจำลองทางชีววิทยาที่สมจริงหรือไม่?
แบคโพรพาเกชันมาตรฐานเป็นอัลกอริทึมเชิงวิศวกรรมและไม่ได้รับการยอมรับว่าเป็นโมเดลรายละเอียดของการเรียนรู้ในสมองชีวภาพ. การเปรียบเทียบเชิงประวัติศาสตร์ของเครือข่ายประสาทไม่ควรถูกมองว่าเทียบเท่าทางชีววิทยา.
แหล่งอ้างอิงหลัก












