
พื้นฐาน AI
เครื่องเวกเตอร์สนับสนุน (Support Vector Machines) คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
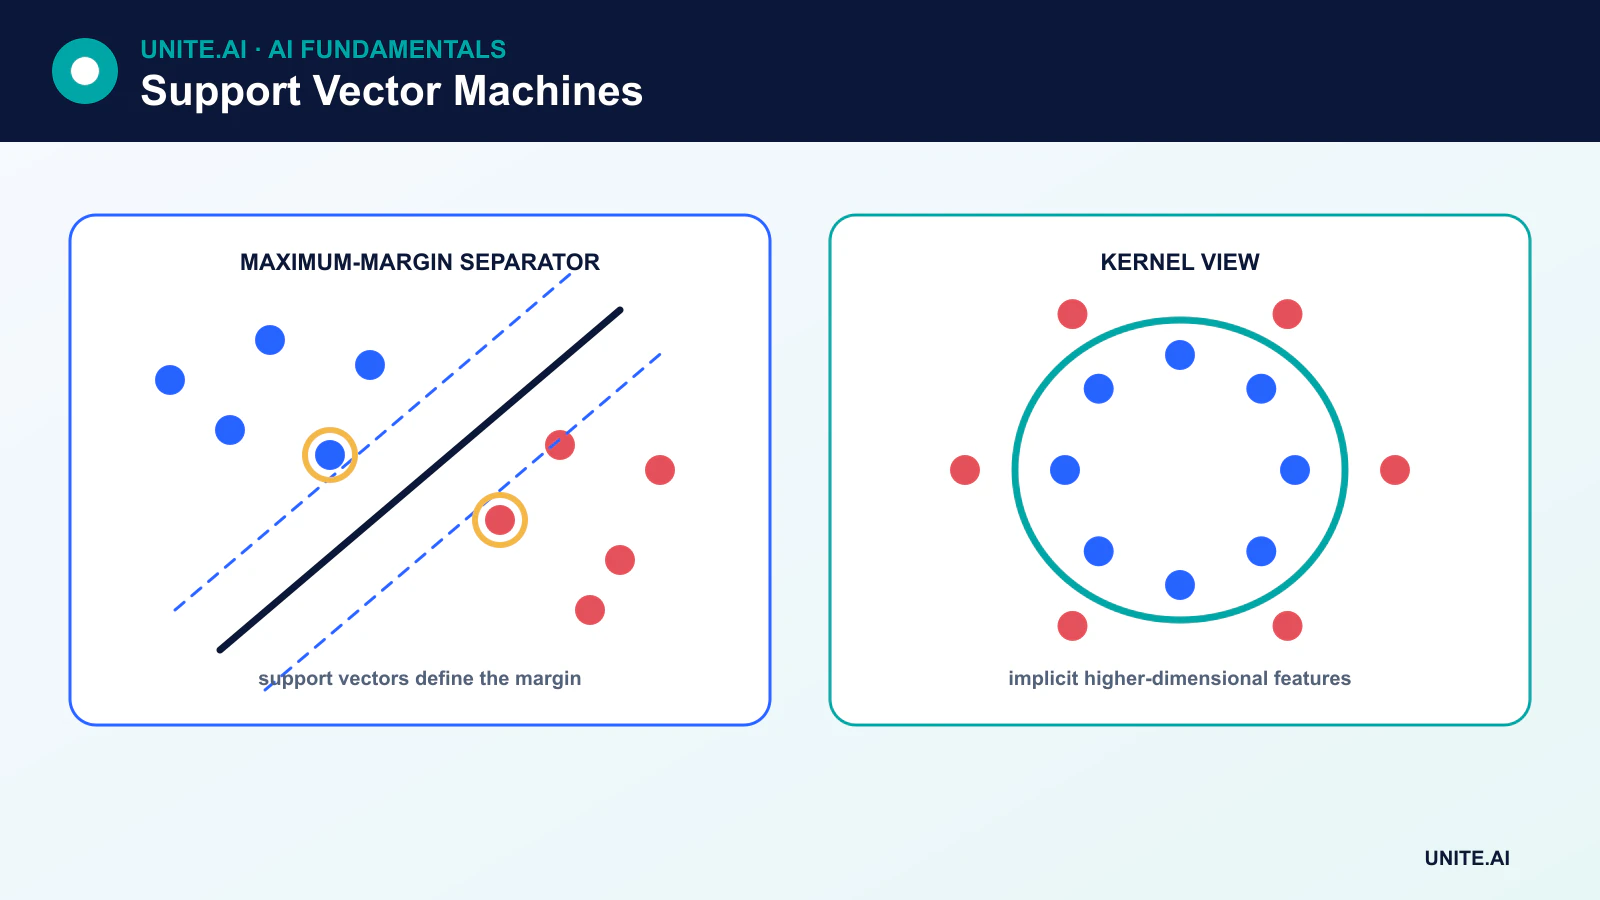
เครื่องเวกเตอร์สนับสนุน (support vector machine (SVM)) เป็นวิธีการเรียนรู้แบบมีผู้สอนที่ค้นหาขอบตัดสินใจที่มีระยะขอบกว้างที่สุดระหว่างคลาส ตัวอย่างการฝึกที่กำหนดขอบตัดสินใจนั้นคือ เวกเตอร์สนับสนุน.
SVM สามารถทำการจำแนกเชิงเส้นหรือไม่เชิงเส้น, การถดถอย, และการตรวจจับความแปลกใหม่ได้ พวกมันมีประโยชน์อย่างยิ่งสำหรับชุดข้อมูลขนาดเล็กถึงกลางที่มีคุณลักษณะให้ข้อมูล รวมถึงข้อมูลแบบกระจุกความหนาแน่นสูงในมิติหลายมิติ แต่ค่าใช้จ่ายในการฝึกอาจกลายเป็นไม่สามารถทำได้กับชุดข้อมูลขนาดใหญ่มาก.
ประเด็นสำคัญ
- SVM จะเพิ่มระยะขอบขั้นต่ำระหว่างขอบตัดสินใจและจุดฝึกที่ใกล้ที่สุดให้มากที่สุด.
- เวกเตอร์สนับสนุนคือจุดข้อมูล ไม่ใช่ไฮเปอร์เพลนเพิ่มเติม.
- พารามิเตอร์ C ปรับสมดุลระหว่างความกว้างของขอบและการลงโทษสำหรับการละเมิด.
- เคอร์เนลคำนวณความคล้ายคลึงในพื้นที่คุณลักษณะโดยอ้อมโดยไม่ต้องสร้างคุณลักษณะที่แปลงแล้วทั้งหมดอย่างชัดเจน.
แนวคิดระยะขอบสูงสุด
สำหรับตัวจำแนกแบบไบนารีเชิงเส้น ขอบตัดสินใจคือไฮเปอร์เพลน:
w · x + b = 0
เวกเตอร์ w กำหนดทิศทางและ b กำหนดการเยื้อง ไฮเปอร์เพลนหลายเส้นอาจแยกคลาสการฝึกได้ SVM จะเลือกเส้นที่ทำให้ระยะทางถึงตัวอย่างที่ใกล้ที่สุดจากทั้งสองด้านมากที่สุด ตัวอย่างที่ใกล้ที่สุดเหล่านั้นคือเวกเตอร์สนับสนุนและมีอิทธิพลสูงสุดต่อขอบที่ได้.
เป้าหมายไม่ได้คือการเพิ่มระยะห่างจากขอบตัดสินใจถึงทุกจุดอย่างอิสระ แต่เป็นการเพิ่มระยะขอบขั้นต่ำขณะปฏิบัติตามหรือลงโทษข้อจำกัดของคลาส.
ขอบแบบแข็งและแบบอ่อน
SVM แบบขอบแข็งต้องการการแยกเชิงเส้นที่สมบูรณ์แบบและมีความอ่อนไหวต่อค่าเบี่ยงเบน ชุดข้อมูลจริงมักต้องการ ขอบอ่อน ซึ่งแนะนำตัวแปรสแล็คสำหรับการสังเกตที่อยู่ภายในขอบหรืออยู่ฝั่งผิดของขอบตัดสินใจ.
ไฮเปอร์พารามิเตอร์ C ควบคุมการลงโทษสำหรับการละเมิดเหล่านี้:
- ค่า C ที่ใหญ่กว่าจะลงโทษการละเมิดอย่างรุนแรงมากขึ้นและมักทำให้ขอบแคบลงซึ่งตามตัวอย่างการฝึกอย่างใกล้ชิด.
- ค่า C ที่เล็กกว่าจะยอมรับการละเมิดมากขึ้นเพื่อแลกกับขอบที่กว้างและมีการทำให้เป็นระเบียบมากขึ้น.
จำนวนเวกเตอร์สนับสนุนเป็นผลมาจากข้อมูลและวิธีแก้; การเพิ่มค่า C ไม่ได้รับประกันจำนวนเวกเตอร์สนับสนุนที่แน่นอน.
เทคนิคเคอร์เนล
บางคลาสไม่สามารถแยกด้วยไฮเปอร์เพลนตรงในพื้นที่คุณลักษณะเดิมได้ เคอร์เนลจะประเมินผลคูณในจุดภายในที่สอดคล้องกับพื้นที่คุณลักษณะอื่น ซึ่งทำให้ SVM สามารถสร้างขอบไม่เชิงเส้นโดยไม่ต้องคำนวณทุกพิกัดที่แปลงแล้วอย่างชัดเจน.
เคอร์เนลที่พบบ่อยได้แก่:
- Linear: มีประสิทธิภาพสำหรับคุณลักษณะกระจุกความหนาแน่นสูงเช่นข้อความ.
- Polynomial: จำลองการโต้ตอบจนถึงระดับที่เลือก.
- Radial basis function (RBF): สร้างขอบท้องถิ่นที่ยืดหยุ่นโดยอิงระยะทาง.
- Sigmoid: คล้ายการกระตุ้นของโครงข่ายประสาทแต่ไม่ค่อยเป็นตัวเลือกเริ่มต้น.
สำหรับ SVM แบบ RBF, gamma ควบคุมว่าตัวอย่างการฝึกแต่ละตัวมีอิทธิพลต่อขอบอย่างใกล้ชิดแค่ไหน ค่า gamma สูงอาจสร้างพื้นที่ที่มีรายละเอียดสูงและ overfit; ค่า gamma ต่ำให้ผลกระทบที่เรียบเนียนกว่า.
การจำแนกหลายคลาส
เป้าหมายคลาสสิกของ SVM คือแบบไบนารี ไลบรารีขยายโดยใช้กลยุทธ์เช่น one-vs-rest ที่ฝึกตัวจำแนกหนึ่งตัวต่อคลาส หรือ one-vs-one ที่ฝึกตัวจำแนกสำหรับคู่คลาสและรวมการตัดสินใจของพวกมัน SVM แบบหลายคลาสไม่ได้เพียงแค่วาดเส้นหนึ่งเส้นน้อยกว่าจำนวนคลาส.
การถดถอยด้วยเวกเตอร์สนับสนุนและ SVM แบบหนึ่งคลาส
การถดถอยด้วยเวกเตอร์สนับสนุน (SVR) ทำการฟิตฟังก์ชันโดยไม่สนใจข้อผิดพลาดภายในท่อที่กว้าง epsilon และลงโทษการเบี่ยงเบนที่ใหญ่กว่า SVM แบบหนึ่งคลาสประมาณขอบเขตรอบข้อมูลทั่วไปและสามารถสนับสนุนการตรวจจับความแปลกใหม่ จุดที่ไม่ปกติไม่ได้หมายความว่าเป็นการฉ้อโกงหรือความล้มเหลวโดยอัตโนมัติ; มันเป็นสิ่งที่ไม่ปกติตามการแสดงผลที่ฟิตแล้ว.
ข้อกำหนดเชิงปฏิบัติ
SVM พึ่งพาระยะทางและผลคูณในจุดภายใน ดังนั้นคุณลักษณะเชิงตัวเลขมักต้องการการสเกล링 C, เคอร์เนล, gamma, และน้ำหนักคลาสควรเลือกผ่านการตรวจสอบความถูกต้อง การประมาณความน่าจะเป็นไม่ได้เป็นส่วนหนึ่งของขอบและมักต้องการการปรับเทียบ ซึ่งเพิ่มค่าใช้จ่ายและควรประเมินแยกต่างหาก.
การฝึก Kernel SVM สามารถขยายได้ระหว่างเวลาเชิงกำลังสองถึงเชิงกำลังสามตามจำนวนตัวอย่าง ขึ้นอยู่กับข้อมูลและการนำไปใช้ รุ่น SVM เชิงเส้นหรือโมเดลเชิงเส้นแบบสโตคาสติกเหมาะกับชุดข้อมูลขนาดใหญ่มาก สำหรับภาพดิบ, เสียง, หรือภาษา การแสดงผลที่เรียนรู้จาก deep learning อาจมีประสิทธิภาพมากกว่า ในขณะที่ SVM ยังสามารถจำแนกการฝังคงที่ได้.
จุดแข็งและข้อจำกัดของ SVM
SVM สามารถทำงานได้ดีกับคุณลักษณะจำนวนมาก ให้เป้าหมายที่มีการทำให้เป็นระเบียบชัดเจน และพึ่งพาเวกเตอร์สนับสนุนเป็นหลักในเวลาทำนาย ข้อจำกัดรวมถึงความอ่อนไหวต่อการสเกลและไฮเปอร์พารามิเตอร์ การฝึกที่อาจมีค่าใช้จ่ายสูง การตีความที่ลดลงภายใต้เคอร์เนลไม่เชิงเส้น และความต้องการการปรับเทียบความน่าจะเป็น.
ระยะขอบ, เคอร์เนล, และวัตถุประสงค์การเพิ่มประสิทธิภาพ
เครื่องเวกเตอร์สนับสนุนมองหาไฮเปอร์เพลนที่แยกคลาสด้วยระยะขอบกว้าง ระยะขอบที่กำหนดโดยเวกเตอร์สนับสนุนที่อยู่บนหรือภายในขอบเท่านั้น Soft-margin SVM แนะนำสแล็คสำหรับการทับซ้อนและจุดที่ติดป้ายผิด; พารามิเตอร์ C ทำการแลกเปลี่ยนระหว่างขอบที่กว้างกว่าและการละเมิดระหว่างการฝึก อินพุตควรสเกลโดยทั่วไปเนื่องจากระยะทางและผลคูณเป็นตัวขับเคลื่อนวิธีแก้ น้ำหนักคลาสหรือการสุ่มซ้ำช่วยเมื่อค่าใช้จ่ายของข้อผิดพลาดและความแพร่หลายไม่เท่ากัน แต่เกณฑ์และความน่าจะต้องการการตรวจสอบแยก
เทคนิคเคอร์เนลประเมินความคล้ายคลึงเหมือนกับว่าข้อมูลถูกแมปไปยังพื้นที่คุณลักษณะมิติสูงกว่า เคอร์เนลเชิงเส้น, พหุนาม, รัศมีฐาน, และเคอร์เนลเฉพาะทางเข้ารหัสสมมติฐานที่แตกต่างกัน สำหรับเคอร์เนล RBF, gamma ควบคุมว่าจุดแต่ละจุดมีอิทธิพลต่อขอบอย่างใกล้ชิดแค่ไหน: gamma สูงอาจสร้างพื้นที่ซับซ้อนและ overfit, ในขณะที่ gamma ต่ำอาจ underfit เมทริกซ์เคอร์เนลเติบโตเชิงกำลังสองกับจำนวนตัวอย่าง ทำให้ SVM ไม่เชิงเส้นมีค่าใช้จ่ายสูงในชุดข้อมูลขนาดใหญ่ ตัวแก้เชิงเส้นหรือแผนที่คุณลักษณะโดยประมาณมักเป็นตัวเลือกที่ดีกว่าเมื่อขนาดใหญ่
การใช้หลายคลาส, การปรับเทียบ, และขีดจำกัดการดำเนินงาน
SVM แบบไบนารีขยายเป็นหลายคลาสผ่าน one-vs-rest, one-vs-one หรือรูปแบบโครงสร้าง ไฮเปอร์พารามิเตอร์ต้องปรับจูนภายในการตรวจสอบความถูกต้องข้ามชุดข้อมูล พร้อมการแบ่งกลุ่มหรือเชิงเวลาเมื่อต้องการ ประเมินความแม่นยำและการเรียกคืนเฉพาะคลาส, การกระจายของระยะขอบ, การปรับเทียบ, และประสิทธิภาพภายใต้การเปลี่ยนแปลง คะแนนการตัดสินใจดิบไม่ใช่ความน่าจะเป็น; การสเกล Platt หรือการปรับเทียบแบบไอโซโทนิกใช้ข้อมูลแยกและอาจเสื่อมถ้าความแพร่หลายเปลี่ยน เปรียบเทียบกับโลจิสติกรีเกรสชัน, ต้นไม้, และวิธีการที่อิงการแสดงผลสมัยใหม่โดยมีการเตรียมข้อมูลและการปรับจูนที่เทียบเท่า
การให้บริการต้องใช้สเกลเลอร์ที่ตรงกัน, ลำดับคุณลักษณะ, พารามิเตอร์เคอร์เนล, เวกเตอร์สนับสนุน, และการแมปคลาส ค่าใช้จ่ายการทำนายสำหรับ kernel SVM จะเพิ่มขึ้นตามจำนวนเวกเตอร์สนับสนุน ดังนั้นควรวัดความหน่วงและหน่วยความจำบนชุดข้อมูลที่เป็นจริง อินพุตที่ห่างจากการสนับสนุนการฝึกยังสามารถรับป้ายที่มั่นใจได้; เพิ่มการตรวจสอบข้อมูลนอกการกระจายหรือแนวนโยบายการละเว้นเมื่อเหมาะสม ตรวจสอบข้อผิดพลาดสำหรับตัวแทนที่อ่อนไหวและศิลปะของชุดข้อมูล SVM ยังคงแข็งแกร่งสำหรับปัญหาขนาดกลางที่มีมิติสูง แต่ระยะขอบเรขาคณิตสูงสุดไม่ได้เป็นหลักฐานของโครงสร้างสาเหตุหรือความปลอดภัย
ตัวอย่างการทำงาน: SVM สำหรับการกำหนดเส้นทางเอกสารหายาก
ทีมปฏิบัติการกฎหมายจำแนกไฟล์สั้นเป็นหมวดหมู่การกำหนดเส้นทางโดยใช้คุณลักษณะ TF–IDF และ SVM เชิงเส้น แบ่งข้อมูลตามเรื่องและเวลาเพื่อป้องกันเทมเพลตรั่วไหล ปรับสเกลน้ำหนักคลาสตามค่าใช้จ่ายข้อผิดพลาดที่ตรวจสอบ และปรับค่า C ภายในการตรวจสอบความถูกต้องแบบซ้อน โมเดลเชิงเส้นถูกเปรียบเทียบกับโลจิสติกรีเกรสชันและตัวแปลง การแม่นยำ, การเรียกคืน, การปรับเทียบ, และภาระงานของผู้ตรวจสอบต่อคลาสมีความสำคัญมากกว่าความแม่นยำรวม
คะแนนการตัดสินใจถูกปรับเทียบด้วยข้อมูลแยก และเอกสารที่มีระยะขอบต่ำหรือภาษาที่ไม่รองรับจะถูกส่งไปยังการรับมือด้วยมือ ผลลัพธ์การให้บริการรวมถึงตัวตัดคำ, คำศัพท์, การให้ค่าน้ำหนัก, โมเดล, การปรับเทียบ, และแผนที่ป้ายกำกับ การเฝ้าติดตามตรวจจับคำใหม่, ความแพร่หลายของหมวดหมู่, ระยะขอบ, และเส้นทางที่แก้ไข เอกสารและเวกเตอร์สนับสนุนได้รับการปกป้องเนื่องจากคุณลักษณะข้อความอาจเปิดเผยข้อมูลลับ เคอร์เนลไม่เชิงเส้นถูกปฏิเสธเมื่อการเพิ่มคุณภาพเล็กน้อยไม่คุ้มค่าต่อความหน่วง, หน่วยความจำ, และค่าใช้จ่ายการตีความ
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของการขึ้นต่อ, การใช้ผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา เทเลเมทรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นโมเดลหรือกฎ, สถานะการขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
SVM ทำได้แค่การจำแนกหรือไม่?
ไม่ SVM แบบถดถอยด้วยเวกเตอร์สนับสนุนทำนายเป้าหมายต่อเนื่อง, ส่วน SVM แบบหนึ่งคลาสสามารถประมาณขอบเขตความแปลกใหม่ แต่ละรูปแบบมีเป้าหมายและชุดไฮเปอร์พารามิเตอร์ที่แตกต่างกัน
เมื่อใดที่ SVM เชิงเส้นเป็นตัวเลือกที่ดี?
SVM เชิงเส้นมักมีประสิทธิภาพสำหรับคุณลักษณะกระจุกความหนาแน่นสูง, รวมถึงการแสดงผลข้อความแบบดั้งเดิม, ที่เคอร์เนลที่ยืดหยุ่นจะเพิ่มค่าใช้จ่ายโดยไม่มีประโยชน์ชัดเจน
แหล่งอ้างอิงหลัก












