
พื้นฐาน AI
ต้นไม้การตัดสินใจคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ต้นไม้การตัดสินใจเป็นโมเดลการเรียนรู้แบบมีผู้สอนที่ทำการทำนายโดยใช้ชุดของกฎแบบถ้า‑แล้ว แต่ละโหนดภายในทดสอบคุณลักษณะแต่ละตัว แต่ละสาขาแสดงผลลัพธ์ของการทดสอบนั้น และแต่ละใบไม้ให้การทำนายประเภทคลาส ความน่าจะเป็น หรือค่าตัวเลข
ต้นไม้การตัดสินใจใช้สำหรับการจำแนกประเภทและการถดถอย ความน่าสนใจของมันอยู่ที่ความเป็นประโยชน์: สามารถแสดงปฏิสัมพันธ์เชิงไม่เชิงเส้น ต้องการการเตรียมข้อมูลล่วงหน้าเพียงเล็กน้อย และสร้างเส้นทางที่ผู้ใช้สามารถตรวจสอบได้ จุดอ่อนของมันคือความไม่เสถียร—การเปลี่ยนแปลงเล็กน้อยในข้อมูลฝึกสามารถทำให้ได้ต้นไม้ที่แตกต่างกัน
ประเด็นสำคัญ
- ต้นไม้แบ่งพื้นที่คุณลักษณะอย่างวนซ้ำ; ไม่จำเป็นต้องแยกแต่ละตัวอย่างการฝึกทั้งหมด
- การแบ่งประเภทมักใช้ค่า Gini impurity หรือ entropy, ส่วนการแบ่งการถดถอยจะลดข้อผิดพลาดการทำนายหรือความแปรปรวน
- ความลึก, ขนาดใบไม้ขั้นต่ำ, และการตัดแต่งควบคุมความซับซ้อนและการฝึกเกิน
- Random forest และ gradient‑boosted tree เพิ่มความสามารถในการทำนายโดยการรวมหลายต้นไม้
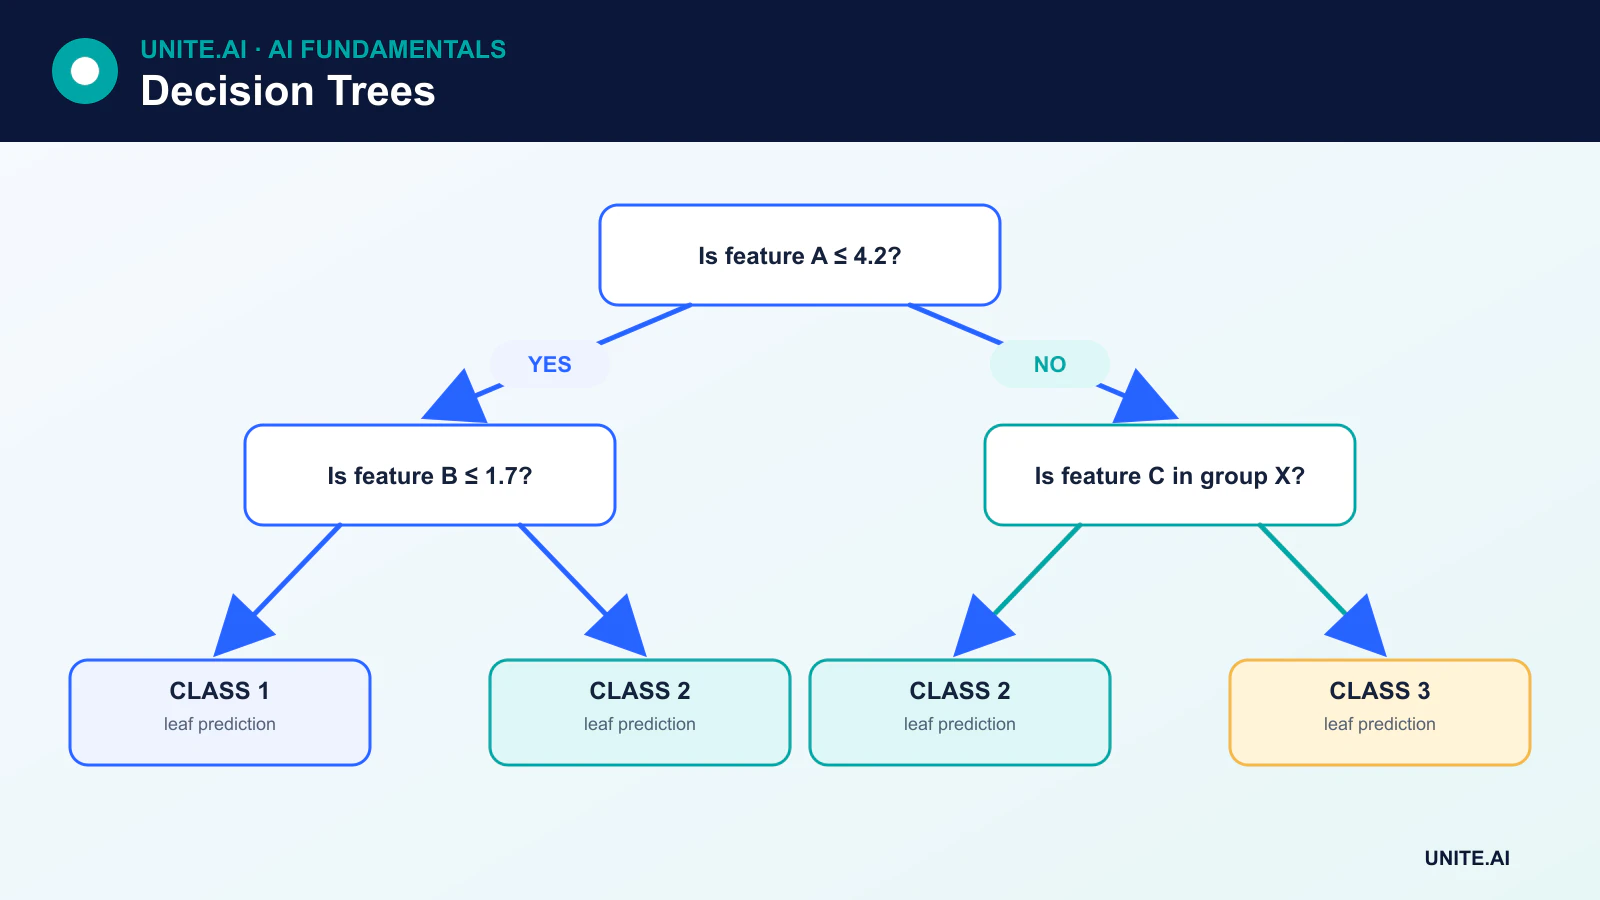
วิธีที่ต้นไม้การตัดสินใจทำการทำนาย
สมมติว่าโมเดลทำนายว่าเครื่องจักรอาจจะเสียหรือไม่ โหนดรากอาจถามว่าการสั่นสะเทือนเกินค่าขีดจำกัดที่เรียนรู้หรือไม่ สาขาหนึ่งอาจทดสอบอุณหภูมิการทำงาน การสังเกตจะไปถึงใบไม้ที่บรรจุความน่าจะเป็นการเสียที่ประมาณจากตัวอย่างการฝึกที่เดินตามเส้นทางเดียวกัน
สำหรับการถดถอย ใบไม้อาจคืนค่ากลางของเป้าหมายจากการสังเกตในเขตนั้น สำหรับการจำแนกประเภท ใบไม้อาจคืนคลาสส่วนใหญ่หรือการกระจายความถี่ของคลาส ใบไม้สามารถบรรจุตัวอย่างจำนวนมาก; การแยกข้อมูลการฝึกอย่างเต็มที่มักไม่ต้องการเพราะอาจทำให้ได้ต้นไม้ที่ฝึกเกิน
วิธีที่ต้นไม้เลือกการแบ่ง
การฝึกพิจารณาคุณลักษณะและค่าขีดจำกัดที่เป็นไปได้, แล้วเลือกการแบ่งที่ทำให้วัตถุประสงค์ที่กำหนดปรับปรุงมากที่สุด การปรับปรุงต้องถ่วงน้ำหนักตามจำนวนตัวอย่างที่ไปยังแต่ละโหนดลูก
ความบกพร่องแบบ Gini
สำหรับการจำแนกประเภท, ความบกพร่องแบบ Gini วัดว่าคลาสผสมกันมากแค่ไหนในโหนด:
Gini = 1 - Σ p(k)²
โหนดที่มีเพียงคลาสเดียวมีความบกพร่องเป็นศูนย์ การแบ่งที่เป็นไปได้จะมีประโยชน์เมื่อความบกพร่องถ่วงน้ำหนักของโหนดลูกต่ำกว่าความบกพร่องของโหนดพ่อแม่
เอนโทรปีและการเพิ่มข้อมูล
เอนโทรปีเป็นมาตรการอีกหนึ่งของความไม่แน่นอนของคลาส:
Entropy = -Σ p(k) log₂ p(k)
การเพิ่มข้อมูลคือเอนโทรปีของโหนดพ่อแม่ลบด้วยเอนโทรปีของโหนดลูกที่ถ่วงน้ำหนัก Gini และเอนโทรปีมักให้ต้นไม้ที่คล้ายกัน แม้ว่าไม่จำเป็นต้องเหมือนกันเสมอ
การสูญเสียในการถดถอย
ต้นไม้การถดถอยมักเลือกการแบ่งที่ลดข้อผิดพลาดกำลังสอง, ข้อผิดพลาดสัมบูรณ์, หรือเกณฑ์การถดถอยอื่น ๆ ใบไม้แต่ละใบจะทำนายค่าตามเป้าหมายการฝึกที่อยู่ในเขตนั้น
CART และอัลกอริทึมต้นไม้อื่น ๆ
CART หรือ Classification and Regression Trees ใช้การแบ่งแบบทวิและเป็นพื้นฐานของการนำไปใช้ทั่วไปเช่นต้นไม้การตัดสินใจของ scikit-learn อัลกอริทึมอื่น ๆ ได้แก่ ID3, C4.5, และ C5.0 การนำไปใช้แตกต่างกันในประเภทการแบ่งที่สนับสนุน, การจัดการค่าที่ขาดหาย, การตัดแต่ง, และวัตถุประสงค์
ตัวแปรเชิงหมวดหมู่อาจต้องการการเข้ารหัส, การแบ่งย่อยโดยตรง, หรือการจัดการตามการนำไปใช้เฉพาะ ค่าที่ขาดหายสามารถเติมค่าได้หรือจัดการผ่านทิศทางค่าเริ่มต้นที่เรียนรู้หรือการแบ่งสำรอง การเข้าใจพฤติกรรมของไลบรารีเฉพาะเป็นสิ่งสำคัญ มากกว่าการสันนิษฐานว่าการนำไปใช้ของต้นไม้ทุกแบบทำงานเหมือนกัน
การควบคุมความซับซ้อนของต้นไม้
ต้นไม้ที่ลึกอาจจดจำสัญญาณรบกวน การควบคุมทั่วไปรวมถึง:
- ความลึกสูงสุด: จำกัดความยาวของเส้นทางการทำนาย
- จำนวนตัวอย่างขั้นต่ำต่อการแบ่งหรือใบไม้: ป้องกันเขตพื้นที่เล็ก ๆ
- การลดความบกพร่องขั้นต่ำ: ต้องการการแบ่งที่ให้ประโยชน์เพียงพอ
- จำนวนใบไม้สูงสุด: จำกัดความซับซ้อนทั้งหมด
- การตัดแต่งตามต้นทุน‑ความซับซ้อน: ลบสาขาที่การปรับปรุงไม่คุ้มค่ากับความซับซ้อนที่เพิ่มขึ้น
การตัดแต่งเป็นกระบวนการเพิ่มประสิทธิภาพที่มีโครงสร้าง ไม่ใช่การลบแบบสุ่ม ค่าพารามิเตอร์ควรเลือกโดยใช้ข้อมูลตรวจสอบหรือการตรวจสอบข้ามชุด, ในขณะที่ชุดทดสอบสุดท้ายยังคงไม่ถูกแก้ไข
ข้อดีและข้อจำกัด
ต้นไม้การตัดสินใจสามารถจำลองปฏิสัมพันธ์และผลของเกณฑ์โดยไม่ต้องปรับสเกลคุณลักษณะ พวกมันรับข้อมูลเชิงตัวเลขและขึ้นอยู่กับการนำไปใช้อาจรับข้อมูลเชิงหมวดหมู่ การทำนายรวดเร็ว และต้นไม้ขนาดเล็กง่ายต่อการแสดงภาพ
อย่างไรก็ตาม ต้นไม้เดี่ยวอาจมีความแปรปรวนสูง, สร้างการเปลี่ยนแปลงการทำนายอย่างกะทันหันใกล้การแบ่ง, และให้ความสำคัญกับคุณลักษณะที่มีจุดแบ่งหลายจุด ต้นไม้ยังคาดการณ์ได้ไม่ดีในการถดถอย: นอกเขตที่สังเกต, ใบไม้ยังคงคืนค่าที่เรียนรู้จากตัวอย่างการฝึก ต้นไม้ขนาดใหญ่อาจไม่เข้าใจได้ง่ายกว่ารุ่นซับซ้อนอื่น
จากต้นไม้เดี่ยวสู่การรวมหลายต้นไม้
การเรียนรู้แบบรวมหลายโมเดล รวมหลายโมเดลเข้าด้วยกัน Random forest ฝึกหลายต้นไม้บนการสุ่มตัวอย่างใหม่ของข้อมูลและชุดย่อยของคุณลักษณะ, แล้วเฉลี่ยการทำนายของพวกมัน Gradient boosting สร้างต้นไม้ต่อเนื่องกันเพื่อให้ต้นไม้ใหม่แต่ละต้นแก้ไขข้อผิดพลาดที่เหลือ วิธีการเหล่านี้มักทำผลงานดีกว่าต้นไม้เดี่ยว, แต่แลกมาด้วยการสูญเสียความสามารถในการอธิบายบางส่วนและเพิ่มค่าใช้จ่ายด้านการคำนวณ
ความสำคัญของคุณลักษณะจากต้นไม้หรือการรวมหลายต้นไม้ควรตีความอย่างระมัดระวัง ความสำคัญที่อิงความบกพร่องอาจมีอคติ, และความสำคัญของคุณลักษณะไม่ได้พิสูจน์เหตุผลเชิงสาเหตุ ความสำคัญแบบ permutation, เครื่องมือ partial‑dependence, และการตรวจสอบจากผู้เชี่ยวชาญให้บริบทเพิ่มเติม
วิธีที่ต้นไม้เรียนรู้การแบ่งและการทำนาย
ต้นไม้การตัดสินใจแบ่งพื้นที่คุณลักษณะอย่างวนซ้ำ ที่แต่ละโหนด, อัลกอริทึมการฝึกประเมินค่าขีดจำกัดของคุณลักษณะหรือการแบ่งประเภทที่เป็นไปได้และเลือกการแบ่งที่ลดความบกพร่องมากที่สุด เช่น Gini impurity หรือ entropy สำหรับการจำแนกประเภทและข้อผิดพลาดกำลังสองสำหรับการถดถอย ใบไม้เก็บการกระจายคลาสหรือการทำนายเชิงตัวเลขตามตัวอย่างการฝึกที่มาถึงมัน การแบ่งแบบโลภเป็นวิธีที่ทำได้ในเชิงคำนวณแต่ไม่รับประกันว่าต้นไม้ที่ดีที่สุดทั่วโลก, และตัวอย่างที่ต่างกันหรือการตัดสินใจเท่าเทียมอาจทำให้ได้โครงสร้างที่แตกต่าง
คุณลักษณะต่อเนื่อง, ลำดับ, เชิงหมวดหมู่, และค่าที่ขาดหายต้องการการจัดการอย่างชัดเจน การเข้ารหัสแบบ one‑hot สามารถสร้างการแบ่งที่เป็นไปได้จำนวนมาก; วิธีเชิงหมวดหมู่อย่างเนทีฟอาจใช้สถิติแบบเรียงลำดับแต่ต้องการการนำไปใช้ที่ปลอดภัยจากการรั่วไหล ต้นไม้ไม่ต้องการการสเกล, แต่ยังอาจให้ความสำคัญกับตัวแปรที่มีระดับความหลากหลายสูงและแยกกลุ่มเล็ก ๆ ความลึก, ขนาดใบไม้ขั้นต่ำ, การลดความบกพร่องขั้นต่ำ, และการตัดแต่งตามต้นทุน‑ความซับซ้อนควบคุมความแปรปรวน เลือกใช้ด้วยข้อมูลตรวจสอบและประเมินการปรับเทียบ, เนื่องจากความน่าจะเป็นของใบไม้ที่อิงจากกรณีน้อยอาจมีความสุดขีดและไม่เสถียร
การตีความ, โหมดความล้มเหลว, และการใช้งานในผลิตภัณฑ์
เส้นทางจากรากถึงใบไม้เป็นกฎที่แน่นอนสำหรับการทำนายของโมเดลหนึ่ง, แต่ไม่ได้หมายความว่าเป็นคำอธิบายเชิงสาเหตุโดยอัตโนมัติ ตัวแปรที่สัมพันธ์กันสามารถแทนที่กันได้, การเปลี่ยนแปลงข้อมูลเล็กน้อยอาจทำให้การแบ่งระดับบนเปลี่ยนแปลง, และเส้นทางที่ดูเรียบง่ายอาจพึ่งพาป้ายกำกับที่มีอคติ ความสำคัญของคุณลักษณะระดับโลกที่อิงความบกพร่องอาจทำให้เข้าใจผิด; ความสำคัญแบบ permutation, partial‑dependence, และการตรวจสอบเชิงตรงข้ามเพิ่มบริบทแต่ก็มีสมมติฐาน รายงานความไม่แน่นอนและทดสอบว่ากฎที่อ้างถึงยังคงเป็นจริงบนข้อมูลอิสระและกลุ่มย่อยที่เกี่ยวข้อง
ต้นไม้เดี่ยวมีประโยชน์เมื่อความโปร่งใส, ความหน่วงต่ำ, และโครงสร้างเชิงไม่เชิงเส้นระดับปานกลางเป็นสิ่งสำคัญ, แต่การรวมหลายต้นไม้มักให้ประสิทธิภาพการทำนายที่ดีกว่า ตรวจสอบพฤติกรรมที่ขอบเขต, หมวดหมู่หายาก, การขาดข้อมูล, และอินพุตที่อยู่นอกช่วงการฝึก กฎที่ส่งออกต้องทำซ้ำการเตรียมข้อมูลการฝึกและการเปรียบเทียบเชิงตัวเลขอย่างแม่นยำ ตรวจสอบการครอบครองใบไม้, การกระจายผลลัพธ์, ข้อผิดพลาด, และหมวดหมู่ที่กำลังเกิดขึ้น ต้นไม้ที่ส่งกรณีใหม่จำนวนมากเข้าสู่เขตเล็กหรือที่เคยว่างเปล่าควรทำให้เกิดการตรวจสอบแม้การเปลี่ยนแปลงโดยรวมจะเล็กน้อย เก็บสำรองสำหรับสคีมาที่ไม่ถูกต้องและบันทึกการตัดแต่งหรือการตัดสินใจเกี่ยวกับเกณฑ์ทุกครั้ง
ตัวอย่างที่ทำงาน: ต้นไม้การคัดแยกสินเชื่อที่อธิบายได้
ผู้ให้กู้ใช้ต้นไม้เพียงเพื่อจัดลำดับความสำคัญของใบสมัครที่ไม่สมบูรณ์สำหรับการตรวจสอบด้วยมือ, ไม่ได้ใช้เพื่ออนุมัติหรือปฏิเสธเครดิต เป้าหมายคือผลลัพธ์ความสมบูรณ์ที่บันทึกไว้, และคุณลักษณะที่มีในขั้นตอนรับข้อมูลไม่รวมการตัดสินใจในภายหลัง การตรวจสอบเชิงเวลาแบบกลุ่มเปรียบเทียบต้นไม้ที่ตัดแต่งตื้นกับกฎและโลจิสติกรีเกรสชัน ขนาดใบไม้ขั้นต่ำป้องกันกฎที่อิงจากผู้สมัครเพียงไม่กี่คน, ในขณะที่การปรับเทียบและข้อผิดพลาดตามคลาสถูกรายงานผ่านช่องทางต่าง ๆ และกลุ่มที่ได้รับการคุ้มครองที่เกี่ยวข้อง
ผู้ตรวจสอบเห็นเส้นทางและค่าต้นฉบับอย่างแม่นยำแต่สามารถแก้ไขข้อมูลที่ผิดพลาดและละเมิดการกำหนดเส้นทางได้ องค์กรทดสอบตัวแทนที่สัมพันธ์และการเปลี่ยนแปลงเชิงตรงข้าม, ตรวจสอบการครอบครองใบไม้และการขาดข้อมูล, และถือการไหลเข้ามาอย่างฉับพลันสู่ใบไม้ขนาดเล็กเป็นเหตุการณ์คุณภาพข้อมูล การเปลี่ยนแปลงนโยบายสร้างเวอร์ชันโมเดลและการตรวจสอบใหม่, ไม่ใช่การแก้ไขการแบ่งที่ไม่ได้บันทึกไว้ เนื่องจากการใช้งานส่งผลต่อการเข้าถึงและภาระ, ผู้สมัครจะได้รับช่องทางมนุษย์และต้นไม้จะไม่ถูกนำเสนอเป็นคำอธิบายเชิงสาเหตุของความน่าเชื่อถือทางเครดิต
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจในผลิตภัณฑ์ต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนที่ขึ้นต่อ, การใช้งานผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงทุกขั้นตอนและเกณฑ์เพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยุติ ใช้การเปิดใช้งานแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยความล้มเหลวที่ใส่เข้ามาโดยเจตนา ระบบเทเลเมทรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะของส่วนที่ขึ้นต่อ, การละเมิดโดยมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
อ้างอิงหลัก












