
พื้นฐาน AI
K-Means Clustering คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
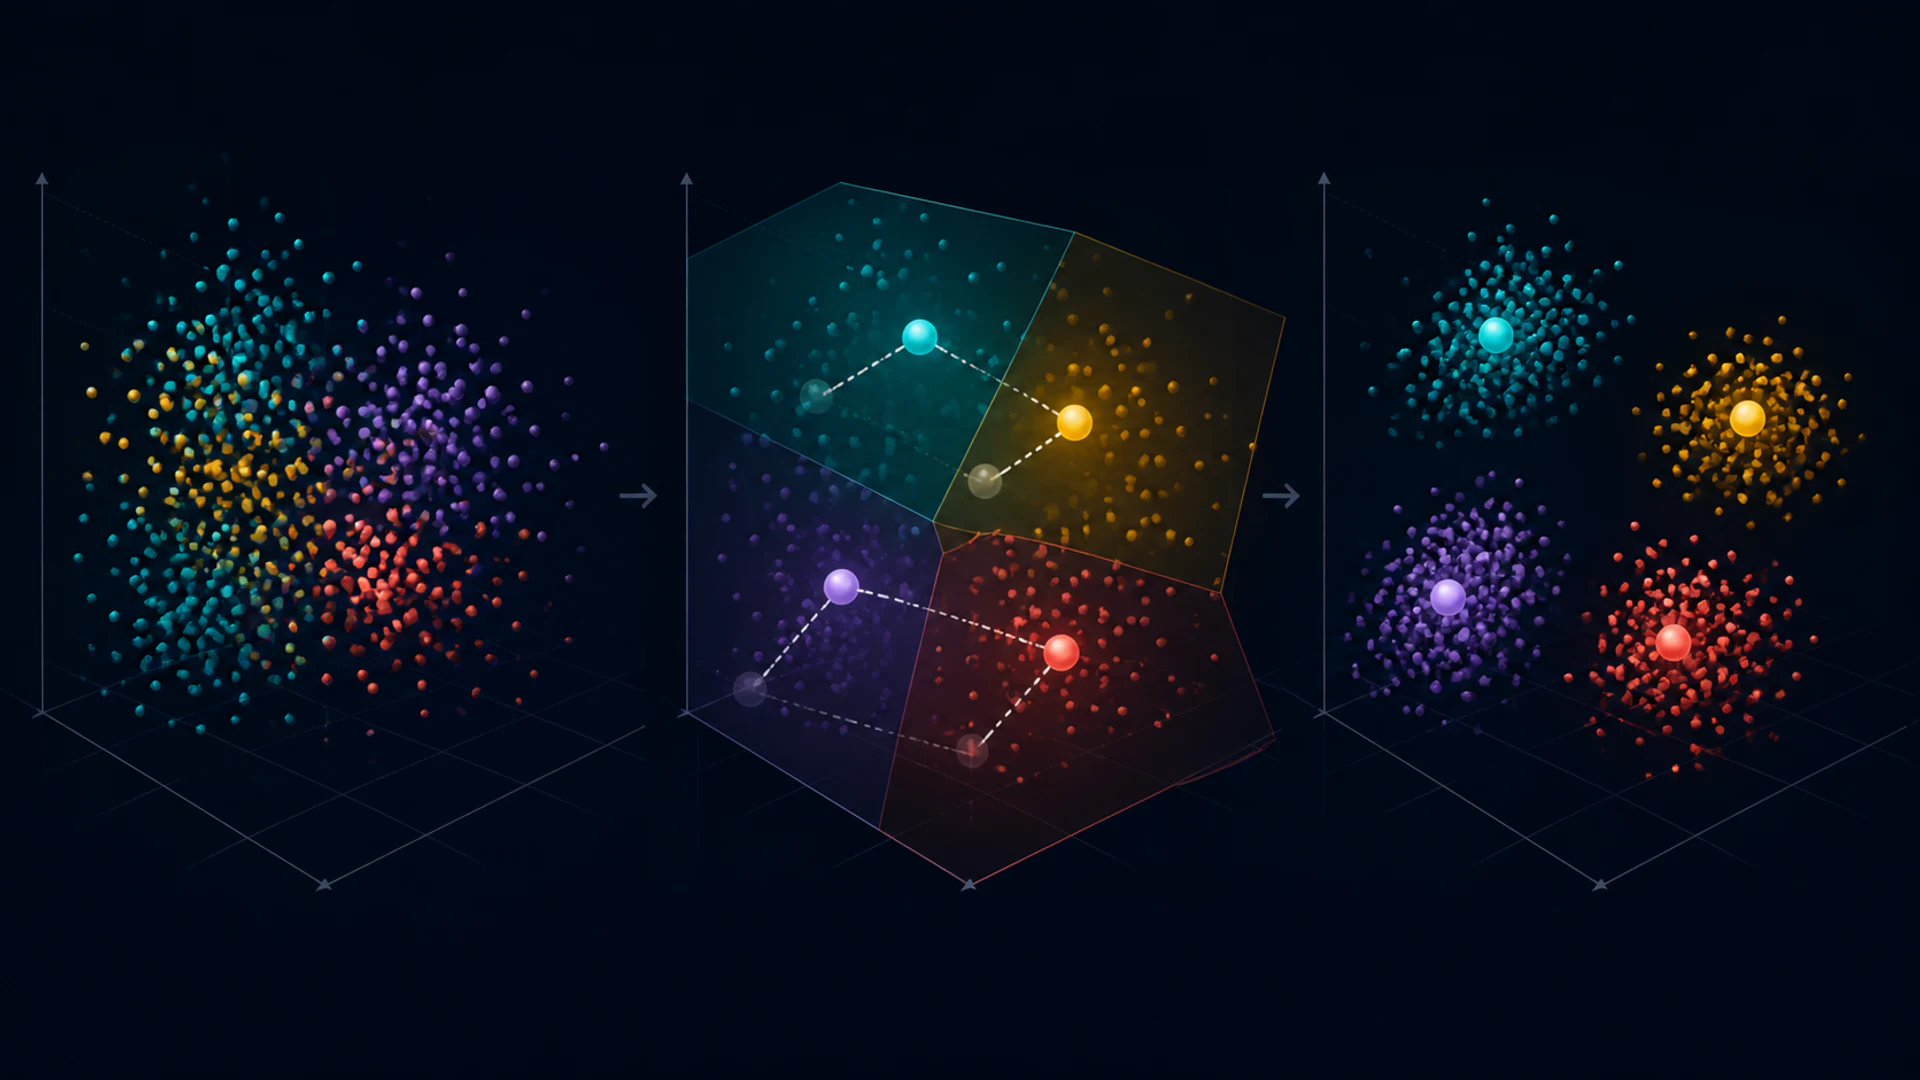
K-means เป็นอัลกอริทึมแบบไม่มีผู้สอนที่แบ่งการสังเกตเชิงตัวเลขออกเป็นคลัสเตอร์ k กลุ่ม โดยสลับระหว่างการกำหนดแต่ละจุดให้กับศูนย์กลางที่ใกล้ที่สุดและการคำนวณศูนย์กลางใหม่เป็นค่าเฉลี่ยของจุดที่ถูกกำหนดให้
อัลกอริทึมนี้ทำงานเร็วและมีประโยชน์ แต่ผลลัพธ์จะได้รับอิทธิพลจากการสเกล, ระยะทาง, วิธีการเริ่มต้นและค่า k ที่เลือก คลัสเตอร์เป็นการแบ่งเชิงคณิตศาสตร์ ไม่ได้หมายความว่าจะตรงกับประเภทในโลกจริงโดยอัตโนมัติ
ประเด็นสำคัญ
- K-means ลดระยะทางยูคลิดสแควร์ภายในคลัสเตอร์ไปยังศูนย์กลางให้เหลือน้อยที่สุด
- การเริ่มต้นมีความสำคัญ; k-means++ กระจายศูนย์กลางเริ่มต้นและมักทำให้ผลลัพธ์ดีขึ้น
- ควรทำมาตรฐานให้คุณลักษณะเมื่อหน่วยหรือสเกลของมันควรมีอิทธิพลเท่าเทียมกัน
- K-means มีปัญหาในการจัดการกับค่าผิดปกติ, คลัสเตอร์ที่ไม่เป็นทรงกลม, ความหนาแน่นที่ไม่เท่ากันและข้อมูลเชิงประเภท
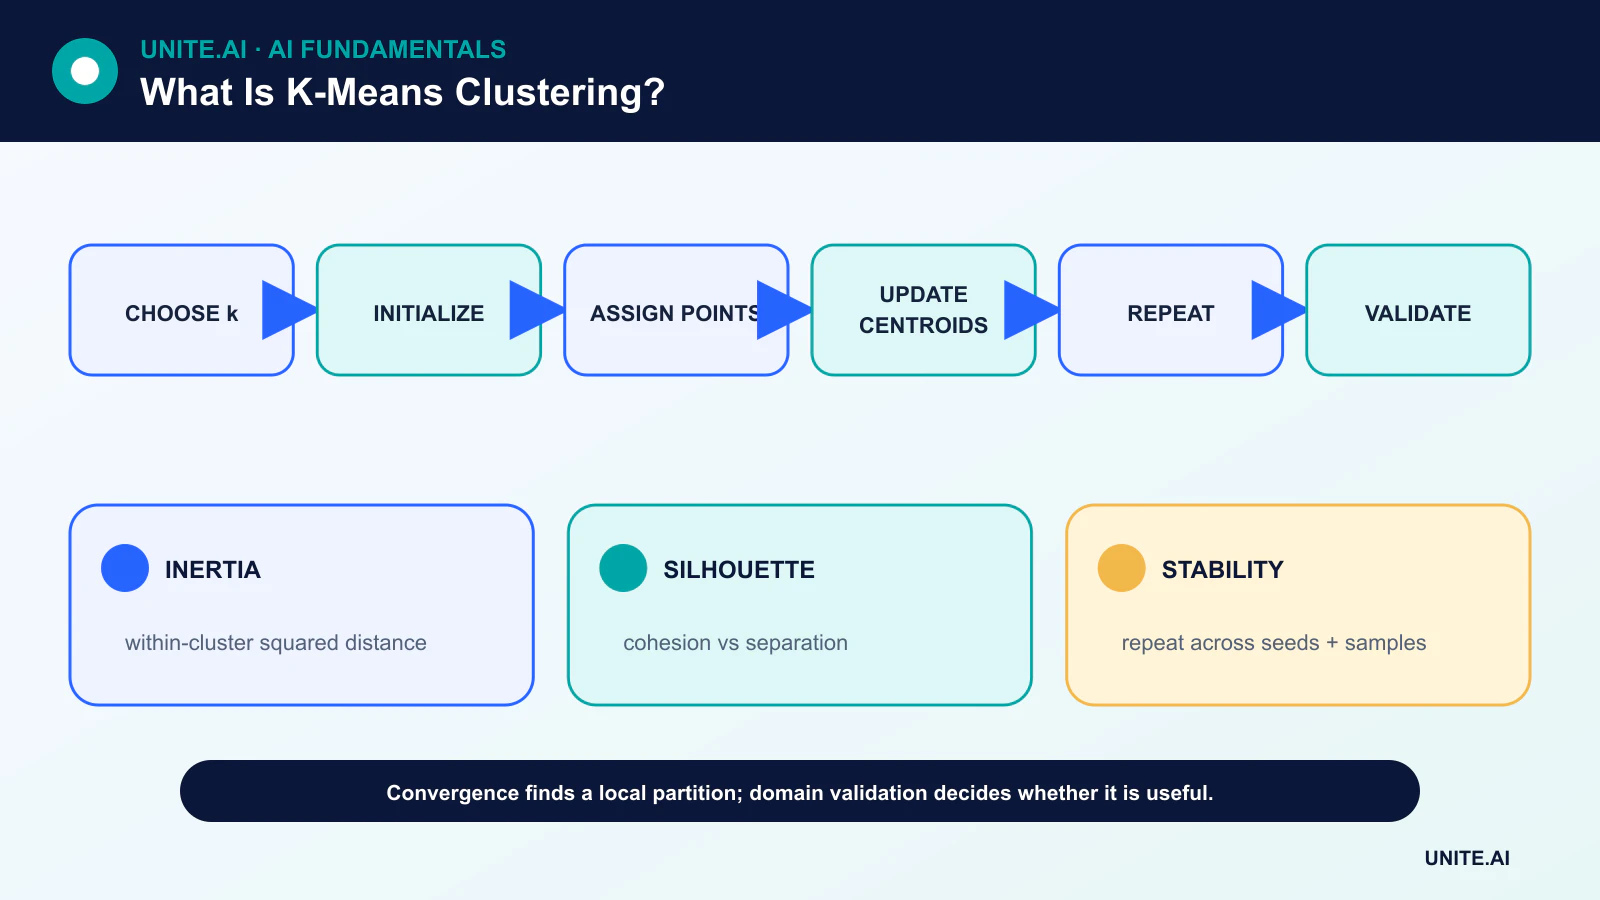
วัตถุประสงค์และลูปการอัปเดต
เมื่อมีศูนย์กลาง k จุด ขั้นตอนการกำหนดจะส่งการสังเกตแต่ละรายการไปยังศูนย์กลางที่ใกล้ที่สุด ขั้นตอนการอัปเดตจะเปลี่ยนศูนย์กลางแต่ละจุดเป็นค่าเฉลี่ยของการสังเกตที่ถูกกำหนดให้ ภายในคลัสเตอร์ ผลรวมสแควร์ไม่สามารถเพิ่มขึ้นได้ภายใต้ขั้นตอนเหล่านี้ ดังนั้นกระบวนการจะบรรจบสู่ค่าที่เหมาะสมในระดับท้องถิ่น
การบรรจบกันไม่ได้รับประกันว่าจะได้ค่าที่เหมาะสมระดับโลก ศูนย์กลางเริ่มต้นที่แตกต่างกันอาจทำให้ได้การแบ่งที่ต่างกัน นั่นเป็นเหตุผลที่การทำงานหลายครั้งจะเริ่มต้นหลายครั้งและเก็บผลลัพธ์ที่มีค่า inertia ต่ำที่สุด
การเริ่มต้นและ k-means++
การเลือกศูนย์กลางเริ่มต้นทั้งหมดแบบสุ่มจากพื้นที่หนาแน่นเดียวอาจทำให้ได้ผลลัพธ์แย่หรือการบรรจบช้า k-means++ จะเลือกจุดเริ่มต้นโดยอิงความน่าจะเป็นที่สัมพันธ์กับระยะทางจากจุดเริ่มต้นที่มีอยู่แล้ว เพื่อกระตุ้นให้ครอบคลุมชุดข้อมูลได้ดีขึ้น
การรันหลายครั้งยังคงมีประโยชน์ ควรบันทึกค่า seed แบบสุ่มและจำนวนการเริ่มต้นเพื่อให้ผลลัพธ์สามารถทำซ้ำได้
การสเกลและระยะทาง
ระยะทางยูคลิดสแควร์ทำให้ K-means มีความอ่อนไหวต่อหน่วยต่าง ๆ คุณลักษณะที่วัดเป็นพันอาจครอบงำคุณลักษณะที่วัดระหว่างศูนย์ถึงหนึ่ง การทำมาตรฐานเป็นวิธีทั่วไป แต่ควรใช้ความรู้ด้านโดเมนเพื่อตัดสินว่าความแปรปรวนที่เท่ากันหลังทำมาตรฐานหมายถึงความสำคัญที่เท่ากันหรือไม่
ค่าผิดปกติอาจดึงค่าเฉลี่ยให้ห่างจากจุดทั่วไป การสเกลแบบทนทาน, การตัดส่วน หรือวิธีที่อิงเมดอยด์อาจเหมาะกว่า คุณลักษณะเชิงประเภทแบบ one‑hot สร้างรูปแบบระยะทางที่อาจไม่สอดคล้องกับความคล้ายคลึงของประเภท
การเลือก k และการตรวจสอบคลัสเตอร์
ค่า inertia จะลดลงเมื่อ k เพิ่มขึ้น ดังนั้นจึงไม่สามารถใช้ค่า inertia เพียงอย่างเดียวเพื่อเลือก k ได้ วิธี elbow จะมองหาการปรับปรุงที่ลดลงเรื่อย ๆ การวิเคราะห์ silhouette จะเปรียบเทียบความหนาแน่นและการแยกกัน ความเสถียรระหว่างตัวอย่างและ seed เพิ่มการตรวจสอบอีกขั้นตอนหนึ่ง
การตรวจสอบที่แข็งแกร่งที่สุดคือความเป็นประโยชน์ต่อโดเมนที่ตั้งใจไว้ เปรียบเทียบคลัสเตอร์กับผลลัพธ์ที่ทราบ, การตรวจสอบจากผู้เชี่ยวชาญ หรือภารกิจต่อเนื่องโดยไม่ทำให้ดูเหมือนว่าป้ายหลังการทำได้ถูกค้นพบอย่างเป็นวัตถุประสงค์
ข้อจำกัดและทางเลือก
K-means ชอบกลุ่มที่กระชับและโดยประมาณเป็นทรงกลมที่มีสเกลคล้ายกัน โมเดลการผสม Gaussian แสดงส่วนประกอบเชิงความน่าจะเป็นแบบรี; วิธีแบบ DBSCAN จะระบุพื้นที่หนาแน่นและสัญญาณรบกวน; การจัดกลุ่มแบบลำดับชั้นสร้างต้นไม้ของการรวมกลุ่ม
การลดมิติ สามารถเพิ่มความเร็วหรือทำความสะอาดข้อมูลเข้าได้ แต่การฝึกบนชุดข้อมูลเต็มอาจเปลี่ยนคำถามการตรวจสอบ การทำ Mini‑batch K‑means ลดการคำนวณสำหรับชุดข้อมูลขนาดใหญ่โดยแลกกับการอัปเดตโดยประมาณ
วัตถุประสงค์, การเริ่มต้น, และการบรรจบ
K-means แบ่งการสังเกตเชิงตัวเลขเป็น k คลัสเตอร์โดยการลดระยะทางยูคลิดสแควร์ภายในคลัสเตอร์ไปยังศูนย์กลาง Lloyd’s algorithm สลับการกำหนดแต่ละจุดให้กับศูนย์กลางที่ใกล้ที่สุดและคำนวณศูนย์กลางใหม่จนกว่าการกำหนดหรือวัตถุประสงค์จะคงที่ มันบรรจบสู่ค่าที่เหมาะสมในระดับท้องถิ่น ไม่ได้หมายความว่าจะเป็นค่าที่ดีที่สุดระดับโลก การเริ่มต้นด้วย K‑means++ กระจายศูนย์กลางเริ่มต้นและมักทำให้ผลลัพธ์ดีขึ้น แต่การใช้ seed หลายค่仍สำคัญ ควรทำมาตรฐานให้คุณลักษณะเมื่อหน่วยควรมีอิทธิพลเท่าเทียมกัน เนื่องจากระยะทางสแควร์ทำให้ตัวแปรที่มีสเกลสูงและค่าผิดปกติมีอิทธิพลมากขึ้น
วิธีนี้สมมติว่าคลัสเตอร์เป็นกระชับ, รูปร่างทรงกลม, และสเกลคล้ายกันภายใต้เรขาคณิตยูคลิด มันมีปัญหาในการจัดการกับโครงสร้างที่ยืดออก, ความหนาแน่นที่ไม่เท่ากัน, ข้อมูลเชิงประเภท, ค่าผิดปกติมาก, และโครงสร้างซ้อนกัน คลัสเตอร์ที่ว่างเปล่าและจุดซ้ำต้องมีการจัดการที่กำหนดไว้ Mini‑batch k‑means สามารถขยายขนาดให้กับข้อมูลจำนวนมากโดยแลกกับการประมาณค่า สำหรับข้อความที่กระจาย, k‑means แบบทรงกลมที่อิงโคไซน์อาจตรงกับทิศทางได้ดีกว่า ในขณะที่การผสม, วิธีความหนาแน่น, การจัดกลุ่มแบบลำดับชั้น, หรือ k‑medoids จะเข้ารหัสสมมติฐานอื่น ๆ
การเลือก k และการตรวจสอบความหมาย
กราฟ elbow, คะแนน silhouette, เกณฑ์ข้อมูลในโมเดลที่เกี่ยวข้อง, และความเสถียรสามารถให้ข้อมูลเกี่ยวกับ k ได้ แต่ไม่มีวิธีใดที่ค้นพบจำนวนที่ถูกต้องอย่างเอกลักษณ์ ความเป็นประโยชน์ต่อธุรกิจและการตีความโดเมนมีความสำคัญ ทำการฟิตใหม่บนหลายตัวอย่างและ seed, เปรียบเทียบการเคลื่อนที่ของศูนย์กลางและความสอดคล้องของการกำหนด, และตรวจสอบคลัสเตอร์บนผลลัพธ์อิสระที่ไม่ได้ใช้ในการสร้างคลัสเตอร์นั้น การฉายภาพสองมิติอาจทำให้การแยกแยะบิดเบือน ดังนั้นควรตรวจสอบระยะทางและตัวอย่างในพื้นที่การแทนค่าต้นฉบับหรือที่ตรวจสอบแล้ว
คลัสเตอร์เป็นกลุ่มเชิงอธิบายที่สร้างจากคุณลักษณะและเมตริกที่เลือก; พวกมันไม่ใช่ประเภทตามธรรมชาติหรือส่วนที่มีสาเหตุ โปรไฟล์ที่อิงจากตัวแปรเดียวกับที่ใช้ในการจัดกลุ่มอาจเป็นวงจร ใช้คุณลักษณะที่แยกออกและการตรวจสอบเชิงคุณภาพ, และตรวจสอบว่าคลัสเตอร์ส่วนใหญ่ทำซ้ำภูมิศาสตร์, แหล่งข้อมูล, หรือลักษณะที่ละเอียดอ่อนหรือไม่ คลัสเตอร์ขนาดเล็กอาจเป็นความผิดปกติหรือศิลปะการสร้าง ชื่อคลัสเตอร์ไม่ได้ทำให้สมาชิกทุกคนตรงกับป้ายชื่อ
การใช้งานและการบำรุงรักษา
เก็บข้อมูลการสเกล, ลำดับคุณลักษณะ, ศูนย์กลาง, นิยามระยะทาง, และป้ายคลัสเตอร์ไว้ด้วยกัน สำหรับจุดใหม่ ให้ตรวจสอบระยะทางไปยังศูนย์กลางที่กำหนดและสัดส่วนที่อยู่นอกขอบเขตการฝึก; ให้สถานะไม่ทราบแทนการบังคับให้ทุกกรณีเข้าสู่คลัสเตอร์ ติดตามขนาดคลัสเตอร์, ศูนย์กลาง, และความเกี่ยวข้องของผลลัพธ์ตามเวลา การฝึกใหม่จะเปลี่ยนตัวตนของคลัสเตอร์ ดังนั้นควรทำแผนที่หรือเวอร์ชันกฎต่อเนื่องแทนการใช้ชื่อเก่าโดยเงียบ ๆ K‑means เป็นฐานการบีบอัดและการแบ่งส่วนที่มีประโยชน์เมื่อเรขาคณิตของมันตรงกับคำถาม ไม่ใช่เครื่องมือค้นหาแบบสากล
ตัวอย่างการทำงาน: การแบ่งส่วนลูกค้าด้วย k-means
บริษัทบริการสมัครสมาชิกทำมาตรฐานให้กับคุณลักษณะการใช้บริการในช่วงเวลาที่กำหนด, ลบตัวระบุบัญชี, และทดสอบค่า k ผ่านหลาย seed ความเสถียร, silhouette, และผลลัพธ์ทางธุรกิจที่แยกออกมาถูกตรวจสอบ, แต่ทีมผลิตภัณฑ์ยังตรวจสอบบัญชีตัวอย่างและขอบเขต พวกเขาพบว่าคลัสเตอร์หนึ่งเป็นเพียงลูกค้าใหม่ที่มีระยะเวลาการสังเกตสั้น ดังนั้นอายุการเป็นสมาชิกจึงถูกจัดการอย่างชัดเจน K‑means ถูกเปรียบเทียบกับวิธีเชิงลำดับชั้นและแบบอิงความหนาแน่นแทนการสันนิษฐานว่าเหมาะสม การฝึกนี้ถือเป็น การเรียนรู้แบบไม่มีผู้สอน ไม่ใช่การค้นหาป้ายชื่อ
ส่วนย่อยเหล่านี้เป็นแนวทางสำหรับการวิจัยและการทดลองข้อความ ไม่ได้ใช้กำหนดสิทธิ์หรือราคา บัญชีใหม่ที่ห่างจากศูนย์กลางทั้งหมดจะได้รับการกำหนดเป็นไม่ทราบ การสเกล, คุณลักษณะ, ศูนย์กลาง, และชื่อจะมีการเวอร์ชัน, และการฝึกใหม่จะทำแผนที่คลัสเตอร์ใหม่ไปยังคลัสเตอร์เก่าเฉพาะเมื่อมีหลักฐาน การตรวจสอบติดตามขนาดคลัสเตอร์, ระยะทาง, และความเกี่ยวข้องของผลลัพธ์ คุณลักษณะที่ละเอียดอ่อนและตัวแทนจะได้รับการตรวจสอบ, และทีมหลีกเลี่ยงการอธิบายคลัสเตอร์ว่าเป็นประเภทบุคลิกภาพตามธรรมชาติเมื่อมันเป็นการแบ่งเชิงคณิตศาสตร์ของพฤติกรรมที่เลือก
หลักฐานการใช้งานและความพร้อมในการปฏิบัติการ
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้ที่ตั้งใจ, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนขึ้นต่อ, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเต็มที่ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา เทเลเมตรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพส่วนขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
K-means เป็นแบบมีผู้สอนหรือไม่มีผู้สอน?
มันเป็นแบบไม่มีผู้สอนเพราะรับคุณลักษณะและจำนวนคลัสเตอร์ที่กำหนด, ไม่ได้รับป้ายเป้าหมาย
K-means จำแนกข้อมูลใหม่หรือไม่?
หลังจากฝึกโมเดลแล้ว จุดใหม่สามารถกำหนดให้กับศูนย์กลางที่ใกล้ที่สุด นั่นคือการกำหนดคลัสเตอร์ ไม่ได้หมายความว่าจะเป็นการทำนายคลาสแบบมีผู้สอน
อ้างอิงหลัก












