
พื้นฐาน AI
การตีความเชิงกลไกคืออะไร? วิธีที่นักวิจัยวิเคราะห์โมเดล AI

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การตีความเชิงกลไกศึกษาว่าส่วนประกอบที่เรียนรู้ภายในเครือข่ายประสาทเทียมสร้างพฤติกรรมอย่างมีสาเหตุอย่างไร แทนที่จะเพียงแค่หาความสัมพันธ์ระหว่างอินพุตและเอาต์พุต นักวิจัยจะตั้งสมมติฐานเกี่ยวกับฟีเจอร์, หัวข้อการให้ความสนใจ, นิวรอน, และวงจร แล้วทำการแทรกแซงเพื่อทดสอบสมมติฐานเหล่านั้น
สาขานี้ได้สร้างคำอธิบายอย่างละเอียดสำหรับพฤติกรรมที่เลือกในโมเดลขนาดเล็กและกลาง แต่การอธิบายอย่างครบถ้วนและเชื่อถือได้ของโมเดลระดับแนวหน้า仍ยังอยู่ไกลเกินเอื้อม คำอธิบายอัตโนมัติและการแสดงภาพที่น่าสนใจอาจเป็นจุดเริ่มต้นที่มีประโยชน์ แต่ไม่ใช่หลักฐานสุดท้าย
ประเด็นสำคัญ
- ฟีเจอร์เป็นรูปแบบที่ถูกแทน; วงจรเป็นส่วนประกอบที่ทำงานร่วมกันซึ่งถูกเสนอให้ดำเนินการคำนวณ
- การแพตช์การกระตุ้น, การตัดส่วน, และการติดตามเชิงสาเหตุทดสอบว่าตัวส่วนประกอบทำให้พฤติกรรมเปลี่ยนแปลงหรือไม่
- การซ้อนทับหมายถึงนิวรอนหนึ่งอาจมีส่วนร่วมในหลายฟีเจอร์; ตัวเข้ารหัสอัตโนมัติแบบกระจาย (sparse autoencoders) พยายามสร้างฐานฟีเจอร์ที่แตกต่าง
- วิธีการตีความต้องการข้อมูลจริง, การทดสอบที่สามารถหักล้างได้, ความครอบคลุม, และการประเมินเทียบกับคำอธิบายทางเลือก
จากการแทนค่าไปสู่กลไก
การสำรวจสอบถามว่าข้อมูลสามารถถอดรหัสจากการกระตุ้นได้หรือไม่ การอ้างอิงประมาณว่าข้อมูลเข้าใดหรือส่วนประกอบใดสำคัญ งานเชิงกลไกก้าวไกลกว่านั้นโดยเสนอการคำนวณภายในและตรวจสอบว่าการแทรกแซงทำให้พฤติกรรมระหว่างขั้นและขั้นสุดท้ายที่คาดหวังเปลี่ยนแปลงหรือไม่
สิ่งนี้ทำให้มันเกี่ยวข้องแต่แคบกว่า Explainable AI คำอธิบายภายหลังสำหรับการตัดสินใจหนึ่งไม่ได้หมายความว่าเป็นอัลกอริทึมที่ถูกวิศวกรรมย้อนกลับภายในโมเดล
วงจรและการแทรกแซงเชิงสาเหตุ
นักวิจัยอาจระบุหัวข้อการให้ความสนใจหรือฟีเจอร์ที่เชื่อมโยงกับงาน, ตัดส่วนนั้นออก, แพตช์การกระตุ้นจากการรันอื่น, หรือสืบค้นว่าข้อมูลเคลื่อนที่ผ่านชั้นอย่างไร สมมติฐานที่ดีจะทำนายพฤติกรรมในตัวอย่างใหม่และยังคงอยู่ภายใต้การควบคุม
การแทรกแซงอาจสร้างสถานะที่อยู่นอกการกระจาย, ดังนั้นการเปลี่ยนแปลงพฤติกรรมไม่ได้บ่งบอกการคำนวณตามธรรมชาติโดยอัตโนมัติ ใช้วิธีหลายอย่าง, การควบคุมที่ตรงกัน, และผลเชิงปริมาณแทนการใช้พรอมต์ตัวอย่างเดียว
การซ้อนทับและฟีเจอร์แบบกระจาย
เครือข่ายประสาทเทียมสามารถแทนฟีเจอร์ได้มากกว่ามิติแต่ละตัวโดยการซ้อนทับ ดังนั้นนิวรอนอาจกระตุ้นต่อหลายรูปแบบที่ไม่เกี่ยวข้อง ทำให้ป้ายระดับนิวรอนอาจทำให้เข้าใจผิด
ตัวเข้ารหัสอัตโนมัติแบบกระจายเรียนพจนานุกรมฟีเจอร์ที่ใหญ่ขึ้นจากการกระตุ้นของโมเดล พวกมันสามารถทำให้รูปแบบแยกกันได้ชัดเจนขึ้น แต่ความกระจายที่เลือก, ข้อมูลการฝึก, ความผิดพลาดการสร้างใหม่, และป้ายอัตโนมัติมีผลต่อสิ่งที่ได้กลับมา ฟีเจอร์ของเครือข่ายประสาทเทียม ยังต้องการการตรวจสอบเชิงสาเหตุ
ความปลอดภัย, การดีบัก, และข้อจำกัด
เครื่องมือเชิงกลไกอาจช่วยค้นหาข้อเท็จจริงที่จำไว้, ความลำเอียง, กลยุทธ์หลอกลวง, หรือวงจรที่ล้มเหลวและอาจสนับสนุนการแก้ไขหรือการเฝ้าติดตาม เครื่องมือเดียวกันอาจพลาดการคำนวณที่กระจาย, หายาก, หรือขึ้นกับบริบท
ให้พิจารณาผลการค้นหาเป็นหลักฐานที่มีขอบเขต: รุ่นของโมเดล, งาน, ชุดข้อมูล, ชั้น, การแทรกแซง, ผลกระทบ, และความไม่แน่นอน เชื่อมการตีความกับการประเมินพฤติกรรม, การทดสอบแบบ red‑team, และการกำกับดูแล Responsible AI แทนการใช้เป็นใบรับรองความปลอดภัยทั่วๆ ไป
การแทนค่า, วงจร, และหลักฐานเชิงสาเหตุ
การตีความเชิงกลไกศึกษาว่าการคำนวณภายในทำให้โมเดลแสดงพฤติกรรมอย่างไร นักวิจัยตรวจสอบการกระตุ้น, น้ำหนัก, การให้ความสนใจ, และฟีเจอร์ระหว่างขั้น จากนั้นตั้งสมมติฐานเกี่ยวกับการแทนค่าและวงจร การแทนค่าไม่ได้จำเป็นต้องเก็บไว้ในนิวรอนเดียว; มันอาจกระจายทั่วทิศทาง, ชั้น, โทเคน, และการผสมที่ขึ้นกับบริบท
ตัวเข้ารหัสอัตโนมัติแบบกระจายพยายามแยกการกระตุ้นที่หนาแน่นเป็นชุดฟีเจอร์ที่ใหญ่ขึ้นซึ่งกระตุ้นอย่างเลือกสรร ป้ายฟีเจอร์เป็นการตีความของมนุษย์ต่อตัวอย่างที่สังเกต ไม่ใช่ความจริงพื้นฐาน ความผิดพลาดการสร้างใหม่, ความกระจาย, การแยกฟีเจอร์, การดูดซับ, และฟีเจอร์ที่ตายไป มีผลต่อสิ่งที่การแยกส่วนเปิดเผยและสิ่งที่พลาด
ความสัมพันธ์ไม่เพียงพอสำหรับข้ออ้างเชิงกลไก การแพตช์การกระตุ้น, การตัดส่วน, การติดตามเชิงสาเหตุ, การควบคุมทิศทาง, และการแทรกแซงน้ำหนักแบบเจาะจงทดสอบว่าตัวส่วนเปลี่ยนพฤติกรรมตามที่คาดหรือไม่ การแทรกแซงอาจสร้างสถานะที่อยู่นอกการกระจาย ดังนั้นผลลัพธ์ต้องมีการควบคุม, การวิเคราะห์ปริมาณ‑ผลตอบแทน, คำอธิบายทางเลือก, และการทำซ้ำในหลายพรอมต์และหลายโมเดล
กระบวนการทำงานตีความอย่างเข้มงวด
เริ่มด้วยพฤติกรรมที่วัดได้อย่างแม่นยำและชุดข้อมูลที่แยกสมมติฐานที่แข่งขันกันออกได้ ระบุตำแหน่งชั้น, ตำแหน่ง, ส่วนประกอบ, หรือฟีเจอร์ที่เกี่ยวข้อง; ตรวจสอบกลไกที่เป็นไปได้; แทรกแซง; และทดสอบว่าวงจรที่เสนอทำนายกรณีใหม่ได้หรือไม่ แยกตัวอย่างสำรวจออกจากการประเมินยืนยันเพื่อลดอคติการเลือก
เครื่องมืออัตโนมัติสามารถจัดอันดับนิวรอน, ฟีเจอร์, หัวข้อ, หรือเส้นทาง, ในขณะที่โมเดลภาษาอาจเสนอคำอธิบาย การทำอัตโนมัติเพิ่มความครอบคลุมแต่ก็อาจสร้างเรื่องราวที่ดูสมเหตุสมผลได้ ให้คะแนนคำอธิบายบนตัวอย่างการกระตุ้นที่แยกออกและการทำนายเชิงสาเหตุ บันทึกความไม่แน่นอน, และทำให้ผลลัพธ์สามารถทำซ้ำได้ด้วยรุ่นโมเดล, ตัวแปลงโทเคน, พรอมต์, และโค้ด
กลไกอาจมีหลายความหมาย, ซ้ำซ้อน, ไม่เชิงเส้น, และกระจาย การลบส่วนประกอบหนึ่งอาจถูกชดเชยโดยส่วนอื่น, ในขณะที่ฟีเจอร์อาจมีส่วนร่วมในหลายพฤติกรรม ผลลัพธ์เชิงลบให้ข้อมูลที่เป็นประโยชน์: วงจรที่ดูเหมือนล้มเหลวนอกตัวอย่างที่คัดสรรควรถูกจำกัดหรือปฏิเสธแทนการพยายามช่วยเหลือด้วยคำอธิบายที่ค่อยๆ ไม่ชัดเจนขึ้น
การประยุกต์ใช้, ข้อจำกัด, และข้ออ้างด้านความปลอดภัย
การตีความอาจช่วยดีบักอาการหลอน, ความลำเอียง, การจำ, พฤติกรรมการหลบหนี, หรือการทั่วไปที่ไม่คาดคิด; เปรียบเทียบโมเดล; และสร้างสมมติฐานทางวิทยาศาสตร์ นอกจากนี้ยังสามารถระบุฟีเจอร์สำหรับการเฝ้าติดตามหรือการแทรกแซง การใช้งานเหล่านี้ต้องการการตรวจสอบตามงานเฉพาะ เนื่องจากการแสดงภาพการวิจัยที่เป็นประโยชน์ไม่ได้หมายความว่าจะเป็นการควบคุมการผลิตที่เชื่อถือได้โดยอัตโนมัติ
การไม่มีฟีเจอร์ที่ตรวจพบไม่ได้พิสูจน์ว่าความสามารถหรือเจตนานั้นไม่มีอยู่, และฟีเจอร์ที่อ่านได้ไม่ได้พิสูจน์ว่าโมเดลใช้มันในคำตอบที่กำหนด เครื่องมือสังเกตการฉายของการคำนวณที่มีการครอบคลุมจำกัด ข้ออ้างด้านความปลอดภัยต้องระบุความไวต่อการตรวจจับ, ผลบวกเท็จ, การกระจาย, ผู้คุกคาม, และจุดบอดที่ทราบ
ใช้การตีความร่วมกับการประเมินพฤติกรรม, การทดสอบแบบ red‑team, การกำกับดูแลข้อมูล, การควบคุมการเข้าถึง, การเฝ้าติดตาม, และการตอบสนองต่อเหตุการณ์ เผยแพร่วิธีการและตัวอย่างตรงข้ามเมื่อทำได้ สาขานี้กำลังพัฒนาอย่างรวดเร็ว แต่เทคนิคในปัจจุบันยังไม่สามารถให้คำอธิบายที่ครบถ้วนและเชื่อถือได้ของการให้เหตุผลของโมเดลระดับแนวหน้า หรือการรับประกันโดยทั่วไปเกี่ยวกับการสอดคล้อง
ตัวอย่างทำงาน: การทดสอบวงจรโมเดลที่เสนอ
สมมติว่าโมเดลดูเหมือนใช้ชุดหัวข้อการให้ความสนใจและฟีเจอร์เพื่อแก้ไขวัตถุโดยอ้อมในประโยค นักวิจัยกำหนดชุดข้อมูลที่ควบคุมโดยมีชื่อ, ตำแหน่ง, สิ่งรบกวน, และตัวอย่างตรงข้ามที่หลากหลาย, จากนั้นวัดพฤติกรรม การตรวจสอบการกระตุ้นระบุตัวส่วนประกอบที่เป็นไปได้, แต่สมมติฐานถูกเขียนก่อนการแทรกแซง: ข้อมูลใดที่แต่ละส่วนประกอบบรรทุก, มันเคลื่อนที่ไปที่ไหน, และการเปลี่ยนแปลงจะทำให้ผลลัพธ์เปลี่ยนอย่างไร
การแพตช์การกระตุ้นและการตัดส่วนทดสอบความจำเป็นและความเพียงพอในตัวอย่างที่แยกออก การแก้ไขที่เจาะจงซึ่งเปลี่ยนโทเคนที่คาดการณ์ในทิศทางที่คาดหวังสนับสนุนกลไก; การเสียประสิทธิภาพอย่างกว้างไม่ทำเช่นนั้น การควบคุมแพตช์ตำแหน่งและส่วนประกอบที่ไม่เกี่ยวข้อง, ปรับระดับการแทรกแซง, และเปรียบเทียบวงจรทางเลือก ทีมเผยกรณีลบที่คำอธิบายล้มเหลวและหลีกเลี่ยงการกำหนดวัตถุประสงค์ที่มนุษย์อ่านได้จากความสัมพันธ์เพียงอย่างเดียว
เพื่ออ้างว่ามีการประยุกต์ใช้ด้านความปลอดภัย วิธีการต้องตรวจจับพฤติกรรมที่เกี่ยวข้องด้วยความไวที่ทราบภายใต้พรอมต์ที่เป็นจริงและการปรับตัวของผู้โจมตี ตัวตรวจสอบฟีเจอร์ต้องได้รับการประเมินผลสำหรับผลบวกเท็จ, การหลบหลีก, การอัปเดตโมเดล, และความเกี่ยวข้องเชิงสาเหตุ หลักฐานการตีความสามารถชี้นำการดีบักและการทดสอบต่อไป, แต่การบังคับใช้ยังคงอยู่ในการควบคุมภายนอกและการเฝ้าติดตามพฤติกรรม แผนภาพวงจรที่น่าสนใจเป็นสมมติฐานทางวิทยาศาสตร์พร้อมหลักฐาน—ไม่ใช่คำอธิบายที่ครบถ้วนของโมเดลหรือการรับประกันเกี่ยวกับพฤติกรรมที่ไม่เคยเห็น
รายการตรวจสอบการนำไปใช้เชิงปฏิบัติ
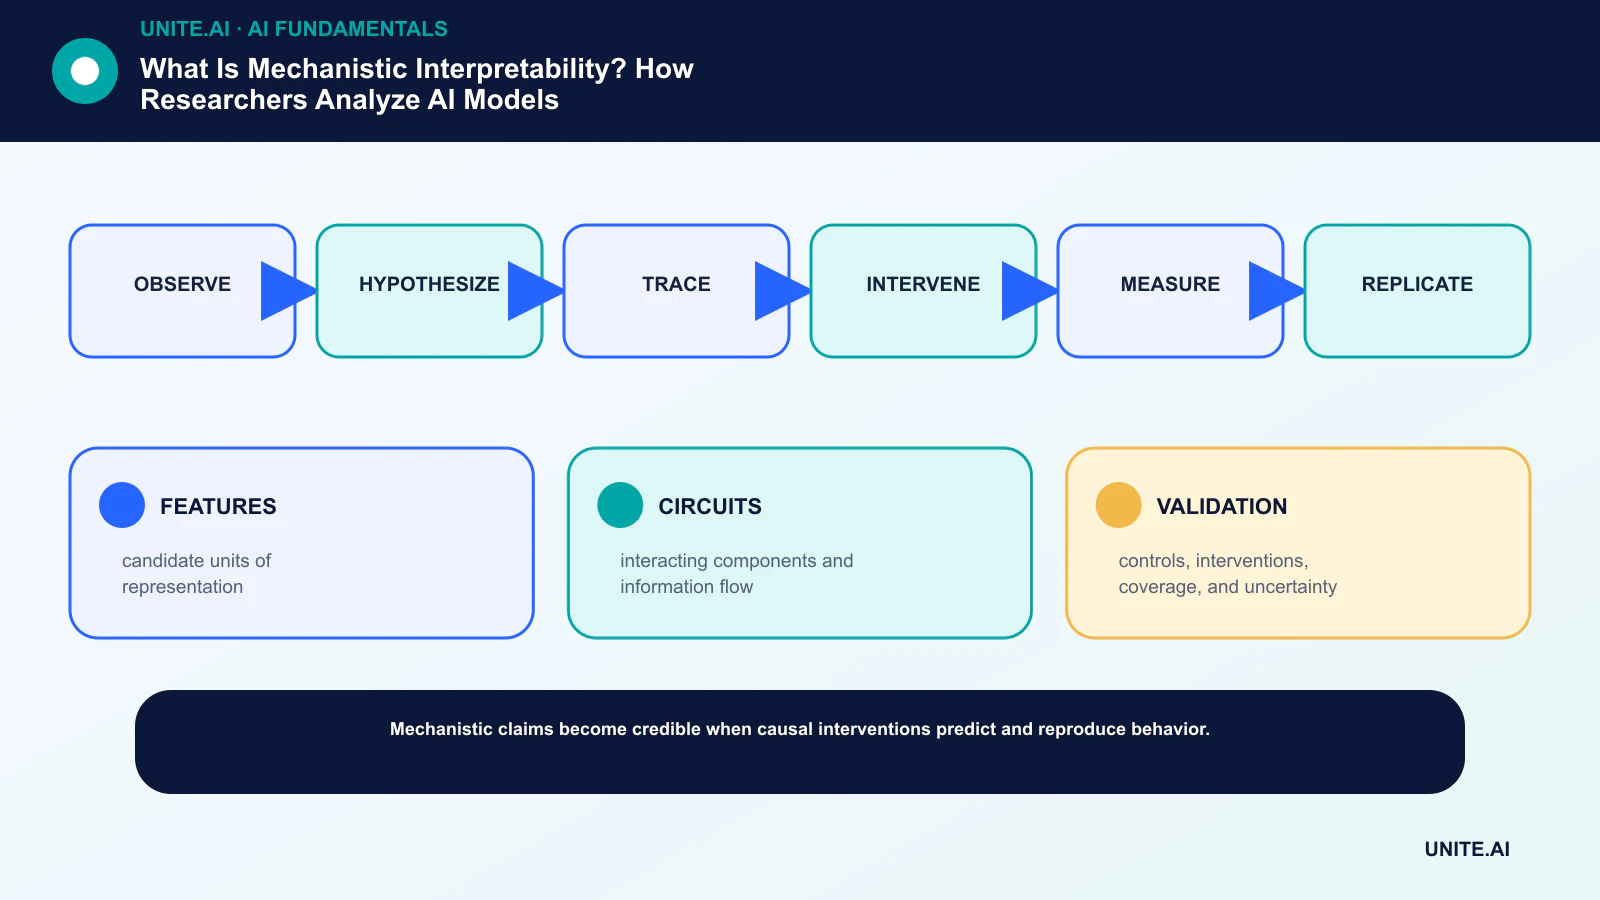
แปลงแนวคิดให้เป็นกระบวนการทำงานที่จำกัดและทดสอบได้: สังเกต → ตั้งสมมติฐาน → ติดตาม → แทรกแซง → วัดผล → ทำซ้ำ กำหนดเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้างฐานเปรียบเทียบง่าย, ตั้งเกณฑ์การยอมรับและหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการเฝ้าติดตาม, การย้อนกลับ, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจสิ่งที่เปลี่ยนแปลงได้
ก่อนเปิดใช้งาน ให้ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้ผิดวัตถุประสงค์; เก็บรักษาหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข กำหนดว่าใครสามารถอนุมัติการปล่อย, ปรับค่าเกณฑ์, ยกเลิกผลลัพธ์, หรือหยุดการทำงานได้อย่างไร พิจารณาตัดสินใจใหม่หลังจากข้อมูลจริงมาถึง, เนื่องจากการทดลองที่สำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- FEATURES: หน่วยการแทนค่าที่เป็นไปได้
- CIRCUITS: ส่วนประกอบที่ทำงานร่วมกันและการไหลของข้อมูล
- VALIDATION: การควบคุม, การแทรกแซง, ความครอบคลุม, และความไม่แน่นอน
คำถามที่พบบ่อย
การตีความเชิงกลไกเป็นเช่นเดียวกับการอ่านน้ำหนักของโมเดลหรือไม่?
ไม่ น้ำหนักดิบไม่ได้อธิบายตัวเอง นักวิจัยวิเคราะห์การกระตุ้น, ฟีเจอร์, ส่วนประกอบ, และการแทรกแซงเพื่อสร้างและทดสอบสมมติฐานเชิงสาเหตุ
ตัวเข้ารหัสอัตโนมัติแบบกระจราสามารถอธิบาย LLM ได้อย่างเต็มที่หรือไม่?
ไม่ พวกเขาให้ฐานฟีเจอร์ที่เป็นไปได้และสามารถสนับสนุนการวิเคราะห์วงจรได้ แต่ความครอบคลุม, ความเชื่อถือได้, การสร้างใหม่, การตั้งป้าย, และความสามารถขยายยังคงเป็นปัญหาเปิด
เอกสารอ้างอิงหลัก












