พื้นฐาน AI
RLHF คืออะไร? การเรียนรู้เสริมจากข้อเสนอแนะของมนุษย์ (RLHF)

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
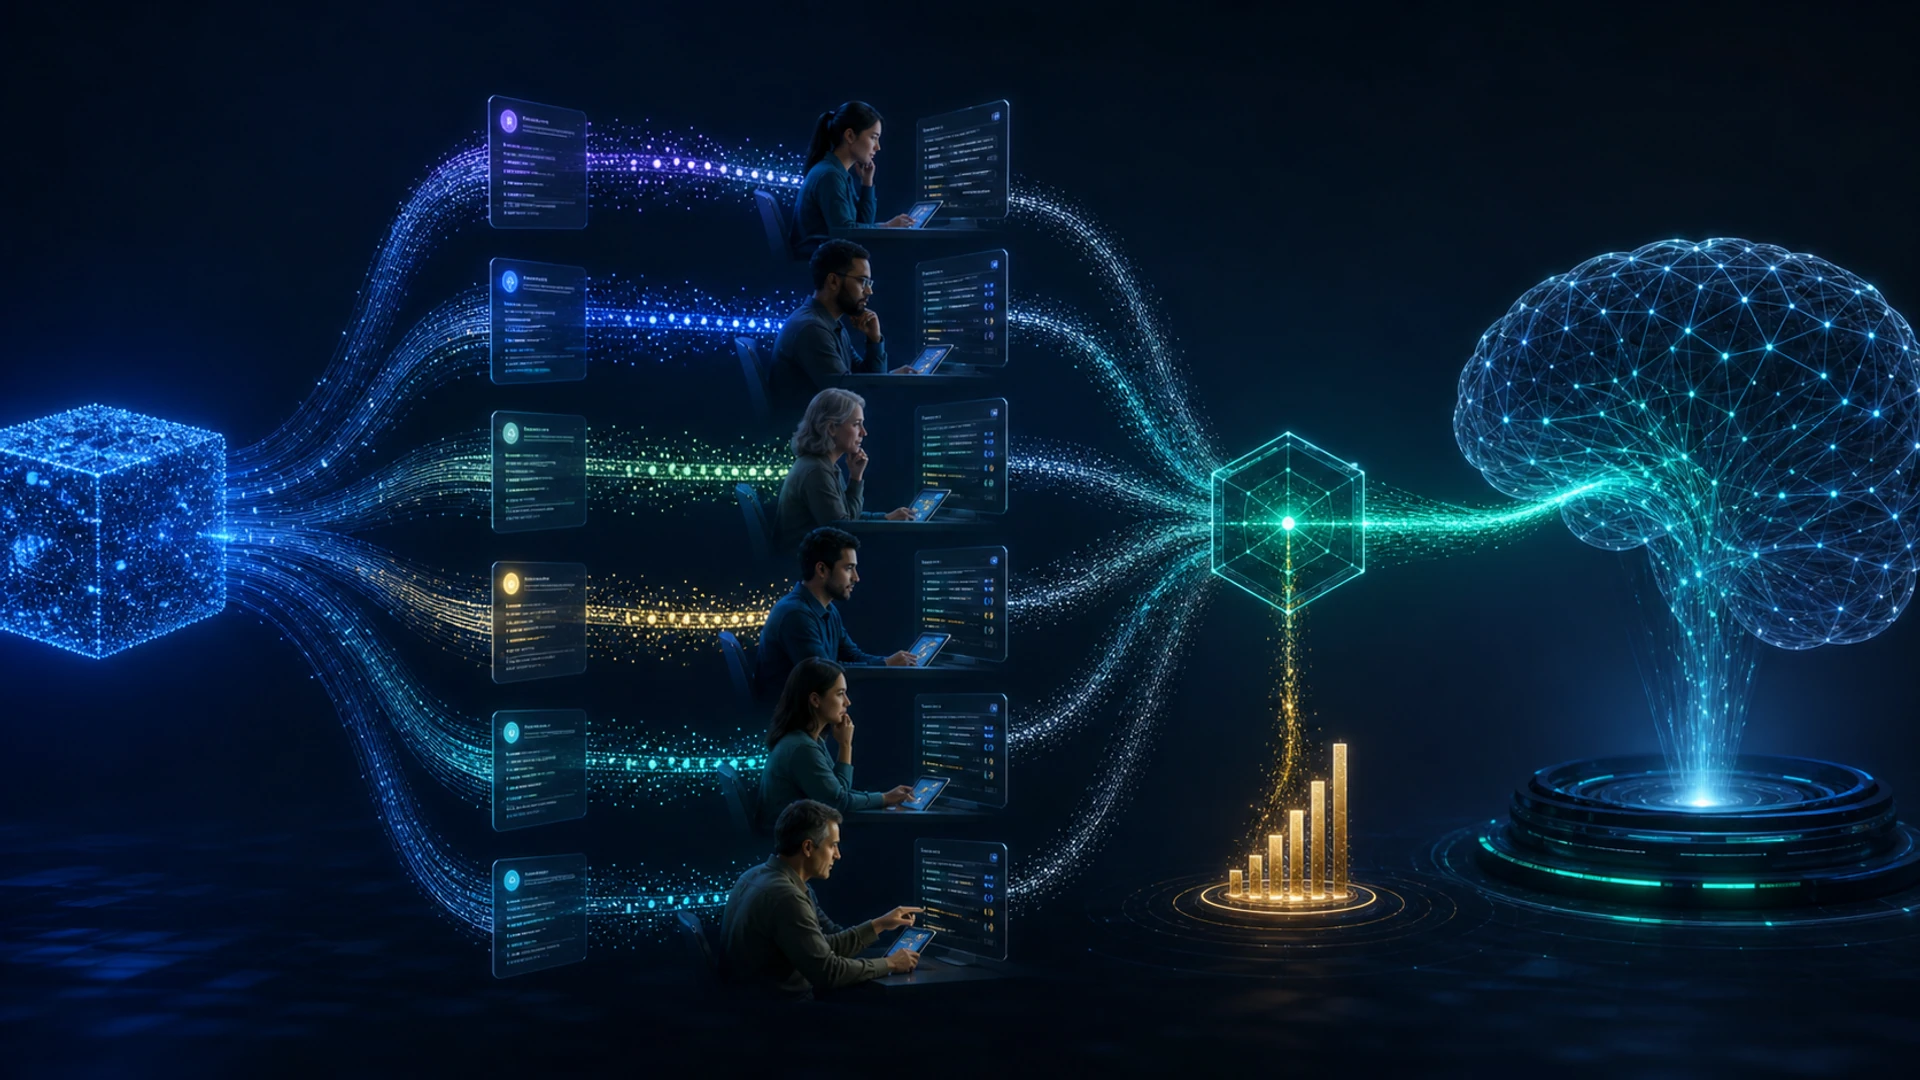
การเรียนรู้เสริมจากข้อเสนอแนะของมนุษย์ (RLHF) เป็นกลุ่มของวิธีการที่ใช้การตัดสินของมนุษย์เพื่อช่วยปรับโมเดลเมื่อพฤติกรรมที่ต้องการยากต่อการกำหนดด้วยรางวัลอัตโนมัติแบบง่าย สำหรับโมเดลภาษา ผู้คนมักเปรียบเทียบคำตอบที่เป็นไปได้และโมเดลความชอบที่เรียนรู้จะเปลี่ยนการเปรียบเทียบเหล่านั้นให้เป็นสัญญาณการฝึกฝน
RLHF สามารถทำให้โมเดลที่ผ่านการฝึกล่วงหน้ามีประโยชน์มากขึ้นหรือสอดคล้องกับนโยบายที่เขียนไว้ได้ดีขึ้น แต่ไม่ได้รับประกันความจริงหรือการสอดคล้องกับผู้ใช้ทุกคน ผลลัพธ์ขึ้นอยู่กับผู้ให้ข้อเสนอแนะ วิธีการสุ่มพรอมต์ สิ่งที่โมเดลรางวัลสามารถแสดงได้ และวิธีการจำกัดการเพิ่มประสิทธิภาพ
ประเด็นสำคัญ
- RLHF มักทำหลังจากการฝึกล่วงหน้าและการปรับแต่งด้วยคำสั่งที่มีการดูแล
- การให้ความชอบแบบคู่ช่วยฝึกโมเดลรางวัลหรือความชอบ; จากนั้นการเพิ่มประสิทธิภาพนโยบายจะให้ความสำคัญกับผลลัพธ์ที่ได้คะแนนสูงกว่า
- การแฮ็กรางวัล, ความขัดแย้งของผู้ให้คำอธิบาย, การเปลี่ยนแปลงการกระจาย, และการเพิ่มประสิทธิภาพเกินขอบเขตยังคงเป็นความเสี่ยงสำคัญ
- ประเมินนโยบายสุดท้ายโดยตรงเพื่อคุณภาพของงาน, ความปลอดภัย, การปรับเทียบ, และผลกระทบต่อกลุ่มย่อย
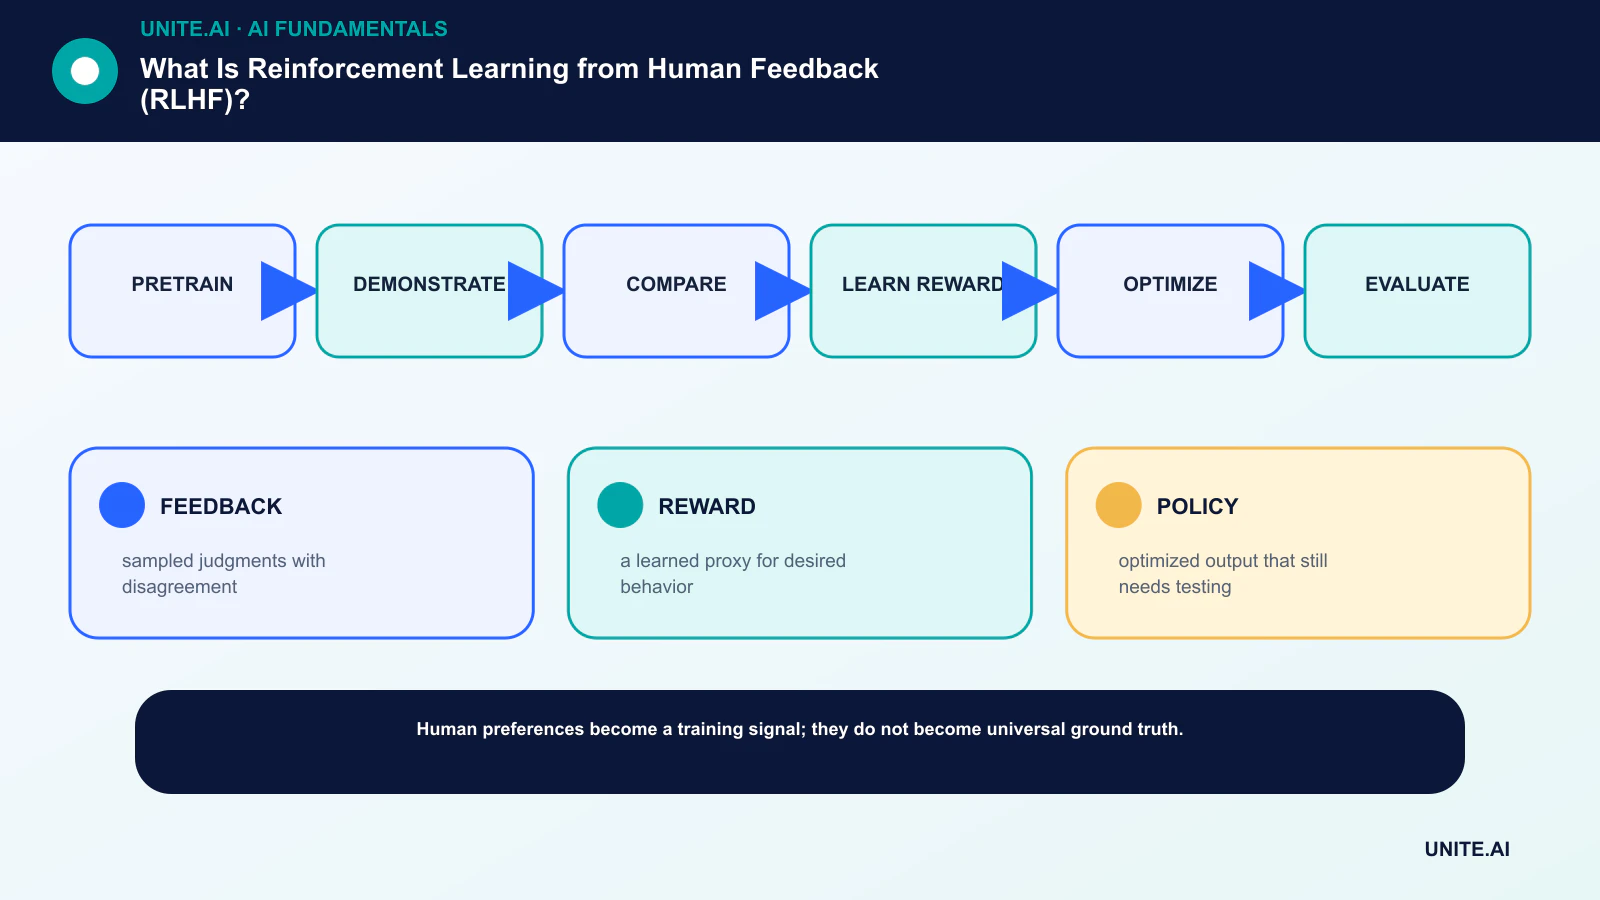
ขั้นตอนการทำงานทั่วไปของ RLHF
โมเดลภาษาเริ่มต้นด้วยการเรียนรู้โครงสร้างสถิติทั่วไปผ่านการฝึกล่วงหน้า จากนั้นการปรับแต่งด้วยการดูแลจะใช้ตัวอย่างของการตอบสนองที่ต้องการ สำหรับการรวบรวมความชอบ ผู้ให้คำอธิบายจะจัดอันดับหรือเลือกระหว่างผลลัพธ์ที่ได้จากพรอมต์เดียวกัน
โมเดลรางวัลจะเรียนรู้เพื่อทำนายการเปรียบเทียบเหล่านั้น อัลกอริทึมการเรียนรู้เสริมเช่น PPO สามารถเพิ่มประสิทธิภาพโมเดลภาษาให้สอดคล้องกับรางวัลที่เรียนรู้ได้ ในขณะที่การลงโทษจะป้องกันไม่ให้โมเดลเบี่ยงเบนไกลเกินกว่านโยบายอ้างอิง
ข้อเสนอแนะเป็นการวัดผล ไม่ใช่ความจริงพื้นฐาน
ผู้ให้คำอธิบายอาจไม่เห็นตรงกันเนื่องจากคำสั่งคลุมเครือ ความเชี่ยวชาญแตกต่างกัน หรือค่านิยมขัดแย้งกัน ตำแหน่ง, ความยาว, ความมั่นใจ, และสไตล์สามารถทำให้ความชอบมีอคติ โปรแกรมคุณภาพสูงจะฝึกผู้ให้คะแนน, วัดระดับความเห็นร่วม, ตรวจสอบตัวอย่าง, และรักษาความไม่แน่นอนไว้
การสุ่มตัวอย่างก็สำคัญเช่นกัน หากชุดความชอบละเว้นภาษาที่ยาก, ด้านหรือความเสียหายที่ซับซ้อน โมเดลรางวัลจะไม่สามารถกำกับได้อย่างเชื่อถือได้ ความเชี่ยวชาญด้านวิทยาศาสตร์ข้อมูลมีความสำคัญเทียบเท่ากับตัวเพิ่มประสิทธิภาพ
รูปแบบความล้มเหลว
นโยบายอาจใช้ประโยชน์จากจุดอ่อนของรางวัลที่เรียนรู้ ทำให้ได้ผลลัพธ์ที่ได้คะแนนสูงแม้ไม่สอดคล้องกับเจตนาพื้นฐาน การเพิ่มประสิทธิภาพเกินขอบเขตอาจทำให้ความหลากหลายลดลง, เน้นสไตล์ที่ต้องการ, หรือทำให้โมเดลตอบสนองอย่างมั่นใจแต่ไม่ตรงตามความต้องการ
โมเดลรางวัลเองอาจล้มเหลวเมื่อนอกการกระจายของข้อมูลการฝึก ทีมงานควรทดสอบพรอมต์เชิงศัตรู, งานข้อเท็จจริง, ขอบเขตการปฏิเสธ, การปรับเทียบ, และพฤติกรรมที่ระดับการเพิ่มประสิทธิภาพต่างกัน แทนที่จะพึ่งพาอัตราชนะความชอบรวมเพียงค่าเดียว
ทางเลือกและส่วนเสริม
Direct Preference Optimization (DPO) เรียนรู้จากคู่ความชอบโดยไม่ต้องฝึกนโยบายแยกผ่านวงจรการเรียนรู้เสริมออนไลน์ การสุ่มแบบปฏิเสธ, การปรับแต่งความชอบด้วยการดูแล, ข้อเสนอแนะแบบกฎ, และการกำกับกระบวนการเป็นตัวเลือกอื่นที่มีการแลกเปลี่ยนข้อดีข้อเสีย
ไม่มีวิธีใดที่สามารถละทิ้งความจำเป็นของพรอมต์, การดึงข้อมูล, เครื่องมือ, และการควบคุมระดับแอปพลิเคชันได้ การฝึกหลังการฝึก (post‑training) กำหนดพฤติกรรม; ระบบที่นำไปใช้ยังคงต้องอาศัยหลักฐานที่มั่นคง, การอนุญาต, การเฝ้าติดตาม, และการส่งต่อให้มนุษย์
วิธีการฝึกโมเดลความชอบ
สำหรับพรอมต์ x และสองคำตอบ y₁ และ y₂ โมเดลความชอบจะกำหนดคะแนนเชิงสเกลและฝึกให้คำตอบที่ต้องการได้รับคะแนนสูงกว่า การสูญเสียทั่วไปอิงจากความน่าจะเป็นที่คะแนนหนึ่งเกินอีกหนึ่ง สิ่งนี้ทำให้การตัดสินแบบคู่หลาย ๆ คู่แปลงเป็นฟังก์ชันที่สามารถให้คะแนนผลลัพธ์ที่สร้างใหม่ได้
โมเดลจะเรียนรู้สัญญาณใด ๆ ที่ทำนายการเลือกที่รวบรวมได้ หากผู้ให้คะแนนชอบการเขียนที่มั่นใจ, คำตอบที่ยาวกว่า, มาตรฐานวัฒนธรรมเฉพาะ, หรือมุมมองที่คุ้นเคย ความสัมพันธ์เหล่านั้นอาจกลายเป็นคุณลักษณะของรางวัล คำสั่งที่สมดุล, ตัวอย่างตรงข้าม, การตรวจสอบจากผู้เชี่ยวชาญ, และการตรวจสอบความชอบผิวเผินจะช่วยลดปัญหาแต่ไม่สามารถขจัดได้ทั้งหมด
ข้อมูลความชอบอาจรวมถึงการเท่ากัน, การจัดอันดับ, การวิจารณ์, ป้ายกำกับเชิงสเกล, หรือการสาธิต การเลือกคู่มีความสำคัญ: การเปรียบเทียบระหว่างคำตอบที่แตกต่างอย่างชัดเจนสอนน้อยเกี่ยวกับขอบเขตคุณภาพที่ละเอียดอ่อน ในขณะที่คู่ที่ยากเท่านั้นอาจทำให้การฝึกไม่เสถียร การสุ่มเชิงรุกสามารถมุ่งเป้าไปที่ความขัดแย้งที่ให้ข้อมูล แต่ก็อาจเปลี่ยนการกระจายของข้อมูล
การเพิ่มประสิทธิภาพนโยบายและการทำให้เป็นระเบียบ
RLHF ที่ใช้ PPO จะสุ่มผลลัพธ์จากนโยบายปัจจุบัน ให้คะแนนด้วยโมเดลรางวัล และอัปเดตนโยบายเพื่อเพิ่มรางวัลที่คาดหวัง การลงโทษแบบ Kullback–Leibler หรือข้อจำกัดที่คล้ายกันจะทำให้นโยบายอยู่ใกล้กับอ้างอิงที่ได้รับการดูแล จำกัดการเบี่ยงเบนที่ทำลายและป้องกันการใช้ประโยชน์จากจุดอ่อนของโมเดลรางวัลที่แคบ
ระดับความแรงของการเพิ่มประสิทธิภาพเป็นการตัดสินใจของผลิตภัณฑ์ การเพิ่มประสิทธิภาพน้อยเกินไปจะทำให้พฤติกรรมที่ต้องการไม่เปลี่ยนแปลง; มากเกินไปอาจทำให้เกิดการแฮ็กรางวัล, การใช้วลีซ้ำซาก, การยอมเชย, หรือความหลากหลายลดลง ควรวัดคุณภาพและเมตริกความปลอดภัยเทียบกับรางวัลและการเบี่ยงเบนตลอดการฝึก แทนที่จะเลือกจุดตรวจสอบโดยอิงรางวัลเพียงอย่างเดียว
วิธีการความชอบโดยตรงสร้างวัตถุประสงค์จากคู่ความชอบและโมเดลอ้างอิงโดยไม่ต้องมีวงจร RL ออนไลน์ที่ชัดเจน พวกมันสามารถทำให้การฝึกง่ายขึ้น แต่ยังคงสืบทอดคุณภาพความชอบ, ความครอบคลุม, และสมมติฐานของนโยบายอ้างอิง การให้ข้อเสนอแนะแบบรัฐธรรมหรือที่สร้างโดย AI จะเปลี่ยนผู้ให้ป้ายกำกับ; แต่มันไม่ได้ขจัดความจำเป็นในการตรวจสอบค่าและความล้มเหลวกับผู้คน
การประเมินผลและการจัดการข้อมูล
ใช้การเปรียบเทียบแบบไม่เปิดเผย, การทดสอบเฉพาะงาน, พรอมต์เชิงศัตรู, การตรวจสอบความเป็นข้อเท็จจริง, ความแม่นยำและการเรียกคืนของการปฏิเสธ, และการตรวจสอบกลุ่มย่อย แยกผู้ประเมินออกจากข้อมูลการฝึกเมื่อเป็นไปได้ อัตราชนะเมื่อเทียบกับโมเดลเก่าอาจซ่อนความล้มเหลวอย่างชัดเจนเมื่อทั้งสองตัวเลือกมีคุณภาพต่ำ
บันทึกการสรรหาผู้ให้คำอธิบาย, ค่าตอบแทน, ความเชี่ยวชาญ, ภูมิภาค, ภาษา, คำสั่ง, การเปิดเผยต่อเนื้อหาที่เป็นอันตราย, ความขัดแย้ง, การตัดสิน, และการควบคุมคุณภาพ งานข้อเสนอแนะอาจมีความเสี่ยงด้านจิตใจ และการดำเนินการข้อมูลอย่างรับผิดชอบควรรวมการสนับสนุนพนักงานและสิทธิ์ในการปฏิเสธงานที่ทำให้รบกวน
หลังการเปิดใช้งาน ควรเฝ้าติดตามการเปลี่ยนแปลงของความชอบและการทั่วไปเกินไป นโยบายที่ปรับให้เหมาะกับการช่วยเหลือแบบสบาย ๆ อาจทำงานไม่ดีในบริบททางการแพทย์หรือกฎหมาย ควรรักษาขอบเขตโดเมน, การดึงข้อมูล, การอนุญาต, และการส่งต่อให้เป็นนอกสมมติฐานของ RLHF และทำการฝึกใหม่เฉพาะเมื่อหลักฐานใหม่พิสูจน์ว่าการเปลี่ยนแปลงนั้นสมเหตุสมผล
กระบวนการฝึกและประเมินผล RLHF อย่างเป็นรูปธรรม
โครงการทั่วไปเริ่มด้วยโมเดลภาษาที่ผ่านการฝึกล่วงหน้าและชุดข้อมูลคำสั่งที่ใช้สำหรับการปรับแต่งด้วยการดูแล จากนั้นผู้ให้คำอธิบายจะเปรียบเทียบคำตอบที่เป็นไปได้ภายใต้เกณฑ์เขียนที่ครอบคลุมความถูกต้อง, ความเกี่ยวข้อง, สไตล์, ความปลอดภัย, และความไม่แน่นอน ความชอบแบบคู่ฝึกโมเดลรางวัลหรือเพิ่มประสิทธิภาพนโยบายโดยตรง การสุ่มตัวอย่างต้องรวมงานทั่วไป, กรณีขอบที่ยาก, พรอมต์เชิงศัตรู, หลายภาษา, และพื้นที่ที่ผู้ให้คำอธิบายมีความขัดแย้งอย่างสมเหตุสมผล
ความแม่นยำของโมเดลรางวัลบนการเปรียบเทียบที่เก็บไว้เป็นข้อมูลทดสอบเป็นสิ่งจำเป็นแต่ไม่เพียงพอ นโยบายที่เพิ่มประสิทธิภาพอาจใช้ประโยชน์จากข้อผิดพลาดของรางวัลที่เรียนรู้, กลายเป็นยาวเกินไป, ปฏิเสธคำขอที่ไม่มีอันตราย, หรือสูญเสียความสามารถ ควรติดตามเกณฑ์มาตรฐานงาน, ความชอบของมนุษย์, การปรับเทียบ, ความปลอดภัย, ความหลากหลาย, และการเบี่ยงเบนจากโมเดลอ้างอิงตลอดการฝึก อย่างสม่ำเสมอควรรวบรวมการเปรียบเทียบใหม่จากนโยบายที่เปลี่ยนแปลงเพื่อให้ข้อมูลความชอบครอบคลุมผลลัพธ์ที่โมเดลสร้างจริง
บันทึกว่าผู้ใดให้ความชอบ, คำสั่งของพวกเขา, ค่าตอบแทน, ความขัดแย้ง, การควบคุมคุณภาพ, และขอบเขตทางวัฒนธรรมหรือโดเมน ใช้ผู้ตรวจสอบผู้เชี่ยวชาญเมื่อความผิดพลาดอาจก่อความเสียหายเฉพาะด้าน ทำการทดสอบ Red‑team ทั้งโมเดลรางวัลและนโยบายสุดท้าย, รักษาการทดสอบการถดถอยของพฤติกรรม, และเตรียมการเปิดใช้ RLHF กำหนดพฤติกรรมตามความชอบที่วัดได้; แต่มันไม่ได้พิสูจน์ความจริง, ขจัดอคติ, หรือแก้ปัญหาที่กว้างขึ้นของการกำหนดว่ารุ่นควรทำอะไรในทุกบริบท
รายการตรวจสอบการนำไปใช้เชิงปฏิบัติ
เปลี่ยนแนวคิดให้เป็นกระบวนการทำงานที่มีขอบเขตและทดสอบได้: ฝึกล่วงหน้า → สาธิต → เปรียบเทียบ → เรียนรู้รางวัล → เพิ่มประสิทธิภาพ → ประเมิน กำหนดเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้างฐานเปรียบเทียบอย่างง่าย, ตั้งเกณฑ์การยอมรับและการหยุด, ทดสอบความล้มเหลวที่เป็นตัวอย่าง, และกำหนดการเฝ้าติดตาม, การย้อนกลับ, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนเปิดใช้งาน ให้ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้งานผิดวิธี; เก็บหลักฐานและความเสี่ยงที่ยังไม่ได้แก้กำหนดว่าใครสามารถอนุมัติการปล่อย, ปรับค่าเกณฑ์, ลบผลลัพธ์, หรือหยุดการดำเนินการ ทบทวนการตัดสินใจเมื่อข้อมูลจากโลกจริงมาถึง เพราะการทดลองที่ประสบความสำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- FEEDBACK: การตัดสินที่สุ่มพร้อมความขัดแย้ง.
- REWARD: ตัวแทนที่เรียนรู้สำหรับพฤติกรรมที่ต้องการ.
- POLICY: ผลลัพธ์ที่เพิ่มประสิทธิภาพซึ่งยังต้องทดสอบ.
คำถามที่พบบ่อย
RLHF คือเดียวกับการปรับแต่งหรือไม่?
RLHF เป็นรูปแบบของการฝึกหลังการฝึกที่ใช้รางวัลที่ได้จากความชอบ การปรับแต่งด้วยการดูแลโดยตรงฝึกบนผลลัพธ์เป้าหมาย; หลายกระบวนการใช้ทั้งสองวิธีร่วมกัน
RLHF ทำให้โมเดลเป็นความจริงหรือไม่?
มันสามารถปรับปรุงพฤติกรรมที่วัดโดยกระบวนการข้อเสนอแนะได้, แต่โมเดลอาจยังคงผิดพลาด, มีอิทธิพล, หรือใช้รางวัลอย่างมีกลยุทธ์ ความจริงต้องการการประเมินโดยตรงและการอ้างอิงที่มั่นคง
อ้างอิงหลัก