
พื้นฐาน AI
การเรียนรู้เสริมแรงเชิงลึกคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
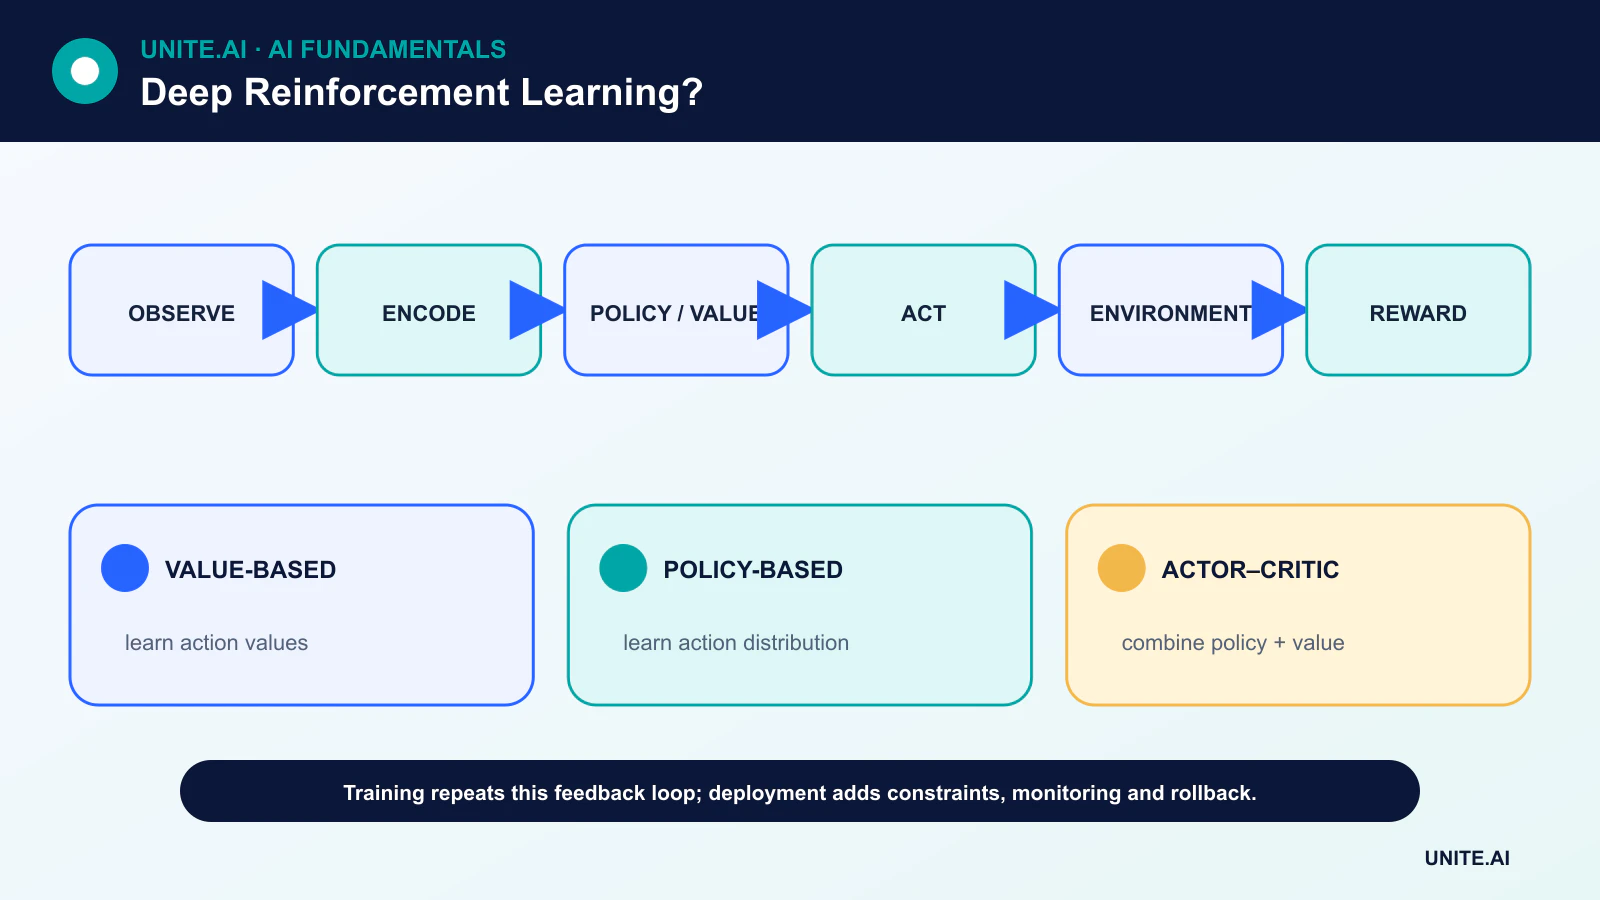
Deep reinforcement learning (deep RL) ผสานการเรียนรู้เสริมแรงกับเครือข่ายประสาทเทียมเชิงลึก ตัวแทนสังเกตสถานะ เลือกการกระทำ รับรางวัลและการสังเกตใหม่ แล้วปรับนโยบายหรือฟังก์ชันค่าเพื่อปรับปรุงการตัดสินใจในอนาคต.
เครือข่ายเชิงลึกไม่ได้ขจัดส่วนที่ยากของการเรียนรู้เสริมแรง มันให้วิธีที่ยืดหยุ่นในการแทนภาพ, สตรีมเซ็นเซอร์, พื้นที่การกระทำขนาดใหญ่ หรือฟังก์ชันค่าที่ซับซ้อน การสำรวจ, การให้เครดิตล่าช้า, การฝึกที่ไม่เสถียรและการประเมินผลในโลกจริงอย่างปลอดภัย ยังคงเป็นปัญหาวิศวกรรมหลัก.
ประเด็นสำคัญ
- Deep RL เรียนรู้การตัดสินใจแบบต่อเนื่องจากการโต้ตอบ แทนการใช้ตารางตัวอย่างที่มีป้ายกำกับคงที่
- วิธีเชิงค่าประเมินว่าการกระทำดีแค่ไหน; วิธีเชิงนโยบายเรียนรูการกระจายของการกระทำโดยตรง; วิธี actor‑critic รวมสองอย่างเข้าด้วยกัน
- บัฟเฟอร์รีเพลย์, เครือข่ายเป้าหมายและการออกแบบรางวัลอย่างรอบคอบสามารถปรับปรุงการฝึกได้ แต่ไม่มีวิธีใดที่รับประกันพฤติกรรมที่เชื่อถือได้
- คะแนนจากซิมูเลเตอร์ที่สูงไม่ใช่หลักฐานของความทนทาน, ความปลอดภัย หรือการโอนย้ายที่ประสบความสำเร็จสู่โลกจริง
ปัญหาการตัดสินใจ: สถานะ, การกระทำและรางวัล
งาน deep‑RL จำนวนมากถูกจำลองเป็นกระบวนการตัดสินใจแบบมาร์คอฟ (Markov decision process) ในเวลา t ตัวแทนได้รับสถานะหรือการสังเกต s_t, เลือกการกระทำ a_t, จากนั้นรับรางวัล r_{t+1} และสถานะถัดไป เป้าหมายคือผลตอบแทนที่ถูกส่วนลดตามคาดหวัง ไม่จำเป็นต้องเป็นรางวัลถัดไปเพียงอย่างเดียว.
ปัจจัยส่วนลดควบคุมความสำคัญของรางวัลที่ห่างไกล ฟังก์ชันรางวัลกำหนดสิ่งที่กระบวนการเพิ่มประสิทธิภาพจะไล่ตาม ดังนั้นตัวแทนที่ไม่ครบถ้วนอาจทำให้เกิดพฤติกรรมที่เทคนิคแล้วสำเร็จแต่ในเชิงปฏิบัติไม่น่าพอใจ นี่เป็นเหตุผลหนึ่งที่การออกแบบรางวัลและการทดสอบข้อจำกัดควรได้รับความสนใจเท่ากับสถาปัตยกรรมโมเดล.
วิธีเชิงค่าประเมิน, วิธีเชิงนโยบายและวิธี actor‑critic
อัลกอริธึมเชิงค่าประเมินประมาณค่าของสถานะหรือค่าของการกระทำ Deep Q‑network ใช้เครือข่ายประสาทเทียมเพื่อประมาณค่า Q‑value และมักเลือกการกระทำที่มีค่าประมาณสูงสุดพร้อมคงการสำรวจบางส่วน อัลกอริธึม policy‑gradient แทนที่จะทำการเพิ่มประสิทธิภาพนโยบายที่มีพารามิเตอร์ซึ่งให้การกระจายของการกระทำ.
ระบบ actor‑critic รักษา actor ที่เสนอการกระทำและ critic ที่ประเมินค่าของการกระทำนั้น การออกแบบนี้สนับสนุนการควบคุมต่อเนื่องแต่ทำให้เกิดแหล่งความผิดพลาดในการประมาณที่โต้ตอบกัน Deep RL จึงอาศัยพื้นฐานเดียวกับ deep learning, gradient descent และ backpropagation.
ทำไมบัฟเฟอร์รีเพลย์และเครือข่ายเป้าหมายจึงช่วยได้
ตัวอย่างประสบการณ์ต่อเนื่องมีความสัมพันธ์กัน ในขณะที่การอัปเดตเครือข่ายทำให้เป้าหมายที่ใช้ในการอัปเดตต่อไปเปลี่ยนแปลง บัฟเฟอร์รีเพลย์ทำลายความสัมพันธ์เชิงเวลาเหล่านี้โดยการสุ่มการเปลี่ยนแปลงเก่า เครือข่ายเป้าหมายเปลี่ยนแปลงช้ากว่าเครือข่ายออนไลน์ ทำให้เป้าหมายแบบบูตสแตรปมีความผันผวนน้อยลง.
กลไกเหล่านี้ช่วยเพิ่มความเสถียรของการฝึก แต่การปรับแต่งยังคงสำคัญ อัตราการเรียนรู้, ตารางการสำรวจ, สเกลของรางวัล, การผสมผสานรีเพลย์และความจุของเครือข่ายทั้งหมดสามารถเปลี่ยนผลลัพธ์ได้ ควรรายงานเมล็ดสุ่มหลายค่าเนื่องจากการรันเพียงครั้งเดียวอาจทำให้เข้าใจผิด.
RL แบบออฟไลน์, RL แบบอิงโมเดลและการโอนจากซิมูเลชันสู่ความเป็นจริง
Offline RL เรียนรู้จากชุดข้อมูลบันทึกที่คงที่โดยไม่ต้องเก็บการโต้ตอบใหม่ สามารถมีประโยชน์เมื่อการสำรวจมีค่าใช้จ่ายสูงหรือไม่ปลอดภัย แต่ต้องให้แนวทางหลีกเลี่ยงการกระทำที่มีการแสดงผลไม่ครบถ้วนในบันทึก RL แบบอิงโมเดลเรียนรู้หรือใช้โมเดลการเปลี่ยนแปลงเพื่อวางแผน โดยแลกกับสมมติฐานเพิ่มเติมเพื่อประสิทธิภาพการใช้ตัวอย่าง.
หุ่นยนต์มักฝึกในซิมูเลชันโดยสุ่มพารามิเตอร์ทางกายภาพ แล้วทำการปรับจูนหรือยืนยันบนฮาร์ดแวร์ ช่องว่างความเป็นจริงยังอาจเปิดเผยข้อผิดพลาดในการรับรู้, เวลา, พลวัตการสัมผัสและกรณีขอบที่ไม่ได้โมเดล ระบบ reinforcement‑learning ควรได้รับการประเมินภายใต้การกวน, การเปลี่ยนแปลงการกระจายและข้อจำกัดด้านความปลอดภัยที่ชัดเจน.
การประเมินผลและการนำไปใช้
การประเมินที่มีประโยชน์จะแยกสภาพแวดล้อมการฝึกและการทดสอบ รายงานการกระจายของผลตอบแทนแทนการให้คะแนนสูงสุดเพียงอย่างเดียว และตรวจสอบการละเมิดข้อจำกัด, ความถี่ของการแทรกแซงและพฤติกรรมในกรณีแย่ที่สุด สำหรับระบบจริง ทีมงานยังต้องการการตรวจสอบ, ขั้นตอนการย้อนกลับ, พื้นที่การกระทำที่จำกัดและการแทรกแซงของมนุษย์.
Deep RL มีความน่าสนใจที่สุดเมื่อการตัดสินใจเป็นลำดับต่อเนื่อง, มีข้อเสนอแนะและกฎการควบคุมที่เขียนด้วยมือไม่เพียงพอ มันเป็นตัวเลือกที่ไม่ดีเมื่อมีป้ายกำกับแบบกำกับดูแลจำนวนมาก, ตัวเพิ่มประสิทธิภาพแบบดั้งเดิมแก้ปัญหาได้, หรือการสำรวจอาจทำให้คนหรือทรัพย์สินเสี่ยง.
สถาปัตยกรรม Deep RL และสัญญาณการฝึก
Deep reinforcement learning ใช้เครือข่ายประสาทเทียมเพื่อแทนฟังก์ชันค่า, นโยบาย, โมเดลสภาพแวดล้อม หรือการผสมผสานบางอย่าง Deep Q‑network ทำนายค่าการกระทำและเรียนรู้จากเป้าหมาย temporal‑difference; บัฟเฟอร์รีเพลย์ลดความสัมพันธ์ระหว่างการอัปเดต ในขณะที่เครือข่ายเป้าหมายทำให้เป้าหมายที่เคลื่อนที่เสถียรขึ้น วิธี policy‑gradient เพิ่มประสิทธิภาพผลตอบแทนที่คาดหวังโดยตรง และวิธี actor‑critic ใช้ critic ที่เรียนรู้เพื่อลดความแปรปรวนของ gradient การกระทำต่อเนื่องมักต้องการรูปแบบ deterministic หรือ stochastic ของ actor‑critic ส่วนการกระทำเชิงบูรณาการมิติสูงต้องการการสำรวจและการออกแบบผลลัพธ์อย่างระมัดระวัง.
การฝึกเป็นแบบไม่คงที่เนื่องจากนโยบายเปลี่ยนแปลงข้อมูลที่เก็บ บัฟเฟอร์รีเพลย์กลายเป็น off‑policy, เป้าหมายบูตสแตรปขึ้นอยู่กับการประมาณค่าปัจจุบัน, และการประมาณฟังก์ชันอาจขยายความผิดพลาด—การรวมกันนี้บางครั้งเรียกว่า deadly triad ตัวประเมินคู่ลดการประเมินค่ามากเกินไป; ฟังก์ชัน advantage ปรับปรุงการมอบเครดิต; โบนัส entropy ส่งเสริมการสำรวจ; วัตถุประสงค์ที่คลิปจำกัดการอัปเดตนโยบายที่ทำลาย Normalize การสังเกตและรางวัลเฉพาะเมื่อสถานะปลอดการรั่วไหล, และบันทึกสภาพแวดล้อม, wrapper, การทำซ้ำการกระทำ, การสิ้นสุด, และการเตรียมรางวัล เนื่องจากแต่ละอย่างเปลี่ยนปัญหา.
การประเมิน, ซิมูเลเตอร์, และความปลอดภัยในการนำไปใช้
รายงานการกระจายของผลตอบแทนในเมล็ดสุ่มและอินสแตนซ์สภาพแวดล้อมที่อิสระ ไม่ใช่การรันที่ดีที่สุด ประเมินประสิทธิภาพการใช้ตัวอย่าง, การละเมิดข้อจำกัด, ผลลัพธ์ที่หายนะ, ความอ่อนไห่ต่อสเกลของรางวัล, และความทนทานต่อเสียงรบกวนของการสังเกต, ความล่าช้า, ความผิดพลาดของแอกชูเอเตอร์, และการเปลี่ยนแปลงพลวัต เปรียบเทียบกับการควบคุมแบบสคริปต์, การควบคุมแบบคลาสสิก, การเลียนแบบแบบกำกับดูแล, และ RL ที่ง่ายกว่า แยกส่วนความแปรปรวนของสภาพแวดล้อมและทดสอบเมตริกผลลัพธ์ที่ไม่มีรางวัล เนื่องจากตัวแทนอาจใช้ประโยชน์จากรางวัลที่โปรแกรมไว้แต่ล้มเหลวในภารกิจที่ตั้งใจ วิดีโอและการตรวจสอบเส้นทางมักเปิดเผยพฤติกรรมที่ซ่อนอยู่ภายใต้ผลตอบแทนรวม.
ซิมูเลชันทำให้การสำรวจเป็นไปได้แต่สร้างช่องว่างความเป็นจริง การสุ่มฟิสิกส์และการรับรู้ที่เกี่ยวข้อง, ปรับเทียบกับการวัดจริง, และใช้การโอนแบบระมัดระวัง ข้อมูลบันทึกหรือ offline RL หลีกเลี่ยงการสำรวจออนไลน์แต่ไม่สามารถประเมินการกระทำที่ไม่ได้รับการสนับสนุนจากนโยบายพฤติกรรมได้อย่างเชื่อถือ ระบบการผลิตควรจำกัดชุดการกระทำ, อัตรา, ทรัพยากร, และขอบเขตการทำงาน; ต้องการการอนุมัติสำหรับการกระทำที่มีผลกระทบสูง; และรวมตัวควบคุมที่ปลอดภัยที่ตรวจสอบแล้วหรือการหยุด การตรวจสอบอินพุตของนโยบาย, การกระจายการกระทำ, รางวัล, ผลลัพธ์จริง, และการแทรกแซง พร้อมการย้อนกลับไปยังเวอร์ชันนโยบายที่ทดสอบแล้ว.
ตัวอย่างการควบคุมที่เป็นรูปธรรม
สำหรับการกำหนดเส้นทางหุ่นยนต์คลังสินค้า นิยามสถานะจากตำแหน่ง, โหลด, แบตเตอรี่, การจราจรใกล้เคียง, และคิวงาน; การกระทำจากการเคลื่อนที่ที่อนุญาตและการตัดสินใจชาร์จ; และรางวัลจากงานที่เสร็จสมบูรณ์, พลังงาน, ความแออัด, และข้อจำกัดด้านความปลอดภัย ฝึกแรกในซิมูเลเตอร์ที่ปรับเทียบพร้อมความต้องการสุ่มและความผิดพลาดของเซ็นเซอร์, จากนั้นเงาตัดสินใจจริง อย่าให้แนวนโยบายที่เรียนรู้ข้ามขั้นตอนการหลีกเลี่ยงการชน ประเมินอัตราการผ่านพร้อมกับการหลุดพลาดใกล้เคียง, การอุดตัน, เหตุฉุกเฉินแบตเตอรี่, และความล่าช้าในกรณีแย่ที่สุด โครงการจะสำเร็จก็ต่อเมื่อระบบหลายชั้นปรับปรุงการดำเนินงานโดยไม่ส่งความเสี่ยงจากการสำรวจที่ไม่ยอมรับได้ต่อคนหรืออุปกรณ์.
ตัวอย่างการทำงาน: DRL สำหรับการทำความเย็นของศูนย์ข้อมูล
ศูนย์ข้อมูลจำกัดเอเจนต์ RL ให้ใช้จุดตั้งค่าการทำความเย็นที่ได้รับการอนุมัติและฝึกในซิมูเลเตอร์ที่ปรับเทียบจากสภาพอากาศในอดีต, ปริมาณงาน, อุณหภูมิ, และการตอบสนองของอุปกรณ์ รางวัลรวมพลังงานแต่ข้อจำกัดที่เข้มงวดแยกกันปกป้องอุณหภูมิ, ความชื้น, และการหมุนเวียนของอุปกรณ์ การควบคุมแบบโมเดล‑พรีดิกทีฟและกฎที่มีอยู่เป็นฐานการประเมินครอบคลุมหลายฤดูกาล, เสียงรบกวนของเซ็นเซอร์, ความล่าช้าของแอกชูเอเตอร์, การสูญเสียอุปกรณ์, โหลดที่ไม่ปกติ, และเมล็ดสุ่มหลายค่า รายงานพลังงาน, การละเมิด, ความแปรปรวน, และการกู้คืน.
นโยบายที่เรียนรู้ทำงานในโหมดเงาก่อนการทดลองในโซนจำกัด ตัวควบคุมความปลอดภัยภายนอกคลิปการกระทำและผู้ปฏิบัติงานสามารถแทรกแซงได้ อัตราการกระทำ, การครอบคลุมสถานะ, ความไม่แน่นอนของโมเดล, และผลลัพธ์ของสถานที่จริงถูกตรวจสอบ; ความไม่ตรงกันของซิมูเลเตอร์หรือการแทรกแซงซ้ำทำให้เกิดการย้อนกลับ การอัปเดตอุปกรณ์หรือตรรกะการควบคุมสร้างเวอร์ชันสภาพแวดล้อมและการตรวจสอบใหม่ การประหยัดพลังงานจะได้รับการยอมรับเฉพาะเมื่อความน่าเชื่อถือ, ระยะความร้อน, การบำรุงรักษา, และการตอบสนองต่อความผิดพลาดยังคงแข็งแรงเท่าฐาน.
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้ที่ตั้งใจ, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละอย่าง สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการสอบเทียบหรือความไม่แน่นอน, ความหน่วง, อัตราการผ่าน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด.
ก่อนเปิดใช้งาน กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการตรวจสอบด้วยการฉีดความล้มเหลวโดยเจตนา โทรเมตริกการปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการนำไปใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดใช้งานหรือเปลี่ยนแทน.
คำถามที่พบบ่อย
การเรียนรู้เสริมแรงเชิงลึกเหมือนกับการเรียนรู้เชิงลึกหรือไม่?
ไม่ การเรียนรู้เชิงลึกให้ตัวประมาณฟังก์ชัน; การเรียนรู้เสริมแรงให้การโต้ตอบ, รางวัลและวัตถุประสงค์การตัดสินใจต่อเนื่อง.
รางวัลสูงหมายความว่าตัวแทนเรียนรู้พฤติกรรมที่ตั้งใจหรือไม่?
ไม่จำเป็นเสมอ มันหมายความว่านโยบายพบพฤติกรรมที่ให้คะแนนดีภายใต้รางวัลและสภาพแวดล้อมที่กำหนด การทดสอบความปลอดภัยและการสอดคล้องกับเป้าหมายอย่างอิสระยังคงจำเป็น.
เอกสารอ้างอิงหลัก












