พื้นฐาน AI
วิทยาการข้อมูลคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Data science คือการปฏิบัติที่เปลี่ยนข้อมูลให้เป็นความรู้ที่สามารถยืนยันได้ การพยากรณ์ หรือการตัดสินใจ มันรวมความเชี่ยวชาญด้านโดเมน, สถิติ, การคำนวณ, วิศวกรรมข้อมูล, การสร้างภาพและการสื่อสาร โมเดลอาจเป็นส่วนหนึ่งของงาน แต่สาขานี้เริ่มตั้งแต่ก่อนการสร้างโมเดลและดำเนินต่อหลังการใช้งานจริง
คำถามที่สำคัญที่สุดไม่ใช่ “อัลกอริทึมใดที่ควรใช้?” แต่คือ “การตัดสินใจใดที่เรากำลังสนับสนุน หลักฐานอะไรจะตอบคำถามนั้น และเราจะรู้ได้อย่างไรว่าผลลัพธ์ยังคงมีประโยชน์?”
ประเด็นสำคัญ
- วิทยาการข้อมูลเป็นกระบวนการทำงานแบบครบวงจรของหลักฐาน ไม่ใช่คำพ้องของการเรียนรู้ของเครื่อง
- การกำหนดปัญหา, การวัดผลและการกำกับดูแลข้อมูลมักเป็นตัวกำหนดความสำเร็จมากกว่าความซับซ้อนของโมเดล
- คำถามเชิงพยากรณ์และเชิงสาเหตุต้องการสมมติฐานและการออกแบบการประเมินที่แตกต่างกัน
- การวิเคราะห์ที่นำไปใช้งานต้องการการเฝ้าติดตาม, เอกสารและการสื่อสารที่เหมาะสมกับผู้ใช้
เริ่มต้นด้วยการตัดสินใจและการประมาณค่า
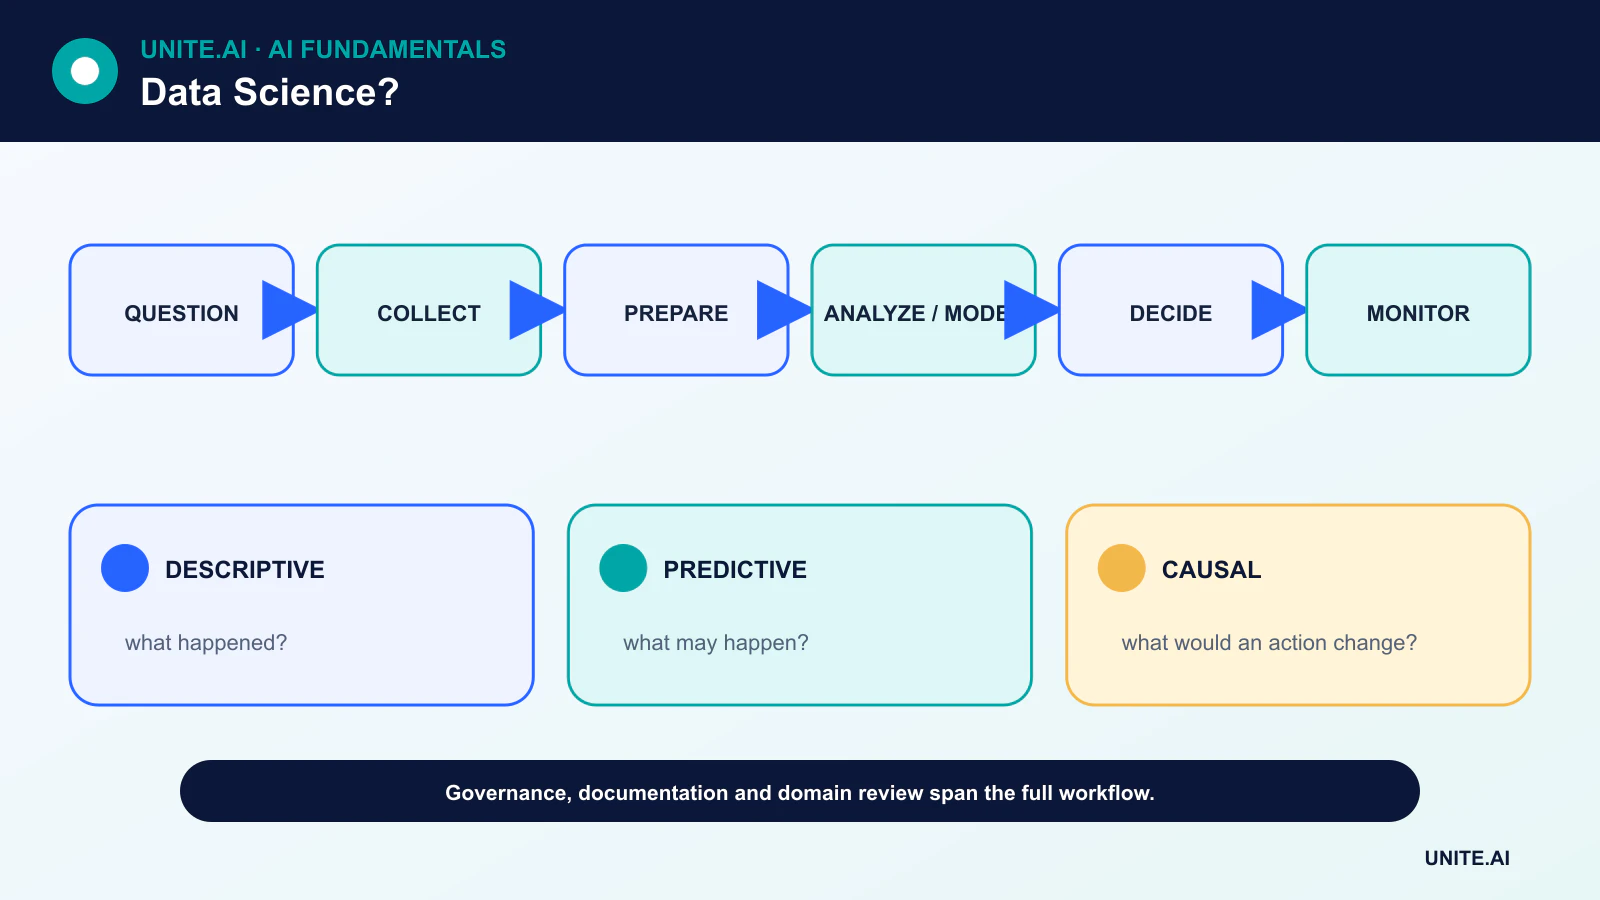
โครงการควรระบุผู้ใช้, การตัดสินใจ, การแทรกแซงและค่าใช้จ่ายของความผิดพลาด สำหรับคำถามเชิงอธิบาย, เป้าหมายอาจเป็นอัตราหรือแนวโน้ม สำหรับการพยากรณ์, อาจเป็นความต้องการหรือความเสี่ยงในอนาคต สำหรับคำถามเชิงสาเหตุ, ค่าประมาณอธิบายผลของการแทรกแซงที่กำหนดภายใต้สมมติฐานที่ระบุ
เป้าหมายที่คลุมเครือเช่น “ค้นพบข้อมูลเชิงลึก” ทำให้การประเมินเป็นไปไม่ได้ วัตถุประสงค์ที่วัดได้สร้างขอบเขตสำหรับการเก็บข้อมูลและป้องกันการวิเคราะห์ขยายไปยังทุกสนามที่มีอยู่
เก็บรวบรวม, กำกับดูแลและทำความเข้าใจข้อมูล
ทีมทำรายการแหล่งที่มา, ความเป็นเจ้าของ, ความยินยอม, การเก็บรักษา, ต้นกำเนิดและการเข้าถึง พวกเขาแยกแยะ ข้อมูลเชิงโครงสร้างและข้อมูลไม่มีโครงสร้าง, กำหนดหน่วยและเวลา, และตรวจสอบว่าบันทึกเหล่านั้นเป็นตัวแทนของประชากรและช่วงเวลาที่สนใจหรือไม่
การทำความสะอาดไม่ได้หมายถึงเพียงการลบแถวที่ขาดข้อมูลเท่านั้น แต่รวมถึงการแก้ไขข้อมูลซ้ำ, ค่าที่เป็นไปไม่ได้, ความคลุมเครือของป้าย, การเปลี่ยนแปลงสคีม่า, การเซ็นเซอร์และการเชื่อมที่เปลี่ยนหน่วยการวิเคราะห์ ทุกการแปลงต้องทำได้ซ้ำและมีเอกสารประกอบ
สำรวจก่อนการสร้างโมเดล
การวิเคราะห์สำรวจศึกษาการกระจาย, การขาดข้อมูล, ความสัมพันธ์และศิลปะการวัดที่อาจเกิดขึ้น การสร้างภาพสามารถเปิดเผยค่าผิดปกติและความแตกต่างของกลุ่มย่อยที่ค่าเฉลี่ยสรุปซ่อนอยู่ การสำรวจควรให้ข้อมูลแก่สมมติฐานโดยไม่ถูกเข้าใจว่าเป็นหลักฐานยืนยัน
การสร้างคุณลักษณะ, การลดมิติ และการเรียนรู้การแสดงผลอาจช่วยปรับปรุงการสร้างโมเดล แต่การแปลงต้องฝึกเฉพาะบนข้อมูลฝึกเพื่อป้องกันการรั่วไหล
เลือกวิธีการตามคำถาม
การประมาณเชิงสถิติวัดความไม่แน่นอนรอบปริมาณที่สนใจ การเรียนรู้ของเครื่อง มีประโยชน์เมื่อเป้าหมายหลักคือประสิทธิภาพการพยากรณ์บนข้อมูลใหม่ การทดลองและวิธีการสรุปเชิงสาเหตุจำเป็นเมื่อเป้าหมายคือผลของการแทรกแซง
ฐานข้อมูลควรเรียบง่ายพอที่จะเข้าใจ โมเดลที่ซับซ้อนมากขึ้นต้องพิสูจน์ว่าค่าใช้จ่ายเพิ่มขึ้นนั้นคุ้มค่าโดยการให้ประสิทธิภาพที่ดีกว่าในชุดทดสอบ, ความไม่แน่นอนที่ปรับเทียบ, มูลค่าการปฏิบัติ หรือความสามารถที่จำเป็นเช่นการประมวลผลภาพหรือภาษา
ประเมิน, สื่อสารและเฝ้าติดตาม
การประเมินควรสอดคล้องกับการตัดสินใจ ตัวจำแนกอาจต้องการความแม่นยำ, การเรียกคืน, การปรับเทียบและการวิเคราะห์กลุ่มย่อย แทนที่จะใช้แค่ความแม่นยำอย่างเดียว; ระบบพยากรณ์ต้องการการทดสอบย้อนหลังที่คำนึงถึงเวลา การฝึกเกิน และการรั่วไหลเป็นความล้มเหลวของกระบวนการ ไม่ใช่แค่คุณสมบัติของโมเดล
การสื่อสารรวมถึงสมมติฐาน, ความไม่แน่นอน, ข้อจำกัดและการกระทำที่แนะนำ เมื่อโมเดลหรือแดชบอร์ดถูกใช้งาน ทีมจะเฝ้าติดตามคุณภาพข้อมูลเข้า, การเปลี่ยนแปลงของผลลัพธ์, พฤติกรรมผู้ใช้และผลกระทบต่อส่วนต่อไป กระบวนการตัดสินใจที่ยุติการใช้งานต้องมีที่เก็บข้อมูลและความเป็นเจ้าของที่ชัดเจน เช่นเดียวกับที่ระบบที่ใช้งานต้องมีผู้ดำเนินการ
วงจรชีวิตของวิทยาการข้อมูลและคำถามเชิงวิเคราะห์
วิทยาการข้อมูลรวมความรู้ด้านโดเมน, สถิติ, การคำนวณและการสื่อสารเพื่อเปลี่ยนข้อมูลให้เป็นหลักฐานสำหรับการตัดสินใจ เริ่มต้นด้วยการแยกแยะการอธิบาย, การวินิจฉัย, การพยากรณ์และการสรุปเชิงสาเหตุ แดชบอร์ดที่รายงานสิ่งที่เกิดขึ้น, โมเดลที่พยากรณ์ว่าผู้ใช้จะยกเลิก, และการทดลองที่ประเมินว่าการแทรกแซงเปลี่ยนการยกเลิกหรือไม่ ตอบคำถามที่แตกต่างกัน กำหนดหน่วย, ประชากร, หน้าต่างเวลา, ผลลัพธ์, การกระทำและค่าใช้จ่ายของความผิดพลาดก่อนดึงข้อมูล โครงการที่ล้มเหลือส่วนใหญ่แก้ปัญหาตัวแทนที่วัดได้ซึ่งไม่สามารถสนับสนุนการตัดสินใจที่ตั้งใจได้
การได้มาของข้อมูลต้องการแหล่งที่มา, สิทธิ์การเข้าถึง, การออกแบบการสุ่มตัวอย่างและสัญญาข้อมูล การสำรวจตรวจสอบการกระจาย, การขาดข้อมูล, การซ้ำ, ค่าผิดปกติ, ความสัมพันธ์, การเปลี่ยนแปลงการวัด, และการรั่วไหลที่อาจเกิดขึ้น การเลือกทำความสะอาดเป็นสมมติฐานเชิงวิเคราะห์: การลบแถวที่ขาด, การเติมค่าที่หาย, หรือการจำกัดค่าผิดปกติอาจเปลี่ยนประชากรและสรุปผล การเวอร์ชันข้อมูลดิบแบบไม่เปลี่ยนแปลงและการแปลงเป็นโค้ด, และสร้างพจนานุกรมข้อมูลพร้อมหน่วยและความหมาย แบ่งข้อมูลประเมินก่อนเรียนรู้การแปลงหรือทดสอบสมมติฐานซ้ำหลายครั้ง
การสร้างโมเดล, การสรุปผล, และความสามารถทำซ้ำได้
การสรุปเชิงสถิติวัดความไม่แน่นอนภายใต้สมมติฐาน; การสร้างโมเดลพยากรณ์ประเมินประสิทธิภาพนอกชุดข้อมูล; การวิเคราะห์เชิงสาเหตุต้องการการระบุผ่านการออกแบบหรือสมมติฐานที่ยอมรับได้ เลือกวิธีที่สอดคล้องกับคำถามและกระบวนการสร้างข้อมูล เปรียบเทียบกับฐานง่าย, ใช้การตรวจสอบแบบกลุ่มหรือคำนึงถึงเวลา, และรายงานความไม่แน่นอนและความไว ความสัมพันธ์สูงหรือความสำคัญของคุณลักษณะไม่ได้ยืนยันสาเหตุ การทดสอบหลายครั้ง, ความอิสระของนักวิจัย, และการรายงานเลือกสรรสามารถสร้างรูปแบบที่ดูน่าเชื่อถือได้ ดังนั้นการลงทะเบียนล่วงหน้าหรือขั้นตอนยืนยันที่แยกชัดเจนจึงเป็นประโยชน์
ความสามารถทำซ้ำได้รวมถึงโค้ด, สภาพแวดล้อม, สแนปช็อตของข้อมูล, เมล็ดสุ่ม, คำจำกัดความของคิวรี, และบันทึกการตัดสินใจด้วยมือ การทดสอบอัตโนมัติควรครอบคลุมสคีม่า, ความคงที่ทางธุรกิจ, การแปลงและเมตริก โน๊ตบุ๊คมีคุณค่าสำหรับการสำรวจแต่การทำงานในผลิตภัณฑ์ต้องการไพพ์ไลน์แบบโมดูลาร์และสามารถตรวจสอบได้ การตรวจสอบโดยเพื่อนควรท้าทายสมมติฐาน, การรั่วไหล, ความถูกต้องของเป้าหมาย, และว่าผลลัพธ์สามารถทั่วไปได้หรือไม่ สื่อสารขนาดผล, ความไม่แน่นอน, ข้อจำกัดและหลักฐานตรงข้าม แทนที่จะเน้นเพียงความสำคัญทางสถิติหรือคะแนนโมเดล
การนำไปใช้และผลกระทบของการตัดสินใจ
หากการวิเคราะห์ขับเคลื่อนกระบวนการที่ทำซ้ำได้ กำหนดผู้รับผิดชอบ, เฝ้าติดตามความสดของข้อมูลและคุณภาพผลลัพธ์, และกำหนดการย้อนกลับหรือการยกเลิก การปกป้องข้อมูลส่วนบุคคลและข้อมูลลับทำได้โดยการลดปริมาณ, การควบคุมการเข้าถึง, การเก็บรักษา, และผลลัพธ์ที่ปลอดภัย ประเมินผลกระทบต่อกลุ่มย่อยและการตอบสนองของผู้ใช้ต่อโมเดล; วงจรตอบกลับอาจเปลี่ยนข้อมูลในอนาคต วัดว่าการตัดสินใจปรับปรุงวัตถุประสงค์จริงหรือไม่ ไม่ใช่แค่โมเดลถูกนำไปใช้ วิทยาการข้อมูลประสบความสำเร็จเมื่อหลักฐานทำให้การกระทำเปลี่ยนแปลงอย่างเชื่อถือได้และโปร่งใส — ไม่ใช่เมื่อองค์กรสะสมแดชบอร์ด, ฟีเจอร์ หรือการทดลองโดยไม่มีการเป็นเจ้าของ
ตัวอย่างการทำงาน: การวัดการแทรกแซงการรักษาผู้ใช้
ทีมผลิตภัณฑ์สังเกตการรักษาผู้ใช้ที่ลดลงและกำหนดผู้ใช้ที่ใช้งานอยู่, กลุ่ม, ช่วงเวลา, การยกเว้น, และการตัดสินใจ นักวิเคราะห์ตรวจสอบเครื่องมือ, เหตุการณ์ที่ขาด, และส่วนผสมของการได้มาของข้อมูลก่อนการสร้างโมเดล กลุ่มอธิบายระบุจุดที่การลดลงเกิดขึ้น, โมเดลพยากรณ์ให้ความสำคัญกับผู้เข้าร่วมการวิจัย, และการทดลองการเริ่มต้นแบบสุ่มประเมินว่าการเปลี่ยนแปลงที่เสนอจะปรับปรุงการรักษาผู้ใช้หรือไม่ สิ่งเหล่านี้เป็นการวิเคราะห์ที่แตกต่างกันสามแบบพร้อมสมมติฐานและผลลัพธ์ที่แยกจากกัน
โน๊ตบุ๊ค, คิวรี, สแนปช็อตของข้อมูล, คำจำกัดความของเมตริก, และแผนการทดลองถูกเวอร์ชันและตรวจสอบโดยเพื่อน ผลลัพธ์รายงานขนาดผลและความไม่แน่นอนพร้อมแนวป้องกันสำหรับความต้องการสนับสนุนและการเข้าถึง แดชบอร์ดเฝ้าติดตามการทดลองแต่ไม่ทดแทนการวิเคราะห์ที่กำหนดไว้ล่วงหน้า หากการแทรกแซงสำเร็จ การเปิดตัวจะดำเนินการเป็นขั้นตอนและตรวจสอบพฤติกรรมระยะยาว งานนี้ถือว่ามีคุณค่าเฉพาะเมื่อสนับสนุนการตัดสินใจที่ทำซ้ำได้ ไม่ใช่เพราะโมเดลซับซ้อนหรือแผนภูมิที่น่าดึงดูดถูกสร้างขึ้น
หลักฐานการดำเนินการและความพร้อมในการปฏิบัติงาน
การตัดสินใจเพื่อการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้ที่ตั้งใจ, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาด, การเปลี่ยนแปลงการกระจาย, การขัดข้องของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนการเปิดตัว กำหนดอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยการฉีดข้อผิดพลาดโดยเจตนา ระบบเทเลเมตรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพสุขภาพของการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการใช้งานแทนการสมมติว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดการทำงานหรือเปลี่ยนทดแทน
คำถามที่พบบ่อย
วิทยาการข้อมูลและการวิเคราะห์ข้อมูลเป็นเรื่องเดียวกันหรือไม่?
คำเหล่านี้มีการทับซ้อนกัน วิทยาการข้อมูลมักรวมการสร้างผลิตภัณฑ์ข้อมูลและระบบพยากรณ์ ในขณะที่การวิเคราะห์อาจเน้นการสนับสนุนการตัดสินใจเชิงอธิบายและวินิจฉัย การใช้คำในองค์กรต่างกัน
ทุกโครงการวิทยาการข้อมูลต้องการ AI หรือไม่?
ไม่จำเป็น โค้รีที่ออกแบบดี, แผนภูมิ, การทดลอง หรือการประมาณเชิงสถิติที่ดีอาจมีประโยชน์และเชื่อถือได้มากกว่าโมเดลที่ซับซ้อน
อ้างอิงหลัก