
พื้นฐาน AI
โมเดลภาษาใหญ่ (LLMs) คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
โมเดลภาษาใหญ่ (LLM) คือเครือข่ายประสาทเทียมที่ได้รับการฝึกบนชุดข้อมูลลำดับขนาดใหญ่เพื่อทำนายโทเคนหรือวัตถุประสงค์ด้านภาษาที่เกี่ยวข้อง โมเดล LLM ส่วนใหญ่ในปัจจุบันใช้สถาปัตยกรรม transformer และสามารถสร้าง, จำแนก, สรุป, แปล, ดึงข้อมูล, และแปลงภาษาได้ผ่านอินเทอร์เฟซเดียว
LLM ไม่ใช่ฐานข้อมูลหรือระบบสรุปผลที่รับประกัน ผลลัพธ์ของมันเป็นการทำนายแบบมีเงื่อนไขซึ่งขึ้นอยู่กับข้อมูลการฝึก, การฝึกหลัง, บริบท, เครื่องมือ, และการถอดรหัส ความคล่องแคล่วอาจอยู่ร่วมกับความผิดพลาดของข้อเท็จจริง, ความไม่แน่นอน, อคติ, หรือพฤติกรรมที่ไม่ปลอดภัย
ประเด็นสำคัญ
- การทำโทเคนไนเซชันแปลงข้อความเป็นหน่วยที่แยกจากกัน; การฝังและกลไก attention สร้างการแสดงผลเชิงบริบท
- การฝึกล่วงหน้าเรียนรู้รูปแบบกว้าง, ในขณะที่การปรับจูนและวิธีการปรับความชอบกำหนดพฤติกรรมของงาน
- การดึงข้อมูลและเครื่องมือสามารถเพิ่มหลักฐานหรือการกระทำที่เป็นปัจจุบัน, แต่ต้องการการอนุญาตและการตรวจสอบแยกต่างหาก
- ประเมินระบบที่ปรับใช้สำหรับคุณภาพ, ความเป็นพื้นฐาน, ความปลอดภัย, ความหน่วง, ค่าใช้จ่าย, และการเปลี่ยนแปลง
โทเคน, ตัวแปลง, และการฝึกล่วงหน้า
ข้อความจะถูกแบ่งเป็นโทเคน ตัว transformer จะทำแปลงเป็นเวกเตอร์, ผสมข้อมูลผ่านกลไก attention และชั้น feed-forward, และสร้างการกระจายความน่าจะเป็นสำหรับโทเคนถัดไปหรือโทเคนที่หายไป
เป้าหมายการเรียนรู้แบบอัตโนมัติสร้างสัญญาณการฝึกจากลำดับดิบ การเพิ่มขนาดของพารามิเตอร์, ข้อมูล, และการคำนวณสามารถลดค่า loss อย่างคาดการณ์ได้ในช่วงต่าง ๆ, แต่คุณภาพของชุดข้อมูล, สถาปัตยกรรม, การเพิ่มประสิทธิภาพ, และการประเมินผลเป็นตัวกำหนดว่าความสามารถใดจะปรากฏในทางปฏิบัติ
การฝึกหลังและการสรุปผล
การปรับจูนด้วยคำสั่งใช้การสาธิต; การเพิ่มประสิทธิภาพตามความชอบสามารถทำให้ผลลัพธ์สอดคล้องกับการตัดสินของมนุษย์หรือแนวนโยบายได้มากขึ้น ในการสรุปผล, คำสั่งและประวัติการสนทนากำหนดบริบท, ขณะที่อุณหภูมิและการตั้งค่าการสุ่มมีผลต่อความแปรปรวน
RLHF และวิธีการที่คล้ายกันกำหนดพฤติกรรมแทนการติดตั้งระบบตรวจสอบความจริงอย่างครบถ้วน โมเดลอาจยังคงสร้างคำตอบที่ดูสมเหตุสมผลแต่ไม่มีการสนับสนุน
การดึงข้อมูล, เครื่องมือ, และตัวแทน
การสร้างข้อความที่เสริมด้วยการดึงข้อมูลจะให้ข้อความที่เลือกจากชุดข้อมูลภายนอก การเรียกใช้เครื่องมือทำให้โค้ดแอปพลิเคชันสามารถสอบถามฐานข้อมูล, คำนวณ, ค้นหา, หรือดำเนินการได้ รูปแบบเหล่านี้แยกความรู้และการดำเนินการบางส่วนออกจากน้ำหนักของโมเดล
แอปพลิเคชันต้องตรวจสอบอาร์กิวเมนต์ของเครื่องมือ, บังคับใช้การอนุญาต, รักษาการอ้างอิง, และถือเนื้อหาที่ดึงมาเป็นข้อมูลที่ไม่เชื่อถือได้ Vector similarity search ช่วยในการดึงข้อมูลแต่ไม่ได้พิสูจน์ว่าข้อความนั้นสนับสนุนคำตอบ
ข้อจำกัดและการประเมินผล
LLM สามารถสร้างข้อมูลที่ไม่มีอยู่จริง, เปิดเผยเนื้อหาที่จำได้, ปฏิบัติตามคำสั่งที่เป็นอันตราย, ทำซ้ำอคติ, และล้มเหลวในงานที่ดูคล้ายกับตัวอย่างการฝึก บริบทยาวไม่ได้รับประกันว่าข้อเท็จจริงทุกข้อจะถูกใช้หรือประสานอย่างถูกต้อง
ประเมินบนงานส่วนตัวที่เป็นตัวแทนพร้อมคำสั่งและเวอร์ชันที่บันทึกไว้ วัดการสนับสนุนจากแหล่งข้อมูล, การปฏิเสธ, การปรับเทียบ, ความปลอดภัย, ผลลัพธ์ของกลุ่มย่อย, ภาระงานของมนุษย์, ความหน่วง, และค่าใช้จ่าย ตรวจสอบหลังการปล่อยเนื่องจากโมเดล, ข้อมูล, และพฤติกรรมของผู้ใช้เปลี่ยนแปลง
ข้อมูลการฝึกและการพัฒนาโมเดล
คอร์ปัสการฝึกล่วงหน้ารวมหน้าเว็บ, หนังสือ, โค้ด, วัสดุทางวิชาการ, การสนทนา, และแหล่งข้อมูลที่ได้รับอนุญาตหรือคัดสรร กระบวนการตรวจจับภาษาจะลบข้อมูลซ้ำ, กรองคุณภาพและเนื้อหาที่ไม่ปลอดภัย, จัดการข้อมูลส่วนบุคคล, และเลือกน้ำหนักการผสม สิ่งเหล่านี้กำหนดความรู้, ความครอบคลุมของภาษา, สไตล์, อคติ, และการจดจำ
กระบวนการเพิ่มประสิทธิภาพทำงานเป็นชุดของลำดับโทเคนและลดค่า loss ของการทำนายด้วยการทำ gradient descent การฝึกแบบกระจายจะแบ่งข้อมูล, เทนเซอร์ของโมเดล, ขั้นตอนของ pipeline, หรือผู้เชี่ยวชาญไปยังอุปกรณ์เร่งความเร็ว การบันทึกจุดตรวจ, ความเสถียรเชิงตัวเลข, การสื่อสารเครือข่าย, และการกู้คืนข้อผิดพลาดกลายเป็นประเด็นวิศวกรรมหลักเมื่อขยายขนาด
การประเมินระหว่างการฝึกติดตาม loss และชุดความสามารถ, แต่การปนเปื้อนของ benchmark สามารถทำให้ผลลัพธ์บิดเบือน การถือเวลาและงานที่เป็นกรรมสิทธิ์ไว้, ค้นหาการทับซ้อน, และรายงานคำสั่งที่แน่นอน, การถอดรหัส, เครื่องมือ, และการให้คะแนน โมเดลอาจปรับปรุงค่า loss เฉลี่ยในขณะที่เกิดการถดถอยในด้านความปลอดภัยหรือภาษาที่ทรัพยากรต่ำ
หน้าต่างบริบท, การถอดรหัส, และการสรุปผล
ในการสรุปผล, แคช key‑value จะเก็บการฉายภาพ attention ของโทเคนก่อนหน้าเพื่อไม่ต้องคำนวณซ้ำในแต่ละขั้นตอน หน่วยความจำแคชจะเพิ่มขึ้นตามจำนวนชั้น, ลำดับ, batch, และการแสดงผล การควอนติฟายและการแบ่งหน้า ลดภาระแต่สามารถเปลี่ยนคุณภาพหรือความหน่วง
การถอดรหัสแบบกรีดี้เลือกโทเคนที่มีความน่าจะเป็นสูงสุด; อุณหภูมิทำการปรับสเกลความน่าจะเป็น; top‑k และ top‑p จำกัดชุดตัวเลือก; beam search ติดตามหลายลำดับ กลยุทธ์ที่ดีที่สุดขึ้นกับว่าหน้าที่ให้ความสำคัญกับความแน่นอน, ความหลากหลาย, ผลลัพธ์ที่มีโครงสร้าง, หรือความน่าจะเป็นของลำดับ ควรตรวจสอบ schema หลังการสร้างเสมอ
บริบทยาวเพิ่มปริมาณข้อมูลที่มีอยู่, แต่ไม่ได้รับประกันการเรียกคืนหรือการให้เหตุผล ตำแหน่ง, ตัวรบกวน, ความขัดแย้ง, และโครงสร้างของคำสั่งมีผลต่อการใช้งาน การดึงข้อมูลสามารถเลือกชุดหลักฐานที่เล็กลง, ในขณะที่การสรุปย่อประวัติอาจสูญเสียรายละเอียด ควรวัดประสิทธิภาพตามความยาวและตำแหน่งของบริบท
การปรับตัว, การปรับใช้, และเศรษฐศาสตร์
การปรับจูนเต็มรูปแบบอัปเดตพารามิเตอร์ทั้งหมด; วิธีการประหยัดพารามิเตอร์อัปเดตอะแดปเตอร์หรือเมทริกซ์ระดับต่ำ; การฝึกต่อเนื่องปรับการกระจายโดเมน; การปรับจูนด้วยคำสั่งและความชอบกำหนดการตอบกลับ การดึงข้อมูลมักดีกว่าสำหรับข้อเท็จจริงที่เปลี่ยนแปลงบ่อย, ในขณะที่การปรับจูนดีกว่าสำหรับพฤติกรรมและรูปแบบงาน วิธีเหล่านี้สามารถผสานรวมกันได้
ตัวเลือกการปรับใช้รวมถึง API ที่โฮสต์, จุดสิ้นสุดที่จัดการ, น้ำหนักเปิดที่โฮสต์เอง, โมเดลบนอุปกรณ์, และแบบผสม เปรียบเทียบการจัดการข้อมูล, การควบคุมเวอร์ชัน, ความหน่วง, ปริมาณผ่าน, ภูมิภาค, ความพร้อมใช้งาน, ความพกพาของโมเดล, การสนับสนุน, และต้นทุนรวม การโฮสต์เองโอนความรับผิดชอบด้านความปลอดภัย, การขยายขนาด, การอัปเดต, และการตรวจสอบการละเมิด
ค่าใช้จ่ายต่อโทเคนไม่ครบถ้วน โมเดลที่อ่อนอาจต้องทำการลองใหม่, คำสั่งยาวขึ้น, การตรวจทานมากขึ้น, หรือข้อผิดพลาดที่มีค่าใช้จ่ายสูง วัดค่าใช้จ่ายต่อภารกิจที่สำเร็จตามคุณภาพและระดับความเสี่ยงที่ต้องการ ใช้แคช, การทำ batch, โมเดลขนาดเล็กที่กำหนดเส้นทาง, และโค้ดที่กำหนดผลลัพธ์อย่าง deterministic เมื่อพวกมันช่วยปรับปรุงกระบวนการทำงานทั้งหมด
ตัวอย่างการทำงาน: การทำให้ LLM เชื่อมโยงกับเอกสารองค์กร
ผู้ช่วยเอกสารควรเริ่มต้นด้วยคอร์ปัสที่คำนึงถึงการอนุญาต, ตัวระบุเอกสารที่คงที่, เวอร์ชันและวันที่มีผล, โครงสร้างที่สามารถแยกวิเคราะห์ได้, และชุดการประเมินของคำถามที่ตอบได้, ไม่ตอบได้, ก ambiguous, และขัดแย้ง การทำดัชนีการดึงข้อมูลจะจัดทำชิ้นส่วนและเมตาดาต้า, แต่ขนาดชิ้นส่วนและการทับซ้อนต้องสอดคล้องกับโครงสร้างเอกสาร คุณภาพการค้นหาจะวัดแยกจากการสร้างข้อความเพื่อให้โมเดลที่คล่องแคล่วไม่สามารถซ่อนหลักฐานที่หายไปได้
ในระหว่างการทำงาน, ตรวจสอบสิทธิผู้ใช้, กรองการดึงข้อมูลตามการเข้าถึง, ดึงและจัดอันดับหลักฐานใหม่, สร้างคำสั่งที่จำกัด, สร้างคำตอบพร้อมอ้างอิง, และตรวจสอบผลลัพธ์ที่ต้องการ โมเดลควรระบุเมื่อแหล่งข้อมูลขัดแย้งหรือไม่สนับสนุนคำตอบ การใช้เครื่องมือและการกระทำภายนอกต้องการการอนุญาตแยกต่างหาก ปกป้องจากคำสั่งที่ฝังอยู่ในเอกสารที่ดึงมาด้วยการถือเนื้อหาเป็นข้อมูลแทนที่จะเป็นนโยบายระบบที่มีลำดับความสำคัญสูงกว่า
ประเมินการเรียกคืนการดึงข้อมูล, ความแม่นยำของการอ้างอิง, ความถูกต้องของคำตอบ, ความเป็นพื้นฐาน, การปฏิเสธ, ความหน่วง, และค่าใช้จ่ายตามบทบาทและประเภทเอกสาร ติดตามเวอร์ชันของโมเดล, คำสั่ง, ดัชนี, ตัวแยกวิเคราะห์, และคอร์ปัสสำหรับการทดสอบทุกครั้ง ในการผลิต, บันทึก ID ของหลักฐานและข้อเสนอแนะโดยไม่เปิดเผยข้อความส่วนตัว, ตรวจสอบคำถามที่ใหม่ไม่สามารถตอบได้หลังจากเปลี่ยนแปลงเนื้อหา, และรักษาการสำรองที่ปลอดภัย อินเทอร์เฟซ LLM ไม่ได้แทนที่การจัดการบันทึก, การควบคุมการเข้าถึง, หรือการตรวจสอบโดยผู้เชี่ยวชาญที่รับผิดชอบ
การวางแผนความจุควรจำลองการกระจายความยาวของคำสั่งและผลลัพธ์, ผู้ใช้พร้อมกัน, พฤติกรรมแคช, ความหน่วงของเครื่องมือ, และอัตราการลองใหม่ การสตรีมมิ่งช่วยลดความรู้สึกของความหน่วงแต่ทำให้การตรวจสอบและการยกเลิกซับซ้อนเพราะเนื้อหาที่ไม่ปลอดภัยหรือไม่ถูกต้องอาจถึงผู้ใช้ก่อนที่การตอบเต็มจะถูกตรวจสอบ ตั้งงบประมาณโทเคนและเครื่องมือ, แยกผู้เช่า, ปกป้องข้อมูลรับรองของผู้ให้บริการ, และซ้อมการสลับรุ่นโมเดลโดยไม่เปลี่ยนแปลงพฤติกรรมของผู้ใช้โดยเงียบ
รายการตรวจสอบการดำเนินการเชิงปฏิบัติ
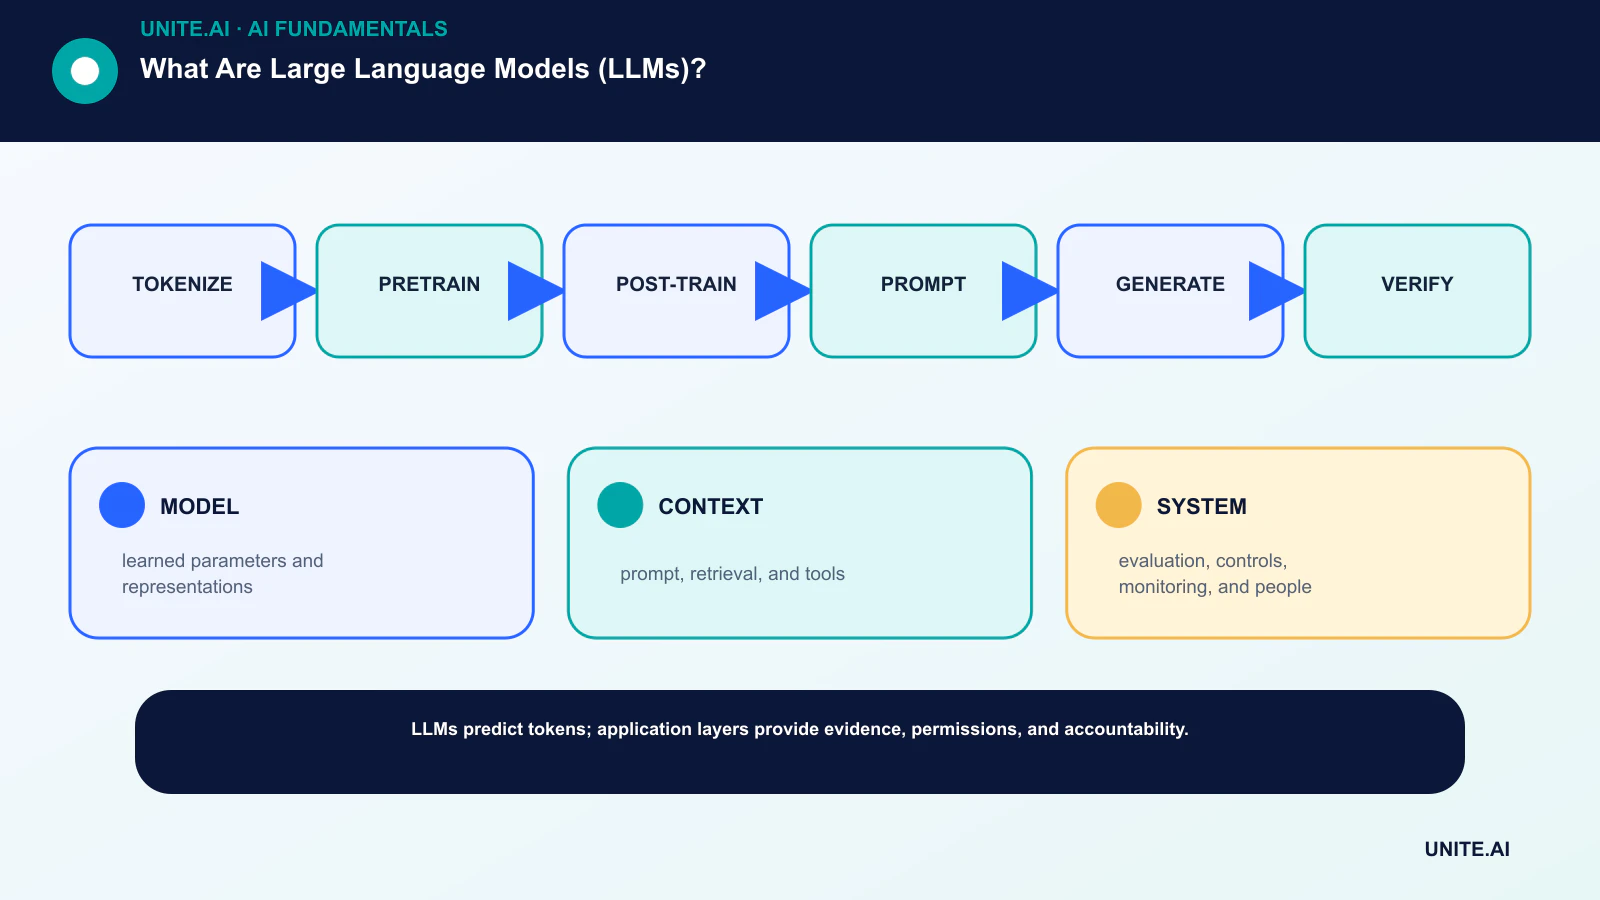
เปลี่ยนแนวคิดให้เป็นกระบวนการทำงานที่จำกัดและทดสอบได้: โทเคนไนซ์ → ฝึกล่วงหน้า → ฝึกหลัง → คำสั่ง → สร้าง → ตรวจสอบ ตั้งเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้างฐานเปรียบเทียบง่าย, กำหนดเกณฑ์การยอมรับและหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการเฝ้าระวัง, การย้อนกลับ, และการตรวจทานก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนเปิดใช้งาน, ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ปฏิบัติการ, ปรับความปลอดภัย, และผู้ที่ได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, การล้มเหลวของการพึ่งพา, และการใช้ในทางที่ผิด; เก็บรักษาหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข
- โมเดล: พารามิเตอร์และการแสดงผลที่เรียนรู้.
- บริบท: คำสั่ง, การดึงข้อมูล, และเครื่องมือ.
- ระบบ: การประเมิน, การควบคุม, การเฝ้าระวัง, และบุคคล.
คำถามที่พบบ่อย
ทำไม LLMs จึงถูกเรียกว่าใหญ่?
ไม่มีเกณฑ์พารามิเตอร์สากล ‘ใหญ่’ หมายถึงขนาดเมื่อเทียบกับโมเดลภาษาก่อนหน้า, รวมถึงพารามิเตอร์, ข้อมูลการฝึก, การคำนวณ, และขอบเขตการใช้งาน
LLMs เข้าใจภาษาหรือไม่?
พวกมันสร้างการแสดงผลภายในที่มีประโยชน์และแสดงพฤติกรรมซับซ้อน, แต่คำว่า ‘เข้าใจ’ มีหลายความหมาย การแสดงผลควรพิสูจน์ด้วยงานจริงแต่ละงานแทนการสรุปจากความคล่องแคล่ว
อ้างอิงหลัก












