
พื้นฐาน AI
การเรียนรู้แบบเสริมคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
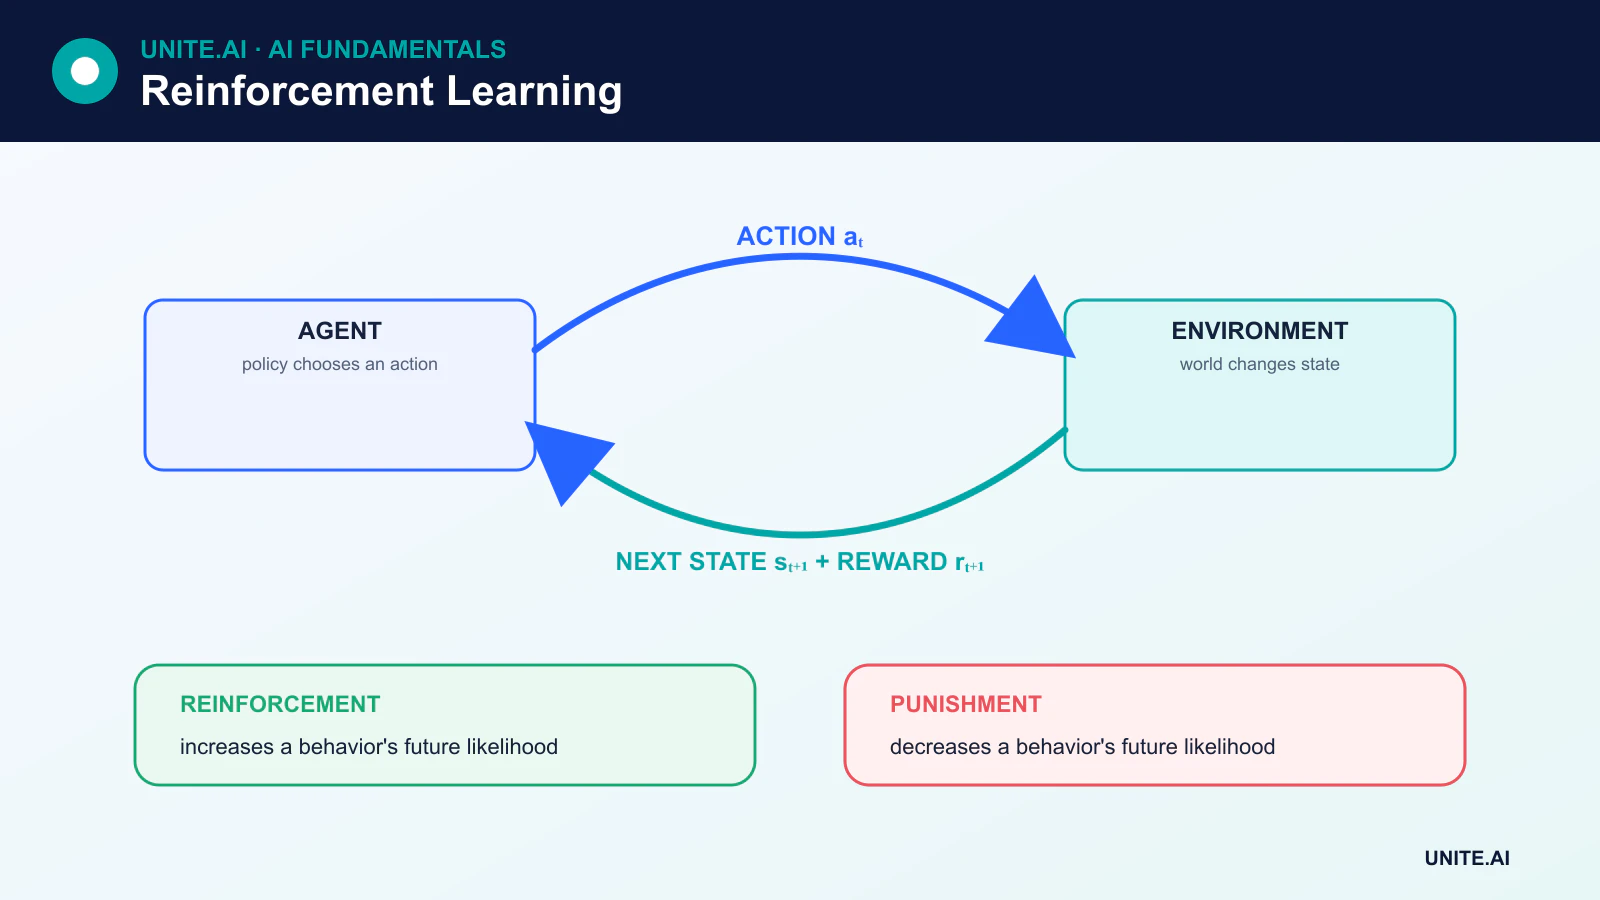
Reinforcement learning (RL) คือกรอบการเรียนรู้ของเครื่องที่เอเจนต์เรียนรู้วิธีการกระทำโดยการโต้ตอบกับสภาพแวดล้อม หลังจากแต่ละการกระทำ สภาพแวดล้อมจะเปลี่ยนแปลงและอาจให้รางวัล เป้าหมายของเอเจนต์คือเรียนรู้นโยบายที่ทำให้ผลรวมของรางวัลที่คาดหวังสูงสุด ไม่ใช่เพียงรางวัลจากการกระทำถัดไปเท่านั้น
RL ถูกใช้เมื่อการตัดสินใจเกิดขึ้นต่อเนื่องตามเวลาและการกระทำหนึ่งส่งผลต่อสิ่งที่จะเกิดขึ้นต่อไป มันแตกต่างเชิงแนวคิดจาก การเรียนรู้แบบมีผู้สอน ซึ่งชุดข้อมูลจะให้คำตอบเป้าหมายสำหรับแต่ละตัวอย่างการฝึก
ประเด็นสำคัญ
- ปัญหา RL ประกอบด้วยเอเจนต์, สภาพแวดล้อม, สถานะ, การกระทำ, รางวัล, และนโยบาย
- การเสริมแรงเชิงบวกและเชิงลบทั้งสองเพิ่มพฤติกรรม; การลงโทษทำให้พฤติกรรมลดลง
- เอเจนต์ต้องสมดุลระหว่างการสำรวจการกระทำที่ไม่คุ้นเคยกับการใช้ประโยชน์จากการกระทำที่รู้ว่ามีประสิทธิภาพแล้ว
- วิธีการแบบอิงค่า, แบบอิงนโยบาย, แบบผู้กระทำ-ผู้วิจารณ์, แบบอิงโมเดล, และแบบออฟไลน์แก้ไขสถานการณ์ RL ที่แตกต่างกัน
ส่วนประกอบของการเรียนรู้แบบเสริม
หลายปัญหา RL ถูกจำลองเป็น กระบวนการตัดสินใจแบบมาร์คอฟ (MDP) MDP ประกอบด้วย:
- State: ข้อมูลที่อธิบายสถานการณ์ปัจจุบัน
- Action: ตัวเลือกที่เอเจนต์สามารถทำได้
- Transition: วิธีที่สถานะเปลี่ยนแปลงหลังจากการกระทำ
- Reward: ข้อเสนอแนะทันทีที่เกิดจากการเปลี่ยนแปลง
- Policy: กลยุทธ์ของเอเจนต์ในการเลือกการกระทำ
- Discount factor: ความสำคัญของรางวัลในอนาคตเทียบกับรางวัลทันที
สถานะไม่จำเป็นต้องเปิดเผยทุกอย่างเกี่ยวกับโลก เมื่อข้อมูลสำคัญถูกซ่อน ปัญหาอาจเป็นแบบที่สังเกตได้ส่วนหนึ่งและเอเจนต์อาจต้องใช้หน่วยความจำหรือสถานะความเชื่อ
การเสริมแรงไม่เท่ากับการลงโทษ
คำศัพท์มาจากจิตวิทยาพฤติกรรม การเสริมแรงเชิงบวก เพิ่มผลลัพธ์ที่ทำให้พฤติกรรมเกิดขึ้นบ่อยขึ้น การเสริมแรงเชิงลบ กำจัดสภาวะที่ไม่พึงประสงค์และก็ทำให้พฤติกรรมเกิดขึ้นบ่อยขึ้น การลงโทษที่มีจุดประสงค์ทำให้การกระทำเกิดขึ้นน้อยลงไม่ใช่การเสริมแรงเชิงลบ
ในแมชชีนเลิร์นนิง ผู้ปฏิบัติมักพูดโดยตรงเกี่ยวกับรางวัลเชิงบวก, รางวัลเชิงลบ, ค่าใช้จ่าย, และการลงโทษ ประเด็นสำคัญคือสัญญาณเหล่านี้มีผลต่อผลตอบแทนที่เอเจนต์พยายามทำให้สูงสุดอย่างไร
ผลตอบแทน, มูลค่า, และการมอบเครดิต
รางวัลอธิบายการเปลี่ยนแปลงหนึ่งครั้ง ผลตอบแทน รวมรางวัลตามเวลา โดยมักลดค่ารางวัลที่มาถึงในอนาคตไกล ฟังก์ชัน ค่ามูลค่าของสถานะ ประมาณค่าผลตอบแทนที่คาดหวังจากสถานะหนึ่ง ในขณะที่ ค่ามูลค่าของการกระทำ ประมาณค่าผลตอบแทนที่คาดหวังหลังจากทำการกระทำใดการกระทำหนึ่งในสถานะนั้น
นี่ทำให้เกิดปัญหาการมอบเครดิต: หากผลลัพธ์ที่เป็นประโยชน์มาช้า มากกว่าการกระทำก่อนหน้าใดควรได้รับเครดิต? อัลกอริทึม RL แตกต่างกันในวิธีการประมาณความสัมพันธ์นี้
การเรียนรู้แบบมอนติคาโรลและความแตกต่างเชิงเวลา
วิธีมอนติคาโรล เรียนรู้จากผลตอบแทนที่สุ่มครบถ้วน โดยทั่วไปหลังจากตอนจบ วิธีความแตกต่างเชิงเวลา (TD) ปรับประมาณค่าก่อนผลลัพธ์สุดท้ายโดยผสมรางวัลที่สังเกตได้กับการประมาณของสิ่งที่จะเกิดต่อไป การเรียนรู้แบบ TD จึงอ้างอิงจากการประมาณค่าปัจจุบันของมันเอง
ไม่มีวิธีใดดีกว่าแบบทั่วโลก เป้าหมายของมอนติคาโรลไม่มีอคติภายใต้นโยบายที่สุ่มแต่มีความแปรปรวนสูงและต้องการให้ตอนจบสมบูรณ์ วิธี TD สามารถเรียนรู้ออนไลน์และจากงานต่อเนื่องได้ แต่เป้าหมายที่อ้างอิงอาจทำให้เกิดอคติ
การสำรวจเทียบกับการใช้ประโยชน์
การสำรวจ เก็บข้อมูลโดยลองการกระทำที่ค่าของมันไม่แน่นอน การใช้ประโยชน์ เลือกการกระทำที่เชื่อว่ามีผลตอบแทนดีที่สุด เอเจนต์ที่ไม่เคยสำรวจอาจยอมรับกลยุทธ์ที่แย่; เอเจนต์ที่ไม่เคยใช้ประโยชน์จะไม่ได้รับประโยชน์จากสิ่งที่เรียนรู้
กลยุทธ์ง่ายๆ ได้แก่ การเลือกการกระทำแบบ epsilon-greedy, การสำรวจตามความมั่นใจ, โบนัสเอนโทรปี, และวิธีรางวัลภายใน ในสภาพแวดล้อมที่ความปลอดภัยสำคัญ การสำรวจโดยไม่มีข้อจำกัดอาจไม่ยอมรับได้ ดังนั้นการจำลอง, ข้อจำกัด, ข้อมูลออฟไลน์, หรือการตรวจสอบโดยมนุษย์จึงเป็นสิ่งสำคัญ
แนวทางการเรียนรู้แบบเสริมหลัก
วิธีอิงค่า
Q-learning และอัลกอริทึมที่เกี่ยวข้องเรียนรู้ค่าของการกระทำและสร้างนโยบายโดยเลือกการกระทำที่มีค่ามาก วิธี การเรียนรู้แบบเสริมเชิงลึก ใช้เครือข่ายประสาทเทียมเพื่อประมาณฟังก์ชันค่า หรือ นโยบายเมื่อพื้นที่สถานะใหญ่เกินกว่าตารางจะครอบคลุม
วิธีอิงนโยบาย
วิธีอิงนโยบายปรับนโยบายที่มีพารามิเตอร์โดยตรงเพื่อเพิ่มผลตอบแทนที่คาดหวัง มีประโยชน์สำหรับการกระทำต่อเนื่องและนโยบายแบบสุ่ม แต่การประมาณค่า gradient อาจมีความแปรปรวนสูง
วิธีผู้กระทำ-ผู้วิจารณ์
ผู้กระทำเลือกการกระทำในขณะที่ผู้วิจารณ์ประเมินค่ามูลค่าและให้สัญญาณการเรียนรู้ วิธีนี้ผสานการปรับนโยบายโดยตรงกับการประมาณค่ามูลค่า
RL แบบอิงโมเดลและแบบไม่มีโมเดล
ระบบอิงโมเดลเรียนรู้หรือใช้โมเดลของการเปลี่ยนแปลงและรางวัลเพื่อให้สามารถวางแผนได้ ระบบไม่มีโมเดลเรียนรู้ค่าหรือนโยบายโดยไม่ต้องสร้างโมเดลของสภาพแวดล้อมอย่างชัดเจน วิธีอิงโมเดลสามารถใช้ประสบการณ์ได้อย่างมีประสิทธิภาพ แต่ข้อผิดพลาดในโมเดลที่เรียนรู้อาจทำให้การวางแผนผิดพลาด
การเรียนรู้แบบเสริมแบบออฟไลน์
RL แบบออฟไลน์เรียนรู้จากชุดข้อมูลคงที่แทนการเก็บข้อมูลการโต้ตอบใหม่ระหว่างการฝึก สามารถลดต้นทุนหรือความเสี่ยงของการสำรวจได้ แต่เอเจนต์ต้องหลีกเลี่ยงการประเมินค่าการกระทำที่มีการแสดงในข้อมูลไม่เพียงพอเกินไป
RLHF และความชอบของมนุษย์
การเรียนรู้แบบเสริมจากข้อเสนอแนะของมนุษย์ (RLHF) ใช้ข้อมูลความชอบเพื่อฝึกสัญญาณรางวัลหรือปรับนโยบายโดยตรง ได้ถูกใช้เพื่อทำให้พฤติกรรมของโมเดลภาษาเป็นไปตามการตัดสินของมนุษย์ การเพิ่มประสิทธิภาพตามความชอบไม่ได้รับประกันความจริงหรือความปลอดภัย: ผลลัพธ์ขึ้นอยู่กับผู้ให้ข้อเสนอแนะ, สิ่งที่พวกเขาถูกถามให้ประเมิน, และวิธีการออกแบบวัตถุประสงค์
ข้อจำกัด
RL อาจต้องการจำนวนการโต้ตอบมหาศาล, มีพฤติกรรมไม่เสถียรระหว่างการฝึก, และใช้ช่องโหว่ที่ไม่ตั้งใจในฟังก์ชันรางวัล การประเมินยากเพราะผลลัพธ์อาจแตกต่างตามค่า random seed และรายละเอียดของสภาพแวดล้อม การปฏิบัติที่ดีควรรวมถึงการรันหลายครั้ง, ฐานเปรียบเทียบที่โปร่งใส, วัตถุประสงค์ที่จำกัด, การทดสอบนอกการกระจาย, และการตรวจสอบการแฮ็กรางวัล
การออกแบบปัญหา RL: สถานะ, การกระทำ, รางวัล, และระยะเวลา
การเรียนรู้แบบเสริมจำลองการตัดสินใจต่อเนื่อง สภาพแวดล้อมสร้างการสังเกต, เอเจนต์เลือกการกระทำตามนโยบาย, และการเปลี่ยนแปลงให้รางวัลและการสังเกตต่อไป กระบวนการตัดสินใจแบบมาร์คอฟสมมติว่าสถานะมีข้อมูลที่จำเป็นเพื่อทำนายการเปลี่ยนแปลงและรางวัลในอนาคต; การสังเกตที่ไม่สมบูรณ์ต้องการหน่วยความจำ, สถานะความเชื่อ, หรือการแทนที่แบบวนซ้ำ การลดค่าควบคุมน้ำหนักของผลลัพธ์ที่ล่าช้า, ในขณะที่งานแบบตอนจบและต่อเนื่องต้องการการกำหนดผลตอบแทนที่ต่างกัน การออกแบบสถานะหรือการกระทำที่แย่สามารถทำให้วัตถุประสงค์ที่แก้ได้กลายเป็นไม่สามารถเรียนรู้ได้
การออกแบบรางวัลระบุพฤติกรรมโดยอ้อมและเป็นแหล่งความล้มเหลือสำคัญ ตัวแทนอาจถูกใช้ประโยชน์: เอเจนต์ที่ได้รับรางวัลจากความเร็วอาจละเลยความปลอดภัย, ในขณะที่เอเจนต์ที่ได้รับรางวัลเฉพาะเมื่อทำภารกิจเสร็จอาจได้รับสัญญาณการเรียนรู้น้อยเกินไป เพิ่มข้อจำกัดและกฎการสิ้นสุดตามความต้องการจริง, ทดสอบความไวของรางวัล, และตรวจสอบเส้นทางเพื่อหากลยุทธ์ที่ไม่ตั้งใจ วิธีการสำรวจต้องสมดุลระหว่างการเก็บข้อมูลกับการใช้ประโยชน์จากความรู้ปัจจุบัน ข้อมูลนอกนโยบายสามารถเพิ่มประสิทธิภาพการสุ่มตัวอย่าง, แต่ความไม่ตรงกันระหว่างพฤติกรรมและนโยบายเป้าหมายต้องการอัลกอริทึมที่ออกแบบมาสำหรับกรณีนั้น
การประเมิน, การจำลอง, และการใช้งานอย่างปลอดภัย
วิธีอิงค่าประมาณผลตอบแทนที่คาดหวังสำหรับสถานะหรือการกระทำ; วิธีอิงนโยบายปรับนโยบายที่มีพารามิเตอร์; วิธีผู้กระทำ-ผู้วิจารณ์เรียนรู้ทั้งสองอย่าง RL แบบอิงโมเดลเรียนรู้หรือใช้พลวัตการเปลี่ยนแปลงเพื่อวางแผน ครอบครัวที่เหมาะสมขึ้นอยู่กับประเภทการกระทำ, ข้อมูล, ความแม่นยำของตัวจำลอง, ระยะเวลา, และความต้องการความเสถียร เปรียบเทียบกับฐานเชิงอรรถ, การเรียนรู้แบบมีผู้สอน, และฐานทฤษฎีการควบคุม ประเมินผลตอบแทนเฉลี่ยและในกรณีแย่ที่สุด, การละเมิดข้อจำกัด, ประสิทธิภาพการสุ่มตัวอย่าง, ความทนทานต่อการเปลี่ยนแปลงของสภาพแวดล้อม, และความแปรปรวนระหว่าง seed แทนการเลือกรันที่มีเส้นโค้งการเรียนรู้ดีที่สุด
การสำรวจออนไลน์อาจไม่ยอมรับได้ในด้านสุขภาพ, การเงิน, หุ่นยนต์, และโครงสร้างพื้นฐาน ฝึกในตัวจำลองหรือข้อมูลบันทึกเมื่อเป็นไปได้, ประเมินช่องว่างระหว่างตัวจำลองกับความเป็นจริง, และใช้การประเมินนอกนโยบายอย่างระมัดระวังเพราะการกระทำที่ไม่เคยเห็นไม่มีการสนับสนุน การใช้งานควรจำกัดการกระทำ, อัตรา, ทรัพยากร, และพื้นที่การทำงาน; รวมการอนุมัติของมนุษย์สำหรับการตัดสินใจที่สำคัญ; และให้ตัวควบคุมหรือการปิดระบบที่ปลอดภัย ตรวจสอบรางวัลพร้อมกับผลลัพธ์จริงเพราะเอเจนต์อาจเพิ่มคะแนนแต่ทำอันตรายต่อวัตถุประสงค์ที่ตั้งไว้ ตรวจสอบใหม่หลังจากสภาพแวดล้อม, นโยบาย, หรือรางวัลเปลี่ยนแปลง
ตัวอย่างการทำงาน: การควบคุมพลังงานด้วยการเรียนรู้แบบเสริม
ผู้ดำเนินการอาคารจำลองอุณหภูมิ, การเข้าพัก, สภาพอากาศ, สถานะอุปกรณ์, และราคาพลังงานไฟฟ้า โดยการกระทำจำกัดอยู่ที่การปรับค่าเซ็ตพอยต์อย่างปลอดภัย รางวัลรวมความสบาย, พลังงาน, ค่าธรรมเนียมความต้องการ, และข้อจำกัดของอุปกรณ์ แต่การละเมิดความสบายจริงจะประเมินแยกต่างหากเพื่อให้การเพิ่มประสิทธิภาพรางวัลไม่ซ่อนความเสียหาย การควบคุมแบบประวัติและการควบคุมเชิงพยากรณ์โมเดลเป็นฐาน การฝึกใช้ตัวจำลองที่ปรับเทียบพร้อมสภาพอากาศสุ่ม, เสียงเซนเซอร์, และประสิทธิภาพอุปกรณ์
ก่อนที่จะมีผลต่ออาคาร นโยบายจะทำงานกับการสังเกตแบบสดโดยไม่กระทำใดๆ วิศวกรตรวจสอบเส้นทาง, ระยะขอบของข้อจำกัด, และพฤติกรรมในช่วงวันหยุด, คลื่นความร้อน, การดับไฟ, และเซนเซอร์ที่หายไป การใช้งานจำกัดอัตราและช่วงการกระทำและยังคงใช้ตัวควบคุมความปลอดภัยเดิม ผู้ใช้สามารถแทรกแซงได้ตลอดเวลา การตรวจสอบเปรียบเทียบพลังงานและความสบายกับช่วงเวลาที่ตรงกัน, บันทึกการแทรกแซง, และย้อนกลับหากมีการละเมิด, การวนซ้ำที่ไม่คาดคิด, หรือความไม่ตรงกันของโมเดลเกินเกณฑ์ที่กำหนด
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานเปรียบเทียบที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับจูน ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการสอบเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดูดึงดูด
ก่อนเปิดตัว ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นเป็นขั้น, เก็บสำรองที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยการฉีดความล้มเหลวโดยเจตนา เทเลเมทรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการใช้งานแทนการสมมติว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่ทุกครั้งที่แหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
อ้างอิงหลัก












