พื้นฐาน AI
การเรียนรู้เมตาคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การเรียนรู้เมตา ฝึกระบบผ่านการกระจายของงานหลายงานเพื่อให้สามารถปรับตัวกับงานใหม่ที่เกี่ยวข้องโดยใช้ข้อมูลหรือการคำนวณที่จำกัด มักสรุปเป็น “เรียนรู้ที่จะเรียนรู้” แต่เป้าหมายทางเทคนิคคือ: ปรับให้ผู้เรียนทำงานได้ดีขึ้นโดยประสบการณ์จากงานก่อนหน้าเพิ่มประสิทธิภาพการปรับตัวต่อภายหลัง
การเรียนรู้เมตาเกี่ยวข้องกับ การเรียนรู้แบบตัวอย่างน้อย และ การเรียนรู้แบบถ่ายโอน แต่คำเหล่านี้ไม่สามารถใช้แทนกันได้ “การเรียนรู้แบบตัวอย่างน้อย” บ่งบอกถึงจำนวนข้อมูลเป้าหมาย; “การเรียนรู้แบบถ่ายโอน” บ่งบอกถึงการนำกลับมาใช้ใหม่; การเรียนรู้เมตาโดยตรงทำให้การปรับตัวข้ามงานเป็นส่วนหนึ่งของการฝึก
ประเด็นสำคัญ
- การฝึกเมตาใช้หลายงาน ไม่ใช่แค่ตัวอย่างอิสระจำนวนมาก
- เอพิโซดแบบ N-way K-shot มี N คลาสและ K ตัวอย่างสนับสนุนที่มีป้ายกำกับต่อคลาส
- วิธีการแบบอิงเกรเดียนท์, แบบอิงเมตริก, แบบอิงหน่วยความจำ, และออปติไมเซอร์ที่เรียนรู้ได้ ปรับตัวในรูปแบบที่แตกต่างกัน
- ประสิทธิภาพขึ้นอยู่กับว่าหน้าที่ฝึกเมตาเหมือนกับงานเป้าหมายหรือไม่อย่างมาก
งาน, ชุดสนับสนุน, และชุดสอบถาม
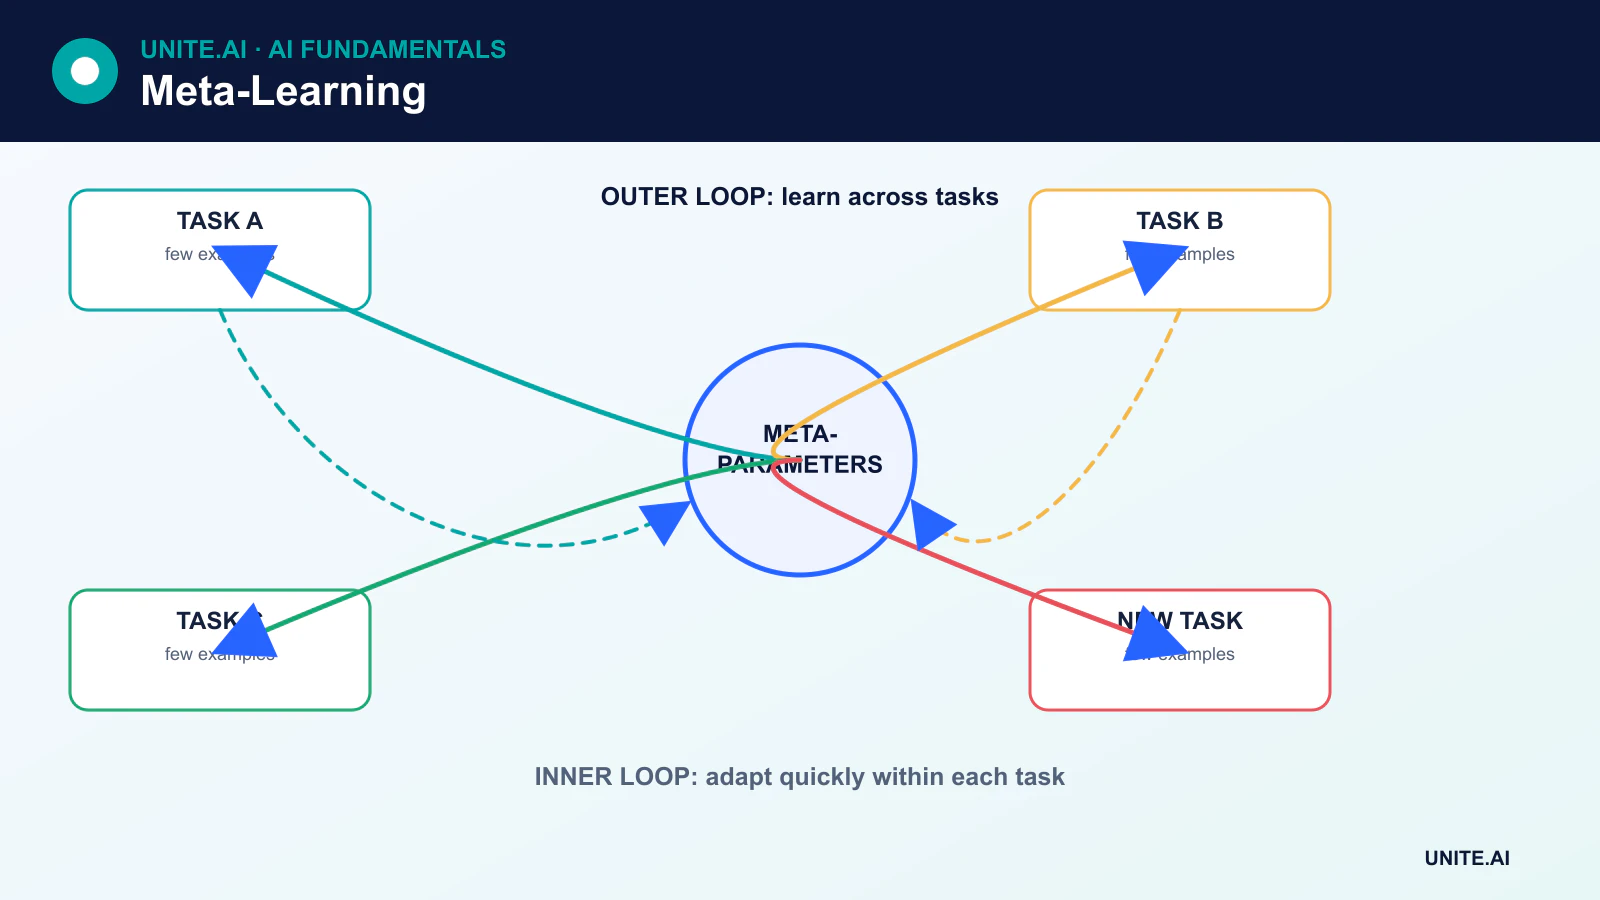
ชุดข้อมูลการเรียนรู้เมตาถูกจัดระเบียบเป็นงาน ในการจำแนกแบบตัวอย่างน้อย เอพิโซดอาจเป็น 5-way 1-shot: ห้าคลาส, ตัวอย่างสนับสนุนหนึ่งตัวต่อคลาส, และตัวอย่างสอบถามเพิ่มเติมเพื่อประเมินการปรับตัว งาน 5-way 5-shot มีตัวอย่างสนับสนุนห้าตัวต่อคลาสห้า คลาส—not ตัวอย่างทั้งหมดห้าตัว
ระหว่างการฝึกเมตา ผู้เรียนจะปรับตัวซ้ำ ๆ บนชุดสนับสนุนและถูกประเมินบนชุดสอบถาม วัตถุประสงค์ภายนอกจะปรับปรุงประสิทธิภาพของชุดสอบถามในงานต่อ ๆ ไป การตรวจสอบเมตา (meta‑validation) ปรับตัวเลือกบนงานแยกต่างหาก และการทดสอบเมตา (meta‑testing) ประเมินงานหรือคลาสที่ไม่เคยเห็นมาก่อน
การเรียนรู้เมตาแบบอิงเกรเดียนท์
Model-Agnostic Meta-Learning (MAML) เรียนรู้การเริ่มต้นที่ทำให้การก้าวเกรเดียนท์จำนวนเล็กน้อยให้ผลลัพธ์ดีบนงานใหม่ ลูปภายในปรับพารามิเตอร์โมเดลโดยใช้ข้อมูลสนับสนุน ลูปภายนอกอัปเดตการเริ่มต้นร่วมโดยใช้ค่าความสูญเสียจากชุดสอบถามบนงานที่สุ่มเลือก
MAML ไม่จำกัดเฉพาะการจำแนก; สามารถนำไปใช้กับการถดถอยและ การเรียนรู้แบบเสริมแรง เมื่อโมเดลและงานสามารถทำอนุพันธ์ได้ Reptile เสนอวิธีการอันดับแรกที่ง่ายกว่าโดยย้ายพารามิเตอร์ไปสู่วิธีแก้ที่ปรับตามงานโดยไม่ต้องคำนวณเมตา‑เกรเดียนท์เต็มรูปแบบของ MAML
การเรียนรู้เมตาแบบอิงเมตริก
วิธีการแบบอิงเมตริกเรียนรู้การฝังเวกเตอร์ที่ตัวอย่างจากคลาสเดียวกันอยู่ใกล้กันและคลาสต่างกันแยกออกจากกัน เครือข่ายต้นแบบ (prototypical network) เฉลี่ยเวกเตอร์สนับสนุนเพื่อสร้างต้นแบบหนึ่งต่อคลาส แล้วจำแนกตัวอย่างสอบถามโดยวัดระยะทางถึงต้นแบบเหล่านั้น
เครือข่าย Matching และ Siamese‑style ใช้กลไกความคล้ายคลึงที่เกี่ยวข้อง วิธีเหล่านี้ไม่ได้แค่ตรวจสอบว่าโมเดล “ตีเป้าหมายเมตริก” หรือไม่; ระยะทางหรือการแทนค่าที่เรียนรู้เป็นส่วนหนึ่งของกระบวนการพยากรณ์เอง
วิธีการแบบอิงหน่วยความจำและออปติไมเซอร์ที่เรียนรู้ได้
ระบบแบบอิงหน่วยความจำใช้สถานะแบบ recurrent หรือ attention เพื่อเก็บข้อมูลเกี่ยวกับงานปัจจุบัน ออปติไมเซอร์ที่เรียนรู้ได้รับเกรเดียนท์หรือสัญญาณการฝึกเป็นอินพุตและเรียนรู้วิธีอัปเดตโมเดลอื่น ๆ วิธีเหล่านี้สามารถค้นกฎการปรับตัวได้ แต่เพิ่มพารามิเตอร์, ค่าความซับซ้อนของการคำนวณ, และระดับความเสี่ยงของการ over‑fitting เพิ่มขึ้น
การเรียนรู้เมตากับการเรียนรู้ในบริบท
Transformer ขนาดใหญ่สามารถปรับผลลัพธ์จากตัวอย่างที่ใส่ใน prompt ได้โดยไม่ต้องอัปเดตน้ำหนัก ซึ่งเรียกว่า “การเรียนรู้ในบริบท” พฤติกรรมนี้คล้ายกับการเรียนรู้เมตาและข้อมูลการฝึกอาจกระตุ้นให้โมเดลสรุปงานได้ แต่ผู้เรียนในบริบทไม่ได้รับการฝึกโดยอัตโนมัติด้วยวัตถุประสงค์เมตา‑episodic แบบคลาสสิก
การประยุกต์ใช้การเรียนรู้เมตา
การใช้งานที่เป็นไปได้รวมถึงการปรับให้เป็นส่วนบุคคล, หุ่นยนต์, การจดจำในทรัพยากรต่ำ, งานวิทยาศาสตร์ที่มีข้อมูลวัดผลน้อย, และการปรับตัวอย่างรวดเร็วต่อสภาพแวดล้อมใหม่ การเรียนรู้เมตาน่าสนใจที่สุดเมื่อมีงานต้นทางที่เกี่ยวข้องหลายงานแต่ข้อมูลงานเป้าหมายมีจำกัด
ข้อจำกัด
การเรียนรู้เมตาอาจใช้ทรัพยากรคอมพิวเตอร์มากเนื่องจากการฝึกต้องฝังการปรับตัวภายในกระบวนการเพิ่มประสิทธิภาพ ผลลัพธ์อ่อนไหวต่อการสร้างงาน, การรั่วไหลของชุดสนับสนุน/สอบถาม, สถาปัตยกรรม, และการเปลี่ยนแปลงโดเมน โมเดลที่ฝึกบนงานแคบและเป็นเอกภาพอาจปรับตัวได้แย่เมื่อออกนอกการกระจายดังกล่าว
การเปรียบเทียบควรรวมถึงการถ่ายโอนแบบดั้งเดิมและฐานหลายงาน การใช้ตัวแทนที่ฝึกล่วงหน้าที่แข็งแกร่งแล้วทำ fine‑tuning มาตรฐานอาจง่ายและมีประสิทธิภาพมากกว่าวิธีการเรียนรู้เมตาที่ออกแบบเฉพาะ
งาน, การปรับตัว, และโครงสร้างการเพิ่มประสิทธิภาพภายใน–ภายนอก
การเรียนรู้เมตาฝึกผ่านการกระจายของงานเพื่อให้ผู้เรียนสามารถปรับตัวกับงานใหม่ด้วยข้อมูลหรือการอัปเดตที่จำกัด แต่ละเอพิโซดสุ่มเลือกงาน, แบ่งตัวอย่างเป็นชุดสนับสนุนสำหรับการปรับตัวและชุดสอบถามสำหรับการประเมิน, แล้วอัปเดตความรู้ร่วมกันข้ามเอพิโซด วิธีการแบบอิงเมตริกเรียนรู้การฝังและกฎการเปรียบเทียบ; วิธีการแบบอิงการเพิ่มประสิทธิภาพเรียนรู้การเริ่มต้นหรือพฤติกรรมการอัปเดต; วิธีการแบบอิงหน่วยความจำและโมเดลอาศัยตัวอย่างงาน การกระจายของงานคือข้อมูลฝึกจริงและต้องคล้ายกับปัญหาการปรับตัวในอนาคต
ใน Model‑Agnostic Meta‑Learning ลูปภายในปรับพารามิเตอร์บนตัวอย่างสนับสนุนและลูปภายนอกเพิ่มประสิทธิภาพบนตัวอย่างสอบถามหลังการปรับ ตัวเกรเดียนท์ระดับสูงอาจมีค่าใช้จ่ายสูง; การประมาณแบบอันดับแรกแลกกับความแม่นยำ Reptile ใช้แนวคิดคล้ายกันโดยไม่คำนวณเมตา‑เกรเดียนท์เต็มรูปแบบ เครือข่ายต้นแบบแทนแต่ละคลาสด้วยศูนย์กลางของชุดสนับสนุนและจำแนกโดยระยะทาง วิธีเหล่านี้สมมติว่ารูปทรงของคลาส, ขั้นตอนการปรับตัว, และการสร้างเอพิโซดสอดคล้องกับการใช้งานจริง วิธีหนึ่งอาจดูเหมือนเรียนรู้เร็วแต่กลับใช้ประโยชน์จากป้ายกำกับคงที่, ศิลปะการเก็บข้อมูล, หรือการทับซ้อนของชุดข้อมูลต้นทาง
การประเมิน, เกณฑ์มาตรฐาน, และข้อจำกัดในโลกจริง
ต้องแยกงานฝึก, งานตรวจสอบ, และงานทดสอบ—not เพียงตัวอย่าง—เพื่อวัดการปรับตัวต่องานที่ไม่เคยเห็นจริง รายงานความแม่นยำหรือค่าความสูญเสียตามจำนวนตัวอย่างและขั้นตอนการปรับ, ช่วงความเชื่อมั่นข้ามงาน, การใช้คอมพิวเตอร์, หน่วยความจำ, และความอ่อนไหวต่อการจัดองค์ประกอบของชุดสนับสนุน เปรียบเทียบกับการถ่ายโอน, การ fine‑tuning โมเดลที่ฝึกล่วงหน้า, nearest neighbors, และโมเดลที่ฝึกร่วมกันบนข้อมูลต้นทางทั้งหมด หลายกรณีที่ดูเหมือนการได้เปรียบจากการเรียนรู้เมตาจะหดลงเมื่อฐานมาตรฐานได้รับ backbone, การเพิ่มข้อมูล, และการปรับจูนเทียบเท่า
การนำไปใช้จริงต้องมีวิธีระบุเมื่อ งานใหม่อยู่นอกการกระจายของการฝึกเมตา ตัวอย่างสนับสนุนที่ผิดพลาดหรือป้ายกำกับผิดอาจทำให้ระบบล้มเหลวอย่างมั่นใจอย่างรวดเร็ว จำกัดขนาดการอัปเดต, ตรวจสอบโมเดลที่ปรับแล้ว, เก็บสำรอง, และป้องกันข้อมูลการปรับจากการโจมตี ตรวจสอบโมเดลฐาน, ตัวสุ่มงาน, seed ของเอพิโซด, และโค้ดการปรับตัว การเรียนรู้เมตามีประโยชน์ต่อกลุ่มปัญหาข้อมูลน้อยที่ทำซ้ำได้ แต่ไม่ได้สร้างความสามารถในการเรียนรู้อย่างทั่วไปจากตัวอย่างใด ๆ และไม่ขจัดความจำเป็นของการประเมินตามโดเมน
ตัวอย่างทำงาน: การปรับตัวแบบ few-shot ข้ามเครื่องจักร
ผู้ผลิตถือแต่ละประเภทเครื่องจักรเป็นงานหนึ่งและฝึกเมตาเพื่อสร้างตัวแทนความผิดปกติข้ามเครื่องจักรหลายเครื่องที่มีผลการบำรุงรักษายืนยัน เครื่องจักรทดสอบจะถูกแยกออกจากการฝึกงานทั้งหมด สำหรับเครื่องจักรใหม่ ชุดสนับสนุนขนาดเล็กครอบคลุมโหมดการทำงานปกติแทนที่จะเป็นข้อมูลหลายนาทีแบบสุ่ม การเรียนรู้เมตาถูกเปรียบเทียบกับ encoder ที่ฝึกล่วงหน้าแบบ frozen, nearest neighbors, และการ fine‑tuning ปกติโดยใช้ชุดสนับสนุนและคอมพิวเตอร์เดียวกัน
การประเมินทำซ้ำหลายครั้งด้วยการเลือกชุดสนับสนุนต่าง ๆ และรายงานอัตราการเรียกคืนเหตุการณ์, การเตือนเท็จ, เวลาในการปรับตัว, และความแปรปรวน ระบบจะละเว้นเมื่อเซนเซอร์หรือพลวัตของเครื่องใหม่อยู่นอกการกระจายของงาน การอัปเดตการปรับตัวถูกจำกัดและตรวจสอบก่อนนำไปใช้ในการบำรุงรักษา ป้ายกำกับสนับสนุนและข้อมูลเครื่องจักรถูกปกป้องจากการโจมตี และโมเดลที่ปรับแล้วทุกตัวจะเก็บเวอร์ชันฐานและตัวอย่างไว้ การปรับตัวอย่างรวดเร็วจะได้รับการยอมรับเฉพาะเมื่อทำได้ดีกว่าการถ่ายโอนแบบง่ายภายใต้การเปลี่ยนแปลงงานที่เป็นจริง
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจเชิงผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้างฐานมาตรฐานที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับจูน ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจได้รับบริการไม่เพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วงเวลา, ปริมาณการประมวลผล, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทั้งหมดเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนเปิดใช้งาน มอบอำนาจการปล่อย, ยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยความล้มเหลวที่ฉีดเข้าโดยเจตนา Telemetry การปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนไปเกินจำเป็น กำหนดเกณฑ์การเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงที่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษาข้อมูล, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
การกระตุ้นแบบ few-shot เป็นการเรียนรู้เมตาหรือไม่?
การกระตุ้นแบบ few-shot เป็นเทคนิคการปรับตัวในบริบท มันอาจแสดงพฤติกรรมที่คล้ายกับการเรียนรู้ข้ามงาน แต่ไม่ได้รับการฝึกโดยอัตโนมัติด้วยเอพิโซดสนับสนุน/สอบถามหรือวงจรเมตา‑เพิ่มประสิทธิภาพที่ชัดเจน
ความเสี่ยงใหญ่ที่สุดของการเรียนรู้เมตาคืออะไร?
การไม่ตรงกันระหว่างงานฝึกเมตากับงานเป้าหมายอาจทำให้การปรับตัวเร็วดูแข็งแกร่งในเบนช์มาร์คแต่ล้มเหลวในการใช้งานจริง การแบ่งงานและที่มาของข้อมูลต้นทางต้องได้รับการตรวจสอบอย่างละเอียดเทียบเท่าการแบ่ง train/test ปกติ
อ้างอิงหลัก