
พื้นฐาน AI
การเรียนรู้แบบมีผู้สอน vs การเรียนรู้แบบไม่มีผู้สอน

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
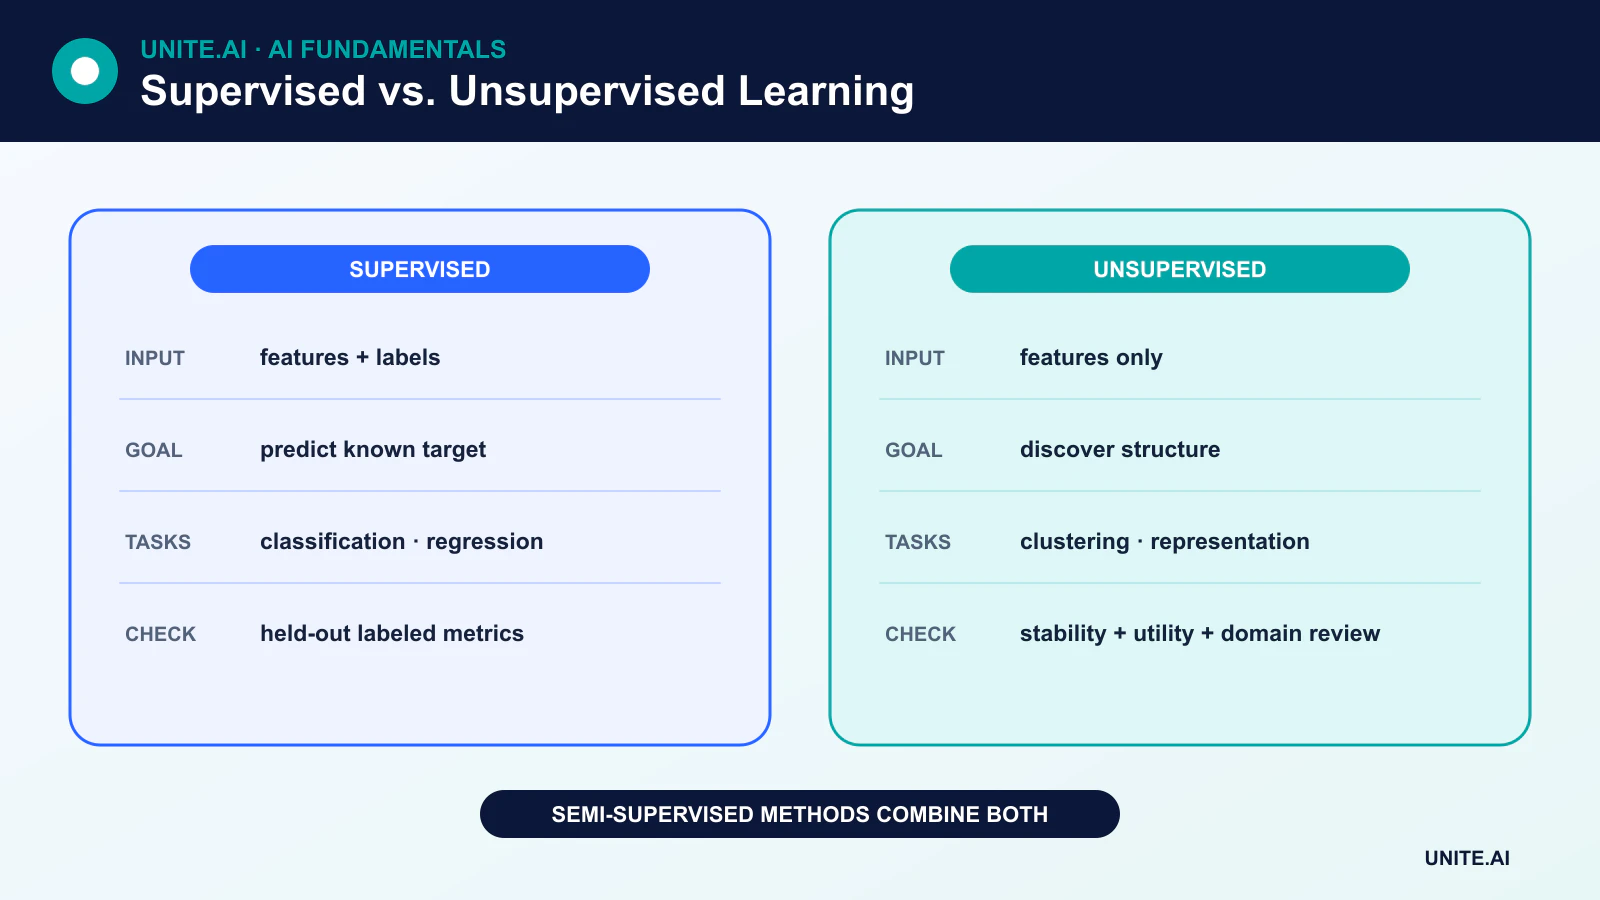
การเรียนรู้แบบมีผู้สอน เรียนรู้จากตัวอย่างที่จับคู่กับคำตอบเป้าหมาย การเรียนรู้แบบไม่มีผู้สอน มองหาโครงสร้างในข้อมูลโดยไม่มีป้ายกำกับเป้าหมาย ความแตกต่างไม่ได้อยู่ที่ว่าแนวทางใดฉลาดหรือแม่นยำกว่า แต่เป็นประเภทของสัญญาณการเรียนรู้ที่มีอยู่และคำถามที่ระบบออกแบบมาเพื่อตอบ
เหล่านี้เป็นสองแนวคิดหลักภายใน machine learning แต่ระบบสมัยใหม่ยังใช้การเรียนรู้กึ่งมีผู้สอน, การเรียนรู้ด้วยตนเอง, และการเรียนรู้แบบเสริมแรง
ประเด็นสำคัญ
- การเรียนรู้แบบมีผู้สอนทำนายเป้าหมายที่ทราบ; การเรียนรู้แบบไม่มีผู้สอนค้นพบรูปแบบหรือการแทนค่า
- การจำแนกและการถดถอยเป็นงานที่มีผู้สอน; การจัดกลุ่ม, การประมาณความหนาแน่น, และหลายวิธีการลดมิติเป็นแบบไม่มีผู้สอน
- ผลลัพธ์จากการเรียนรู้แบบไม่มีผู้สอนไม่ได้เป็นคลาสของโลกจริงโดยอัตโนมัติและอาจประเมินได้ยากกว่า
- ค่าใช้จ่ายการคำนวณและความแม่นยำขึ้นอยู่กับอัลกอริทึม, ข้อมูล, งาน, และการประเมิน—not เพียงแนวคิดเดียว
วิธีการทำงานของการเรียนรู้แบบมีผู้สอน
ชุดข้อมูลที่มีผู้สอนประกอบด้วยคุณลักษณะ X และเป้าหมาย y การฝึกปรับโมเดลให้การทำนายใกล้เคียงกับเป้าหมาย การประเมินใช้ตัวอย่างที่มีป้ายกำกับแยกออกเพื่อประมาณว่ามันทั่วไปได้ดีแค่ไหน
การจำแนก
การจำแนกทำนายหมวดหมู่: สแปมหรือไม่สแปม, หัวข้อเอกสารหนึ่งในหลายหัวข้อ, หรือหนึ่งหรือหลายวัตถุในภาพ ตัวชี้วัดที่เกี่ยวข้องรวมถึง precision, recall, F1, การปรับเทียบ, และมาตรการที่คำนึงถึงต้นทุน ความแม่นยำอาจทำให้เข้าใจผิดเมื่อคลาสหนึ่งหายาก; ตารางสับสน เปิดเผยว่าคลาสใดกำลังสับสนกัน
การถดถอย
การถดถอยทำนายค่าต่อเนื่อง เช่น ความต้องการ, ระยะเวลา, หรืออุณหภูมิ การถดถอยเชิงเส้น สามารถใช้หนึ่งหรือหลายคุณลักษณะ; ไม่จำกัดเพียงการวาดความสัมพันธ์ระหว่างสองตัวแปร ตัวชี้วัดการถดถอยรวมถึงค่าเฉลี่ยความผิดพลาดสัมบูรณ์, รากที่สองของค่าเฉลี่ยความผิดพลาดกำลังสอง, และต้นทุนเฉพาะงาน
อัลกอริทึมที่มีผู้สอนทั่วไป
วิธีที่มีผู้สอนรวมถึงโมเดลเชิงเส้นและโลจิสติก, ต้นไม้ตัดสินใจ, ป่าแบบสุ่ม, การเพิ่มประสิทธิภาพแบบกราเดียนท์, เครื่องเวกเตอร์สนับสนุน, K-nearest neighbors, และ เครือข่ายประสาทเทียม
การถดถอยโลจิสติกสร้างคะแนนหรือความน่าจะเป็นที่สามารถแปลงเป็นคลาสโดยใช้เกณฑ์ที่เลือก ใบของต้นไม้ตัดสินใจมีการทำนายที่อิงจากพื้นที่คุณลักษณะ ไม่จำเป็นต้องเป็นการสังเกตการฝึกเดียว KNN ทำนายจากตัวอย่างการฝึกที่มีป้ายกำกับใกล้เคียงและยังต้องการการออกแบบการฝึก/ตรวจสอบ/ทดสอบที่ดี
วิธีการทำงานของการเรียนรู้แบบไม่มีผู้สอน
การเรียนรู้แบบไม่มีผู้สอนรับคุณลักษณะโดยไม่มีคอลัมน์เป้าหมาย วัตถุประสงค์ของมันกำหนดโดยอ้อม—เช่น ลดระยะทางภายในกลุ่ม, สร้างข้อมูลอินพุตใหม่, ประมาณความหนาแน่นของข้อมูล, หรือเก็บความแปรปรวนให้มากที่สุดในมิติที่น้อยลง
การจัดกลุ่ม
K-means กำหนดจุดให้กับจำนวนกลุ่มที่เลือกและอัปเดตศูนย์กลางกลุ่มเพื่อลดระยะทางกำลังสองภายในกลุ่ม อัลกอริทึมค้นหาการจัดกลุ่มเชิงเรขาคณิตภายใต้ระยะทางและการแทนคุณลักษณะที่กำหนด กลุ่มเหล่านี้ไม่ได้สอดคล้องโดยอัตโนมัติกับประเภทลูกค้าที่มีความหมาย, การวินิจฉัย, หรือป้ายกำกับโดเมนอื่น ๆ
การลดมิติ
การลดมิติ แทนข้อมูลด้วยตัวแปรที่น้อยลง การวิเคราะห์ส่วนประกอบหลัก (PCA) ค้นหาทิศทางตั้งฉากที่เก็บความแปรปรวนให้มากที่สุดภายใต้การฉายเชิงเส้น วิธีอื่น ๆ รักษาแนวคิดโครงสร้างที่แตกต่างและอาจสร้างการแสดงผลที่แตกต่างอย่างมาก
การตรวจจับความผิดปกติและการประมาณความหนาแน่น
วิธีการแบบไม่มีผู้สอนสามารถประมาณว่าข้อมูลหนาแน่นที่ไหนและทำเครื่องหมายการสังเกตที่ไม่ปกติ คะแนนความผิดปกติไม่ได้พิสูจน์การฉ้อโกง, ความล้มเหลว, หรือพฤติกรรมที่เป็นอันตราย; มันระบุความเบี่ยงเบนภายใต้การแทนและโมเดลที่เลือก
การประเมินการเรียนรู้แบบไม่มีผู้สอน
ไม่มีแนวคิดสากลของ “ความแม่นยำ” ในการเรียนรู้แบบไม่มีผู้สอน ผู้ปฏิบัติอาจใช้ตัวชี้วัดภายในเช่น silhouette score, เปรียบเทียบความเสถียรระหว่างตัวอย่าง, ทดสอบประโยชน์ในงานต่อเนื่อง, หรือสอบถามผู้เชี่ยวชาญด้านโดเมนว่ารูปแบบที่ค้นพบมีความหมายหรือไม่ หากมีป้ายกำกับจริงสำหรับการประเมิน สามารถใช้ตัวชี้วัดการจัดกลุ่มภายนอกโดยไม่ต้องเปลี่ยนกระบวนการฝึกเป็นการเรียนรู้แบบมีผู้สอน
เหนือการเปรียบเทียบสองทาง
การเรียนรู้กึ่งมีผู้สอน
การเรียนรู้กึ่งมีผู้สอนผสานชุดข้อมูลที่มีป้ายกำกับเล็กลงกับชุดข้อมูลที่ไม่มีป้ายกำกับขนาดใหญ่ ตัวอย่างเช่น pseudo-labeling, consistency regularization, และวิธีการแบบกราฟ ข้อมูลที่ไม่มีป้ายกำกับยังต้องคล้ายกับการกระจายเป้าหมายอย่างเพียงพอเพื่อช่วย
การเรียนรู้ด้วยตนเอง
การเรียนรู้ด้วยตนเองสร้างเป้าหมายจากอินพุตเอง เช่น การทำนายโทเคนที่ถูกปิดบังหรือการจับคู่มุมมองที่แปลงแล้ว มันเป็นพื้นฐานของโมเดลภาษาสมัยใหม่, การมองเห็น, และโมเดลหลายโหมด รวมถึง transformers
การเรียนรู้แบบเสริมแรง
การเรียนรู้แบบเสริมแรง ปรับการตัดสินใจผ่านรางวัลที่เกิดจากการโต้ตอบ มันแตกต่างจากการทำนายที่มีป้ายกำกับและการค้นหารูปแบบคงที่
การเลือกแนวทางที่เหมาะสม
เริ่มต้นด้วยการตัดสินใจหรือข้อมูลเชิงลึกที่ระบบต้องให้ หากมีเป้าหมายที่เชื่อถือได้และเป้าหมายคือการทำนาย การเรียนรู้แบบมีผู้สอนเป็นธรรมชาติ หากวัตถุประสงค์คือการสำรวจ, การแทนค่า, หรือการจัดกลุ่ม วิธีการแบบไม่มีผู้สอนอาจเหมาะ เมื่อป้ายกำกับหายาก การฝึกล่วงหน้าด้วยการเรียนรู้ด้วยตนเองหรือกึ่งมีผู้สอนตามด้วยการประเมินแบบมีผู้สอนอาจมีประสิทธิภาพมากกว่า
ในทุกกรณี การรั่วไหลของข้อมูล, การสุ่มตัวอย่างที่ลำเอียง, ตัวแทนที่อ่อนแอ, และการเปลี่ยนแปลงการกระจายสามารถครอบงำการเลือกอัลกอริทึม โมเดลที่ถูกต้องทางเทคนิคแต่ฝึกบนวัตถุประสงค์ที่ผิดก็อาจล้มเหลว
สัญญาณการเรียนรู้, วัตถุประสงค์, และวิธีการที่เป็นตัวแทน
การเรียนรู้แบบมีผู้สอนใช้ตัวอย่างที่จับคู่กับป้ายกำกับหรือค่าตามเป้าหมายและปรับลดข้อผิดพลาดการทำนาย การจำแนก, การถดถอย, การจัดอันดับ, และการทำนายเชิงโครงสร้างแตกต่างกันในด้านผลลัพธ์และฟังก์ชันสูญเสีย การเรียนรู้แบบไม่มีผู้สอนมองหาโครงสร้างโดยไม่มีป้ายกำกับเป้าหมายผ่านการจัดกลุ่ม, การประมาณความหนาแน่น, การลดมิติ, การเรียนรู้การแทนค่า, หรือการสร้างโมเดลเชิงสร้างสรรค์ การเรียนรู้ด้วยตนเองสร้างเป้าหมายการทำนายจากข้อมูลเอง, ในขณะที่การเรียนรู้กึ่งมีผู้สอนผสานชุดข้อมูลที่มีป้ายกำกับเล็กกับข้อมูลไม่มีป้ายกำกับจำนวนมาก หมวดเหล่านี้อธิบายสัญญาณการเรียนรู้; สถาปัตยกรรมประสาทเทียมเดียวกันสามารถฝึกภายใต้หลายแนวคิดได้
ป้ายกำกับทำให้วัตถุประสงค์ชัดเจนแต่เพิ่มค่าใช้จ่ายการทำเครื่องหมาย, ความผิดพลาด, สมมติฐานนโยบาย, และความล่าช้าทางเวลา ข้อมูลไม่มีป้ายกำกับรวบรวมได้ง่ายแต่ไม่ได้บอกอัลกอริทึมว่ารูปแบบที่ค้นพบนั้นมีประโยชน์หรือไม่ กลุ่มอาจสะท้อนแสง, ความยาวเอกสาร, หรือแหล่งที่มาของข้อมูลแทนที่จะเป็นหมวดหมู่ที่มีความหมาย กำหนดการประเมินอย่างอิสระ: โมเดลที่มีผู้สอนใช้ผลลัพธ์ที่มีป้ายกำกับแยกออก, ในขณะที่โมเดลที่ไม่มีผู้สอนต้องการความเสถียร, การสร้างใหม่, ความน่าจะเป็น, การดึงข้อมูล, ประโยชน์ต่อภารกิจต่อเนื่อง, หรือการตรวจสอบจากผู้เชี่ยวชาญ การแยกภาพเพียงอย่างเดียวไม่ใช่หลักฐานของโครงสร้างที่ถูกต้อง
การเลือกแนวคิดและป้องกันข้อผิดพลาดทั่วไป
ใช้การเรียนรู้แบบมีผู้สอนเมื่อมีเป้าหมายที่คงที่และป้ายกำกับที่เป็นตัวแทน ใช้การสำรวจแบบไม่มีผู้สอนเพื่อสรุป, ตรวจจับความใหม่, บีบอัด, หรือสร้างสมมติฐาน, แต่ให้ถือผลลัพธ์เป็นชั่วคราว การฝึกล่วงหน้าด้วยการเรียนรู้ด้วยตนเองมีคุณค่าเมื่อข้อมูลดิบมีมากและงานต่อเนื่องใช้การแทนค่าเดียวกัน วิธีการกึ่งมีผู้สอนช่วยได้เฉพาะเมื่อสมมติฐานเกี่ยวกับข้อมูลไม่มีป้ายกำกับและโครงสร้างคลาสเป็นจริง เปรียบเทียบกับฐานเส้นง่ายและคำนึงถึงต้นทุนรวมของการเก็บข้อมูล, การทำเครื่องหมาย, การตรวจสอบ, การคำนวณ, และข้อผิดพลาด แทนที่จะสมมติว่าข้อมูลไม่มีป้ายกำกับหมายถึงต้นทุนต่ำโดยอัตโนมัติ
ป้องกันการรั่วไหลโดยแยกเอนทิตีที่เกี่ยวข้องก่อนสร้างป้ายกำกับ, การเพิ่มข้อมูล, หรือ pseudo-labels ตรวจสอบความสมดุลของคลาส, ความสอดคล้องของการทำเครื่องหมาย, ความเสถียรของกลุ่ม, การยุบรวม, และการเปลี่ยนแปลง pseudo-labels อาจเสริมข้อผิดพลาดตั้งแต่แรก; การจัดกลุ่มอาจฝังคุณลักษณะที่ละเอียดอ่อน; การแทนค่าที่ฝึกล่วงหน้าอาจถ่ายทอดอคติของแหล่งข้อมูล การตรวจสอบโดยมนุษย์ควรเน้นกรณีขอบเขตและผลกระทบ ในการผลิต เอกสารว่สัญญาณการเรียนรู้สร้างขึ้นอย่างไรและเมื่อใดจึงล้าสมัย แนวคิดกำหนดว่าการกำกับดูแลเข้าสู่ระบบที่ไหน ไม่ได้หมายความว่าการเลือกและค่านิยมของมนุษย์ไม่มีอยู่
ตัวอย่างการทำงาน: ค้นพบและตั้งป้ายหัวข้อสนับสนุน
บริษัทใช้การฝังเวกเตอร์และการจัดกลุ่มแบบไม่มีผู้สอนเพื่อสำรวจธีมในข้อความสนับสนุนที่ไม่ระบุตัวตน นักวิเคราะห์ตรวจสอบตัวอย่างที่เป็นตัวแทนและขอบเขตและพบว่ากลุ่มบางกลุ่มสะท้อนความยาวข้อความและช่องทางแทนที่จะเป็นปัญหา พวกเขาพัฒนาระบบจัดประเภทที่มีผู้สอนพร้อมคลาสที่ไม่ทราบ, แนวทางการทำเครื่องหมาย, และการวัดความสอดคล้อง ตัวจำแนกจึงถูกประเมินในช่วงเวลาต่อมา, ภาษา, และผลิตภัณฑ์เทียบกับคีย์เวิร์ดและฐานเส้น nearest-neighbor
ข้อความใหม่ที่ไม่มีป้ายกำกับช่วยให้ค้นพบการเปลี่ยนแปลงของแนวโน้มแต่ไม่ฝึกตัวจำแนกโดยอัตโนมัติ ผู้ตรวจสอบทำการทำเครื่องหมายกรณีที่ไม่แน่นอนและกำลังเกิดขึ้นผ่านการเรียนรู้อย่างกระตือรือร้น พร้อมการตรวจสอบคุณภาพและชุดประเมินที่ปิดไว้ การเฝ้าติดตามติดตามความถี่ของหัวข้อ, ความเชื่อมั่น, ความไม่เห็นด้วย, และผลลัพธ์การกำหนดเส้นทาง เมื่อมีผลิตภัณฑ์ใหม่เปิดตัว ระบบจัดประเภทและความสามารถของทีมต่อเนื่องจะอัปเดตพร้อมกัน กระบวนการทำงานใช้วิธีการแบบไม่มีผู้สอนเพื่อสร้างสมมติฐานและหลักฐานที่มีผู้สอนสำหรับการกำหนดเส้นทางการปฏิบัติการ
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจในผลิตภัณฑ์ต้องการมากกว่าการสาธิตที่สำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้างฐานเส้นที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของบริการ, การใช้ผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, ความเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูดใจ
ก่อนการเปิดตัว มอบอำนาจให้กับผู้รับผิดชอบการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา ระบบเทเลเมตรีการปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะบริการ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง แล้วตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนที่จะสมมติว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือเปลี่ยนทดแทน
เอกสารอ้างอิงหลัก












