
พื้นฐาน AI
เมทริกซ์สับสนคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
A confusion matrix คือ ตารางที่นับจำนวนครั้งที่การทำนายของตัวจำแนกตรงหรือไม่ตรงกับป้ายกำกับที่ทราบ มันเปิดเผยว่าชั้นใดบ้างที่สับสนกันและให้จำนวนที่ใช้คำนวณเมตริกต่าง ๆ เช่น ความแม่นยำ, การเรียกคืน, ความจำเพาะ, และ F1 เป็นหนึ่งในเครื่องมือวินิจฉัยหลักสำหรับ การเรียนรู้แบบมีผู้ควบคุม ปัญหาการจำแนกประเภท
เมทริกซ์เองไม่ใช่คะแนนประสิทธิภาพเดียว มันเป็นมุมมองเชิงโครงสร้างของผลลัพธ์ที่ระดับค่าเกณฑ์การตัดสินใจ, ชุดข้อมูล, และการกำหนดคลาสที่กำหนดไว้
ประเด็นสำคัญ
- สำหรับการจำแนกแบบทวิ, สี่ผลลัพธ์คือ ทรูพอซิทีฟ, ฟอลส์พอซิทีฟ, ฟอลส์เนกาทีฟ, และทรูเนกาทีฟ
- ควรตั้งชื่อแกนเสมอ: ไลบรารีและเอกสารต่าง ๆ ไม่ได้วางคลาสจริงและคลาสที่ทำนายในทิศทางเดียวกันเสมอ
- ความแม่นยำอาจซ่อนข้อผิดพลาดร้ายแรงเมื่อคลาสไม่สมดุล
- การเปลี่ยนค่าเกณฑ์การจำแนกจะเปลี่ยนเมทริกซ์สับสนและการแลกเปลี่ยนระหว่างความแม่นยำและการเรียกคืน
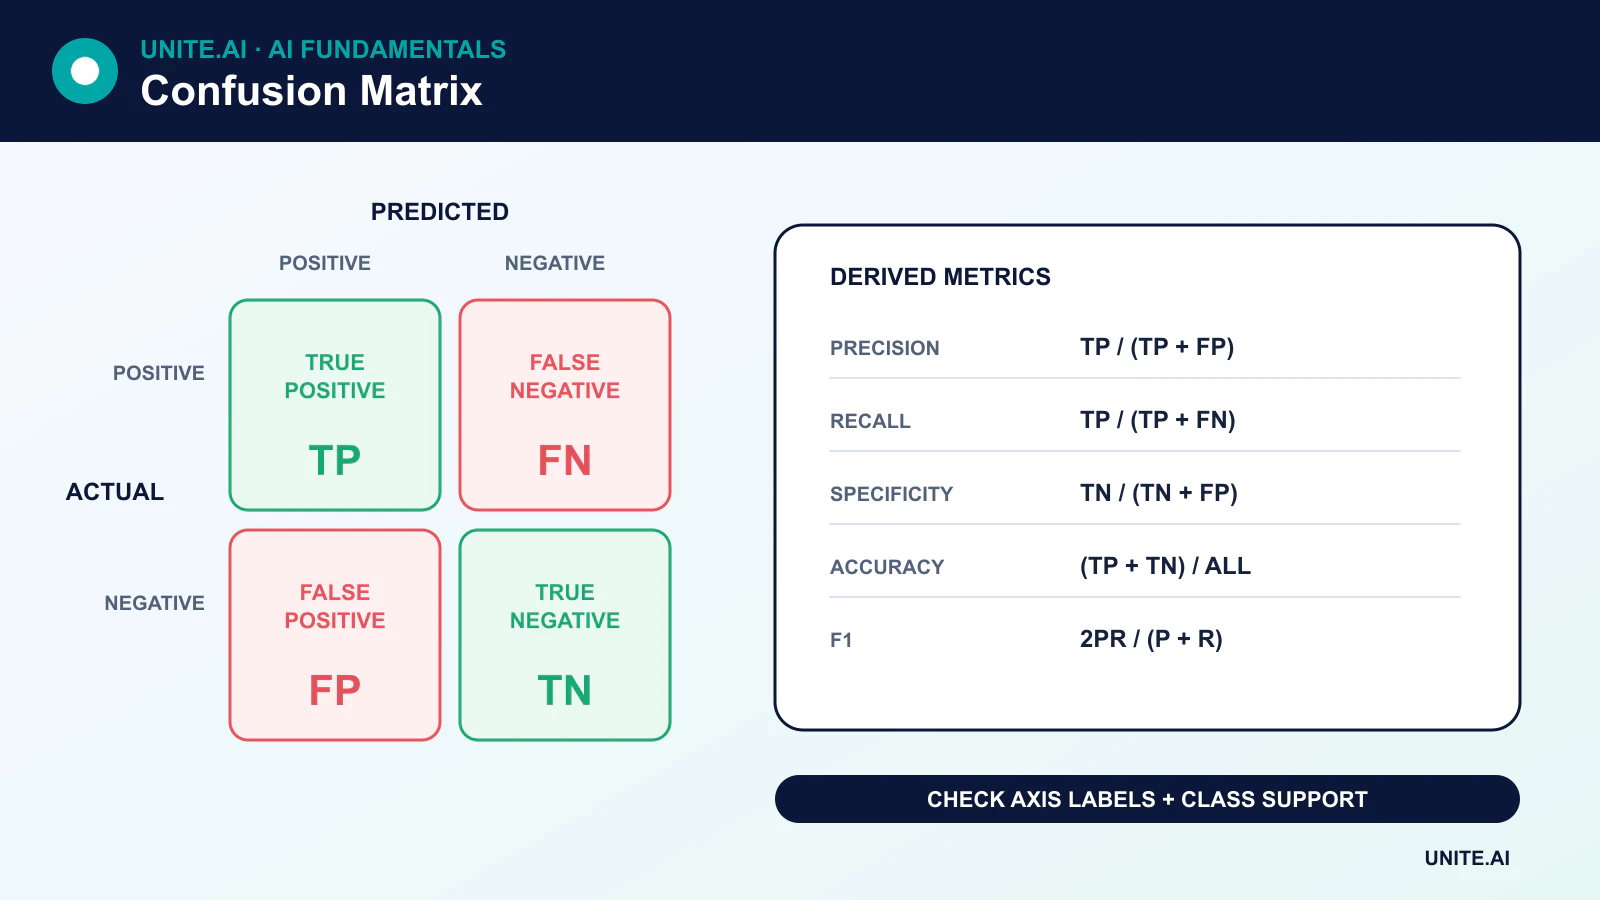
สี่ผลลัพธ์ของการจำแนกแบบทวิ
- True positive (TP): ตัวอย่างเป็นบวกและโมเดลทำนายเป็นบวก
- False positive (FP): ตัวอย่างเป็นลบแต่โมเดลทำนายเป็นบวก
- False negative (FN): ตัวอย่างเป็นบวกแต่โมเดลทำนายเป็นลบ
- True negative (TN): ตัวอย่างเป็นลบและโมเดลทำนายเป็นลบ
ตามแนวทางของ scikit-learn แถวแสดงคลาสจริงและคอลัมน์แสดงคลาสที่ทำนาย การแสดงผลอื่น ๆ อาจสลับตำแหน่งนี้ ดังนั้นควรอ้างอิงป้ายกำกับ—not ตำแหน่งมุม—เพื่อการตีความ
เมตริกที่ได้จากเมทริกซ์สับสน
ความแม่นยำ
Precision = TP / (TP + FP)
ความแม่นยำตอบว่า: ในตัวอย่างที่ทำนายเป็นบวก, สัดส่วนที่จริง ๆ แล้วเป็นบวกคือเท่าไหร่?
Recall หรือ Sensitivity
Recall = TP / (TP + FN)
Recall ตอบว่า: ในตัวอย่างบวกทั้งหมด, สัดส่วนที่โมเดลตรวจพบคือเท่าไหร่? ในการจำแนกแบบทวิ, Recall ของคลาสบวกยังเรียกว่า Sensitivity หรืออัตราทรูพอซิทีฟ
Specificity
Specificity = TN / (TN + FP)
Specificity คือ Recall สำหรับคลาสลบ: ในกรณีลบจริง, สัดส่วนที่โมเดลปฏิเสธอย่างถูกต้องคือเท่าไหร่?
ความแม่นยำรวม
Accuracy = (TP + TN) / (TP + TN + FP + FN)
ความแม่นยำรวมมีประโยชน์เมื่อคลาสและค่าใช้จ่ายของข้อผิดพลาดสมดุลกัน อย่างไรก็ตามอาจทำให้เข้าใจผิดเมื่อคลาสหนึ่งครอบคลุมส่วนใหญ่ของข้อมูล
คะแนน F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
คะแนน F1 สรุปความแม่นยำและ Recall ด้วยค่าเฉลี่ยฮาร์โมนิก มันไม่พิจารณาทรูเนกาทีฟ ดังนั้นจึงไม่เหมาะกับทุกงาน
ตัวอย่างที่ทำงาน
สมมติว่าชุดทดสอบมีธุรกรรม 1,000 รายการ มี 50 รายการเป็นการฉ้อโกง โมเดลพบ 40 รายการฉ้อโกงแต่ทำเครื่องหมายว่า 30 รายการเป็นการฉ้อโกงเท็จ:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
โมเดลมีความแม่นยำ 96% แต่ความแม่นยำอยู่ที่ประมาณ 57% และ Recall อยู่ที่ 80% ความแม่นยำสูงส่วนใหญ่เกิดจากจำนวนธุรกรรมที่เป็นปกติจำนวนมาก ความยอมรับโมเดลนี้ขึ้นอยู่กับต้นทุนของการพลาดการฉ้อโกง, ความสามารถในการตรวจสอบ, และการปรับระดับคะแนนความเสี่ยงของโมเดล
ค่าเกณฑ์เปลี่ยนเมทริกซ์
ตัวจำแนกหลายตัวให้คะแนนแทนการตอบใช่/ไม่ใช่ การลดค่าเกณฑ์บวกโดยทั่วไปเพิ่ม Recall และฟอลส์พอซิทีฟ; การเพิ่มค่าเกณฑ์โดยทั่วไปเพิ่มความแม่นยำหรือ Specificity แต่พลาดบวกมากขึ้น ค่าเกณฑ์ควรเลือกโดยอิงข้อมูล validation และค่าใช้จ่ายของข้อผิดพลาดจริง ไม่ใช่ค่าคงที่ที่ 0.5 โดยอัตโนมัติ
กราฟ Precision‑Recall และ ROC สรุปประสิทธิภาพตามค่าเกณฑ์ต่าง ๆ โดยกราฟ Precision‑Recall มักให้ข้อมูลที่ชัดเจนกว่าเมื่อคลาสบวกหายาก
เมทริกซ์สับสนหลายคลาส
สำหรับ K คลาส เมทริกซ์จะเป็น K × K การทำนายที่ถูกต้องอยู่บนเส้นทแยงมุม; เซลล์ที่อยู่นอกเส้นทแยงมุมแสดงว่าคลาสใดสับสนกับคลาสใด เมตริกต่อคลาสสามารถเฉลี่ยได้หลายวิธี:
- Macro average: ให้แต่ละคลาสมีน้ำหนักเท่ากัน
- Weighted average: ให้แต่ละคลาสมีน้ำหนักตามจำนวนตัวอย่างของมัน
- Micro average: รวมจำนวนผลลัพธ์ก่อนคำนวณเมตริก
การรายงานเฉพาะค่าเฉลี่ยเดียวอาจซ่อนประสิทธิภาพที่แย่ของคลาสขนาดเล็ก ควรรวมจำนวนสนับสนุนและผลลัพธ์ต่อคลาสเมื่อความแตกต่างมีความสำคัญ
ข้อผิดพลาดทั่วไป
- อ่านเมทริกซ์ที่สลับตำแหน่งโดยไม่ตรวจสอบป้ายแกน
- คำนวณเมตริกจากข้อมูลฝึกแทนชุดทดสอบที่เหมาะสม
- ละเลยความถี่ของคลาส, ยุทธวิธีการสุ่มตัวอย่าง, หรือข้อมูลซ้ำระหว่างส่วนต่าง ๆ
- เปรียบเทียบเมทริกซ์ที่สร้างที่ค่าเกณฑ์ต่างกันโดยไม่ระบุการเปลี่ยนแปลง
- ถือว่าผลลบเท็จและบวกเท็จมีค่าใช้จ่ายเท่ากัน
เมทริกซ์สับสนจึงเป็นเครื่องมือวินิจฉัย ไม่ใช่การประเมินผลครบถ้วน การปรับเทียบ, การวิเคราะห์กลุ่มย่อย, ความทนทาน, และผลลัพธ์ต่อเนื่องก็เป็นส่วนสำคัญของการตรวจสอบการจำแนกประเภท
การอ่านทุกเซลล์และสรุปเมตริกที่เป็นประโยชน์
สำหรับการจำแนกแบบทวิ, เมทริกซ์สับสนนับนับทรูพอซิทีฟ, ฟอลส์พอซิทีฟ, ฟอลส์เนกาทีฟ, และทรูเนกาทีฟสำหรับคลาสบวกและค่าเกณฑ์ที่เลือก ความแม่นยำหารจำนวนการทำนายที่ถูกต้องด้วยทั้งหมด; ความแม่นยำถามว่าร้อยละของบวกที่ทำนายถูกต้องคือเท่าไหร่; Recall ถามว่าร้อยละของบวกจริงที่พบคือเท่าไหร่; Specificity วัดร้อยละของลบจริงที่ถูกปฏิเสธอย่างถูกต้อง; F1 เป็นค่าเฉลี่ยฮาร์โมนิกของความแม่นยำและ Recall ไม่มีอันไหนดีกว่าโดยธรรมชาติ: การคัดกรองการฉ้อโกง, การคัดกรองทางการแพทย์, และการกรองสแปมต่างให้ผลลัพธ์ที่ต่างกันตามผลกระทบของเซลล์เดียวกัน
สำหรับปัญหาหลายคลาส, แถวมักแทนคลาสจริงและคอลัมน์แทนคลาสที่ทำนาย แม้แนวทางอาจแตกต่างกัน จึงต้องระบุป้ายให้ชัดเจน การนับแบบ One‑vs‑Rest ให้ความแม่นยำและ Recall ต่อคลาส การเฉลี่ยแบบ Macro ให้คลาสเท่ากัน; การเฉลี่ยแบบ Micro รวมการตัดสินใจและให้ความสำคัญกับคลาสที่พบบ่อย; การเฉลี่ยแบบ Weighted ให้ตามจำนวนสนับสนุน งานหลายป้ายอนุญาตให้มีหลายป้ายต่อรายการและต้องกำหนดตามป้ายหรือแต่ละตัวอย่าง การทำ Normalization ตามแถวช่วยตรวจสอบรูปแบบ Recall หรือตามคอลัมน์ช่วยตรวจสอบส่วนประกอบการทำนาย แต่ต้องเก็บจำนวนดิบไว้เพื่อไม่ให้กลุ่มหายากถูกขยายภาพเกินจริง
ค่าเกณฑ์, ความไม่แน่นอน, และการตัดสินใจเชิงปฏิบัติ
เมทริกซ์สับสนสรุปการตัดสินใจที่ชัดเจนที่ค่าเกณฑ์หนึ่ง ใช้กราฟ Precision‑Recall หรือ ROC เพื่อเปรียบเทียบค่าเกณฑ์ แล้วเลือกจุดดำเนินการตามความจุ, ความชุก, และค่าใช้จ่ายของข้อผิดพลาด การปรับเทียบสอบถามว่าความน่าจะเป็นที่ทำนายตรงกับความถี่ที่สังเกตได้หรือไม่และแยกจากการจัดอันดับ เมื่อความชุกเปลี่ยนแปลง ความแม่นยำอาจเปลี่ยนได้แม้ Sensitivity และ Specificity คงที่ รายงานช่วงความเชื่อมั่นหรือการแปรผันแบบ Bootstrap และหลีกเลี่ยงการสรุปจากข้อผิดพลาดเพียงไม่กี่กรณีในกลุ่มย่อยขนาดเล็ก
ตรวจสอบเมทริกซ์ตามเวลา, สถานที่, อุปกรณ์, ภาษา, และกลุ่มที่ได้รับผลกระทบที่เกี่ยวข้องเพื่อหาข้อผิดพลาดที่กระจุกตัว เปรียบเทียบโมเดลกับกระบวนการตัดสินใจเดิมรวมถึงการตรวจสอบโดยมนุษย์ สำหรับระบบลำดับขั้น ให้บันทึกข้อผิดพลาดที่แต่ละขั้นตอน: การดึงข้อมูล, การจำแนก, การกำหนดค่าเกณฑ์, และการดำเนินการ ตรวจสอบป้ายผลลัพธ์แบบเรียลไทม์พร้อมความล่าช้าและกระบวนการแก้ไข F1 ที่ดูเหมือนดีขึ้นอาจยังเพิ่มฟอลส์เนกาทีฟที่เป็นอันตรายหรือทำให้ความจุการตรวจสอบเกินพิกัด เมทริกซ์สับสนเป็นสมุดบันทึกการตัดสินใจ เชื่อมโยงทุกเซลล์กับผู้ที่ได้รับผลกระทบและการตอบสนองต่อไป
ตัวอย่างที่ทำงาน: การเลือกค่าเกณฑ์การคัดกรองทางการแพทย์
โมเดลการคัดกรองด้วยการเรียนรู้ของเครื่องให้คะแนนความเสี่ยงสำหรับภาวะที่ความชุกต่ำ ทีมสร้างเมทริกซ์สับสนหลายค่าเกณฑ์และรายงาน Sensitivity, Specificity, Precision, การอ้างอิงเท็จ, และกรณีที่พลาดพร้อมช่วงความเชื่อมั่น เนื่องจาก Positive Predictive Value ขึ้นกับความชุก จึงจำลองประชากรเป้าหมายแทนการอ้างอิง Precision จากชุดข้อมูลเดียว ผลลัพธ์แบ่งตามอุปกรณ์, สถานที่, อายุ, เพศ, และกลุ่มที่มีเหตุผลทางคลินิกอื่น ๆ
แพทย์เลือกจุดดำเนินการที่รักษา Sensitivity ที่ต้องการโดยไม่ทำให้การทดสอบยืนยันล้นเกินไป เมทริกซ์ถูกแปลงเป็นจำนวนคาดคะเนต่อ 10,000 คนที่คัดกรองเพื่อให้ผลกระทบเข้าใจได้ คะแนนที่อยู่นอกเงื่อนไขที่ตรวจสอบแล้วจะไม่ให้สรุปอัตโนมัติ การตรวจสอบเปรียบเทียบการทำนายกับการวินิจฉัยที่ยืนยันล่าช้า ติดตามความจุและการปรับเทียบ และกระตุ้นการตรวจสอบเมื่อความชุกหรือการเก็บข้อมูลเปลี่ยน เมทริกซ์สับสนยังคงเชื่อมโยงกับโมเดล, ค่าเกณฑ์, และประชากรที่แน่นอน
หลักฐานการนำไปใช้และความพร้อมเชิงปฏิบัติ
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่สำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดประเมินเวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนต่อขยาย, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการประมวลผล, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและค่าเกณฑ์ทุกครั้งเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดูน่าสนใจ
ก่อนเปิดใช้งาน มอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยุติ ใช้การเปิดตัวแบบขั้นตอน, เก็บสำรองที่ปลอดภัย, และตรวจสอบการมอนิเตอร์ด้วยการฉีดความล้มเหลวโดยเจตนา เทเลเมตรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะส่วนต่อขยาย, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดค่าเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
เมทริกซ์สับสนที่ทำให้เป็นมาตรฐานคืออะไร?
การทำ Normalization จะแบ่งจำนวนโดยรวมของคลาสจริง, คลาสที่ทำนาย, หรือทั้งหมด ทำให้เรทง่ายต่อการเปรียบเทียบระหว่างคลาส แต่รายงานควรยังคงเก็บจำนวนสนับสนุนดิบเพื่อไม่ให้กลุ่มเล็กถูกเข้าใจว่าเท่ากับกลุ่มใหญ่
เมทริกซ์สับสนสามารถประเมินการถดถอยได้หรือไม่?
ไม่ได้โดยตรง เมทริกซ์สับสนต้องการคลาสแบบแยกประเภท การแบ่งช่วงค่าต่อเนื่องจะทำให้ข้อมูลสูญเสีย; การถดถอยควรใช้การวิเคราะห์ส่วนเหลือและเมตริกที่ออกแบบมาสำหรับค่าต่อเนื่อง เช่น MAE หรือ RMSE
แหล่งอ้างอิงหลัก












