
พื้นฐาน AI
การวิเคราะห์อารมณ์คืออะไร? วิธีการ การใช้ และข้อจำกัด

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การวิเคราะห์อารมณ์ประมาณค่าภาษาเชิงประเมินในข้อความ การถอดความเสียงพูด หรือเนื้อหาอื่น ๆ ระบบอาจจำแนกความเป็นบวก เช่น บวก ลบ หรือเป็นกลาง; ตรวจจับความเห็นระดับแง่มุม; ประมาณความเข้มข้น; หรือระบุท่าทีต่อข้ออ้างเฉพาะ
ต้องกำหนดเป้าหมายอย่างระมัดระวัง อารมณ์ไม่เท่ากับความรู้สึก, ความตั้งใจ, ความเป็นพิษ, ความพึงพอใจ หรือความจริง ประโยคที่เป็นบวกอาจอธิบายเหตุการณ์ที่เป็นอันตรายอย่างเสียดสี ในขณะที่รีวิวผลิตภัณฑ์ที่เป็นลบยังอาจแนะนำผลิตภัณฑ์โดยรวม
ประเด็นสำคัญ
- กำหนดหน่วย, เป้าหมาย, ป้ายกำกับ, และบริบทก่อนเก็บตัวอย่าง
- พจนานุกรมเป็นฐานข้อมูลที่โปร่งใส; โมเดลแบบกำกับและโมเดลทรานส์ฟอร์มเมอร์สามารถจับบริบทได้มากขึ้นแต่ต้องการข้อมูลที่เป็นตัวแทน
- การปฏิเสธ, การเสียดสี, คำศัพท์เฉพาะโดเมน, ข้อความหลายภาษา, และขอบเขตแง่มุมยังคงเป็นความท้าทาย
- ประเมินตามคลาส, กลุ่มย่อย, โดเมน, และช่วงเวลา; รวมการตรวจสอบโดยมนุษย์สำหรับการใช้งานที่มีผลสำคัญ
ระดับและเป้าหมาย
การวิเคราะห์ระดับเอกสารสร้างป้ายกำกับหนึ่งค่าให้กับรายการทั้งหมด การวิเคราะห์ระดับประโยคจะแยกข้อความออก ในขณะที่การวิเคราะห์ตามแง่มุมเชื่อมอารมณ์กับเอนทิตี้หรือคุณลักษณะ—เช่น บวกเกี่ยวกับคุณภาพภาพ แต่ลบเกี่ยวกับอายุการใช้งานแบตเตอรี่
ท่าทีสอบถามว่าผู้พูดสนับสนุนข้อเสนอเฉพาะหรือไม่ ซึ่งอาจแตกต่างจากโทนอารมณ์ ความแตกต่างเหล่านี้ควรระบุในคู่มือการทำเครื่องหมายก่อนใช้วิธี การจำแนกข้อความ
พจนานุกรม, โมเดลคลาสสิก, และทรานส์ฟอร์มเมอร์
พจนานุกรมกำหนดคะแนนให้กับคำและรวมกับกฎสำหรับการปฏิเสธหรือความเข้มข้น มันสามารถอธิบายได้และต้นทุนต่ำแต่มีปัญหาในการจัดการกับบริบท โมเดลกำกับแบบคลาสสิกใช้คุณลักษณะคำหรือ n-gram ในขณะที่ทรานส์ฟอร์มเมอร์เรียนรู้การแทนค่าบริบทและสามารถปรับแต่งต่อได้
การกระตุ้นแบบ few-shot อาจสะดวก แต่ผลลัพธ์ขึ้นอยู่กับตัวอย่างและการใช้คำ เปรียบเทียบวิธีที่ซับซ้อนทุกอย่างกับฐานข้อมูลและใช้ การเรียนรู้แบบ few-shot เฉพาะกับชุดประเมินที่แยกออกและมีเวอร์ชัน
ความท้าทายด้านข้อมูลและภาษา
ป้ายกำกับอาจสะท้อนมุมมองของผู้ทำเครื่องหมายแทนความจริงเชิงวัตถุ การเปลี่ยนแปลงโดเมนรุนแรง: ‘unpredictable’ อาจเป็นคำชมสำหรับภาพยนตร์และเป็นการวิจารณ์สำหรับยานยนต์ การสลับโค้ด, ภาษาถิ่น, อีโมจิ, คำพูดที่อ้างอิง, และอารมณ์เสียดสีทำให้สัญญาณระดับโทเคนซับซ้อน
ควรทำสมดุลคลาสโดยเจตนาและป้องกันไม่ให้ผู้เขียน, ผลิตภัณฑ์, หรือการสนทนาที่เกี่ยวข้องรั่วไหลระหว่างชุดฝึกและชุดทดสอบ โมเดลที่จำแบรนด์หรือผู้พูดได้อาจดูเหมือนแม่นยำโดยไม่ได้เรียนรู้อารมณ์จริง
การประเมินและการใช้อย่างรับผิดชอบ
รายงานค่าความแม่นยำ (precision), การเรียกคืน (recall), F1, และ เมทริกซ์สับสน แทนการใช้ความแม่นยำเพียงอย่างเดียว ตรวจสอบข้อผิดพลาดตามแง่มุม, ความยาว, ภาษาถิ่น, และเวลา, และปรับค่าขีดจำกัดให้สอดคล้องกับต้นทุนการดำเนินการของแต่ละข้อผิดพลาด
การสรุปแนวโน้มโดยรวมอาจสนับสนุนการวิจัยหรือการคัดกรอง, แต่การสรุปสถานะของบุคคลหรือการตัดสินใจด้านการจ้างงาน, เครดิต, สุขภาพ, หรือการบังคับใช้กฎหมายสร้างความเสี่ยงที่สูงขึ้น ควรให้ข้อมูลความไม่แน่นอน, บริบทแหล่งที่มา, การควบคุมความเป็นส่วนตัว, และการตรวจสอบโดยมนุษย์
การทำเครื่องหมายและการสร้างชุดข้อมูล
เขียนคู่มือการทำเครื่องหมายที่ระบุเอนทิตี้เป้าหมาย, หน่วยการวิเคราะห์, คำจำกัดความของป้ายกำกับ, การจัดการข้อความผสมและเป็นกลาง, กฎการอ้างอิง, นโยบายการเสียดสี, และตัวอย่างจากโดเมน ทดลองกับผู้ทำเครื่องหมายหลายคน, คำนวณความสอดคล้อง, พิจารณาความขัดแย้ง, และแก้ไขงานก่อนขยายขนาดป้ายกำกับ
การสุ่มตัวอย่างกำหนดสิ่งที่โมเดลจะเรียนรู้ สตรีมโซเชียลมีเดียอาจให้ความสำคัญเกินไปกับบัญชีที่เคลื่อนไหวสูง; ตั๋วสนับสนุนอาจละเว้นลูกค้าที่พึงพอใจ; การให้คะแนนดาวอาจไม่ตรงกับข้อความรีวิว ควรเก็บเมตาดาต้าแหล่งที่มาและเวลา, เคารพเงื่อนไขของแพลตฟอร์มและความเป็นส่วนตัว, และสร้างชุดทดสอบจากประชากรที่การตัดสินใจจะเกิดขึ้น
การรั่วไหลของป้ายกำกับอาจเกิดจากการให้คะแนน, อีโมจิที่ระบบเก็บข้อมูลแทรก, ลายเซ็นแบบเทมเพลต, หรือชื่อผลิตภัณฑ์ที่สัมพันธ์กับอารมณ์ ทำการลบโพสต์ที่คล้ายกันและจัดกลุ่มการสนทนาหรือผู้เขียนเพื่อให้ภาษาของพวกเขาไม่ปรากฏบนทั้งสองฝั่งของการแบ่ง
การเลือกโมเดลและการปรับเทียบ
ระบบพจนานุกรมรวมคะแนนคำและปรับตามการปฏิเสธ, ตัวขยาย, เครื่องหมายวรรคตอน, หรืออีโมจิ พวกมันให้การตรวจสอบความสมเหตุสมผลที่มีประโยชน์และสามารถปรับให้เข้ากับคำศัพท์โดเมน โมเดลเชิงเส้นที่ใช้คุณลักษณะ TF–IDF ยังคงแข่งขันได้ในบางชุดข้อมูลและเปิดเผย n-gram ที่มีอิทธิพล
ตัวเข้ารหัสเชิงบริบทแทนคำตามข้อความรอบข้างและสามารถปรับแต่งสำหรับความเป็นบวกหรือลบหรือแง่มุมได้ เอกสารยาวอาจต้องการโมเดลเชิงลำดับชั้น, การรวมประโยค, หรือการดึงส่วนที่เกี่ยวข้อง วิธีการหลายภาษาอาจฝึกโมเดลร่วมหนึ่ง, แปลเป็นภาษากลาง, หรือรักษาโมเดลท้องถิ่น; แต่ละวิธีมีการครอบคลุมและการแลกเปลี่ยนด้านวัฒนธรรม
การปรับเทียบความน่าจะเป็นมีความสำคัญเมื่อคะแนนกระตุ้นการดำเนินการ แผนภูมิเชื่อถือได้และค่าความผิดพลาดการปรับเทียบที่คาดหวังเปิดเผยว่าความเชื่อมั่น 0.8 ที่รายงานสอดคล้องกับความถูกต้องประมาณ 80% หรือไม่ ขีดจำกัดสามารถสร้างช่วงการละเว้นสำหรับการตรวจสอบโดยมนุษย์, และการตั้งขีดจำกัดแยกต่างหากอาจเป็นเหตุผลเมื่อต้นทุนข้อผิดพลาดแตกต่างกัน—ไม่ใช่เพื่อปกปิดคุณภาพที่ไม่เท่าเทียม
การประยุกต์ใช้และการตีความผิดทั่วไป
การสรุปอารมณ์โดยรวมสามารถช่วยจัดลำดับความสำคัญของธีม, เปรียบเทียบการตอบสนองของแคมเปญ, หรือส่งข้อความบริการเร่งด่วน การวิเคราะห์แง่มุมมักให้ข้อมูลที่นำไปปฏิบัติได้มากกว่าความเป็นบวกโดยรวมเพราะระบุว่าผู้คนพูดถึงอะไร การวิเคราะห์แนวโน้มต้องการการสุ่มตัวอย่างที่เสถียรและคำจำกัดความของป้ายกำกับตลอดเวลา
อย่าเทียบความแพร่หลายของโพสต์ลบกับความคิดเห็นของประชากร พฤติกรรมการโพสต์, บอท, การกลั่นกรอง, ประชากรของแพลตฟอร์ม, แคมเปญ, และคำค้นการเก็บข้อมูลกำหนดลักษณะของตัวอย่าง โมเดลอารมณ์ไม่ได้วัดประชากรที่เงียบ, และการเปลี่ยนแปลงคำพูดอาจดูเหมือนการเปลี่ยนแปลงทัศนคติ
สำหรับการตัดสินใจส่วนบุคคล, ป้ายกำกับที่ผิดอาจทำให้เกิดการตีตราและยากต่อการโต้แย้ง หลีกเลี่ยงการใช้อารมณ์เป็นตัวแทนของการมีส่วนร่วมของพนักงาน, สุขภาพจิต, ความน่าเชื่อถือทางเครดิต, ความตั้งใจ, หรือการหลอกลวง เมื่อผู้คนได้รับผลกระทบ, ควรแสดงบริบทแหล่งที่มา, อนุญาตให้แก้ไข, และกำหนดให้มีผู้ตัดสินใจที่เป็นมนุษย์พร้อมอำนาจการตัดสินใจจริง
ตัวอย่างทำงาน: การวิเคราะห์อารมณ์สำหรับความคิดเห็นของลูกค้า
บริษัทที่วิเคราะห์ความคิดเห็นการสนับสนุนควรกำหนดว่าต้องการอารมณ์ระดับเอกสาร, อารมณ์ตามแง่มุม, ความรู้สึก, ความเร่งด่วน, หรือการจัดประเภทปัญหา หรือไม่ คำว่า ‘การจัดส่งรวดเร็วแต่ผลิตภัณฑ์เสีย’ ไม่สามารถแสดงอย่างถูกต้องด้วยป้ายกำกับบวกหรือลบเดียว ควรสร้างคู่มือการทำเครื่องหมายสำหรับเป้าหมาย, การปฏิเสธ, การเสียดสี, คำพูดผสม, คำพูดอ้างอิง, และกรณีที่ไม่ทราบ, จากนั้นวัดความสอดคล้องก่อนถือป้ายกำกับเป็นความจริงพื้นฐาน
เปรียบเทียบพจนานุกรมหรือฐานเชิงเส้นกับตัวเข้ารหัสที่ปรับแต่งหรือโมเดลภาษาที่กระตุ้น แบ่งข้อมูลตามเวลา หรือ ลูกค้าเพื่อป้องกันการรั่วไหลของข้อมูลที่คล้ายกัน, และรักษาความถี่ของคลาส รายงานค่าความแม่นยำ, การเรียกคืน, F1, การปรับเทียบ, และเมทริกซ์สับสนตามภาษา, ช่องทาง, ผลิตภัณฑ์, และตัวแทนประชากรเฉพาะเมื่อเป็นไปตามกฎหมายและมีเหตุผล ตรวจสอบข้อผิดพลาดที่มีความมั่นใจสูงเพราะมีความอันตรายมากกว่าในการกำหนดเส้นทางอัตโนมัติเมื่อเทียบกับผลลัพธ์ที่ไม่แน่นอนที่ถูกส่งต่อ
ใช้อารมณ์เป็นสัญญาณหนึ่งสำหรับการสรุปหรือการจัดลำดับความสำคัญ, ไม่ใช่มาตรการที่ไม่ต้องสงสัยของสภาพของบุคคล ตรวจสอบคำศัพท์และการเปลี่ยนแปลงของผลิตภัณฑ์, ฝึกใหม่ด้วยตัวอย่างที่ตรวจสอบแล้ว, และอนุญาตให้ตัวแทนแก้ไขป้ายกำกับ ไม่ควรสรุปลักษณะที่ได้รับการคุ้มครองหรือทำโทษพนักงานจากคะแนนอารมณ์ที่ไม่ได้ตรวจสอบ สำหรับการรายงานระดับผู้บริหาร, แสดงขนาดตัวอย่าง, ความไม่แน่นอน, ข้อมูลที่ขาดหาย, และหัวข้อที่ขับเคลื่อนการเปลี่ยนแปลง เพื่อให้คะแนนที่ผันแปรนำไปสู่การสืบสวนแทนการสรุปอย่างง่ายดาย
การใช้งานหลายภาษาควรไม่สมมติว่าการแปลอินพุตจะคงโทน, การปฏิเสธ, สำนวน, หรือขนบธรรมเนียมวัฒนธรรม ตรวจสอบแต่ละภาษาที่รองรับและรูปแบบหลายภาษาโดยผู้ตรวจสอบเจ้าของภาษา, และให้ผลลัพธ์ที่ไม่ทราบเมื่อหลักฐานอ่อนแอ การปรับโดเมนก็สำคัญ: คำที่ฟังดูเป็นลบในสนทนาทั่วไปอาจเป็นคำอธิบายทางเทคนิคที่เป็นกลาง รักษาขีดจำกัดหรือโมเดลแยกต่างหากเฉพาะเมื่อหลักฐานการดำเนินงานยืนยันความซับซ้อนและภาระการกำกับที่เพิ่มขึ้น
รายการตรวจสอบการดำเนินการเชิงปฏิบัติ
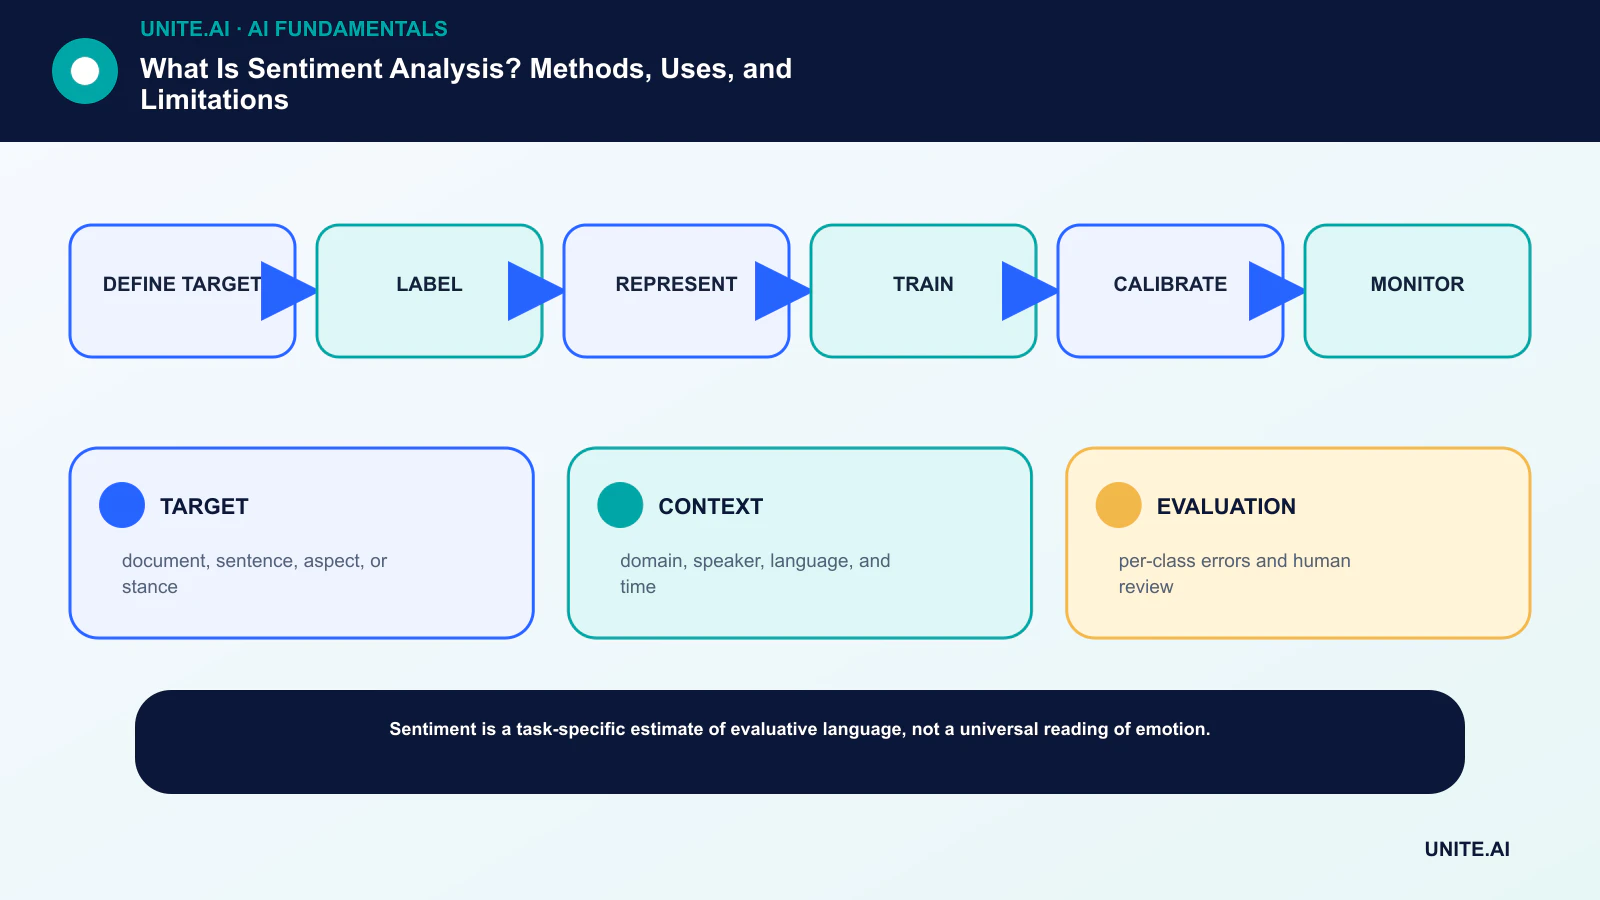
แปลงแนวคิดเป็นกระบวนการทำงานที่จำกัดและทดสอบได้: กำหนดเป้าหมาย → ป้ายกำกับ → ตัวแทน → ฝึก → ปรับเทียบ → ตรวจสอบ ตั้งชื่อเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้างฐานข้อมูลง่าย, กำหนดเกณฑ์การยอมรับและการหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการตรวจสอบ, การย้อนกลับ, และการรีวิวก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนเปิดใช้งาน, ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้งานผิดวิธี; เก็บรักษาหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข กำหนดว่าใครสามารถอนุมัติการปล่อย, เปลี่ยนขีดจำกัด, ยกเลิกผลลัพธ์, หรือหยุดการดำเนินการ ตรวจสอบการตัดสินใจอีกครั้งหลังจากข้อมูลจริงมาถึง, เนื่องจากการทดลองที่ประสบความสำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- เป้าหมาย: เอกสาร, ประโยค, แง่มุม, หรือท่าที.
- บริบท: โดเมน, ผู้พูด, ภาษา, และเวลา.
- การประเมิน: ข้อผิดพลาดตามคลาสและการตรวจสอบโดยมนุษย์.
คำถามที่พบบ่อย
การวิเคราะห์อารมณ์เป็นวัตถุประสงค์หรือไม่?
ไม่. มันประมาณค่าป้ายกำกับที่กำหนดโดยงานและกระบวนการทำเครื่องหมาย ข้อความบางส่วนจริง ๆ แล้วคลุมเครือ, ผสมผสาน, ขึ้นกับบริบท, หรือถูกตีความต่างกันโดยผู้อ่าน
การวิเคราะห์อารมณ์สามารถตรวจจับการเสียดสีได้หรือไม่?
โมเดลสามารถเรียนรู้รูปแบบบางอย่างได้, แต่การเสียดสีมักขึ้นอยู่กับประวัติผู้พูด, ความรู้ร่วม, และบริบทนอกข้อความ มันยังคงเป็นโหมดความล้มเหลวที่พบบ่อย
แหล่งอ้างอิงหลัก












