
พื้นฐาน AI
การจำแนกข้อความทำงานอย่างไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การจำแนกข้อความ กำหนดหนึ่งหรือหลายป้ายกำกับให้กับเอกสาร, ข้อความ หรือช่วงของข้อความ ตัวอย่างรวมถึงการตรวจจับสแปม, การกำหนดเส้นทางตามเจตนา, การวิเคราะห์อารมณ์, การตั้งหัวข้อ, การตรวจสอบและการจัดลำดับความสำคัญของตั๋วสนับสนุน
ตัวจำแนกในระดับการผลิตเป็นมากกว่ารุ่นโมเดล มันขึ้นอยู่กับระบบการจัดประเภทป้ายกำกับที่แม่นยำ, การทำเครื่องหมายที่เป็นตัวแทน, การแบ่งข้อมูลที่ปลอดการรั่วไหล, กฎการตัดสินใจที่ปรับเทียบและการตรวจสอบสำหรับการเปลี่ยนแปลงของภาษาและความถี่ของคลาส
ประเด็นสำคัญ
- กำหนดป้ายกำกับและกรณีที่คลุมเครือก่อนเลือกสถาปัตยกรรม
- ฐานข้อมูล bag‑of‑words แบบง่ายยังคงมีคุณค่า; ตัวเข้ารหัสที่ผ่านการฝึกล่วงหน้าเพิ่มบริบทและการเรียนรู้แบบถ่ายโอน
- ความแม่นยำอาจปกปิดประสิทธิภาพที่แย่ของคลาสส่วนน้อย, ดังนั้นควรใช้เมตริกที่รับรู้คลาสและการวิเคราะห์ข้อผิดพลาด
- การปรับเทียบความน่าจะเป็น, การละเว้นและการตรวจสอบโดยมนุษย์ทำให้คะแนนกลายเป็นการตัดสินใจที่ปลอดภัยยิ่งขึ้น
กำหนดระบบการจัดประเภทและนโยบายการทำเครื่องหมาย
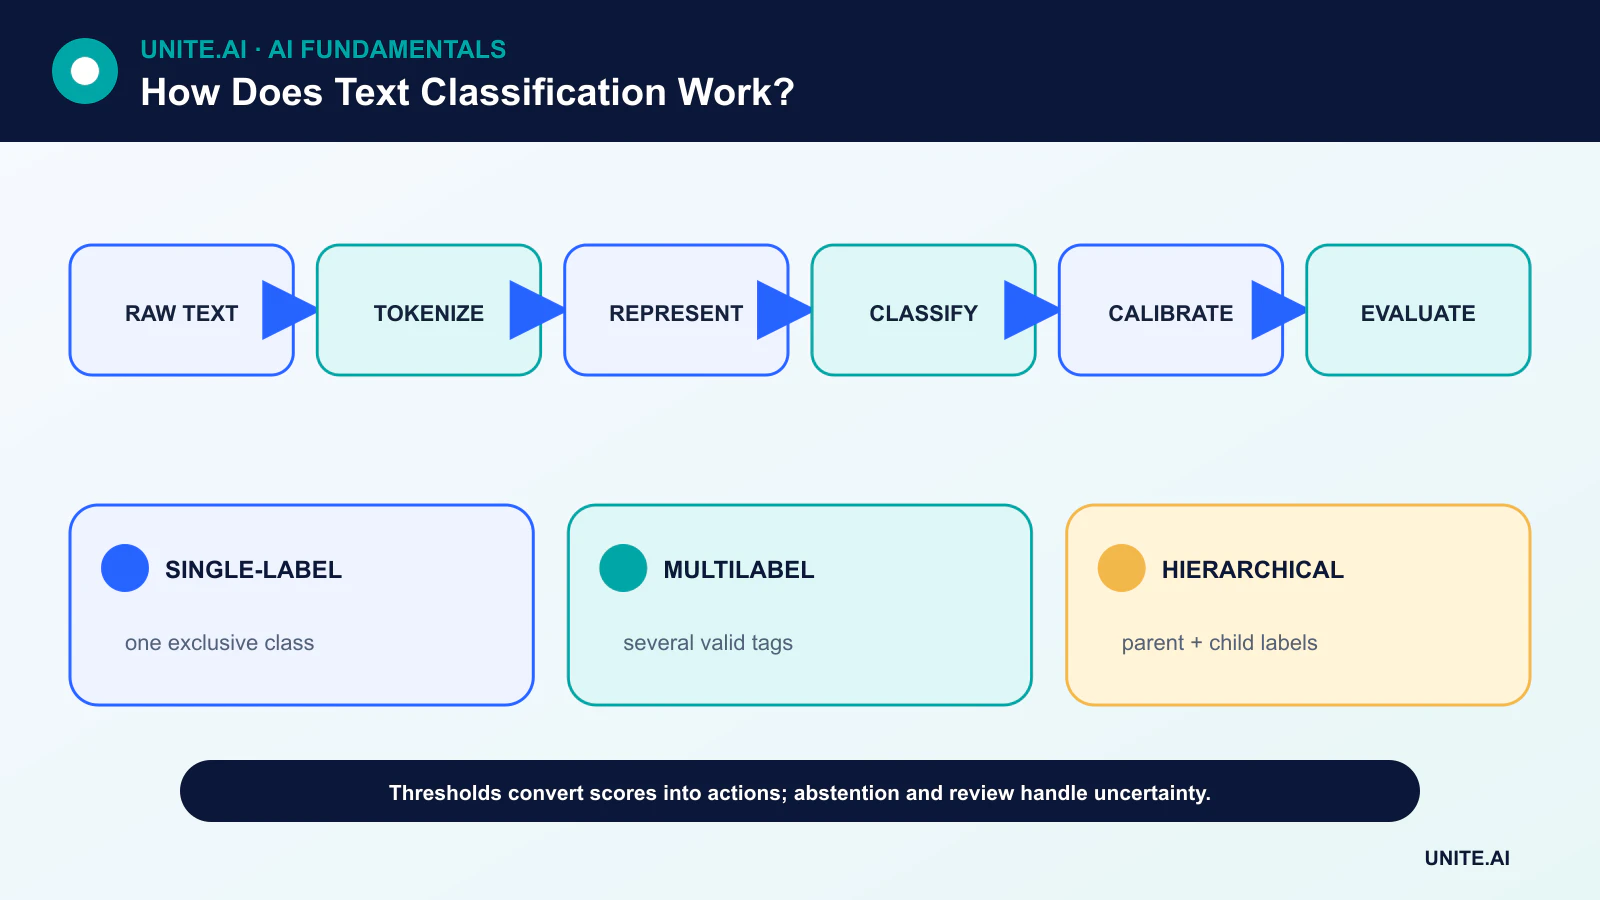
งานที่มีป้ายกำกับเดียวเลือกคลาสที่ไม่ซ้อนทับกันหนึ่งคลาส งานหลายป้ายกำกับอาจกำหนดแท็กหลายอันที่เป็นอิสระ ระบบการจัดประเภทแบบลำดับชั้นมีป้ายกำกับระดับพ่อแม่และระดับบุตร สิ่งเหล่านี้เป็นปัญหาการเรียนรู้ที่แตกต่างกันและต้องการผลลัพธ์และเมตริกที่ต่างกัน
ผู้ทำเครื่องหมายต้องการคำนิยาม, ตัวอย่างบวกและลบ, กฎสำหรับบริบทที่ขาดหายและเส้นทางการขยายระดับ สถิติความสอดคล้องอาจเปิดเผยงานที่ไม่ชัดเจน, แต่ความไม่สอดคล้องอาจเป็นความคลุมเครือที่แท้จริงซึ่งระบบควรคงไว้
การแสดงข้อความ
กระบวนการแบบดั้งเดิมใช้การนับโทเคน, n‑gram และ TF‑IDF ร่วมกับตัวจำแนกเชิงเส้นหรือเครื่องเวกเตอร์สนับสนุน. พวกมันฝึกได้อย่างรวดเร็ว, เปิดเผยคำที่มีอิทธิพลและให้ฐานข้อมูลที่แข็งแกร่ง
ระบบประสาทเทียมแปลงโทเคนเป็นเวกเตอร์ฝังตัว ตัวเข้ารหัสทรานสฟอร์มเมอร์ที่ผ่านการฝึกล่วงหน้าใช้กลไกความสนใจเพื่อสร้างการแสดงผลเชิงบริบทและสามารถปรับแต่งเพิ่มเติมด้วยตัวอย่างที่มีป้ายกำกับ ตัวจำแนกที่ใช้การกระตุ้นหรือศูนย์ช็อตสามารถลดการทำเครื่องหมายเริ่มต้นได้, แต่การใช้คำของป้ายกำกับ, รุ่นของโมเดลและการปรับเทียบต้องได้รับการประเมินในโดเมนจริง
การฝึกโดยไม่มีการรั่วไหล
ชุดข้อมูลถูกแยกเป็นข้อมูลฝึก, ตรวจสอบความถูกต้องและข้อมูลทดสอบสุดท้าย เอกสารที่ซ้ำกันเกือบ, ข้อความจากการสนทนาเดียวกันหรือเทมเพลตจากแหล่งเดียวกันควรอยู่ในส่วนเดียวกัน สำหรับการใช้งานที่ขึ้นกับเวลา การแบ่งตามลำดับเวลาให้ภาพที่ดีกว่าของการนำไปใช้
ความไม่สมดุลของคลาสสามารถแก้ไขได้โดยการให้ค่าน้ำหนัก, การสุ่มใหม่, การเลือกเกณฑ์หรือข้อมูลเพิ่มเติม ตัวอย่างสังเคราะห์ไม่ควรแทนที่การตรวจสอบความล้มเหลวของคลาสส่วนน้อยจริงและอาจสร้างศิลปวัตถุที่โมเดลเรียนรู้ได้ง่ายเกินไป
เมตริกและการตัดสินใจที่ปรับเทียบ
เมทริกซ์ความสับสนแสดงว่าป้ายกำกับใดบ้างที่สับสน ความแม่นยำวัดจำนวนผลบวกที่คาดการณ์ถูกต้อง; การเรียกคืนวัดจำนวนผลบวกจริงที่พบ ค่าเฉลี่ยแบบแมโครให้ค่าน้ำหนักคลาสเท่าเทียมกัน, ในขณะที่ค่าเฉลี่ยแบบไมโครให้ค่าน้ำหนักตัวอย่างแต่ละรายการ
คะแนนซอฟต์แมกซ์ดิบไม่ได้เป็นความน่าจะเป็นที่เชื่อถือได้โดยอัตโนมัติ การปรับเทียบเปรียบเทียบความมั่นใจกับความถูกต้องที่สังเกตได้ ทีมงานสามารถกำหนดเกณฑ์เฉพาะคลาส, เลิกทำเมื่อความมั่นใจต่ำและส่งกรณีที่สำคัญไปยังผู้ตรวจสอบ
การนำไปใช้, การใช้หลายภาษาและการเปลี่ยนแปลง
ข้อความเปลี่ยนแปลงตามผลิตภัณฑ์, เหตุการณ์, สแลงและพฤติกรรมเชิงศัตรู การเฝ้าติดตามควรตรวจสอบภาษาขาเข้า, ความยาว, รูปแบบที่อยู่นอกพจนานุกรม, อัตราคลาส, ความมั่นใจและผลลัพธ์ที่ล่าช้า การฝึกซ้ำต้องใช้ข้อมูลที่มีเวอร์ชันและชุดการทดสอบรีเกรสชันของตัวอย่างสำคัญ
ประสิทธิภาพหลายภาษาต้องทดสอบตามแต่ละภาษาและสำเนียง การแปลทั้งหมดเป็นภาษาหนึ่งอาจเปลี่ยนอารมณ์หรือเอนทิตี; ตัวเข้ารหัสหลายภาษายังอาจทำงานไม่สม่ำเสมอเนื่องจากการฝึกล่วงหน้าและป้ายกำกับไม่เป็นตัวแทนอย่างเท่าเทียม
การแสดงผลและตระกูลตัวจำแนก
การจำแนกข้อความแมปเอกสาร, ประโยค หรือลำดับโทเคนไปยังหนึ่งหรือหลายป้ายกำกับ กำหนดว่าป้ายกำกับเป็นแบบไม่ซ้อนทับกัน, หลายป้าย, ลำดับชั้น, มีลำดับหรือเปิดชุด ระบบแบบดั้งเดิมทำการแยกโทเคนข้อความ, สร้างฟีเจอร์ bag‑of‑words หรือ TF‑IDF และฝึกโลจิสติกรีเกรสชัน, naive Bayes หรือ SVM เชิงเส้น ระบบประสาทเทียมเรียนรู้การฝังตัวด้วยคอนโวลูชัน, การวนซ้ำ หรือทรานสฟอร์มเมอร์ โมเดลภาษาที่กระตุ้นสามารถจำแนกได้โดยไม่ต้องฝึกเฉพาะงาน, แต่ข้อจำกัดของผลลัพธ์, ค่าใช้จ่าย, การเปลี่ยนแปลงและหลักฐานยังต้องประเมินเทียบกับฐานข้อมูลที่ง่ายกว่า
การเตรียมข้อมูลล่วงหน้าขึ้นอยู่กับการแสดงผล การทำให้เป็นตัวพิมพ์เล็กหรือการลบเครื่องหมายวรรคตอนอาจทำลายสัญญาณสำหรับชื่อ, อารมณ์, โค้ด หรือภาษา; การสเตมมอาจทำให้ความหมายที่แตกต่างกันรวมกัน ตัวแยกโทเคนของทรานสฟอร์มเมอร์ทำงานบนซับเวิร์ดและมีขีดจำกัดความยาว, ดังนั้นกลยุทธ์การตัดข้อความจึงสำคัญ เอกสารยาวอาจต้องแบ่งเป็นส่วนและรวมผล รักษาข้อความดิบและเวอร์ชันการแปลง, และแบ่งตามผู้เขียน, การสนทนา, แหล่งหรือเวลาเพื่อป้องกันการซ้ำใกล้เคียงและเทมเพลตที่เกิดซ้ำจากการข้ามชุดฝึกและทดสอบ
ป้ายกำกับ, เมตริกและการวิเคราะห์ข้อผิดพลาด
คู่มือการทำเครื่องหมายควรกำหนดขอบเขต, ตัวอย่าง, กรณีที่คลุมเครือ, และตัวเลือกไม่ทราบหรือละเว้น วัดความสอดคล้องและตัดสินความไม่สอดคล้องแทนการซ่อนด้วยการโหวตส่วนใหญ่ สำหรับคลาสที่ไม่สมดุล ความแม่นยำไม่เพียงพอ; รายงานความแม่นยำ, การเรียกคืน, F1, ความสับสน, การปรับเทียบและภาระงานตามเกณฑ์เฉพาะคลาส งานหลายป้ายต้องการเมตริกแบบไมโคร, แมโครและระดับป้ายกำกับ ประเมินภาษา, สำเนียง, โดเมน, ความยาวข้อความและเวลา การแบ่งแบบสุ่มอาจทำให้คุณภาพดูดีเกินจริงเมื่อคำศัพท์หรือเทมเพลตเปลี่ยนแปลง
การวิเคราะห์ข้อผิดพลาดควรแยกความล้มเหลวของการแสดงผล, บริบทที่ไม่เพียงพอ, ความคลุมเครือของป้ายกำกับ, คำศัพท์หายาก, การปฏิเสธ, การเสียดสีและสัญญาณเท็จ ใช้การทดสอบเชิงตรงข้ามที่เปลี่ยนชื่อ, ตัวบ่งชี้สำเนียงหรือเมตาดาต้าที่ไม่เกี่ยวข้องในขณะที่รักษาความหมาย ตรวจสอบข้อผิดพลาดที่มีความมั่นใจสูงและกรณีที่ถูกปฏิเสธ โมเดลอาจเรียนรู้ว่าช่องทางลูกค้าหรือลายเซ็นทำนายป้ายกำกับแทนการตีความเนื้อหา ลบการรั่วไหลและปรับปรุงข้อมูลก่อนเพิ่มความจุของโมเดลอย่างเดียว
การออกแบบการผลิต
ให้บริการตัวแยกโทเคนและโมเดลที่คงที่พร้อมการตรวจสอบสคีม่า, ขีดจำกัดความยาว, การทำแบตช์, และการสำรองสำหรับภาษาที่ไม่รองรับหรือความมั่นใจต่ำ เฝ้าติดตามการกระจายข้อมูลขาเข้า, อัตราป้ายกำกับ, การปรับเทียบ, ความหน่วงและผลลัพธ์ที่ตรวจสอบแล้ว ปกป้องข้อความเพราะอาจมีคำสั่งส่วนบุคคล, ลับหรือเชิงศัตรู สำหรับการตรวจสอบอัตโนมัติ, ความมีสิทธิ์หรือการกำหนดเส้นทาง ให้การอุทธรณ์และวัดข้อผิดพลาดที่แตกต่างกัน เวอร์ชันป้ายกำกับและเกณฑ์ตามนโยบายธุรกิจ การจำแนกข้อความเชื่อถือได้เฉพาะภายในระบบป้ายกำกับและการกระจายข้อมูลที่กำหนด; คำอธิบายโมเดลที่คล่องแคล่วไม่ได้พิสูจน์ว่าการจำแนกนั้นถูกต้อง
ตัวอย่างการทำงาน: การจำแนกคำขอสนับสนุนที่เข้ามา
ทีมสนับสนุนกำหนดป้ายกำกับการกำหนดเส้นทางที่ไม่ซ้อนทับกันพร้อมกับธงเร่งด่วน, หลายภาษาและไม่ทราบ ผู้ทำเครื่องหมายทำการป้ายกำกับข้อความที่ไม่มีข้อมูลส่วนบุคคลพร้อมคำแนะนำสำหรับประเด็นผสมและวัดความสอดคล้อง ฐานโลจิสติก TF‑IDF, ตัวเข้ารหัสที่ปรับแต่งเพิ่มเติม, และโมเดลที่กระตุ้นใช้ชุดทดสอบตามเวลาเดียวกัน รายงานการประเมินแสดงความแม่นยำและการเรียกคืนของคลาส, ผลลบเชิงเร่งด่วน, การปรับเทียบ, ความถูกต้องของสคีม่า, ความหน่วงและค่าใช้จ่าย, พร้อมกับการจัดกลุ่มเทมเพลตที่ซ้ำใกล้เคียงเพื่อหลีกเลี่ยงการรั่วไหล
ตัวจำแนกที่นำไปใช้ตรวจสอบภาษาและความยาว, เลิกทำเมื่อหลักฐานอ่อนแอ, และให้ตัวแทนแก้ไขเส้นทาง การกระตุ้นและข้อความถือว่าไม่น่าเชื่อถือ; การเข้าถึงเครื่องมือไม่มี การเฝ้าติดตามติดตามความถี่ของป้ายกำกับ, ความมั่นใจ, การแก้ไข, เวลาตอบสนองและหัวข้อที่กำลังเกิดขึ้น นโยบายหรือการเปลี่ยนแปลงผลิตภัณฑ์อัปเดตระบบการจัดประเภทและข้อมูลการฝึกซ้ำผ่านการตรวจสอบ ระบบทำให้การจัดคิวดีขึ้น, แต่ไม่สรุปอารมณ์หรือสิทธิของลูกค้านอกเหนือจากป้ายกำกับที่ตรวจสอบแล้ว
หลักฐานการนำไปใช้และความพร้อมในการดำเนินงาน
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละอย่าง สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัวและความปลอดภัย บันทึกการแปลงทุกขั้นตอนและเกณฑ์เพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนการเปิดตัว ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับและการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยการฉีดความล้มเหลวโดยเจตนา โทรเมตริกการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดการทำงานหรือแทนที่
คำถามที่พบบ่อย
การวิเคราะห์อารมณ์เป็นงานการจำแนกข้อความหรือไม่?
โดยทั่วไปใช่, แต่ความรู้สึกอาจเป็นหลายป้าย, ตามแง่มุม หรือเป็นค่าต่อเนื่องแทนการเป็นป้ายเดียวเช่น บวก/กลาง/ลบ
เมื่อใดที่ตัวจำแนกข้อความควรละเว้น?
เมื่อความมั่นใจต่ำ, ข้อความอยู่นอกขอบเขต, บริบทที่ต้องการขาดหาย หรือค่าใช้จ่ายของการกระทำอัตโนมัติที่ผิดพลาดเกินกว่าค่าใช้จ่ายของการตรวจสอบ
อ้างอิงหลัก












