
พื้นฐาน AI
อะไรคือการรู้จำเสียงสนทนา (CSR)?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การรู้จำเสียงสนทนา (CSR) ขยายการรู้จำเสียงอัตโนมัติ (ASR) ที่ทำการถอดเสียงแบบแยกส่วนโดยใช้บริบทของการสนทนา สัญญาณการสลับ turn, ข้อมูลผู้พูด และการประมวลผลที่มีความหน่วงต่ำ เป้าหมายคือสนับสนุนการโต้ตอบแบบสดที่คำพูด เวลา การขัดจังหวะ และ turn ก่อนหน้ามีความสำคัญทั้งหมด
CSR เป็นฉลากผลิตภัณฑ์และการวิจัยที่กำลังเกิดขึ้น ไม่ใช่คลาสโมเดลมาตรฐานเดียว ระบบที่แข็งแกร่งจะผสานการสตรีม ASR กับการกำหนดจุดสิ้นสุด การจัดการผู้พูด การสร้างแบบจำลองภาษาแบบบริบท สถานะการสนทนา และนโยบายการตอบสนอง จากนั้นประเมินประสบการณ์จากต้นจนจบ
ประเด็นสำคัญ
- การรู้จำแบบสตรีมมิ่งจะส่งออกสมมติฐานชั่วคราวและแก้ไขเมื่อเสียงเพิ่มเข้ามา
- การกำหนดจุดสิ้นสุดและการคาดการณ์ turn แยกจากความแม่นยำของการถอดเสียง
- ประวัติการสนทนาและ hotword สามารถปรับปรุงการรู้จำได้แต่ก็อาจทำให้ข้อผิดพลาดก่อนหน้าถูกส่งต่อ
- ประเมินความหน่วง เวลาแทรก ผู้พูด สำเนียง เสียงรบกวน ความเป็นส่วนตัว และการทำงานสำเร็จของงาน—not เพียงอัตราความผิดพลาดของคำ (WER) อย่างเดียว
จาก ASR ไปสู่การสนทนาสด
ASR แบบดั้งเดิม ASR แปลงเสียงเป็นข้อความ ระบบสนทนาต้องตัดสินใจว่าเมื่อใดจะฟัง เมื่อ turn เสร็จสิ้น หรือว่าการพูดมุ่งเป้าไปที่ระบบหรือไม่ และจะกู้คืนอย่างไรเมื่อถอดข้อความหรือการตอบกลับผิดพลาด
โมเดลสตรีมมิ่งประมวลผลเฟรมอย่างต่อเนื่องและสร้างข้อความบางส่วน ความหน่วงต่ำทำให้ตอบสนองเร็วขึ้น แต่การตัดสินใจเร็วเกินไปอาจเพิ่มการแก้ไขหรือข้อผิดพลาด ระบบต้องมีนโยบายสำหรับข้อความที่มั่นคงกับข้อความชั่วคราว
การสลับ การผลัดกันพูด การพูดทับซ้อน, และผู้พูด
ระยะเวลาความเงียบเพียงอย่างเดียวเป็นสัญญาณจุดสิ้นสุดที่อ่อนแอ การเติมเต็มเชิงอักษร โพรโซดี้ เวลา การจ้องมอง และสถานะการสนทนาสามารถช่วยคาดการณ์ว่าผู้พูดกำลังถือหรือปล่อย floor การบรรเทา (barge‑in) ทำให้ผู้ใช้สามารถขัดจังหวะเสียงสังเคราะห์ได้โดยไม่สูญเสียบริบท
เสียงที่ทับซ้อนและการแยกผู้พูดยังคงเป็นความท้าทาย ระบบควรรักษาความไม่แน่นอนของผู้พูด หลีกเลี่ยงการอ้างอิงคำพูดให้กับคนผิด และให้เส้นทางการแก้ไข—โดยเฉพาะสำหรับบันทึกที่ใช้ในด้านสุขภาพ การเงิน หรือกฎหมาย
การรู้จำแบบมีบริบท
Turn ก่อนหน้าสามารถทำให้ชื่อและการอ้างอิงไม่กำกวม; รายการ hotword สามารถทำให้การรู้จำโน้มไปทางคำศัพท์เฉพาะโดเมน โมเดลภาษาพูดอาจเข้ารหัสบริบทเสียงและข้อความในกรอบการ prompting หรือ attention ร่วม
บริบทอาจยังคงเสริมข้อความที่ถอดผิดหรือรั่วไหลข้อมูลระหว่างเซสชัน จำกัดประวัติให้เพียงเพื่อวัตถุประสงค์ปัจจุบัน แยกเมตาดาต้าเชื่อถือได้จากเสียงผู้ใช้ และใช้บริบท transformer พร้อมกฎการเก็บรักษาและการเข้าถึงที่ชัดเจน
การประเมินและการใช้งานอย่างรับผิดชอบ
รายงานอัตราความผิดพลาดของคำแบบสตรีมมิ่ง, ความหน่วงของ token แรกและการสรุป, อัตราการแก้ไข, ข้อผิดพลาดจุดสิ้นสุด, ความสำเร็จของ barge‑in, การอ้างอิงผู้พูด, และการทำงานสำเร็จของงาน ทดสอบกับไมโครโฟนจริง, เสียงรบกวน, สำเนียง, การสลับภาษา, ความพิการ, และการพูดที่เต็มไปด้วยอารมณ์
ข้อมูลเสียงอาจเปิดเผยหรือระบุตัวตนได้ ใช้การยินยอม, การลดข้อมูล, การเข้ารหัส, ขีดจำกัดการเก็บรักษา, และการตรวจสอบโดยมนุษย์ เชื่อมการตอบกลับที่สร้างขึ้นกับการควบคุมความปลอดภัยของ chatbot เพราะการถอดข้อความที่แม่นยำไม่ได้ทำให้การตอบสนองถูกต้องหรือได้รับอนุญาต
จากข้อมูลเสียงสู่สถานะการสนทนา
ระบบการพูดสนทนาจะจับเสียง, ทำการปรับสัญญาณ, ตรวจจับการพูด, รู้จำคำหรือหน่วยความหมาย, ระบุผู้พูดเมื่อจำเป็น, และอัปเดตสถานะการสนทนา ระบบสตรีมมิ่งจะสร้างสมมติฐานบางส่วนก่อนที่ utterance จะสิ้นสุด สมมติฐานเหล่านี้อาจเปลี่ยนแปลงได้ ดังนั้นส่วนต่อไปต้องแยกผลลัพธ์ชั่วคราวจากผลลัพธ์สุดท้าย
การตรวจจับกิจกรรมเสียงและการกำหนดจุดสิ้นสุดตัดสินใจว่าเสียงเริ่มเมื่อไหร่และผู้ใช้เสร็จเมื่อไหร่ ค่าเงียบคงที่ไม่ทำงานกับผู้พูดช้า, เสียงรบกวนพื้นหลัง, หรือการหยุดคิด โมเดลการสลับ turn สามารถใช้คำ, โพรโซดี้, การจ้องมอง, และบริบทการสนทนา แต่ต้องสมดุลระหว่างการตอบสนองเร็วกับการตัดผู้พูด
การแยกผู้พูด (diarization) ตอบว่าใครพูดเมื่อไหร่; การระบุผู้พูดประเมินอัตลักษณ์; การแยกแหล่งเสียงแยกเสียงที่ทับซ้อน ทั้งนี้เป็นงานที่ต่างกันและมีความเสี่ยงต่างกัน ในการประชุม, การดูแลสุขภาพ, และการบริการลูกค้า การอ้างอิงคำพูดที่ถูกต้องกับคนที่พูดอาจสำคัญเท่ากับอัตราความผิดพลาดของคำ
บริบท, การทับซ้อน, อารมณ์, และการกู้คืนการโต้ตอบ
บริบทของการสนทนาช่วยแก้ไขสรรพนาม, การละเลย, การแก้ไข, คำเฉพาะโดเมน, และการอ้างอิงถึง turn ก่อนหน้า ระบบสามารถผสานหลักฐานเสียงกับประวัติการสนทนาและความรู้ที่ดึงมาได้ แต่บริบทก่อนหน้าอาจทำให้การรู้จำโน้มไปทางความคาดหมายที่ผิด พิจารณาเก็บหลักฐานเสียงและระดับความมั่นใจเพื่อให้บริบทไม่ลบความไม่แน่นอนโดยเงียบ
การสนทนาธรรมชาติมี backchannel, การขัดจังหวะ, การเริ่มพูดผิด, เสียงหัวเราะ, การสลับภาษา, และการพูดพร้อมกัน ตัวแทนที่ตอบสนองต้องจัดการ barge‑in: หยุดหรือทำให้เสียงออกต่ำ, รับเสียงใหม่ของผู้ใช้, ตัดสินใจว่าการขัดจังหวะเปลี่ยนเจตนาหรือไม่, และกู้คืนโดยไม่ทำซ้ำหรือสูญเสียการกระทำ
โพรโซดี้และสัญญาณพาราลิงกวิสติกสามารถบ่งบอกการเน้นหรือความไม่แน่นอน แต่การสรุปอารมณ์, สุขภาพ, หรือเจตนาจากเสียงมีความผิดพลาดและขึ้นกับวัฒนธรรม ใช้การประมาณเหล่านี้อย่างระมัดระวัง เปิดเผยเมื่อเหมาะสม และอย่าตัดสินใจสำคัญจากป้ายอารมณ์ที่ยังไม่ได้รับการตรวจสอบ
การประเมิน, ความเป็นส่วนตัว, และการออกแบบเพื่อการผลิต
WER ยังคงมีประโยชน์ แต่การประเมินการสนทนาควรวัดการอ้างอิงผู้พูด, ความแม่นยำของเอนทิตี, ความสำเร็จของงานเชิงความหมาย, ความเสถียรของสมมติฐานบางส่วน, ความหน่วงของจุดสิ้นสุด, ความสำเร็จของการขัดจังหวะ, การกู้คืน, และอัตราการแก้ไขของผู้ใช้ แบ่งตามสำเนียง, ภาษา, อุปกรณ์, เสียงรบกวน, การทับซ้อน, สไตล์การพูด, และสภาพเครือข่าย
สถาปัตยกรรมสตรีมมิ่งต้องมีบัฟเฟอร์ที่จำกัด, การกดดันย้อนกลับ, การเชื่อมต่อใหม่, หมายเลขลำดับ, และการสรุปอย่างชัดเจน แยกงบประมาณความหน่วงของโมเดลและของบทสนทนา, ติดตามทุกขั้นตอน, และทดสอบเครือข่ายที่เสื่อมสภาพ เมื่อระบบทำให้เกิดการกระทำ ให้ยืนยันเจตนาที่มีผลสำคัญและทำการลองใหม่ให้เป็น idempotent เพื่อให้เสียงหรือการเชื่อมต่อใหม่ไม่ทำธุรกรรมซ้ำ
เสียงประกอบด้วยอัตลักษณ์, เนื้อหา, สภาพแวดล้อม, และข้อมูลของผู้โดยรอบ ลดการเก็บรักษา, เข้ารหัสการส่งและการเก็บ, ควบคุมการเข้าถึง, กำหนดการลบ, และแยกเสียงจากข้อความและ embedding ที่ได้ ให้แสดงตัวบ่งชี้การบันทึกที่มองเห็นได้และทางเลือกเมื่อไม่มีความยินยอม โมเดลท้องถิ่นอาจลดการถ่ายโอนแต่ยังต้องการการอนุญาตและการควบคุมวงจรชีวิต
ตัวอย่างทำงาน: ตัวแทนเสียงที่จัดการการขัดจังหวะและการแก้ไข
ผู้โทรพูดว่า ‘จองวันอังคาร—ไม่, วันพุธบ่าย’ ในขณะที่ตัวแทนเริ่มตอบหลังคำว่า ‘วันอังคาร’ การสตรีมมิ่งส่งออกข้อความบางส่วนที่เปลี่ยนแปลง, การกำหนดจุดสิ้นสุดตรวจจับการพูดต่อเนื่อง, และ barge‑in หยุดการออกเสียง สถานะการสนทนาตั้งค่าให้วันที่ก่อนหน้าถูกแทนที่แทนที่จะสร้างคำขอสองรายการ การยืนยันเอนทิตีมุ่งที่วันที่และเวลาที่แก้ไข, ระบบเก็บความมั่นใจและหลักฐานสำหรับการตีความสุดท้าย
สถาปัตยกรรมแยกการจับเสียง, การตรวจจับการพูด, การสตรีมมิ่ง, การจัดการผู้พูด, นโยบายบทสนทนา, การดำเนินการเครื่องมือ, และการสังเคราะห์ หมายเลขลำดับและการสรุปป้องกันผลลัพธ์บางส่วนที่ล่าช้าไม่เขียนทับข้อความสุดท้าย เครื่องมือจองรับคำขอที่มีโครงสร้าง, ตรวจสอบการอนุญาตและความพร้อม, ใช้คีย์ idempotency การจองที่สำคัญจะถูกอ่านกลับและยืนยันก่อนดำเนินการ; การเชื่อมต่อใหม่ไม่สามารถทำซ้ำโดยเงียบได้
การทดสอบรวมความแม่นยำของคำและเอนทิตีกับความหน่วงของจุดสิ้นสุด, ความสำเร็จของการขัดจังหวะ, การจัดการการแก้ไข, การอ้างอิงผู้พูด, การทำงานสำเร็จของงาน, และอัตราการทำซ้ำของการกระทำ สถานการณ์ครอบคลุมเสียงรบกวน, การทับซ้อน, สำเนียง, การสลับภาษา, การพูดช้า, อุปกรณ์ช่วยเหลือ, เครือข่ายอ่อน, และการโจมตีด้วยเสียงสังเคราะห์ การเก็บเสียงจะถูกลดและเปิดเผย, ข้อมูลผู้โดยรอบจะจัดการอย่างชัดเจน, และผู้ใช้สามารถสลับเป็นข้อความหรือคนจริง ปัญญาประดิษฐ์สนทนาถูกวัดโดยการกู้คืนอย่างปลอดภัยและผลลัพธ์ ไม่ใช่ความแม่นยำของถอดข้อความเพียงอย่างเดียว
รายการตรวจสอบการนำไปใช้จริง
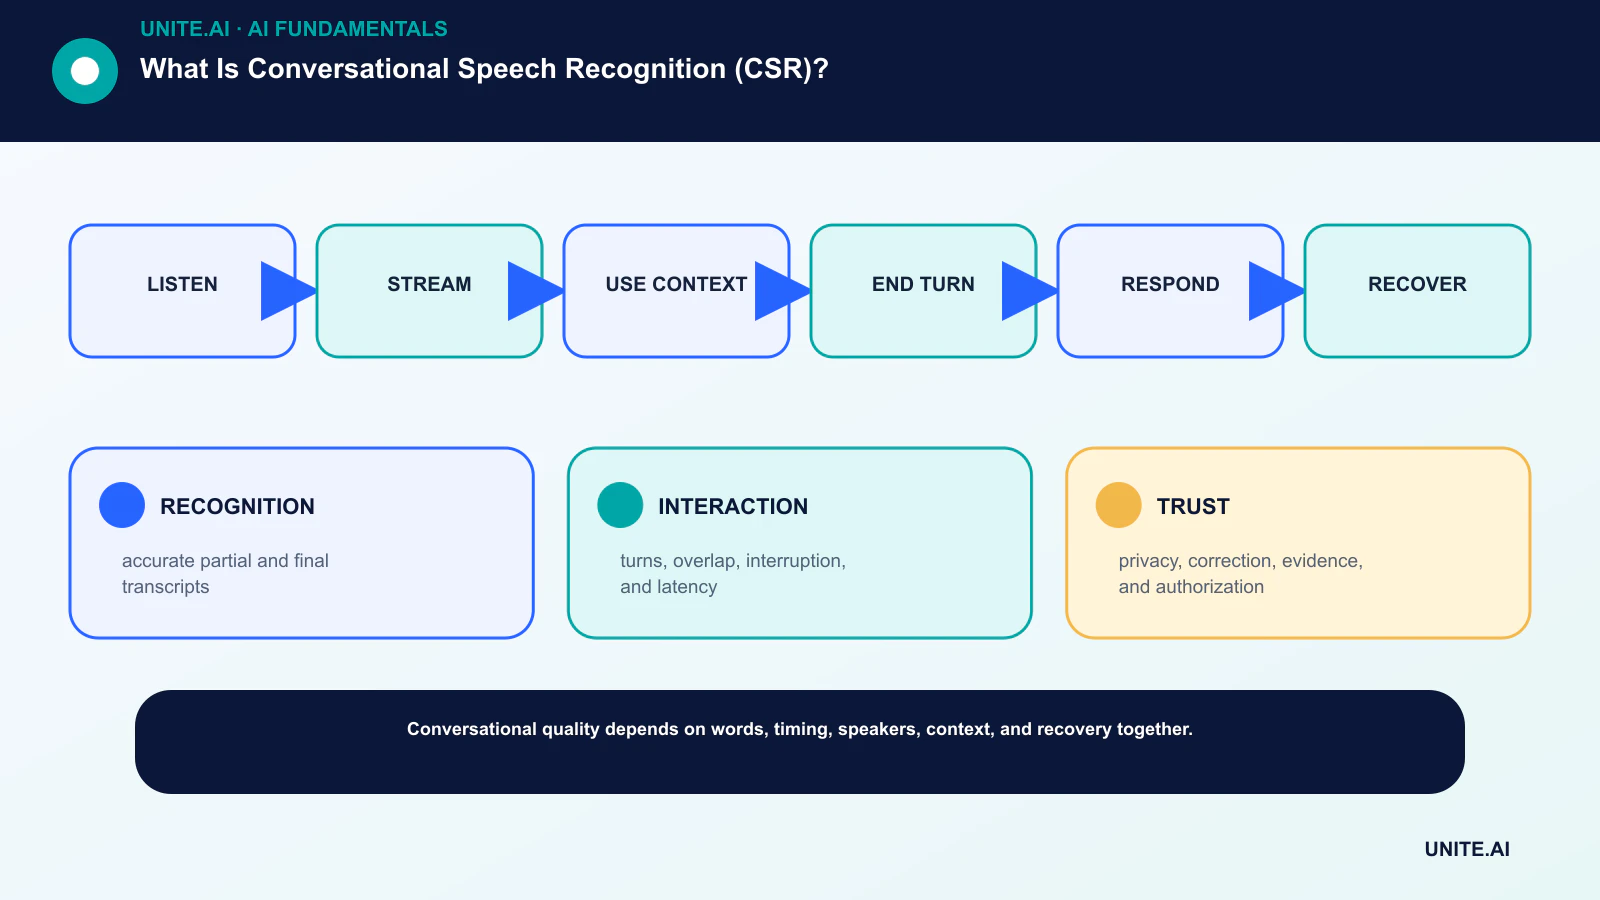
เปลี่ยนแนวคิดให้เป็นกระบวนการทำงานที่มีขอบเขตและทดสอบได้: ฟัง → สตรีม → ใช้บริบท → สิ้นสุด turn → ตอบ → กู้คืน ตั้งเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้าง baseline ง่าย, กำหนดเกณฑ์การยอมรับและการหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการเฝ้าติดตาม, rollback, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนเปิดตัว, ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปลอดภัย, และผู้ที่ได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้งานผิดพลาด; เก็บหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข กำหนดว่าใครสามารถอนุมัติการปล่อย, เปลี่ยนค่า threshold, แก้ไขผลลัพธ์, หรือหยุดการทำงาน ทบทวนการตัดสินใจหลังจากข้อมูลจริงเข้ามา เพราะการทดลองพายลตเทคนิคเท่านั้นอาจไม่รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- การรู้จำ: การถอดข้อความบางส่วนและเต็มที่แม่นยำ
- การโต้ตอบ: การผลัดกันพูด การพูดทับซ้อน, การขัดจังหวะ, และความหน่วง
- ความไว้วางใจ: ความเป็นส่วนตัว, การแก้ไข, หลักฐาน, และการอนุญาต
คำถามที่พบบ่อย
CSR แตกต่างจาก ASR หรือไม่?
ASR คือส่วนประกอบการแปลงเสียงเป็นข้อความ CSR ใช้ ASR พร้อมบริบทการสนทนา, เวลา, ผู้พูดและการจัดการจุดสิ้นสุด, และนโยบายการโต้ตอบสำหรับการสนทนาสด
อัตราความผิดพลาดของคำที่ต่ำกว่าจะรับประกันตัวแทนเสียงที่ดีกว่าไหม?
ไม่ ระบบอาจถอดข้อความได้แม่นยำแต่ขัดจังหวะผู้ใช้, ตอบช้า, อ้างอิงผู้พูดผิด, หรือทำการกระทำที่ไม่ถูกต้อง ต้องใช้เมตริกการโต้ตอบแบบต้นจนจบ
อ้างอิงหลัก












