
พื้นฐาน AI
ทฤษฎีเบย์สคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
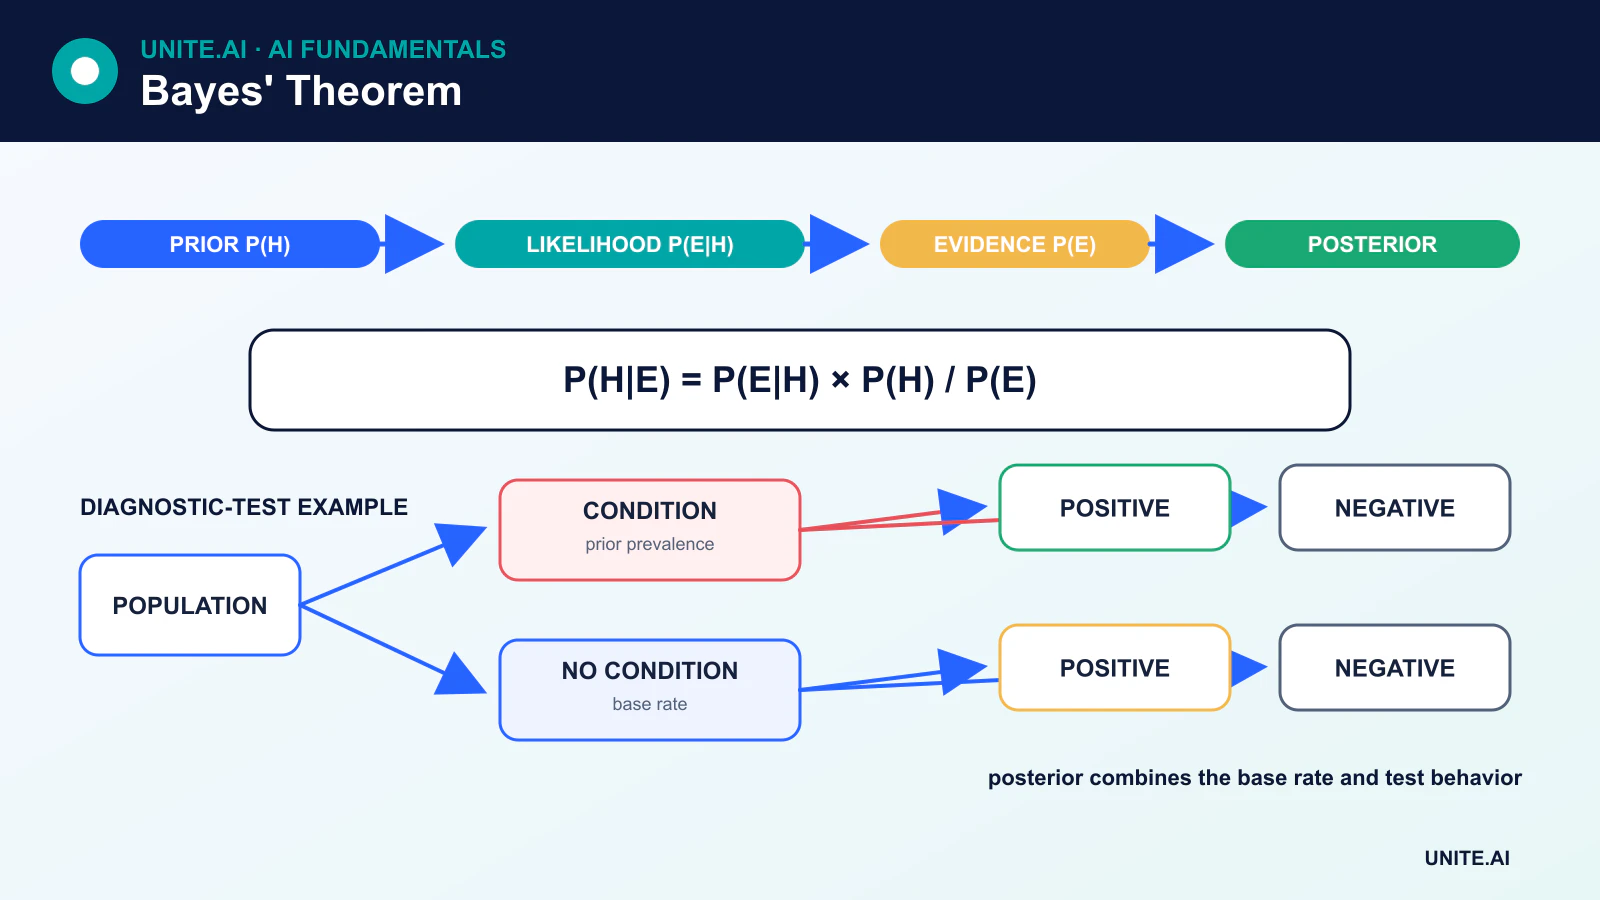
ทฤษฎีเบย์ส อธิบายวิธีการปรับปรุงความน่าจะเป็นของสมมติฐานหลังจากสังเกตหลักฐาน มันเชื่อมความน่าจะเป็นของหลักฐานที่ให้โดยสมมติฐานกับความน่าจะเป็นของสมมติฐานที่ให้โดยหลักฐานนั้น
ความแตกต่างนี้เป็นแกนสำคัญของการให้เหตุผลทางสถิติและ การเรียนรู้ของเครื่อง การทดสอบอาจมีความแม่นยำสูงเมื่อมีภาวะอยู่ แต่ผลลัพธ์บวกยังคงมีความน่าจะเป็นที่ค่อนข้างต่ำในการบ่งชี้ภาวะนั้น หากภาวะนั้นหายาก
ประเด็นสำคัญ
- ผลลัพธ์หลัง (posterior) รวมความเชื่อก่อนหน้า (prior) กับความน่าจะเป็นของหลักฐานที่สังเกตได้
- พจน์หลักฐานทำให้สมมติฐานที่เป็นไปได้ทั้งหมดเป็นมาตรฐาน
- อัตราพื้นฐาน (base rate) สามารถครอบงำหลักฐานที่ดูเหมือนแข็งแรง
- Naive Bayes สมมติว่าลักษณะ (features) มีความเป็นอิสระเชิงเงื่อนไขเมื่อกำหนดคลาส ไม่ได้หมายความว่าเป็นอิสระในทุกสถานการณ์
สูตร
P(A|B) = P(B|A)P(A) / P(B)
- P(A) คือความน่าจะเป็นก่อนหน้า (prior) ของสมมติฐาน A.
- P(B|A) คือความเป็นไปได้ของการสังเกตหลักฐาน B หาก A เป็นจริง.
- P(B) คือความน่าจะเป็นโดยรวมของหลักฐาน.
- P(A|B) คือความน่าจะเป็นหลัง (posterior) ของ A หลังจากสังเกต B.
ทฤษฎีนี้ได้มาจากสองสมการที่เท่ากันสำหรับความน่าจะเป็นร่วม: P(A ∩ B) = P(B|A)P(A) และ P(A ∩ B) = P(A|B)P(B).
ตัวอย่างอัตราพื้นฐานเชิงตัวเลข
สมมติว่าภาวะหนึ่งส่งผลต่อ 1% ของประชากร การทดสอบมีความไว 90% และอัตราผลบวกเท็จ 5% พิจารณาผู้ 1,000 คน:
- ประมาณ 10 คนมีภาวะนั้น; การทดสอบแสดงผลบวกอย่างถูกต้อง 9 ราย
- ประมาณ 990 คนไม่มี; อัตราผลบวกเท็จ 5% ทำให้ประมาณ 50 รายแสดงผลบวกเท็จ
- ดังนั้นจึงมีผลบวกประมาณ 59 ราย ซึ่ง 9 รายเป็นผลบวกจริง
ความน่าจะเป็นของภาวะหลังจากผลบวกอยู่ที่ประมาณ 9 / 59 ≈ 15% ไม่ใช่ 90% ความไวของการทดสอบให้คำตอบ P(positive | condition); ผู้ใช้มักต้องการ P(condition | positive). ทฤษฎีเบย์สเชื่อมโยงทั้งสองโดยใช้ค่าอัตราพื้นฐาน
การอัปเดตแบบเบย์เซียน
เมื่อหลักฐานใหม่เข้ามา ผลลัพธ์หลัง (posterior) สามารถกลายเป็นความเชื่อก่อนหน้า (prior) สำหรับการอัปเดตครั้งต่อไป โมเดลเบย์เซียนที่ครบถ้วนระบุสมมติฐานที่เป็นไปได้, การกระจาย prior, ความเป็นไปได้ (likelihood) และปริมาณที่ต้องสรุป ความไม่แน่นอนถูกแสดงด้วยการกระจาย posterior แทนการประมาณค่าเดียว
ควรบันทึก prior ไว้และทดสอบความไวของมัน Prior ที่ให้ข้อมูลอย่างอ่อนโยนสามารถทำให้ค่าที่ไม่สมเหตุสมผลเป็นปกติได้ ในขณะที่ prior ที่แข็งแรงแต่เลือกไม่ดีอาจครอบงำข้อมูลที่มีจำกัด
ตัวจำแนก Naive Bayes
Naive Bayes ทำนายคลาส y จากลักษณะ x₁ … xₙ โดยใช้ทฤษฎีเบย์สและสมมติฐาน:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
ลักษณะต่าง ๆ ถูกสมมติให้เป็นอิสระเชิงเงื่อนไขเมื่อคลาสเป็นที่ทราบแล้ว สิ่งนี้มักไม่เป็นความจริง แต่ตัวจำแนกยังสามารถทำงานได้ดีเมื่อคะแนนคลาสที่ได้ยังคงมีประโยชน์
รูปแบบทั่วไป
- Multinomial Naive Bayes จำลองลักษณะแบบนับและเป็นที่นิยมในงานจำแนกเอกสาร
- Bernoulli Naive Bayes จำลองการมีอยู่ของลักษณะแบบทวิ
- Gaussian Naive Bayes จำลองลักษณะต่อเนื่องแต่ละตัวด้วยการกระจายแบบเกาส์เชียนที่ขึ้นกับคลาส
- Categorical Naive Bayes จำลองประเภทแบบไม่ต่อเนื่อง
การทำให้เรียบและความเสถียรเชิงตัวเลข
หากค่าลักษณะไม่เคยปรากฏร่วมกับคลาสในการฝึก การประมาณความน่าจะเป็นที่ไม่มีการทำให้เรียบอาจกลายเป็นศูนย์และทำให้ผลคูณทั้งหมดหายไป การทำให้เรียบแบบบวกหรือแบบลาปลาซช่วยป้องกันเหตุนี้ การทำงานจะคำนวณความน่าจะเป็นในรูปแบบลอการิทึมเพื่อให้การคูณค่าขนาดเล็กหลายค่าเปลี่ยนเป็นการบวกค่าลอการิทึมที่เสถียร
ความน่าจะเป็น, คะแนน, และการปรับเทียบ
ผลลัพธ์ความน่าจะเป็นของ Naive Bayes อาจปรับเทียบได้ไม่ดี เพราะลักษณะที่มีความสัมพันธ์กันถูกนับหลายครั้ง ตัวจำแนกอาจจัดอันดับคลาสได้ดีแต่ประเมินความมั่นใจสูงเกินไป ควรประเมินการปรับเทียบบนข้อมูลที่แยกออกเมื่อความน่าจะเป็นเป็นตัวกำหนดการตัดสินใจ
เบย์สเหนือ Naive Bayes
การสรุปแบบเบย์เซียนสนับสนุนโมเดลเชิงลำดับชั้น, การทดสอบ A/B, การประมาณค่าพารามิเตอร์ทางวิทยาศาสตร์, การพยากรณ์, การตัดสินใจที่รับรู้ความไม่แน่นอน, และโมเดลกราฟิกเชิงความน่าจะเป็น วิธีประมาณเช่น Markov chain Monte Carlo และ variational inference ถูกใช้เมื่อไม่สามารถคำนวณ posterior ในรูปแบบปิดได้
ข้อผิดพลาดในการให้เหตุผลทั่วไป
- สับสนระหว่าง
P(A|B)กับP(B|A). - ละเลยอัตราพื้นฐานที่หายากหรือทั่วไป
- ถือว่า prior เป็นวัตถุประสงค์หรือไม่บันทึกไว้
- สมมติว่าความเป็นไปได้สูง (likelihood) จะทำให้ posterior สูงโดยอัตโนมัติ
- ตีความความสัมพันธ์เชิงพยากรณ์ว่าเป็นสาเหตุ
ความน่าจะเป็นเชิงเงื่อนไข, อัตราต่อรอง, และหลักฐาน
ทฤษฎีเบย์สเชื่อมความน่าจะเป็นของสมมติฐานหลังจากมีหลักฐานกับความน่าจะเป็นก่อนหน้า, ความเป็นไปได้ของการสังเกตหลักฐานภายใต้สมมติฐาน, และความน่าจะเป็นรวมของหลักฐาน ในรูปแบบอัตราต่อรอง, อัตราต่อรองหลัง (posterior odds) เท่ากับอัตราต่อรองก่อนหน้า (prior odds) คูณด้วยอัตราส่วนความเป็นไปได้ (likelihood ratio) สิ่งนี้แยกความเชื่อก่อนการทดสอบออกจากความแข็งแรงของการทดสอบในการแยกสมมติฐาน การทดสอบที่ดูเหมือนแม่นยำสูงยังอาจให้ผลบวกเท็จจำนวนมากเมื่อภาวะหายาก เพราะอัตราพื้นฐานเข้ามาใน posterior
ความเป็นไปได้ (likelihood) เป็นฟังก์ชันของสมมติฐานเมื่อข้อมูลที่สังเกตคงที่และไม่ควรสับสนกับความน่าจะเป็นของสมมติฐาน การทำให้เป็นมาตรฐานของหลักฐานทำการบวกหรือบูรณาการข้ามสมมติฐานที่แข่งขันกัน การสมมติความอิสระเชิงเงื่อนไขสามารถทำให้การคำนวณง่ายขึ้น เช่นใน Naive Bayes แต่ต้องตรวจสอบผลตามมาของการสมมตินี้ ส่วนหลักฐานหลายชิ้นไม่สามารถคูณเป็นอิสระได้เมื่อมีสาเหตุร่วมหรือข้อมูลซ้ำซ้อน ทิศทางสาเหตุก็สำคัญ: P(evidence|hypothesis) ไม่ได้เท่ากับ P(hypothesis|evidence) เสมอ ซึ่งเป็นข้อผิดพลาดแบบย้อนกลับของความน่าจะเป็นแบบดั้งเดิม
การเลือกโมเดล, การคำนวณ, และการใช้ในการตัดสินใจ
การวิเคราะห์เบย์เซียนระบุ prior, likelihood, และการกระจายพยากรณ์ posterior. Prior สามารถบรรจุความรู้ที่มีอยู่, ทำให้ตัวอย่างขนาดเล็กเป็นปกติ, หรือให้ข้อมูลอย่างอ่อนโยน; ควรอธิบายเหตุผลและทดสอบผ่านการวิเคราะห์ความไว โมเดลเชิงสหสัมพันธ์ให้การอัปเดตเชิงวิเคราะห์, ในขณะที่ Markov chain Monte Carlo, variational inference, และวิธีเชิงลำดับทำให้ประมาณ posterior ที่ซับซ้อน ตรวจสอบการรวมตัว, ขนาดตัวอย่างที่มีประสิทธิภาพ, ความคลาดเคลื่อนของการประมาณ, และความสมเหตุสมผลของการพยากรณ์ prior แทนการรายงานค่าหนึ่งของ posterior โดยไม่มีการตรวจสอบคำนวณ
ความน่าจะเป็น posterior ให้ข้อมูลแต่ไม่สามารถกำหนดการกระทำได้โดยตรง การตัดสินใจต้องพิจารณาความสูญเสีย, ประโยชน์, ข้อจำกัด, และทางเลือกที่มีอยู่ ประเมินโมเดลเชิงความน่าจะเป็นด้วยการปรับเทียบ, กฎการให้คะแนนที่เหมาะสม, และการตรวจสอบพยากรณ์ posterior กับข้อมูลใหม่ อัปเดตเฉพาะเมื่อมีหลักฐานที่เก็บภายใต้กระบวนการที่โมเดลกำหนด; การเลือกตัวอย่างที่มีอคติและการเปลี่ยนแปลงชุดข้อมูลอาจทำให้ likelihood ไม่เป็นจริง สื่อสารช่วงเชื่อมั่นและสมมติฐานโดยไม่ถือว่าเป็นช่วงความถี่ที่รับประกัน ทฤษฎีเบย์สเป็นพีชคณิตความน่าจะเป็นที่แม่นยำ, แต่คุณภาพของข้อสรุปเบย์เซียนขึ้นอยู่กับโมเดลและหลักฐานที่ให้
ตัวอย่างทำงาน: การตีความการทดสอบวินิจฉัย
การทดสอบมีความไว 95% และความจำเพาะ 90% แต่ภาวะส่งผลต่อเพียง 1% ของประชากรที่คัดกรอง สำหรับ 10,000 คน คาดว่าจะมีผลบวกจริงประมาณ 95 รายและผลบวกเท็จประมาณ 990 ราย ทำให้ค่า Positive Predictive Value ต่ำกว่า 9% ทฤษฎีเบย์สทำให้ผลของอัตราพื้นฐานเป็นที่ชัดเจน การคำนวณระบุประชากร, เกณฑ์การทดสอบ, และความไม่แน่นอนแทนการโฆษณาความไวเป็นโอกาสที่ผลบวกจะถูกต้อง ความแตกต่างนี้ยังเป็นพื้นฐานสำคัญของ วิทยาศาสตร์ข้อมูล
แพทย์จะอัปเดตความน่าจะเป็นด้วยหลักฐานเพิ่มเติมเฉพาะเมื่อมีการโมเดลความขึ้นต่อกันของการทดสอบ เกณฑ์การตัดสินใจรวมความเสียหายจากการพลาดโรค, ความเสี่ยงของการทดสอบยืนยัน, ค่าใช้จ่าย, และความต้องการของผู้ป่วย การปรับเทียบจะตรวจสอบในประชากรท้องถิ่น, และการเปลี่ยนแปลงของอัตราการแพร่หลายจะกระตุ้นการทบทวน Posterior สนับสนุนการสนทนาและขั้นตอนต่อไป; ไม่ได้แทนที่การวินิจฉัยยืนยัน การรายงานใช้ความถี่ธรรมชาติและการวิเคราะห์ความไวเพื่อให้ผู้ป่วยและผู้ปฏิบัติงานเห็นว่าข้อสรุปเปลี่ยนแปลงอย่างไรภายใต้สมมติฐานที่สมเหตุสมผล
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือขาดหาย, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนเปิดใช้งาน, มอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการถอดถอน ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการฉีดความล้มเหลวโดยเจตนา ระบบเทเลเมทรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นทบทวนหลักฐานในโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยน ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
ความแตกต่างระหว่าง likelihood กับ probability คืออะไร?
เมื่อพารามิเตอร์คงที่ โมเดลจะกำหนดความน่าจะเป็นให้กับข้อมูลที่เป็นไปได้ เมื่อข้อมูลที่สังเกตคงที่ นิพจน์เดียวกันสามารถมองเป็นฟังก์ชัน likelihood สำหรับค่าพารามิเตอร์ที่เป็นไปได้ได้ สูตรเชิงตัวเลขอาจเหมือนกันแต่การตีความแตกต่างกัน
Naive Bayes เป็นการสรุปแบบเบย์เซียนเต็มรูปแบบหรือไม่?
มันใช้ทฤษฎีเบย์สสำหรับการจำแนกภายใต้โมเดลความอิสระเชิงเงื่อนไขที่แข็งแรง การสรุปเบย์เซียนที่กว้างขวางกว่านั้นจะวางการกระจายบนปริมาณที่ไม่ทราบและให้เหตุผลด้วยการกระจาย posterior
แหล่งอ้างอิงหลัก












