
AI 基础
什么是深度学习?

 将 Unite.AI 添加到您在 Google 上的首选来源
深度学习是一类使用具有多层处理层的神经网络来学习数据有用表征的机器学习方法。这些模型为语言、图像、音频、推荐、科学预测以及生成式 AI 等众多现代系统提供动力。
词语 deep 指的是输入与输出之间的变换层数,而不是机器拥有更深的理解。深度模型学习对其训练目标有用的数值关系,但其性能仍需在新数据上进行测试。
关键要点
- 深度学习是 机器学习 的一个子集。
- 层使用学习到的参数、非线性激活、归一化以及其他操作来转换张量。
- 反向传播计算梯度;优化器利用这些梯度更新可训练参数,包括权重和偏置。
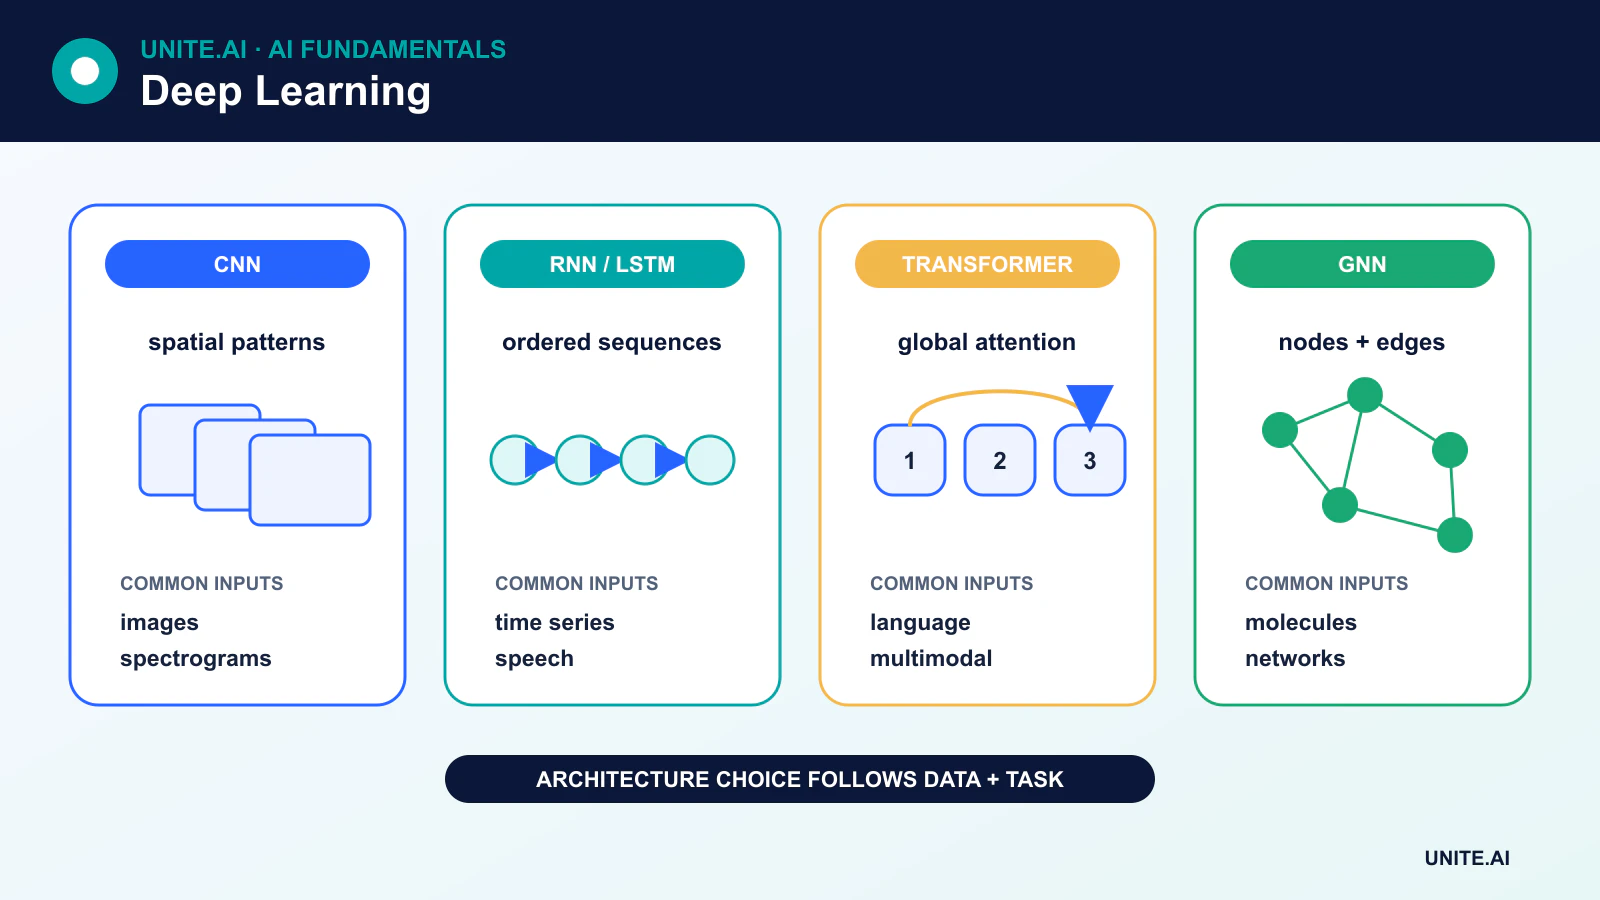
- CNN、循环网络、Transformer、自动编码器和扩散模型具有不同的结构和优势。
深度神经网络的学习方式
神经网络以 张量(即多维数值数组)的形式接收数据。图像张量可能编码像素通道,而语言模型使用表示词元的向量。每一层执行可微分的变换并将结果传递给下一层。
在基本的全连接层中,模型计算输入的加权和,加入可训练的偏置,然后应用激活函数:
output = activation(Wx + b)
激活函数引入非线性。若没有它,堆叠普通的线性层仍只能表示线性变换。ReLU 及其变体在隐藏层中常见,而输出激活函数则取决于具体任务。
训练通常包括四个步骤:
- 一次 前向传播 生成预测。
- 一个 损失函数 衡量预测与目标之间的差异。
- 反向传播 使用链式法则计算损失相对于每个可训练参数的梯度。
- 诸如随机梯度下降或 AdamW 等优化器更新参数。
在多个批次上重复这些步骤可以提升模型,但较低的训练损失并不保证在真实环境中的可靠表现。验证、正则化、具代表性的数据以及监控仍然是必不可少的。
主要深度学习架构
多层感知机
多层感知机(MLP)使用全连接层,其中每个输出单元依赖于前一层的所有输入。MLP 对表格特征以及大型系统内部的组件很有用,但它们并未内置图像局部性或序列顺序的假设。
卷积神经网络
卷积神经网络(CNN) 在局部区域应用学习到的滤波器。权重共享使其在图像、声谱图等网格数据上高效。CNN 在视觉以及边缘部署中仍然重要,尽管视觉 Transformer 与混合模型也被广泛使用。
循环网络、LSTM 与 GRU
循环神经网络(RNN) 在处理序列时更新隐藏状态。LSTM 与门控循环单元(GRU)有助于保留信息并减轻导致基本 RNN 在长依赖上表现不佳的梯度消失问题。它们并未消除所有长上下文的限制,但在流式信号、时间序列数据以及紧凑的序列模型中仍然有用。
Transformer
Transformer 使用注意力机制来建模序列或集合中元素之间的关系。其并行处理众多位置的能力使其在大多数大规模语言系统中取代了循环结构,且 Transformer 的变体如今已用于图像、音频、视频、蛋白质以及多模态数据的处理。
自编码器与生成模型
自编码器 将输入压缩为表征,并从该表征重建输入。这形成了自监督的重建目标;它并不会自动将未标记数据转化为有标签的示例。
生成对抗网络(GAN) 通过竞争训练生成器和判别器。扩散模型 学会逆转逐步加噪的过程。自回归 Transformer 一次生成一个词元或单元。这些方法在训练动态、可控性和计算需求上各不相同。
深度为何有帮助——以及架构为何重要
多层让模型将简单的变换组合成更复杂的变换。在视觉领域,某些学习到的特征可能从局部纹理逐步发展为任务特定的模式。在语言领域,注意力层构建上下文相关的词元表征。这些描述是有用的直觉,而非每一层必须学习的固定规则。
现代网络还依赖残差连接、归一化、精心初始化、正则化以及优化的硬件。仅仅增加层数或参数可能使模型更难训练、速度更慢,或更容易出现 过拟合。模型规模只有在数据、目标、优化和部署环境支持的情况下才有帮助。
训练与推理
训练 调整参数,通常是计算密集的阶段。推理 运行已训练好的模型以产生输出。对于大型模型,推理仍可能成本高昂,这也是团队使用量化、蒸馏、批处理、缓存、稀疏化以及诸如 神经处理单元 等专用硬件的原因。
限制与负责任的使用
深度模型可能继承偏见、记忆敏感信息,在分布转移下表现失效,并产生看似可信却错误的输出。它们也可能难以解释且训练成本高昂。评估应超越基准平均值:团队需要关注类别或子群体层面的性能、鲁棒性、校准、安全性、延迟、能耗以及失败的后果。
表征、优化与架构选择
深度网络通过参数化层学习连续的表征。线性变换混合输入;非线性激活使网络能够近似复杂函数;归一化和残差连接帮助优化;注意力、卷积、循环或状态空间操作则编码不同的结构假设。深度增加了变换的次数,但并不保证智能。架构应体现任务的模态、数据量、延迟、内存以及不变性。当数据有限且局部空间结构占主导时,较小的卷积模型可能优于 Transformer。
训练计算损失,并通过反向传播对其求导,然后使用诸如随机梯度下降或 Adam 等优化器更新参数。批量大小、学习率、调度、初始化、正则化和数值精度相互影响。训练和验证损失曲线有助于区分欠拟合、过拟合、不稳定和泄漏,但它们并不能确定真实世界的有效性。应使用独立的评估数据、在方差重要时进行多次运行、消融实验以及与更简洁基线的比较。大量参数也会提升对数据治理、计算规划和可复现配置的需求。
安全高效地部署深度模型
部署可以使用托管端点、专用加速器、浏览器、手机或嵌入式设备。导出和编译可能会融合算子、量化权重和激活,或改变数值行为,因此需要验证部署产物而非仅验证训练检查点。应在真实的批量和序列规模下测量冷启动时间、稳定延迟、吞吐量、内存、功耗和质量。压缩方法——剪枝、蒸馏、量化和低秩适配——在尺寸或速度与准确性及工程复杂度之间进行权衡,必须在敏感类别和极端情况上进行评估。
深度模型在分布转移、对抗输入、虚假相关以及代表性不足的群体下可能自信地失效。需监控输入输出分布、任务结果、校准、资源使用以及依赖版本。使用访问控制、签名产物、受保护的训练数据、红队演练以及符合威胁模型的速率限制。诸如显著性图或注意力视图等解释是诊断性证据,并非因果证明。应将其与行为测试、反事实分析、人类审查、事件响应以及对自动决策的明确限制相结合。
实例演示:训练图像缺陷检测器
工厂收集来自不同相机、班次、材料以及已知缺陷类别的产品图像,然后按生产批次划分,以防止近似重复的项目跨分区。将一个小型卷积基线模型与预训练的深度网络进行比较。数据增强在不抹除缺陷的前提下再现已验证的光照和视角变化。评估报告包括每种缺陷的召回率、误拒率、校准、推理延迟以及对模糊、眩光、相机更换和稀有材料颜色的鲁棒性。
导出的模型以及精确的尺寸调整、颜色和归一化代码在生产线硬件上进行测试,以验证持续吞吐量和热行为。低置信度的情况交由检查员处理;独立规则在出现安全关键的传感器故障时停止生产线。图像仅在许可范围内保留,模型产物签名。监控将预测结果与后续检查结果及生产批次关联。新相机或新材料会触发受控的重新评估,而不是对未审查标签进行静默在线学习。
实施证据与运营准备
生产决策需要的不仅是成功的演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每种重要故障的后果。在调优前建立可复现的基线和带版本的评估集。测试普通案例、边界条件、畸形或缺失的输入、分布转移、依赖中断、误用以及最可能被忽视的群体或环境。测量任务质量以及校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录每一次转换和阈值,以便独立审阅者能够复现结果并将证据与诱人的原型区分开来。
上线前,需指定发布、例外、变更、回滚和退役的责任人。采用分阶段发布,保留安全回退,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,而不收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时都需重新评估。维护中的系统还需要有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
主要参考文献












