
AI 基础
什么是 NPU?神经处理单元详解

 将 Unite.AI 添加到您在 Google 上的首选来源
神经处理单元(NPU)是一种专用加速器,旨在高效执行常见的神经网络操作。在手机、个人电脑、车辆、摄像头和嵌入式系统中,它能够以更低的能耗运行受支持的 AI 工作负载,或释放 CPU 和 GPU 用于其他任务。
NPU 是一个宽泛的行业术语,而非单一的通用架构。其性能取决于支持的算子、数值格式、内存、编译器与运行时、热限制以及应用程序能够在加速器上保留的程度。
关键要点
- NPU 强调矩阵、向量和张量运算,具有高数据复用率和低功耗。
- 峰值 TOPS 并非端到端应用基准,且可能基于特定的精度或稀疏性假设。
- 模型可能需要进行转换、量化、图划分以及对不支持的算子进行回退。
- 在实际工作负载上比较延迟、吞吐量、能耗、内存、质量、隐私和可移植性。
CPU、GPU 与 NPU 的角色
CPU 擅长通用控制流和广泛兼容性。GPU 提供可编程的并行吞吐量和庞大的软件生态系统。NPU 专注于重复的张量运算,可能配备本地内存、乘加阵列以及针对推理优化的数据流。
异构系统会将不同的任务调度到最合适的部件上。这在 边缘 AI 中尤为重要,因为持续功耗和响应速度往往比数据中心的峰值吞吐更为关键。
模型编译与执行
框架图会被转换为中间表示,进行优化、在适当情况下量化,并针对受支持的算子进行编译。运行时可能会对图进行划分,使不受支持的层在 CPU 或 GPU 上执行。
处理器之间的传输会抵消加速器的收益。静态形状、布局、精度、批处理和内存复用都会影响性能。必须对编译后的产物进行测试,因为 深度学习 模型的质量在转换后可能会发生变化。
理解 TOPS 与效率声明
TOPS 在特定假设下报告每秒数万亿次运算。厂商可能会将乘法和加法分别计数,使用低位整数精度,或假设稀疏性。更高的数值并不保证特定模型的延迟更低。
应测量冷启动和热启动时的每次查询延迟、吞吐量、能耗、峰值内存、热降频、支持的上下文或图像尺寸,以及加速的图占比。使用等效的精度和软件版本进行对比。
设备端 AI 的权衡
本地执行可以降低网络依赖并将原始输入保留在设备上,但下载的模型、日志、备份以及云回退仍会产生数据流。仍需确保模型交付的安全性和平台更新的可靠性。
NPU 能支持视觉、音频、语言和传感器等应用,包括 TinyML 相关工作负载。开发者应设计优雅的回退机制,并在处理脱离设备时进行告知。
NPU 架构与支持的算子
NPU 通过使用乘加单元阵列、本地内存、数据流调度以及专用数值格式来加速张量运算。将权重和激活保持在计算单元附近可减少昂贵的数据搬移。实际设备在算子支持、内存层次结构、精度、稀疏性、可编程性以及与 CPU、GPU 的工作分配方式上各不相同。
峰值性能常以 TOPS 宣传,但 TOPS 并未说明精度、利用率、内存限制、算子覆盖率或端到端延迟。两款处理器即使标称相同,也可能在同一模型上表现不同。应对编译后的模型、实际的批量和序列规模、预处理、数据传输以及功耗模式进行基准测试。
NPU 对支持的神经工作负载(如视觉、语音、去噪、背景效果以及小型语言模型)表现出色。不支持的算子可能回退到 CPU 或 GPU,导致数据传输和不可预测的延迟。应检查编译器报告和运行时跟踪,以确认算子放置,而不是假设整个图都使用加速器。
模型转换、量化与部署
部署通常经历从训练框架到导出、图优化、量化、厂商编译以及运行时集成的过程。静态形状和常用算子最易加速。动态控制流、自定义内核、大型中间张量以及不支持的归一化或注意力模式可能需要对图进行修改或采用混合执行。
整数及低精度格式可降低模型体积、带宽、能耗和延迟,但校准数据必须能够代表真实输入。在对质量敏感的场景下,需要比较后训练量化与感知量化训练。应评估每类以及最坏情况的表现,因为平均精度可能掩盖稀有或安全关键案例的退化。
设备端推理通过限制数据传输提升了延迟、离线运行和隐私,但设备仍需安全的模型、基于权限的数据访问以及更新机制。应在适当位置保护模型文件、对更新进行签名、披露云回退,并确保遥测不会重新引入本地架构本意要降低的隐私风险。
性能评估与系统层面权衡
测量冷启动和稳态延迟、吞吐量、每次推理的能耗、内存、热行为、精度以及对电池的影响。长时间测试能够发现短基准测试遗漏的降频现象。需将预处理和后处理计入其中,因为图像缩放、分词、解码或数据拷贝可能主导本应快速的加速器工作。
调度是系统层面的问题。CPU 负责应用逻辑,GPU 可能用于渲染或执行不受支持的层,NPU 则运行兼容的计算图。并发的摄像头、音频、显示和 AI 工作负载会争夺内存带宽和功耗。应测试完整的用户场景,而非仅在厂商工具中对单一模型进行评估。
跨编译器和运行时的可移植性仍受限。应在可行的情况下优先使用标准模型表示,将厂商特定代码封装在接口后,保留参考输出,并保持设备测试覆盖率。选型时应基于已验证的工作负载、软件支持、更新周期和整体系统成本,而非单一加速器规格。
案例示例:在 NPU 笔记本上部署视觉模型
一个团队为背景效果训练了分割模型,将其导出为受支持的中间格式,替换不支持的算子,并使用具有代表性的相机、光照、肤色、服装和背景进行整数量化校准。厂商编译器会报告哪些节点在 NPU 上运行,哪些回退。团队将任何回退视为系统成本,因为张量传输可能主导快速的单个算子。
基准测试会在真实视频通话中测量相机预处理、模型执行、合成、内存、冷启动、稳态延迟、帧稳定性、功耗以及热降频。结果与 CPU 和 GPU 路径在相同输出质量下进行对比。应用通过能力检测和经过验证的回退机制,而不是假设加速器存在或在驱动更新后仍支持相同的计算图。
发布测试涵盖设备型号、操作系统和驱动版本、并发工作负载、电池模式以及异常输入。模型包进行签名和版本管理;遥测记录性能和故障,但不收集不必要的视频。产品会说明何时在设备上完成处理,何时使用云功能。NPU 通过在真实约束下提升整体体验而获得价值,而非仅凭孤立的 TOPS 或算子基准。
实用实施清单
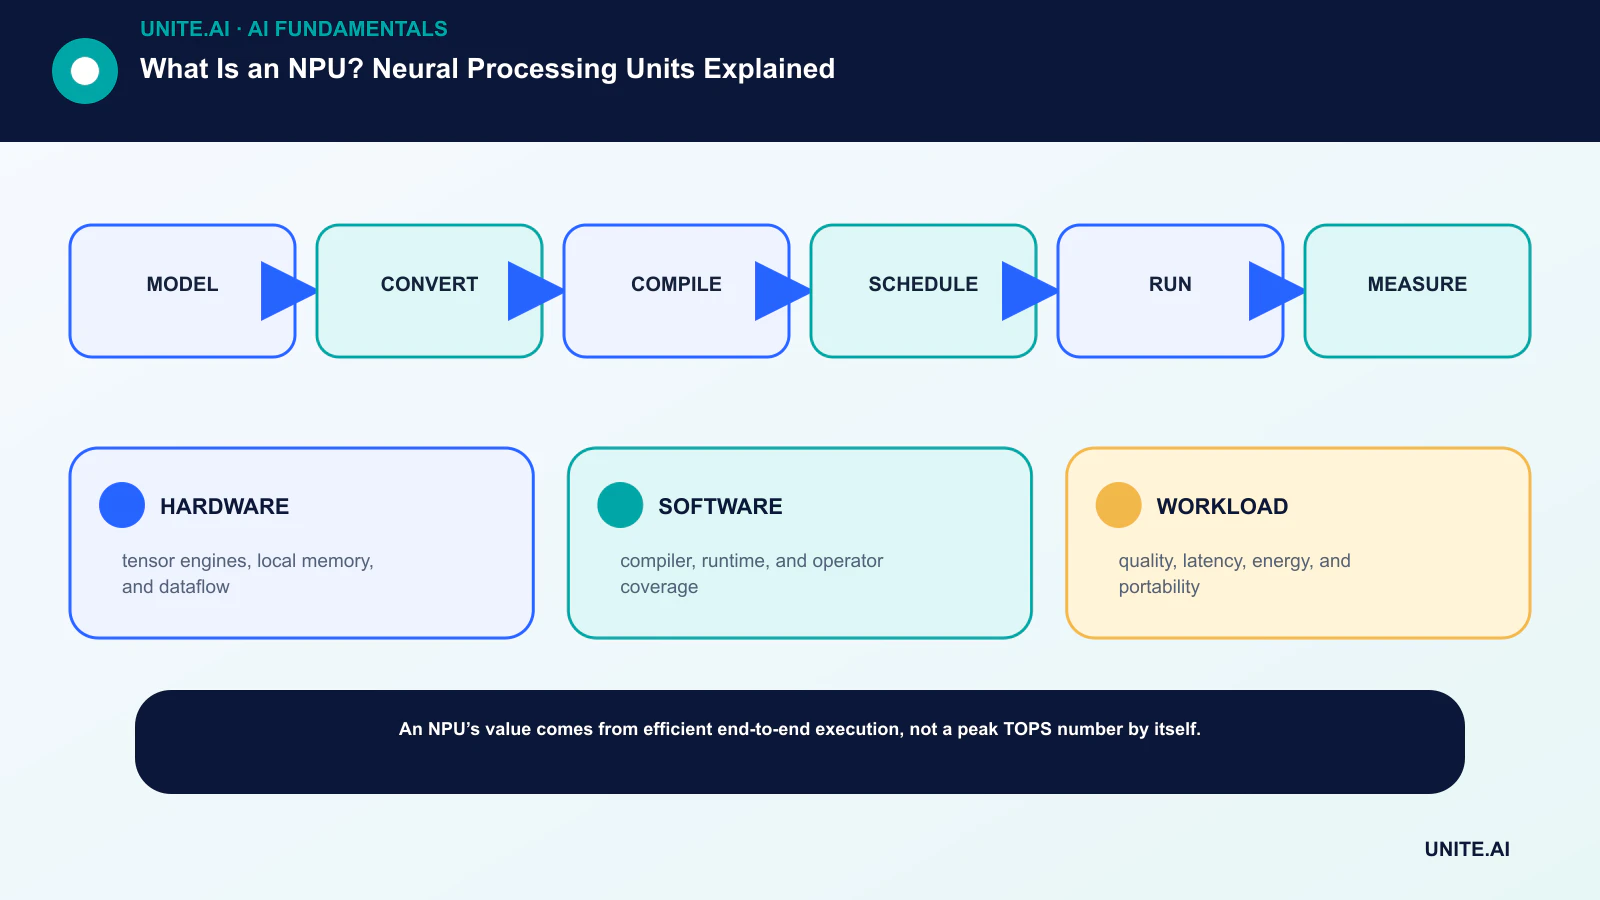
将概念转化为可界定、可测试的工作流: 模型 → 转换 → 编译 → 调度 → 运行 → 测量。指定负责人,记录数据和依赖,建立简易基准,设定验收和停止标准,测试代表性故障,并在扩大范围前定义监控、回滚和审查。记录版本和假设,以便其他团队复现结果并了解变更情况。
上线前,需与构建、运维、保障以及受系统影响的人员进行有文档记录的就绪评审。测试正常情况、边界条件、依赖失效和误用;保留证据和未解决的风险。明确谁有权限批准发布、修改阈值、覆盖输出或停止运行。实际数据到来后重新评估决定,因为技术上成功的试点并不保证在更大规模下的可靠性能。
- HARDWARE: 张量引擎、本地内存和数据流。
- SOFTWARE: 编译器、运行时和算子覆盖。
- WORKLOAD: 质量、延迟、能耗和可移植性。
常见问题
NPU 比 GPU 更快吗?
这取决于模型、精度、算子支持、批量大小、功耗限制以及软件。对于受支持的设备端工作负载,NPU 可能更高效,而在其他情况下 GPU 更快或更灵活。
NPU 能确保所有 AI 数据的隐私吗?
不能。它支持本地处理,但应用仍可能将数据或输出发送至云服务。隐私取决于完整的体系结构和策略。
主要参考文献












