AI 基础
什么是自编码器?

 将 Unite.AI 添加到您在 Google 上的首选来源
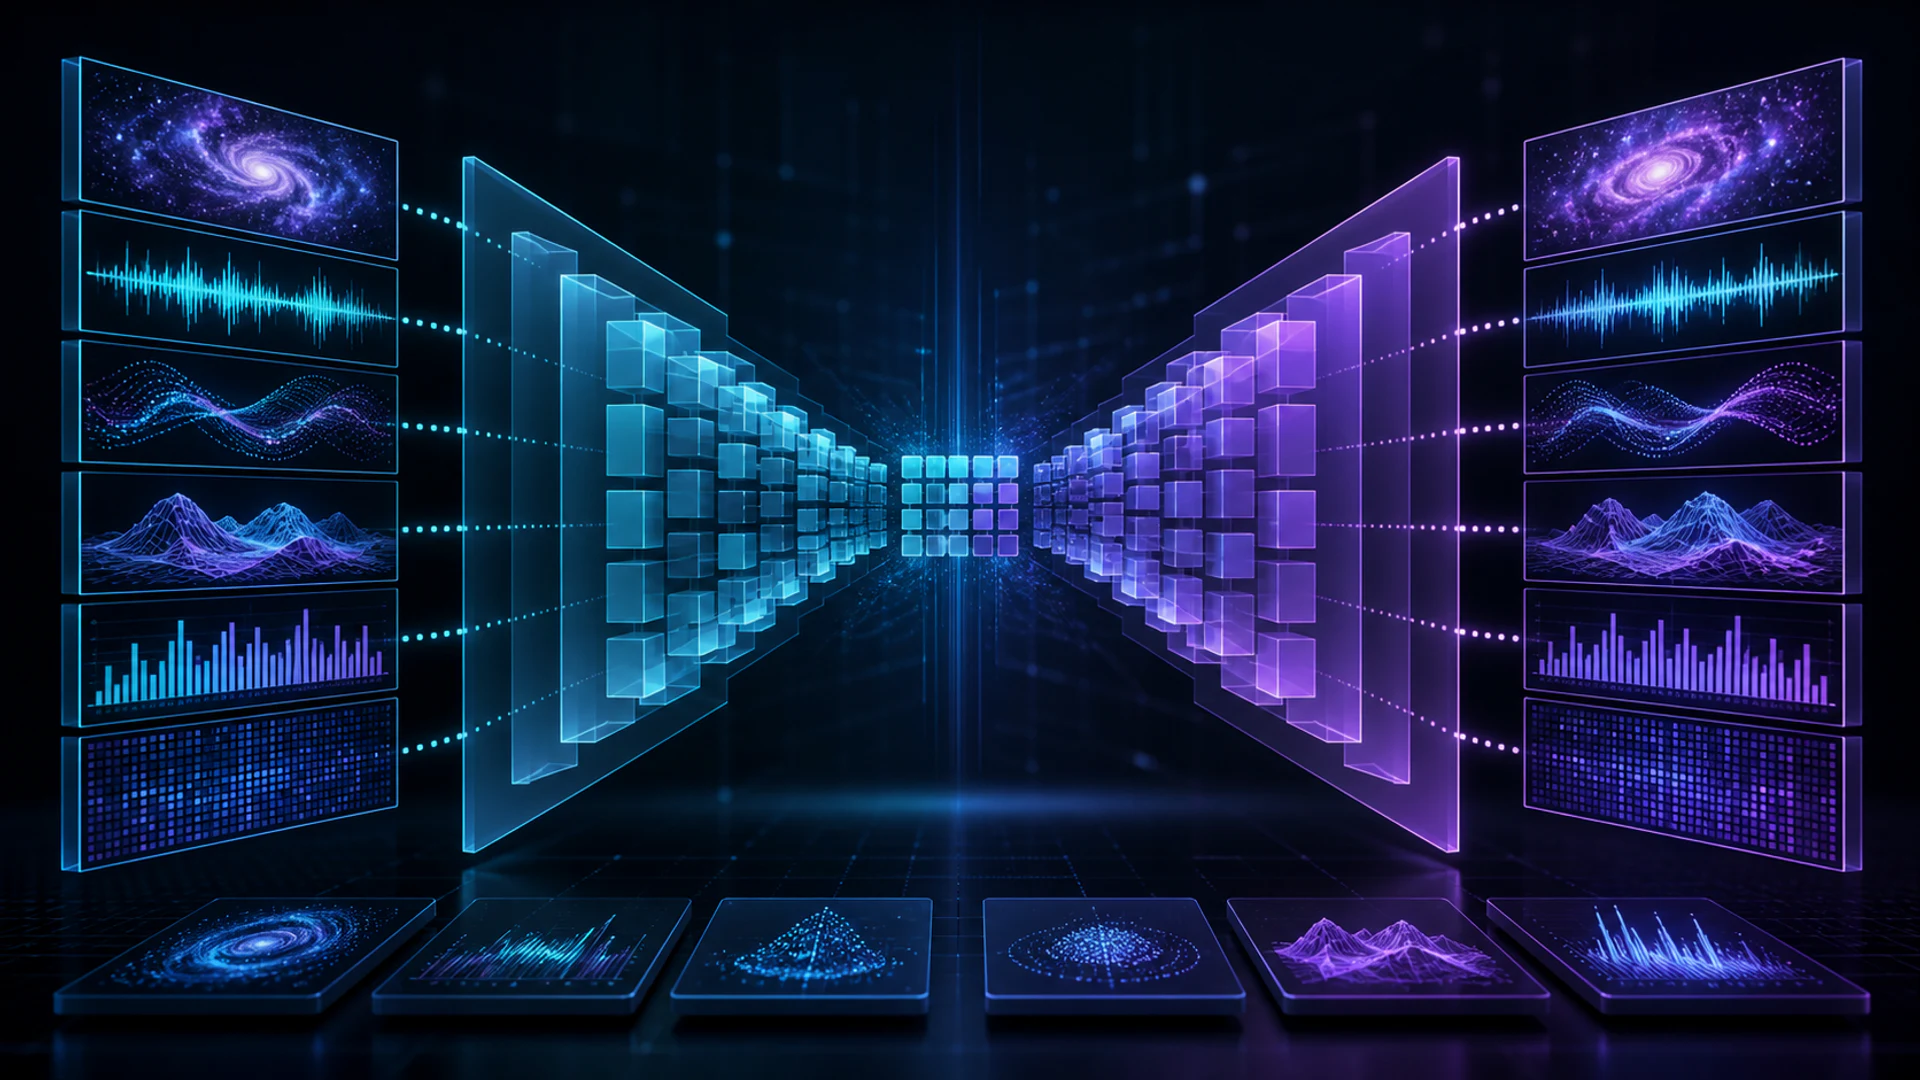
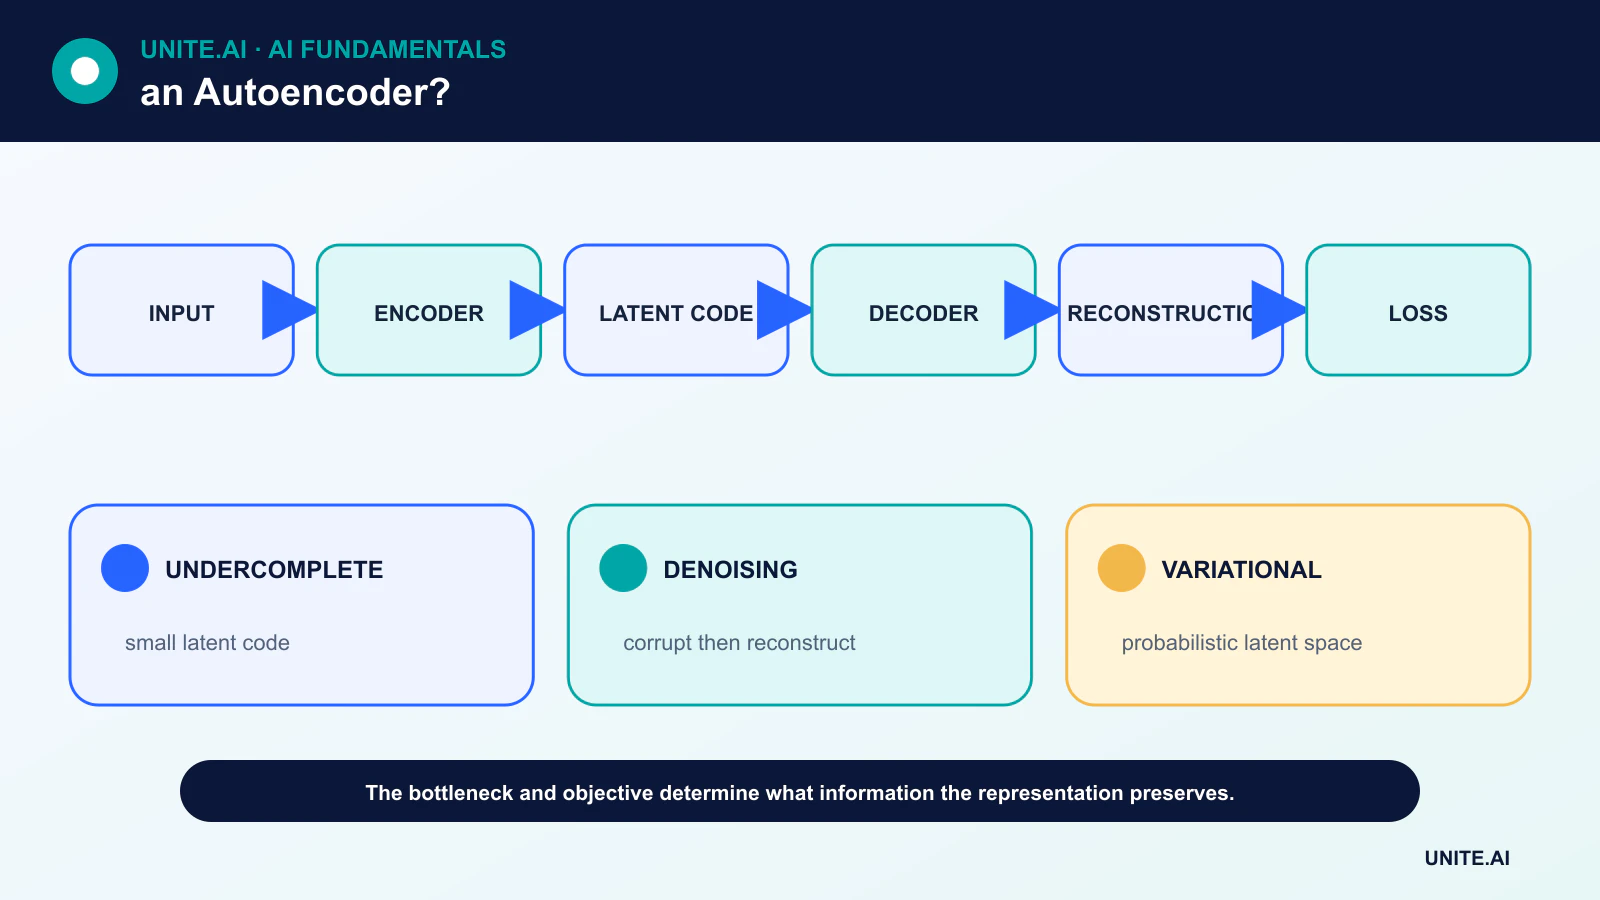
自编码器是一种经过训练以重建其输入的神经网络。autoencoder是一种经过训练以重建其输入的神经网络。编码器将输入映射到潜在表示;解码器将该表示映射回重建。训练通过最小化重建损失来进行,有时会加入额外约束。
完全复制输入并不一定有用。模型的结构或目标必须创建瓶颈、加入噪声、施加稀疏性或以其他方式防止出现平凡的恒等映射,从而使潜在代码捕获有用的结构。
关键要点
- 编码器压缩或转换输入;解码器从潜在代码重建输入。
- 不完全的瓶颈、噪声或正则化鼓励模型学习结构而不是直接复制。
- 重建误差可用于异常检测,但异常并不一定会产生高误差。
- 变分自编码器学习概率潜在模型,与确定性自编码器不同。
编码器、潜在空间与解码器
对于输入 x,编码器生成潜在代码 z = f(x),解码器生成重建 x̂ = g(z)。损失函数比较 x 与 x̂,例如对连续值使用均方误差,或使用适合数据的似然函数。
潜在维度可以小于输入,从而形成不完全自编码器。深层网络还可以学习非线性表示,扩展了降维的概念。
常见自编码器变体
稀疏自编码器对广泛激活进行惩罚。去噪自编码器接受被破坏的输入并重建出干净版本。收缩自编码器惩罚代码对微小输入变化的敏感性。
变分自编码器(VAE)对概率分布的参数进行编码,采样潜在值,并通过正则化项平衡重建,使潜在空间形成特定形状。这支持采样,但会改变目标和解释方式。
训练与避免平凡解
自编码器使用反向传播,与其他神经网络相同。容量过大的网络可能记住训练样本或学习近似恒等函数。瓶颈大小、噪声、惩罚以及对未见数据的验证可对其进行约束。
损失函数的选择很重要。像素级损失可能导致图像重建模糊,而感知损失则继承自另一网络的假设。最佳的重建指标并不一定是语义相似性的最佳度量。
用途与局限
自编码器可以学习特征、去噪信号、压缩数据、初始化模型,并生成用于可视化的潜在变量。用于异常检测时,基于正常数据训练的模型可能对异常输入给出更高的重建误差。
当自编码器同样能够很好地重建异常,或无害的变异比目标异常更难重建时,这种方法可能失效。阈值需要有标签或经过仔细审查的验证数据,并且应按子群体和运行条件监控误差。
自编码器与其他生成模型的比较
确定性自编码器并不自动等同于概率生成模型。VAE 定义结构化的潜在分布;GAN 训练生成器与判别器对抗;扩散模型学习去噪过程。
选择取决于目标是重建、表示、似然、样本保真度、可控性还是异常评分。相比大型图像生成器,较小的任务特定模型往往更实用。
编码器‑解码器目标与潜在表示
自编码器学习一个将输入 x 映射为潜在代码 z 的编码器,以及一个从 z 重建 x 的解码器。如果容量不受限制,它可能学习到几乎没有有用结构的恒等映射。瓶颈、正则化、噪声、稀疏性或结构约束会强制表示保留选定信息。重建损失定义了何为相似:均方误差倾向于平均像素保真度,而感知或特定模态的损失则强调不同特征。低损失并不保证语义意义。
不完全自编码器限制潜在维度。去噪自编码器从受损输入重建干净数据。稀疏变体对激活进行惩罚;收缩变体对敏感性进行惩罚。变分自编码器通过将重建与散度项结合,学习概率潜在分布,支持采样但改变目标。卷积、序列、图和 Transformer 自编码器编码模态结构。应通过下游验证来选择潜在大小和正则化,而非仅凭吸引人的二维图。
异常检测、压缩与评估
在异常检测中,使用具有代表性的正常数据进行训练,并对重建误差或潜在似然进行评分,但异常有时也能很好地重建,而罕见的正常情况可能重建较差。应在有标签或已审查的验证案例上设定阈值,报告事件级召回率和误报率,并测试运行状态的变化。与简单的统计方法和单类基线进行比较。对于压缩,需要统计完整的编解码器——包括模型大小、量化、元数据和解码计算——并在匹配比特率下与已有编解码器比较质量。
可以通过线性探测、聚类稳定性、检索、重建以及下游任务来评估表示质量,每种方法回答不同的问题。学习编码器和设定阈值时要避免信息泄漏。检查损失忽略了哪些特征以及敏感属性是否仍被编码。压缩后的潜在表示并不自动实现匿名化;逆向和属性推断可能恢复私人信息。生成的重建图像虽然看起来合理,却可能改变关键细节。
部署与监控
对编码器和解码器进行同版本管理,导出后验证数值变化,并保留输入的尺度。监控重建分布、潜在漂移、阈值警报以及已确认的结果。在工业监控中,根据运行模式对模型进行条件化,以免将正常转变误判为故障。对于医学或科学重建,绝不可在未经过验证和来源追溯的情况下,将生成的细节呈现为测量证据。 自编码器是灵活的表示学习器,但决定信息保留、丢弃或生成的不是架构名称,而是约束条件和损失函数。
案例实操:用于泵异常的自编码器
不完全自编码器从经过验证的健康泵在不同负载和温度下的振动窗口中学习。它与统计阈值和单类方法进行比较,其重建阈值基于已审查的正常转变和已知故障进行选择。评估采用事件召回率、预警提前时间、每运行小时的误报数以及按泵划分的结果,而非将相邻样本随机划分为训练和测试的窗口。
生产模型根据运行状态进行条件化,并向工程师展示残差模式。高误差会触发检查;它并不会诊断部件或自动停泵。传感器断连、削波和未见负载会产生明确的无效状态。监控跟踪重建分布、警报确认以及传感器健康状况。当维护或硬件更改基线时,旧模型仍可使用,同时在已审查数据上训练候选模型并回放至历史事件。
实施证据与运营准备
生产决策需要的不仅是成功的演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每种重要故障的后果。调优前建立可复现的基线和版本化的评估集。测试常规案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。测量任务质量时同时考虑校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录每一次转换和阈值,以便独立审阅者能够复现结果并区分证据与吸引人的原型。
在上线前,指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过人为注入故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,且不收集不必要的敏感数据。定义警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除和保留流程,以及明确的停用或替换时点。
常见问题
自编码器是无损压缩吗?
通常不是。它们通常学习任务和分布特定的有损表示,并且需要经过训练的解码器来重建数据。
每个瓶颈都可解释吗?
不一定。紧凑的代码在没有每个维度对应可读概念的情况下仍然可以有用。
主要参考文献