
AI 基础
什么是 K 均值聚类?

 将 Unite.AI 添加到您在 Google 上的首选来源
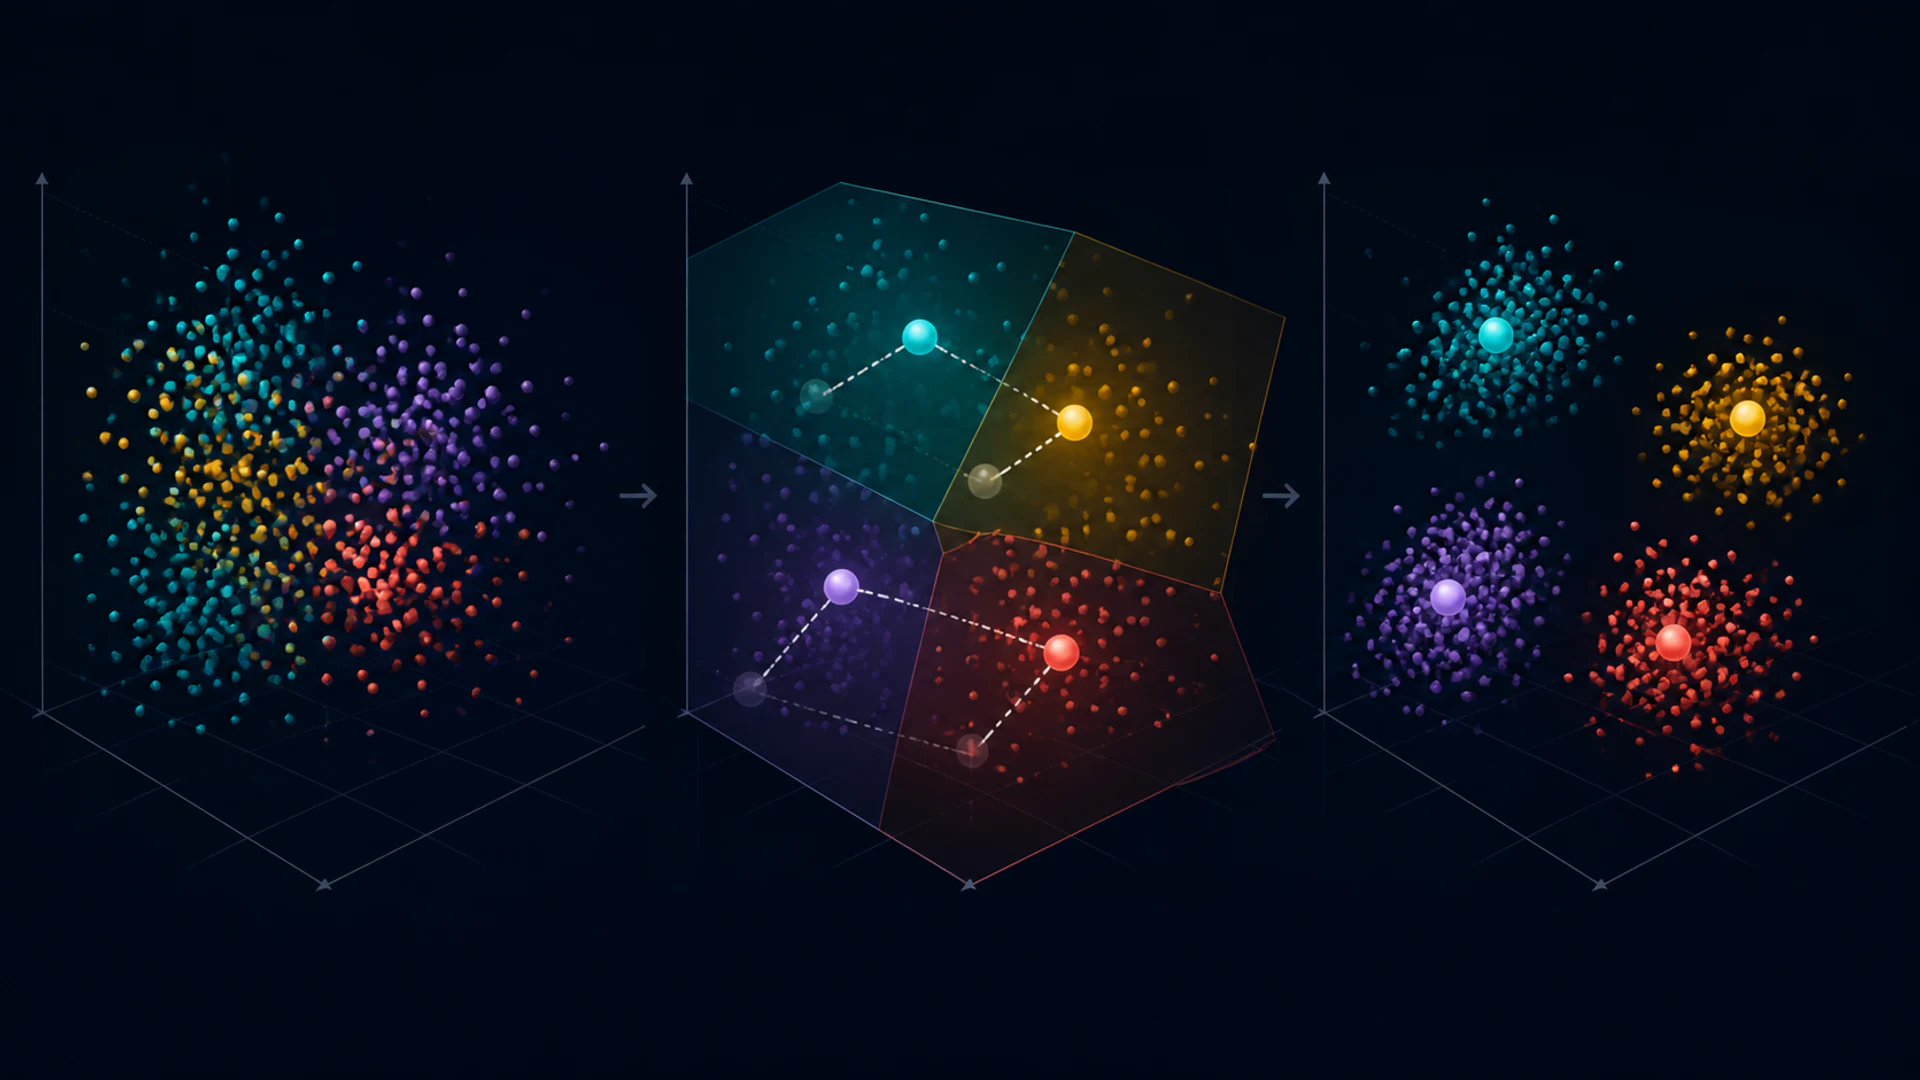
K-means 是一种无监督算法,将数值观测划分为 k 个簇。它在将每个点分配到最近的质心与重新计算每个质心为其所属点的均值之间交替进行。
该算法快速且实用,但其结果受尺度、距离、初始化方式以及所选 k 的影响。簇是数学上的划分,并不必然对应真实世界的类别。
关键要点
- K-means 通过最小化簇内到质心的欧氏距离平方来优化。
- 初始化很重要;k-means++ 能使起始质心更均匀分布,通常能提升结果。
- 当特征的单位或尺度应当同等贡献时,需要对特征进行标准化。
- K-means 在处理离群点、非球形簇、密度不均以及类别型数据时表现不佳。
目标与更新循环
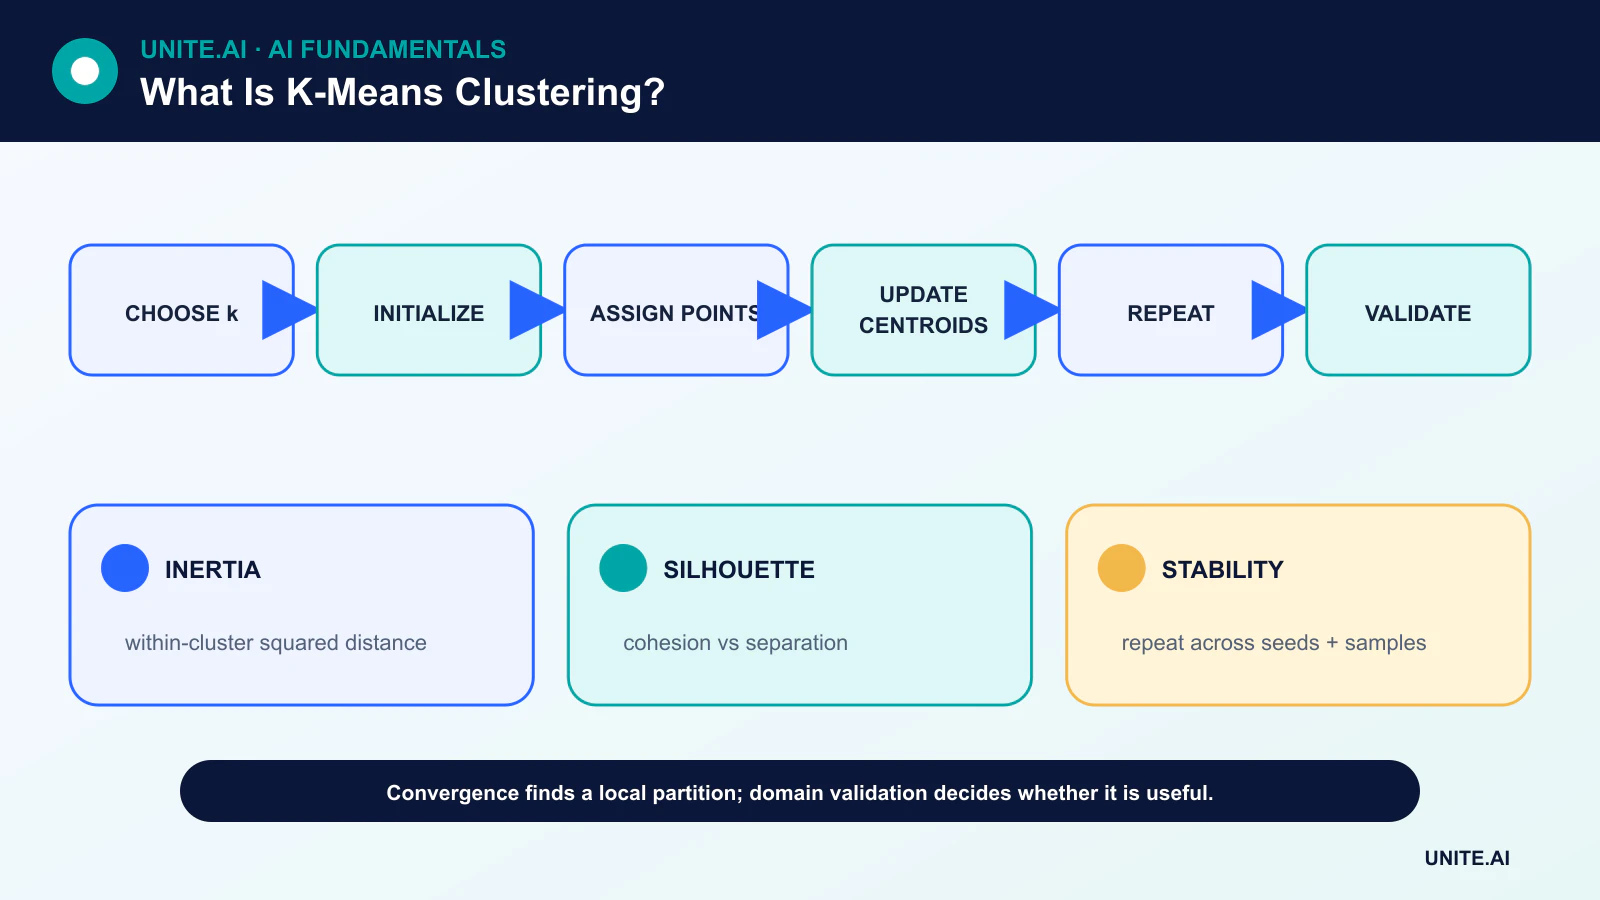
给定 k 个质心后,分配步骤将每个观测点指派给最近的质心。更新步骤则用指派给该质心的观测点的均值替换质心。在这些步骤下,簇内平方和不会增加,因而过程会收敛到局部最优。
收敛并不保证全局最优。不同的初始质心会导致不同的划分,这也是实现中会多次初始化并保留惯性最小解的原因。
初始化与 k-means++
若随机从同一密集区域选择所有起始质心,可能得到糟糕的解或收敛缓慢。k-means++ 根据与已有种子距离的概率选择新种子,从而鼓励覆盖整个数据集。
多次运行仍然有价值。记录随机种子和初始化次数,以便结果可复现。
尺度与距离
欧氏距离的平方使 K-means 对单位极为敏感。千位级的特征会主导介于 0 与 1 之间的特征。标准化是常用做法,但是否采用相同的标准化方差应由领域知识决定。
离群点会把均值拉得远离典型点。稳健的尺度变换、截断或基于中心点(medoid)的方法可能更合适。对类别型特征进行独热编码会产生一种距离几何结构,未必能反映类别相似性。
选择 k 与验证簇
惯性会随 k 增大而下降,因此仅凭惯性无法确定 k。肘部法则寻找改进递减的拐点。轮廓系数比较内部凝聚度与外部分离度。跨样本和随机种子的稳定性提供另一层检验。
最有力的验证是其在目标领域的实用性。将簇与已知结果、专家评审或下游任务进行比较,切勿把事后标记误认为客观发现。
局限性与替代方案
K-means 偏好紧凑、近似球形且尺度相近的群体。高斯混合模型提供概率椭圆成分;DBSCAN 类方法识别密集区域和噪声;层次聚类生成合并树。
降维 能提升速度或去噪,但在完整数据集上进行降维可能改变验证问题。Mini-batch K-means 通过近似更新降低大规模数据的计算量。
目标、初始化与收敛
K-means 通过最小化簇内到质心的欧氏距离平方,将数值观测划分为 k 个簇。Lloyd 算法交替将每点指派给最近的质心并重新计算质心,直至指派或目标函数稳定。它收敛到局部最优,而非必然的全局最佳。k-means++ 初始化能够使初始中心更均匀分布,通常提升结果,但多种随机种子仍然重要。当单位应当同等贡献时,需要对特征进行标准化,因为平方距离会放大高尺度变量和离群点的影响。
该方法假设簇大致紧凑、球形且尺度相似,基于欧氏几何。它在处理细长流形、密度不均、类别型数据、重离群点以及嵌套结构时表现不佳。空簇和重复点需要明确定义处理方式。Mini-batch k-means 通过近似更新实现大规模数据的扩展。对于稀疏文本,基于余弦的球面 k-means 可能更匹配方向;而混合模型、密度方法、层次聚类或 k-medoids 则编码其他假设。
选择 k 与验证含义
肘部曲线、轮廓分数、相关模型的信息准则以及稳定性可以为 k 提供参考,但没有方法能发现唯一正确的数目。业务价值和领域解释才是关键。跨样本和随机种子重新拟合,比较质心移动和指派一致性,并在未用于构建簇的独立结果上进行验证。二维投影可能扭曲分离度,因此应在原始或经验证的表示空间中检查距离和示例。
簇是由所选特征和度量创建的描述性群体,并非自然类别或因果分段。基于相同变量的画像可能形成循环。应使用保留特征和定性评审,并检查簇是否主要复现地理、数据来源或敏感属性。小簇可能是异常或伪影。给簇命名并不意味着每个成员都符合该标签。
部署与维护
将尺度、特征顺序、质心、距离定义和簇标签一起保存。对新点,监控其到指派质心的距离以及超出训练支持范围的比例;提供“未知”状态而非强行归入某簇。随时间跟踪簇大小、质心以及结果相关性。重新训练会改变簇身份,因此应映射或版本化下游规则,而不是静默使用旧名称。K-means 是一种在几何假设匹配问题时有用的压缩与分段基线,而非通用的发现引擎。
实战示例:使用 K-means 进行客户细分
一家订阅型公司对固定窗口内的使用特征进行标准化,去除账户标识,并在不同随机种子上测试不同的 k。通过稳定性、轮廓分数以及保留业务结果进行评审,同时产品团队检查代表性和边界账户。他们发现某簇仅代表新客户且观察期较短,于是将任期作为显式特征处理。K-means 与层次和基于密度的替代方案进行比较,而非默认适用。该练习被视为 无监督学习,而非标签发现。
细分用于指导研究和信息实验,而非决定资格或定价。远离所有质心的新账户会被标记为未知。尺度、特征、质心和名称均进行版本管理,重新训练时仅在有证据的情况下映射到旧簇。监控包括簇大小、距离以及结果相关性。对敏感属性及其代理进行审计,团队避免将簇描述为自然人格类型,因为它们只是基于选定行为的数学划分。
实现证据与运营准备
生产决策需要的不仅是成功演示。必须定义预期用户、运行环境、输入、输出、依赖、负责人以及每种关键失效的后果。建立可复现的基线并在调优前准备版本化的评估集。测试普通案例、边界条件、错误或缺失输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。测量任务质量并结合校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全。记录每一次转换和阈值,以便独立审查员能够复现结果并区分证据与吸引人的原型。
上线前,指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过人为注入的故障验证监控。运营遥测应展示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,同时避免收集不必要的敏感数据。设定警报阈值并指定响应负责人,随后在部署后审查真实世界证据,而非假设离线性能会持续。每当数据源、用户、模型、供应商、政策、硬件或目标变化时都需重新评估。维护的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
K-means 是监督学习还是无监督学习?
它是无监督的,因为只接收特征和选定的簇数,而不需要目标标签。
K-means 能对新数据进行分类吗?
模型拟合后,可以将新点指派给最近的质心。这是簇指派,而不一定等同于监督式的类别预测。
主要参考文献












