
AI 基础
什么是降维?

 将 Unite.AI 添加到您在 Google 上的首选来源
降维 用更少的变量表示数据,同时保留对任务有用的信息。它可以降低存储需求和噪声,提升可视化效果,减轻冗余特征,并使下游模型更易训练。
没有任何方法能保留所有关系。有效的降维需要先明确哪些信息应被保留: 方差、类别分离、局部邻域、全局几何、重构质量或可解释性。
关键要点
- 特征选择保留原始变量;特征提取生成新的低维坐标。
- PCA 是线性且以方差为导向;t‑SNE 和 UMAP 强调用于可视化的邻域结构。
- 可视化嵌入可能会扭曲距离、簇大小和全局分离度。
- 仅在训练数据上拟合降维,然后将学习到的变换应用于验证和测试数据。
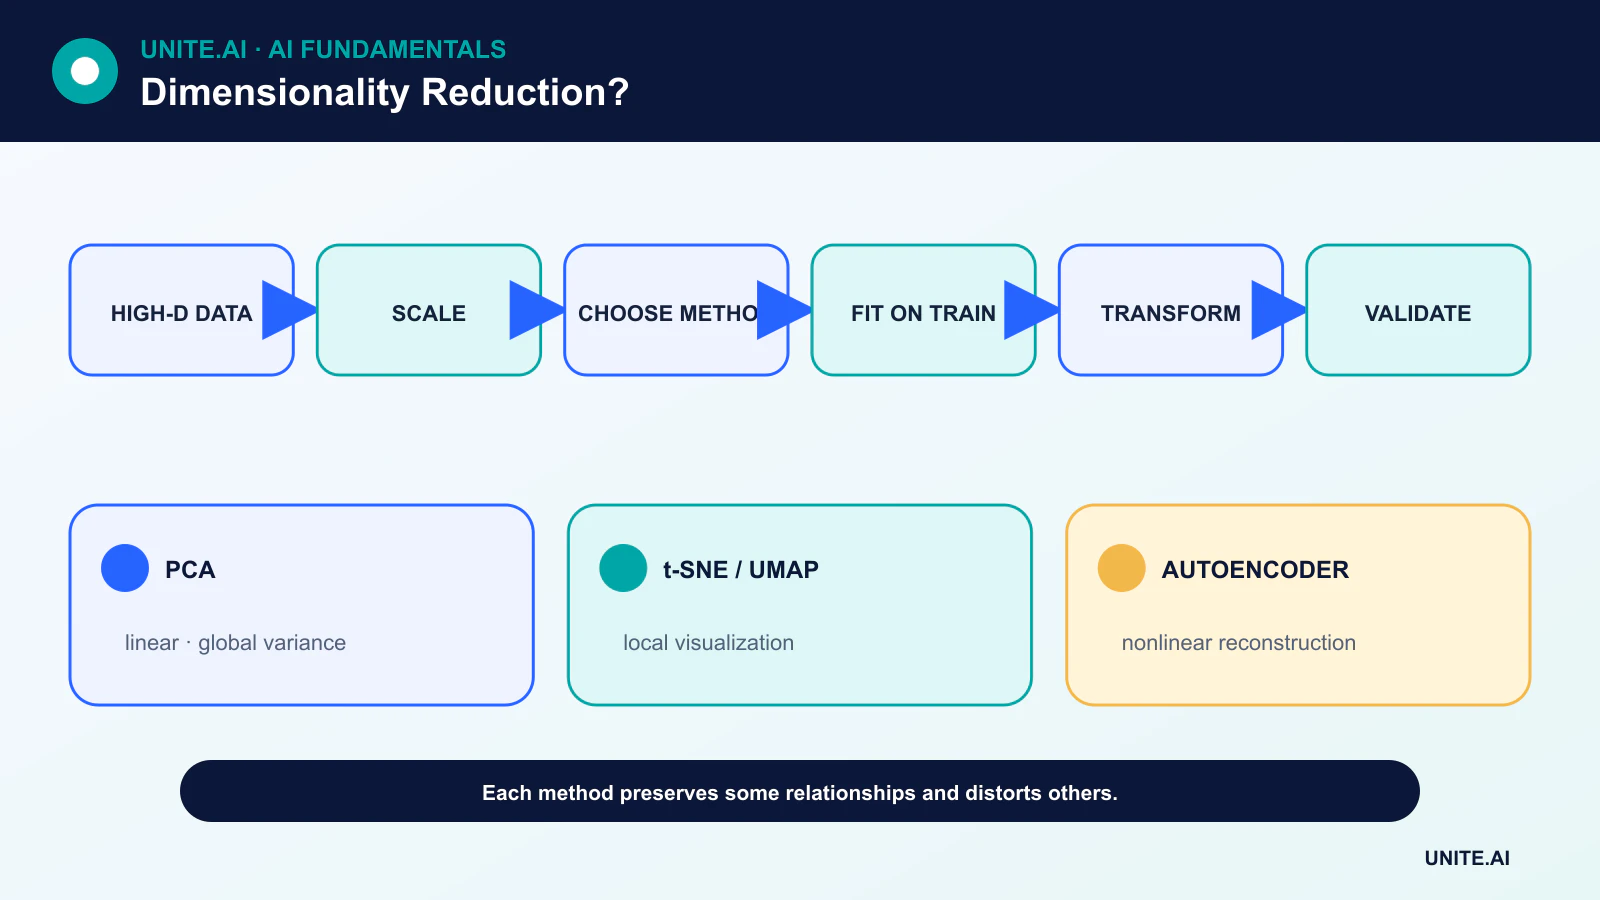
特征选择与投影
特征选择通过领域规则、缺失情况、冗余、预测测试或正则化来移除变量。它保留原始含义,有助于治理和解释。
投影方法将变量组合成新的坐标。它们能够捕获分布式结构,但可能使每个坐标更难解释。自动编码器通过重构学习非线性投影。
PCA 与 SVD
主成分分析在对数据中心化后识别方差递减的正交方向。奇异值分解提供了一条常用的数值途径。尺度很重要: 高方差的测量单位可能主导各主成分。
PCA 在符号和重复特征值之外是确定性的,支持样本外变换并提供解释方差的汇总。高方差并不总是与任务相关,线性成分也无法展开所有弯曲流形。
t‑SNE 与 UMAP
t‑SNE 在邻居上构建概率分布,并优化强调局部相似性的低维映射。UMAP 构建加权邻域图,并优化具有相关局部结构目标的低维表示。
二者都是强大的探索性工具,但对预处理、距离度量和超参数敏感。二维图中的空白、簇面积以及簇间距离不应自动被赋予真实世界的解释。
监督方法与任务感知表示
线性判别分析利用类别标签寻找分离,这使其不同于无监督的 PCA。神经表示学习可以优化预测或对比目标,而非重构。
如果标签引导降维,则所有拟合和调参必须在训练过程中完成。否则测试集信息可能泄漏到模型选择中,导致过于乐观的结果。
选择与验证方法
从预处理和简单基线开始。对于压缩,衡量不同维度下的重构或下游性能。对于可视化,测试不同随机种子和超参数的稳定性,并将邻域保持情况与领域知识进行比较。
在生产环境中,需要询问该方法是否能对新记录进行变换、如何处理缺失值、在重新训练时是否会变化,以及用户是否需要原始特征的解释。过拟合可能在降维步骤中出现,正如在最终模型中一样。
线性与非线性降维方法
降维将高维数据映射到更少的坐标,同时保留选定的结构。主成分分析在中心化后寻找最大方差的正交方向;当各单位应贡献相当时需要进行尺度化。奇异值分解计算相关的低秩结构并支持稀疏矩阵。线性判别分析利用标签寻找类别分离方向。这些方法提供显式变换,但方差或类别分离可能无法保留下游任务所需的信息。
流形方法如 t‑SNE 和 UMAP 构建邻域并优化低维布局。它们在探索中非常有用,但会扭曲全局距离、密度、簇大小,有时甚至分离度。结果受预处理、度量、邻居数或困惑度、初始化以及随机种子的影响。即使不存在离散群体,二维中也可能出现诱人的簇。应使用多种设置,仅依据未用于拟合的元数据上色,并在原始空间或使用独立标签验证表面结构。
特征选择、嵌入与评估
特征选择通过过滤器、包装器或基于模型的重要性保留原始变量;表示学习使用自动编码器或监督模型创建新的潜在特征。随机投影在特定条件下近似保持距离,并提供高效的基线。应根据压缩、可视化、降噪、速度、存储或模型性能选择方法。仅在训练数据上拟合降维器,然后对验证集和测试集进行变换。监督降维必须嵌套在交叉验证中,以避免标签泄漏。
对线性压缩评估解释方差或重构质量,对可视化评估可信度和邻域保持情况,对预测评估下游准确率、校准、延迟和鲁棒性。测量不同样本和随机种子的稳定性。检查是否有稀有类别或敏感群体被合并,以及是否可以进行逆映射。降维后的坐标仍可能包含私人信息;二维图并非匿名化手段。需记录变换、尺度化器、特征顺序及其局限性。
生产环境使用
部署时需要精确的已拟合变换和输入模式。监控缺失特征、范围漂移、组件得分分布、重构误差以及下游结果。如果出现新类别或传感器,应重新训练并对整个流水线进行版本管理,而不是悄悄追加列。降维可以提升计算效率并去噪模型,但也可能丢弃对稀有事件重要的弱信号。应将其视为一种学习得到的测量步骤,必须对保留和丢失的信息进行决策层面的测试。
案例演示:降低客户行为特征维度
分析师对200个行为指标进行标准化,并仅在训练客户上拟合 PCA。交叉验证依据下游流失预测性能和稳定性而非二维散点图来选择组件数量。检查载荷以发现主导来源和缺失情况。将 PCA、特征选择、随机投影以及未降维的正则化模型在校准、延迟和稀有客户细分结果上进行比较。重复抽样还用于检验主要组件和下游结论的稳定性。
部署的流水线固定特征顺序、尺度化器和组件,并拒绝缺失的模式版本。监控跟踪组件分布、重构误差和下游结果。可视化中出现的表面簇用于生成问题,而非分配客户画像。由于潜在组件仍然编码行为,访问和保留仍受控制。如果源定义发生变化,则会重新构建并验证完整的变换和模型,而不是将不兼容的数据投射到旧组件中。
实现证据与运营准备度
生产决策需要的不仅是成功的演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每个重要故障的后果。在调参前建立可复现的基线和带版本的评估集。测试普通情况、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。将任务质量与校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性一起衡量。记录每一次变换和阈值,以便独立审阅者能够复现结果,并将证据与吸引人的原型区分开来。
上线前,需指定发布、例外、变更、回滚和退役的权限。采用分阶段发布,保留安全回退,并通过人为注入故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,同时避免收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据源、用户、模型、供应商、政策、硬件或目标发生变化时,都需重新评估。维护中的系统还需要有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
降维是否总能提升模型?
不会。它可能会丢弃预测信息或使解释更加困难。请在留出数据上与未降维的基线进行比较。
分离的 t‑SNE 簇是否证明真实类别的存在?
不会。该图是对邻域关系的优化可视化,可能产生表面分离。需使用独立证据对簇进行验证。
主要参考文献












