
AI 基础
什么是集成学习?

 将 Unite.AI 添加到您在 Google 上的首选来源
集成学习将多个模型的预测结果进行组合。核心思想是,当模型的错误不同且将它们的输出进行平均、投票或交给元学习器时,能够得到更准确或更稳定的结果。
仅仅增加模型数量并不足够。如果每个成员都学习了相同的捷径,它们的错误会高度相关,集成可能只是对同一错误更有信心。
关键要点
- 当成员模型各自有用且错误差异显著时,集成效果最佳。
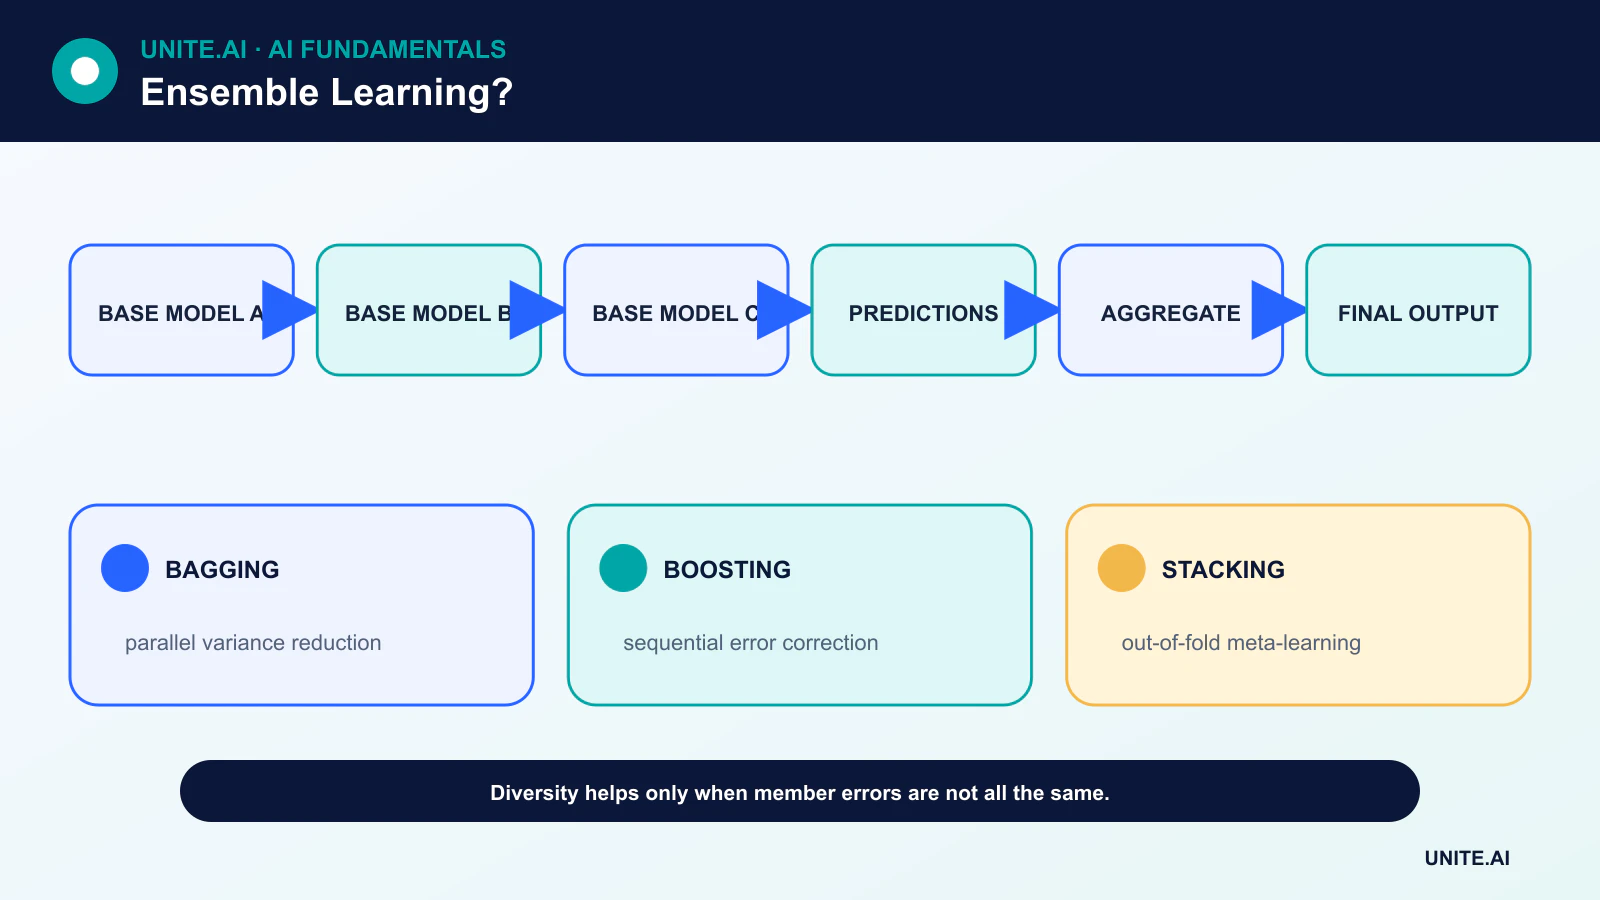
- 装袋(Bagging)在并行的重采样数据上训练成员;提升(Boosting)则顺序训练学习器以纠正错误。
- 堆叠(Stacking)在折外预测(out‑of‑fold predictions)上训练元模型,而不是在样本内预测上训练。
- 精度提升必须权衡延迟、校准、可解释性和维护成本。
投票与平均
硬投票(Hard voting)选择票数最多的类别。软投票(Soft voting)对类别概率进行平均,通常在校准之后进行。回归集成常常对数值预测取平均。加权版本会赋予更强的成员更大影响力。
当错误不完全相关时,平均可以降低方差。但它无法修复共享的数据缺陷、标签错误或缺失的子群体。多样性应通过不一致性和错误重叠来衡量,而不是仅凭模型名称的不同来假设。
装袋与随机森林
自助聚合(Bootstrap aggregating)在重采样的数据集上训练模型并对它们的预测取平均。决策树方差较高,是装袋的天然候选。
随机森林在划分时加入随机特征选择,降低树之间的相关性。袋外(Out‑of‑bag)样本可用于估计性能,但仍需保留一个未触碰的最终测试集,以便进行模型选择和部署声明。
提升
提升通过分阶段构建加法模型。后续学习器聚焦于当前集成处理不佳的样本或残差模式。AdaBoost 调整样本权重;梯度提升则让学习器拟合选定损失函数的负梯度。
提升树能够建模复杂的表格关系,但深树、过多迭代以及信息泄漏仍可能导致过拟合。学习率、树深度、子采样和提前停止是关键控制参数。
堆叠与混合
堆叠创建一个二层模型,学习如何组合基模型的预测。为避免泄漏,元模型的每一行训练数据必须来自未在该行上训练过的基模型。交叉验证生成这些折外预测。
混合使用单独的保留集来训练元模型,虽然更简单,但会减少可用于训练的数据量。两种方法在推理时都需要相同的预处理和版本控制。
运营权衡
集成会成倍增加内存、计算和故障模式。它可能更难解释、校准和一致更新。蒸馏可以将集成压缩为更小的模型,但学生模型必须单独评估。
实际选择时需比较性能、尾部延迟、校准、资源使用和错误成本。有时一个正则化良好的单模型比脆弱堆叠带来的微小精度提升更可取。
为什么集成有效
集成学习通过让多个模型的错误部分相互抵消或让各自的优势覆盖不同区域来提升整体表现。装袋在重采样数据上训练模型并对预测取平均,降低方差;随机森林通过随机特征选择使树之间去相关。提升按顺序训练学习器以聚焦残差错误,通常降低偏差但会增加对噪声和调参的敏感度。堆叠在基模型预测上训练元模型。多样性必须是有用的: 对相同模型进行平均只会增加成本而几乎不降低错误。
错误之间的相关性决定收益。多样性可以来源于数据样本、特征、算法、超参数、随机初始化或时间窗口。硬投票会丢失置信度;软投票对概率取平均但需要兼容的校准。回归可以平均或使用稳健聚合。在堆叠中,折外预测是必不可少的——在同一拟合数据上训练元模型会导致泄漏。采用复杂组合器之前,先保留一个简单的平均基线。
评估、校准与不确定性
在保持相同预处理的留出集上比较每个成员和整体集成。报告任务指标、校准情况、子群体错误、折或随机种子间的方差以及资源成本。集成可以提升平均质量,却可能掩盖因共享数据或标签导致的共同盲点。检查不一致性:它可能指示不确定性,但高度相关且自信错误的模型也可能达成一致。对最终集成进行校准,而不仅是对单个成员,并根据审查容量和后果验证弃用阈值。
袋外估计对装袋模型有用,但不能替代最终的、代表部署环境的测试。对时间序列数据,要避免破坏顺序的重采样。对安全相关的使用场景,需要测试成员失效、模型陈旧和对抗性输入。加权集成在尝试大量候选模型时可能在验证集上过拟合。记录候选选择过程,并在调参广泛时使用嵌套验证。
部署与维护
集成会增加内存、延迟、能耗和运营依赖。蒸馏可以将组合行为压缩为单一模型,但需要新的验证要求。将成员、预处理、权重和路由统一版本化;定义成员超时或产生无效结果时的行为。监控成员预测和不一致性,使静默失效可被发现。淘汰冗余成员并有计划地重新训练。只有当错误多样性真实存在时,集成才能提升预测,但它并不能把有偏的训练数据或无效的目标转化为可靠证据。
实例演示: 用于严重天气警报的集成
一个预报团队将物理模型特征集、梯度提升树、神经序列模型和校准的统计基线进行组合。折外预测用于训练一个简单的元模型,评估则使用完全未被成员训练过的未来风暴。指标包括事件召回率、误报率、提前时间、校准、地域表现以及在罕见极端条件下的可靠性。会检查成员错误的相关性,因为共享输入数据可能导致共享盲点。
部署时保留每个预测及其组合结果。如果某个成员不可用,系统会使用预先验证的降级配置,而不是静默地重新归一化。出现不一致时会触发额外审查,但并非在所有情况下都视为不确定性。监控记录成员漂移、延迟和风暴结果,权重仅通过受控验证进行更新。公众警报仍须遵循授权的气象决策流程;集成提供了更有力的证据,却不会自行重新定义警报政策。
实施证据与运营准备
生产环境的决策需要超出成功演示的依据。明确预期用户、运行环境、输入、输出、依赖、负责人以及每种重要失效的后果。调参前建立可复现的基线和版本化的评估集。测试普通案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被服务不足的群体或环境。将任务质量与校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全一起衡量。记录每一次转换和阈值,以便独立审查员能够复现结果并区分证据与吸引人的原型。
上线前,指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过人为注入故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及确认的结果,且不收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据源、用户、模型、供应商、政策、硬件或目标变化时,都要重新评估。维护中的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
随机森林是集成吗?
是的。它通过投票或平均的方式组合了大量随机化的决策树。
相同模型能形成有用的集成吗?
如果训练数据、初始化或抽样产生了足够不同的错误,它们可以形成有用的集成,但单纯的复制并不会带来收益。
主要参考文献












