
AI 基础
什么是生成对抗网络(GAN)?

 将 Unite.AI 添加到您在 Google 上的首选来源
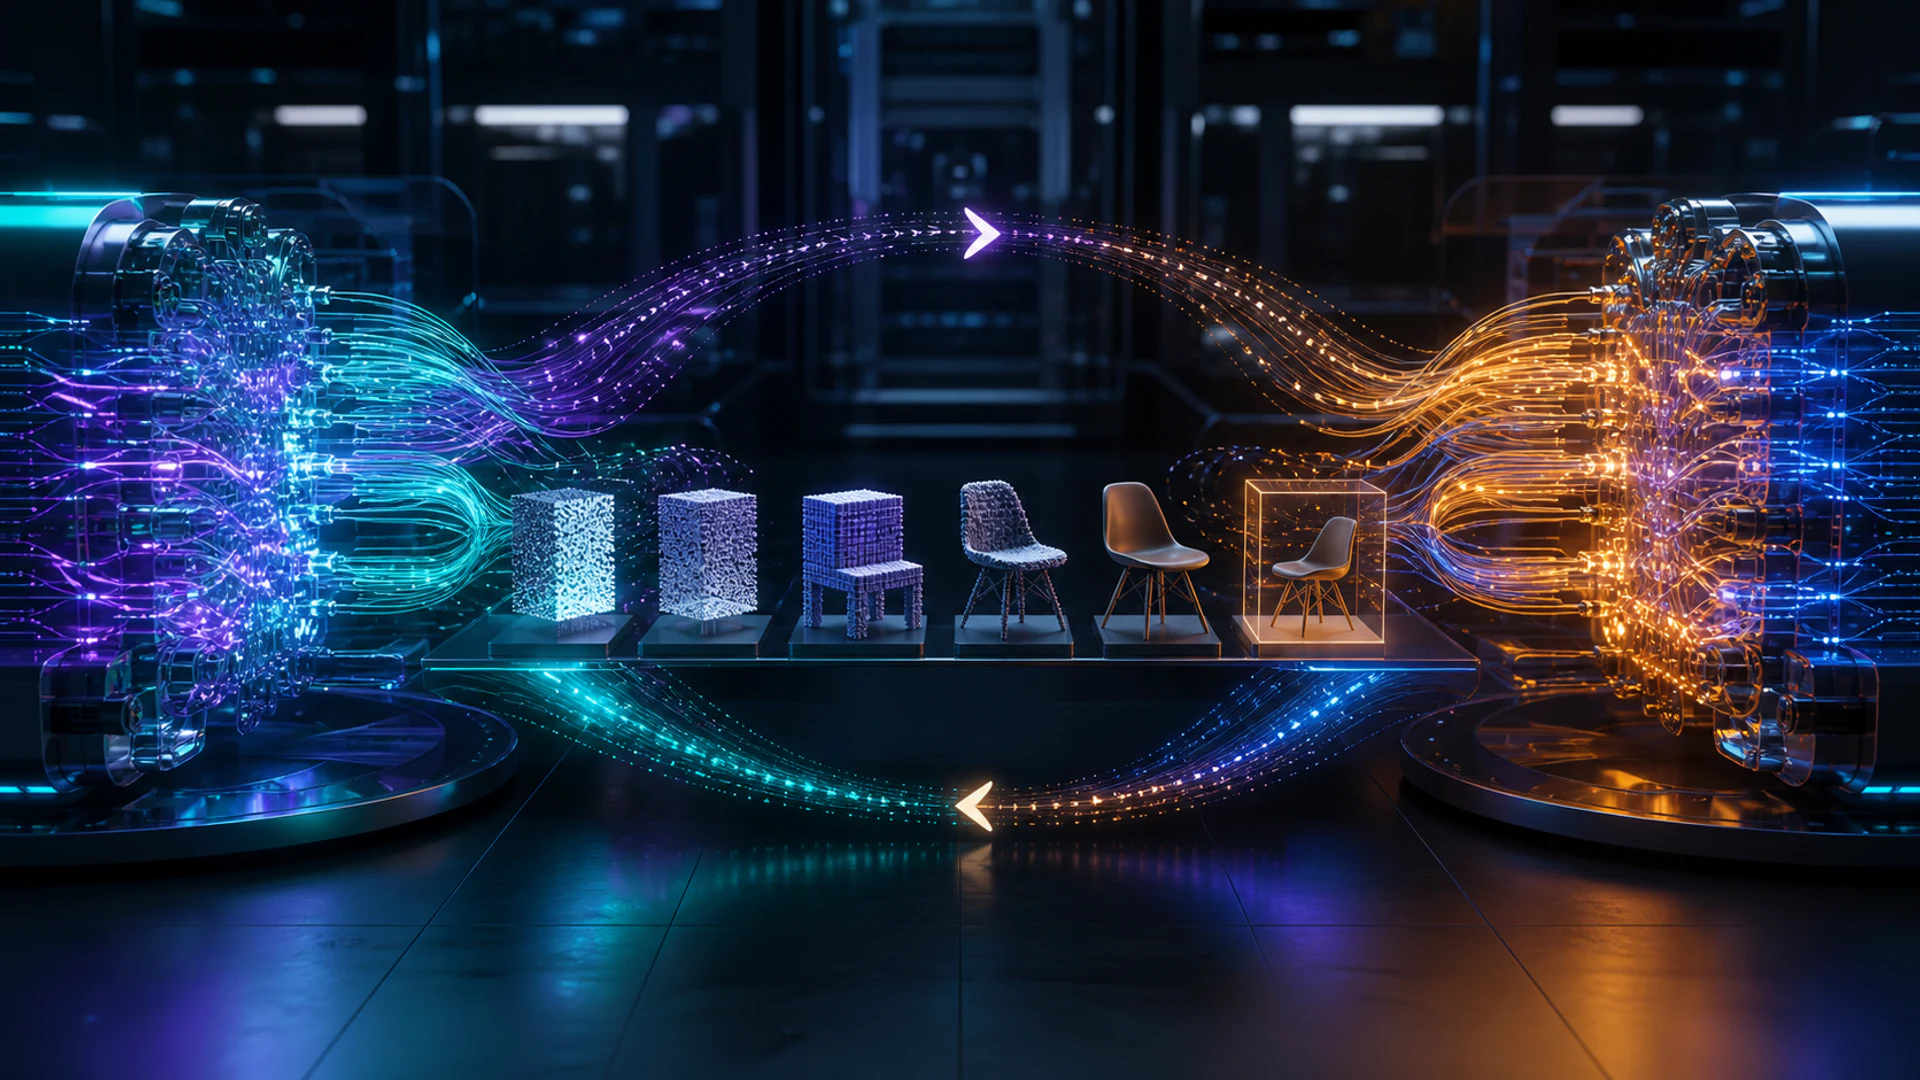
一个 生成对抗网络(GAN) 在竞争中训练两个神经网络。生成器将随机或条件输入转换为合成样本。判别器尝试将生成的样本与真实训练示例区分开来。每个网络的反馈会改变另一个网络的学习问题。
GAN 可以生成清晰的图像和可控的合成数据,但对抗训练很难稳定。视觉真实感并不等同于多样性、事实有效性或使用训练数据的许可。
关键要点
- 生成器产生样本;判别器学习真实与生成的判别信号。
- 训练旨在寻找平衡,但对手的变化可能导致不稳定、振荡或模式崩溃。
- 条件 GAN 通过标签、文本或其他上下文控制生成。
- 评估应测试保真度、覆盖率、记忆化以及下游风险——而不仅仅是图像质量。
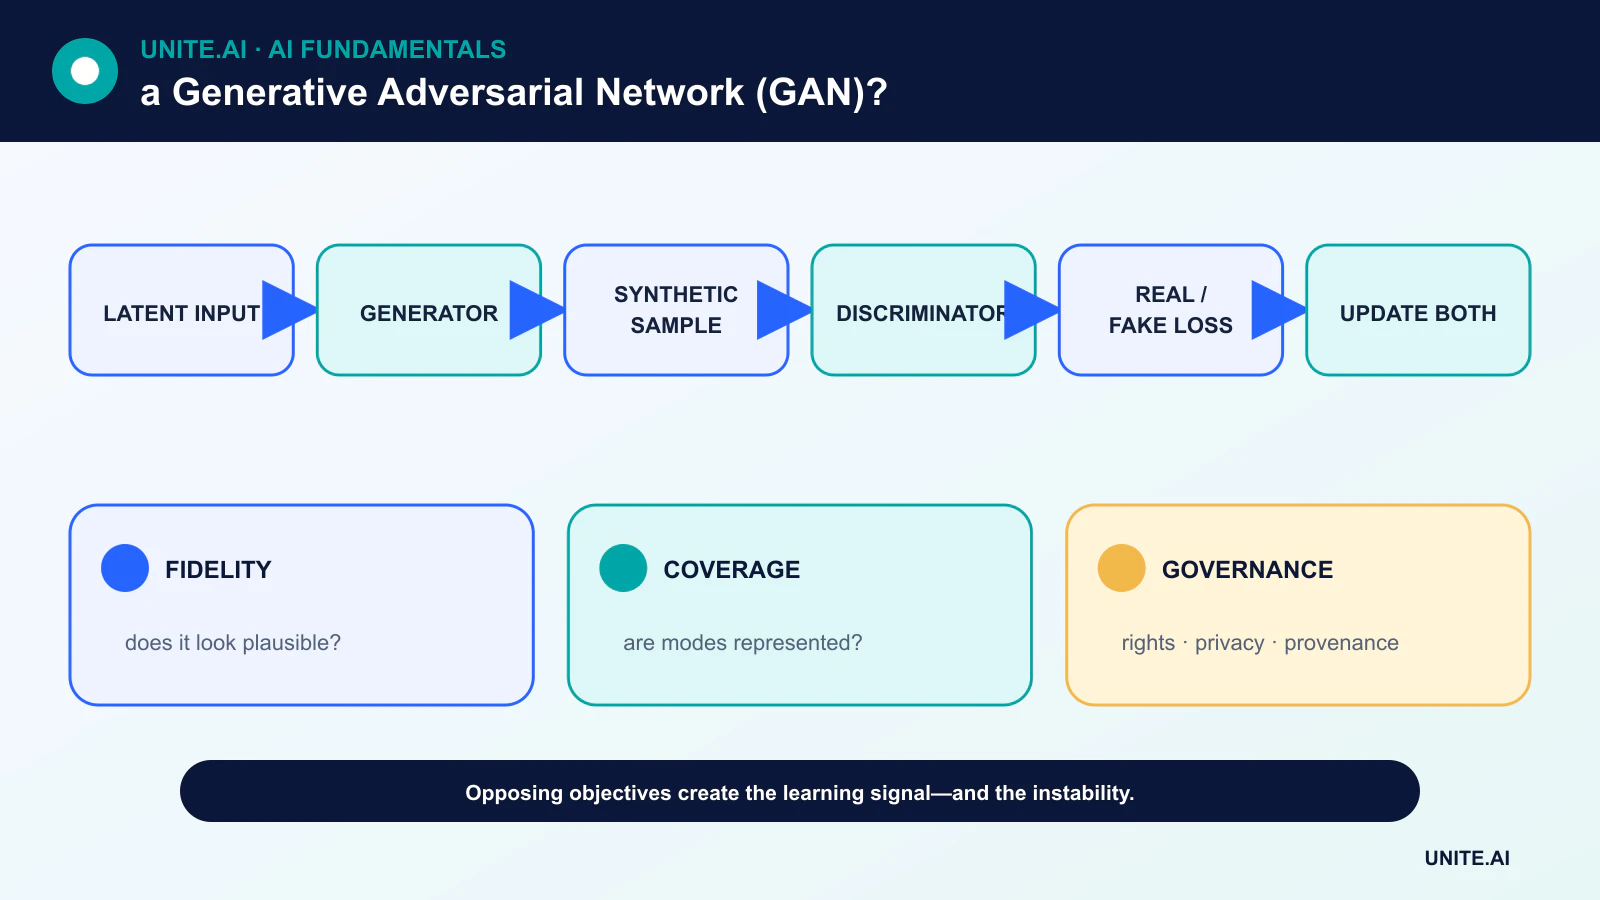
对抗游戏
最初的表述是一个双人极小极大博弈。判别器在区分真实数据与生成数据方面不断提升,而生成器在使判别器将样本分类为真实方面不断改进。两者均通过反向传播进行训练。
如果判别器变得过于准确,其对生成器的反馈可能无益;如果判别器过于薄弱,生成器可能利用简单的捷径。因而训练交替更新,并仔细平衡模型容量、损失函数和优化设置。
模式崩溃与训练稳定性
当大量潜在输入产生相似输出时会出现模式崩溃,导致样本看似合理却仅覆盖数据分布的一小部分。其他失效包括振荡、梯度爆炸以及对随机初始化的敏感性。
Wasserstein 目标、梯度惩罚、谱归一化、架构改动以及调节的更新比例可以提升稳定性。但它们并不能免除检查多样性以及使用多个随机种子重复实验的必要。
条件生成与潜在控制
条件 GAN 为生成器和判别器提供标签或其他上下文,从而实现对特定类别或属性的控制。基于风格的架构在不同分辨率上分离潜在控制的各个方面,已生成高度逼真的图像。
潜在方向可能与人类概念相关,但编辑某一属性可能会影响其他属性,因为训练数据中存在相关特征。对可控性的主张应在多样的身份和上下文中进行测试。
评估、隐私与来源
诸如 Fréchet Inception Distance(FID)之类的指标比较特征分布,但它们继承了特征模型的假设,可能遗漏记忆化或子群体失效。最近邻分析、精确率/召回率式的覆盖测试以及人工审查提供了互补的证据。
GAN 可能记忆稀有样本、复制偏见或生成欺骗性媒体。团队应记录数据集、版权、过滤、水印或来源机制以及滥用控制。合成数据并非自动匿名。
GAN、VAE 与扩散模型
变分自编码器通过优化基于似然的潜在目标,常常以样本清晰度换取结构化的潜在空间。扩散模型学习逆转噪声过程,已成为图像生成的常用基础。
当需要快速一次性采样、特定的图像到图像映射或紧凑部署时,GAN 仍然有用。选择合适的方法取决于质量、多样性、延迟、训练稳定性和治理,而非哪种架构最新。
对抗目标与训练动态
生成对抗网络训练生成器生成样本,判别器区分生成数据与真实数据。在原始的极小极大博弈中,判别器估计与密度比相关的信号,生成器则试图欺骗它。训练交替更新,使每个网络针对不断变化的对手而非固定的损失进行学习。如果判别器过于强大,生成器的梯度可能无益;若判别器过弱,生成质量会停滞。仅凭损失值并不能直接对应样本质量。
当生成器产生有限的多样性以欺骗判别器时会出现模式崩溃。振荡、对超参数的敏感性以及不稳定的归一化也很常见。Wasserstein 目标、梯度惩罚、谱归一化、特征匹配、小批量统计以及精心平衡的更新调度可针对不同的失效机制。条件 GAN 使用标签、文本或图像来引导输出;基于风格的架构分离潜在影响。数据集的质量和覆盖率仍是根本,因为生成器会复制并重新组合其所见的分布。
评估与负责任使用
分别评估保真度和多样性。Fréchet Inception Distance(FID)比较特征分布,但受样本量、特征模型、预处理和领域的影响;Inception Score 则不与真实数据比较。生成模型的精确率与召回率、最近邻分析、记忆化检查以及人工任务评估提供额外证据。对于科学或医学合成,使用领域指标和下游验证。保留一个未见的真实集,并在相同计算资源和分辨率下与扩散或自回归基线进行比较。
GAN 可以用于数据增强、领域迁移、图像超分辨率、媒体合成以及支持仿真,但合成数据可能放大偏见或泄露训练样本。需核实许可、同意、身份和来源。防止未经同意的冒充和欺骗性使用,在适当情况下对输出进行标记或签名,并保留生成元数据。光照真实的图像并非文献证据;当输出影响决策时,必须保持对不确定性和合成来源的可见性。
部署与可复现性
记录生成器、判别器、优化器、数据集、随机种子、截断以及采样设置。量化或导出可能改变归一化和输出,因此需验证服务产物。监控提示或条件分布、安全过滤器、输出多样性、延迟和报告。在公共系统中使用速率限制和身份保护。GAN 训练是耦合的优化实验:挑选的展示图像无法证明模型的鲁棒性、覆盖率或无记忆化,模型应在预期生成任务的完整分布上进行评估。
案例研究:使用 GAN 合成缺陷图像
一家制造商训练条件 GAN 以生成稀有表面缺陷图像。它在训练和评估前确认训练图像拥有使用权,并将生产批次分离。生成的样本会进行最近邻记忆化、缺陷几何形状、背景伪影、多样性以及专家可行性检查。使用合成数据增强训练的分类器仅在独立的真实缺陷上评估,并与使用传统增强的同一分类器进行比较。
仅当真实世界的召回率提升且未增加误拒或子群体错误时,合成数据才被接受。生成设置和来源信息会附加在每张图像上,合成文件永不作为真实检查进入测试集或证据档案。操作员不能利用生成器伪造审计记录。团队比较扩散模型的替代方案以及收集更多真实样本的成本,认识到逼真的外观并不证明 GAN 捕捉到了物理失效过程。
实施证据与运营准备
生产决策需要的不仅是成功的演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每项重要失效的后果。调优前建立可复现的基线和带版本的评估集。测试常规案例、边界条件、错误或缺失的输入、分布漂移、依赖中断、滥用以及最可能被忽视的群体或环境。衡量任务质量时同步评估校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录每一次转换和阈值,以便独立审阅者复现结果并将证据与诱人的原型区分开来。
在上线前,指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状态、人为覆盖以及已确认的结果,且不收集不必要的敏感数据。定义警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标变化时都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除和保留流程,以及明确的停用或替换时点。
常见问题
GAN 能理解它生成的图像吗?
GAN 学习用于生成的统计结构。但这本身并不能证明其具有人类般的语义或因果理解。
GAN 生成的样本可以安全地用作训练数据吗?
仅在检查了覆盖率、标签有效性、记忆化、偏差以及合成分布是否在真实留出测试集上有帮助之后,才可使用。
主要参考文献












