
AI 基础
什么是反向传播?

 将 Unite.AI 添加到您在 Google 上的首选来源
Backpropagation 是用于计算神经网络的损失相对于其可训练参数的变化的算法。它在前向传播记录的操作上向后应用微积分的链式法则。
反向传播计算梯度;它本身并不决定更新。诸如随机梯度下降或 AdamW 等优化器使用这些梯度来改变权重、偏置以及其他可训练参数。
关键要点
- 前向传播构建中间值并产生预测。
- 损失函数将预测值和目标转换为标量训练目标。
- 反向传播利用局部导数和链式法则高效计算参数梯度。
- 现代框架在计算图上实现逆向自动微分。
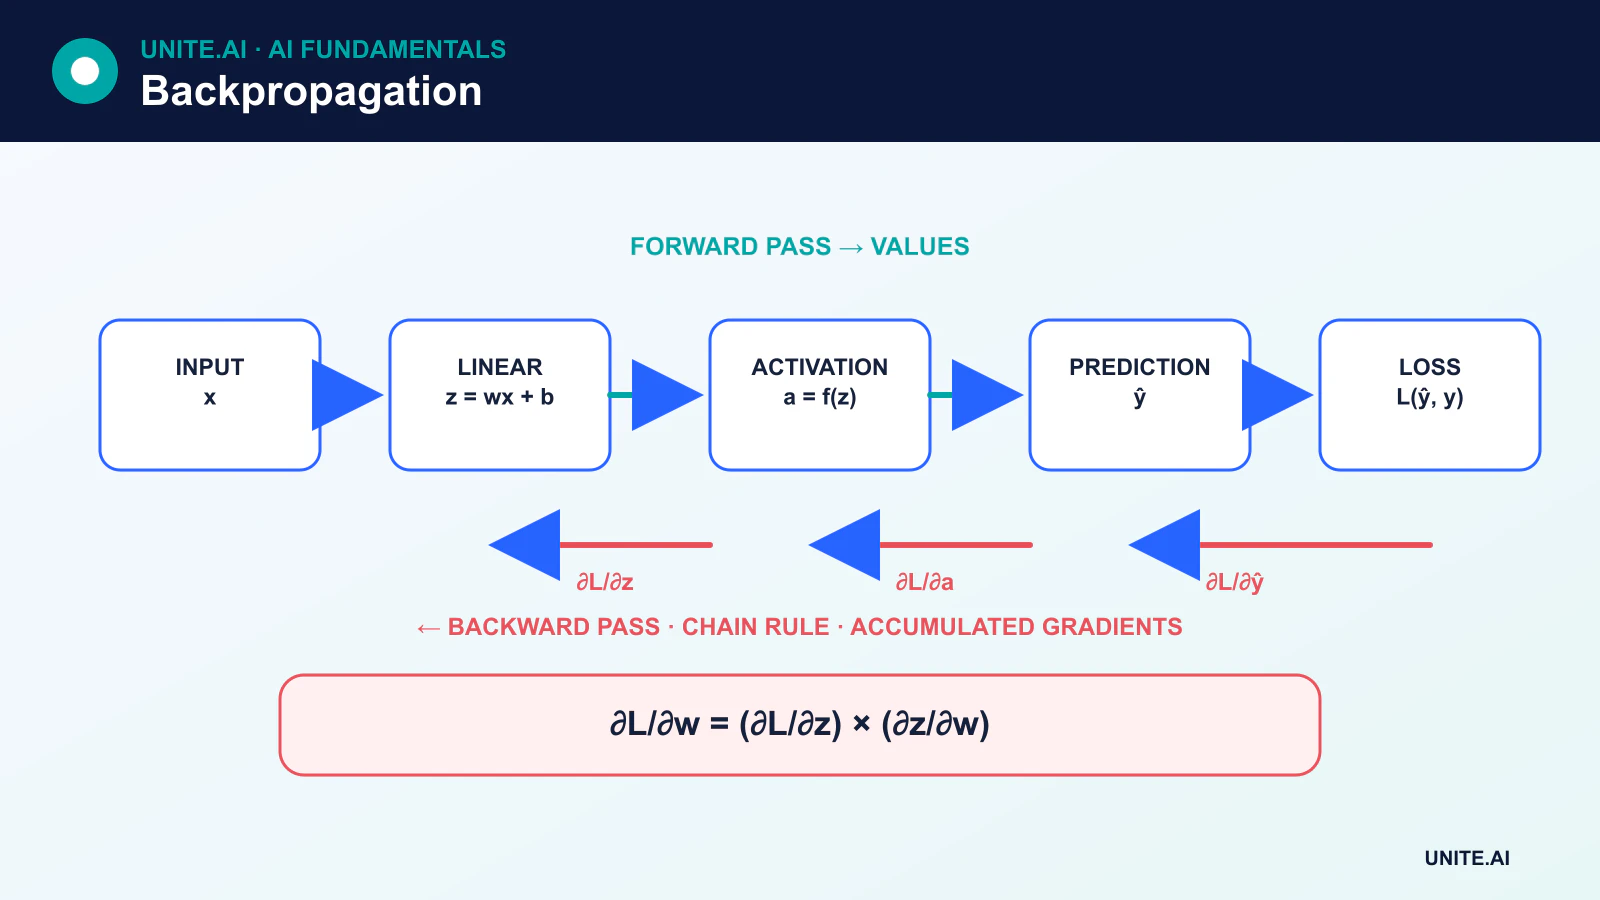
前向传播
考虑一个简单单元:
z = wx + bŷ = activation(z)
输入是 x,而 w 和 b 是可训练的权重和偏置参数。偏置在训练过程中通常会像权重一样变化。网络将许多此类操作结合起来,还包括归一化、注意力、卷积、残差连接或其他可微块。
前向传播执行这些操作并产生预测。交叉熵或均方误差等损失函数用于衡量目标。最合适的损失函数取决于任务和输出的解释方式。
链式法则
如果损失 L 依赖于中间值 z,且 z 依赖于参数 w,则链式法则给出:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
深度网络包含许多路径。反向传播在计算图中逆向遍历,当一个值通过多个路径影响损失时会累加其贡献。结果是对每个参与前向计算的可训练参数得到梯度。
一个小的数值例子
假设 ŷ = wx + b,其中 x = 2,w = 3,b = 1。预测值为 7。如果目标值为 5,且损失为 L = ½(ŷ - y)²,则:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
优化器随后可以沿负梯度方向更新 w 和 b。该公式仅适用于所选的线性单元和平方误差损失;通用的反向传播规则是针对实际计算图的链式法则,而不是固定的“误差”方程。
反向传播 与 梯度下降 的对比
梯度下降 是一种优化方法。反向传播提供所需的梯度。一次训练步骤通常包括:
- 清除或重置已存储的梯度。
- 执行前向传播。
- 计算损失。
- 执行反向传播。
- 应用优化器的更新。
将这两个概念分离有助于更容易理解动量、AdamW、梯度累积以及混合精度训练。
自动微分
诸如 PyTorch 的框架在前向传播期间记录操作并构建计算图。随后,逆向模式的自动微分高效地从输出向参数计算向量-雅可比乘积。这比为固定网络手动编写导数更通用,也构成了现代深度学习框架的基础。
某些操作不可微或其导数不稳定。框架在特定情况下定义次梯度或文档化约定,但从业者仍需了解分离张量、原位操作以及数值精度。
梯度消失与梯度爆炸
在许多层或时间步中重复相乘会导致梯度极小或极大。梯度消失会使前层学习变慢;梯度爆炸会使更新不稳定。ReLU 系列激活函数、谨慎的初始化、残差连接、归一化、门控递归以及梯度裁剪都有助于缓解,但没有一种是万能的解决方案。
梯度检查
有限差分梯度检查将解析或自动梯度与数值近似进行比较。虽然速度慢,但对调试自定义操作很有用。监控梯度范数并检测 NaN 或无穷值可以揭示训练过程中的不稳定性。
在计算图中的链式法则
反向传播高效地计算标量损失相对于每个可微参数的梯度。前向传播在计算图中记录中间值。从损失开始,逆向模式的自动微分应用链式法则,乘以局部导数并在路径相交处累加贡献。对于层 y=f(x,w),对 y 的上游灵敏度与偏导数相结合,产生对 x 和 w 的灵敏度。反向传播计算梯度,优化器决定参数的变化方式。
一个简单的仿射层产生 y=Wx+b。W 的梯度是上游梯度与输入的外积,b 的梯度是上游值的求和,输入的梯度则乘以转置的权重矩阵。激活函数提供逐元素的导数。卷积、归一化、注意力和循环层的复用遵循相同的图原则,但需要正确的张量形状、广播、掩码以及参数共享。除非显式保留,框架会在反向传播后释放保存的激活,因此内存通常随批量、深度和序列长度增长。
梯度失效、验证与工程实践
众多导数的乘积可能会导致梯度消失或爆炸。类 ReLU 激活、谨慎的初始化、归一化、残差连接、门控以及梯度裁剪针对不同机制进行处理。饱和激活和不可微操作会阻断有用信号;截断的反向传播限制序列历史;混合精度在未进行损失缩放时可能下溢。梯度爆炸是一种症状,因而裁剪应伴随对学习率、数据、网络结构和数值误差的调查,而不是掩盖它们。
使用有限差分梯度检查在小规模双精度输入上验证自定义操作,避免不可微点。检查梯度范数、NaN、未激活的参数以及梯度是否到达预期模块。有意清除累积的梯度,并区分 dropout 与归一化在训练和评估时的行为。检查点会重新计算激活以节省内存;分布式训练必须一致地聚合梯度。训练损失下降表明存在优化路径,但并不意味着梯度在概念上正确、数据无泄漏或模型具备泛化能力。
实作示例: 验证自定义神经层
一位工程师为音频网络实现了可微分的谱层。一个微小的双精度测试将自动梯度与跨输入和参数的中心有限差分进行比较,排除操作故意不可微的点。形状、广播、填充以及复数转实数的转换分别列出案例。测试验证了在参数复用时累计的梯度,并确认被掩码的音频帧不产生梯度。
在训练过程中,仪表盘跟踪梯度和激活范数、NaN、未激活参数以及损失缩放。故意损坏的批次可验证在优化器更新前检测到非有限输出。混合精度和导出实现与参考实现进行比较。检查点恢复测试包括优化器状态和随机顺序。仅因总体损失下降而接受该层是不够的;单元梯度、数值稳定性以及下游泛化都必须提供一致的证据。
实施证据与运营准备
生产决策需要的不仅是成功的演示。要明确预期用户、运行环境、输入、输出、依赖、负责人以及每种重要故障的后果。调优前建立可复现的基线和带版本的评估集。测试常规情况、边界条件、错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的用户群体或环境。测量任务质量时同时考虑校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全。记录每一次转换和阈值,以便独立评审者能够复现结果,并将证据与诱人的原型区分开来。
上线前,分配发布、例外、变更、回滚和退役的权限。采用分阶段发布,保留安全回退,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状态、人为覆盖以及确认的结果,同时避免收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而非假设离线性能会持续。每当数据源、用户、模型、供应商、政策、硬件或目标变化时都需重新评估。维护中的系统还需要有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时机。
常见问题
反向传播会更新权重吗?
反向传播计算梯度。优化器使用这些梯度、学习率以及可能的动量或自适应动量等状态来执行更新。
反向传播在生物学上是否真实可信?
标准的反向传播是一种工程算法,并不被视为对生物大脑学习的详细模型。历史上的神经类比不应被当作生物等价来对待。
主要参考文献












