
AI 基础
什么是卷积神经网络(CNN)?

 将 Unite.AI 添加到您在 Google 上的首选来源
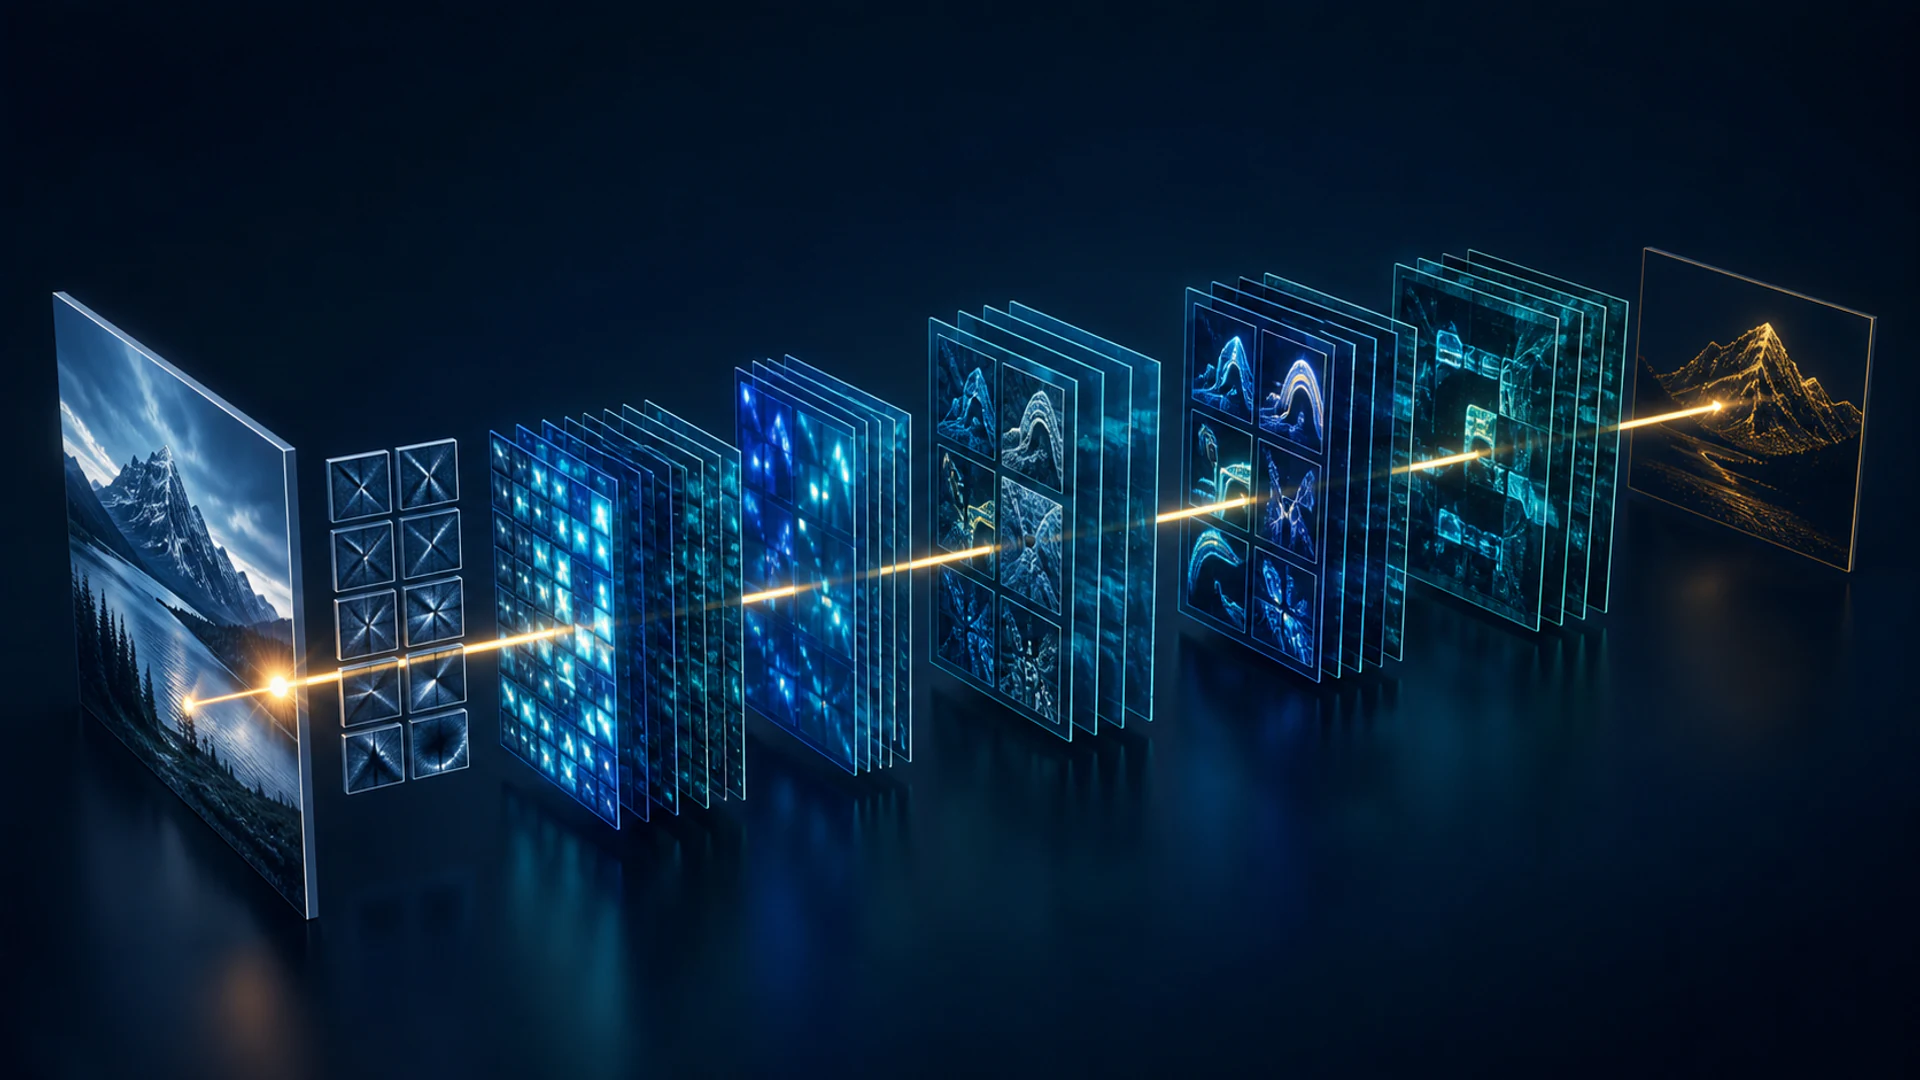
A 卷积神经网络(CNN) 是一种神经网络架构,它在输入的局部区域使用学习得到的滤波器。CNN 成为现代 计算机视觉 的基础,因为它们能够检测模式,无论这些模式出现在哪里,并在整幅图像中复用相同的参数。
CNN 并不将图像从非数值形式转换为数值形式——图像已经以像素值张量的形式出现。其目的是将该张量转换为对分类、检测、分割或其他任务有用的特征图。
关键要点
- 卷积将局部输入值与学习得到的卷积核相结合,生成特征图。
- 步幅、填充、膨胀和池化控制空间分辨率和感受野。
- 权重共享使得 CNN 相较于在原始像素上使用全连接网络更具参数效率。
- 视觉 transformer 提供了另一种选择,但在高效且数据受限的系统中,CNN 仍然表现出色。
卷积工作原理
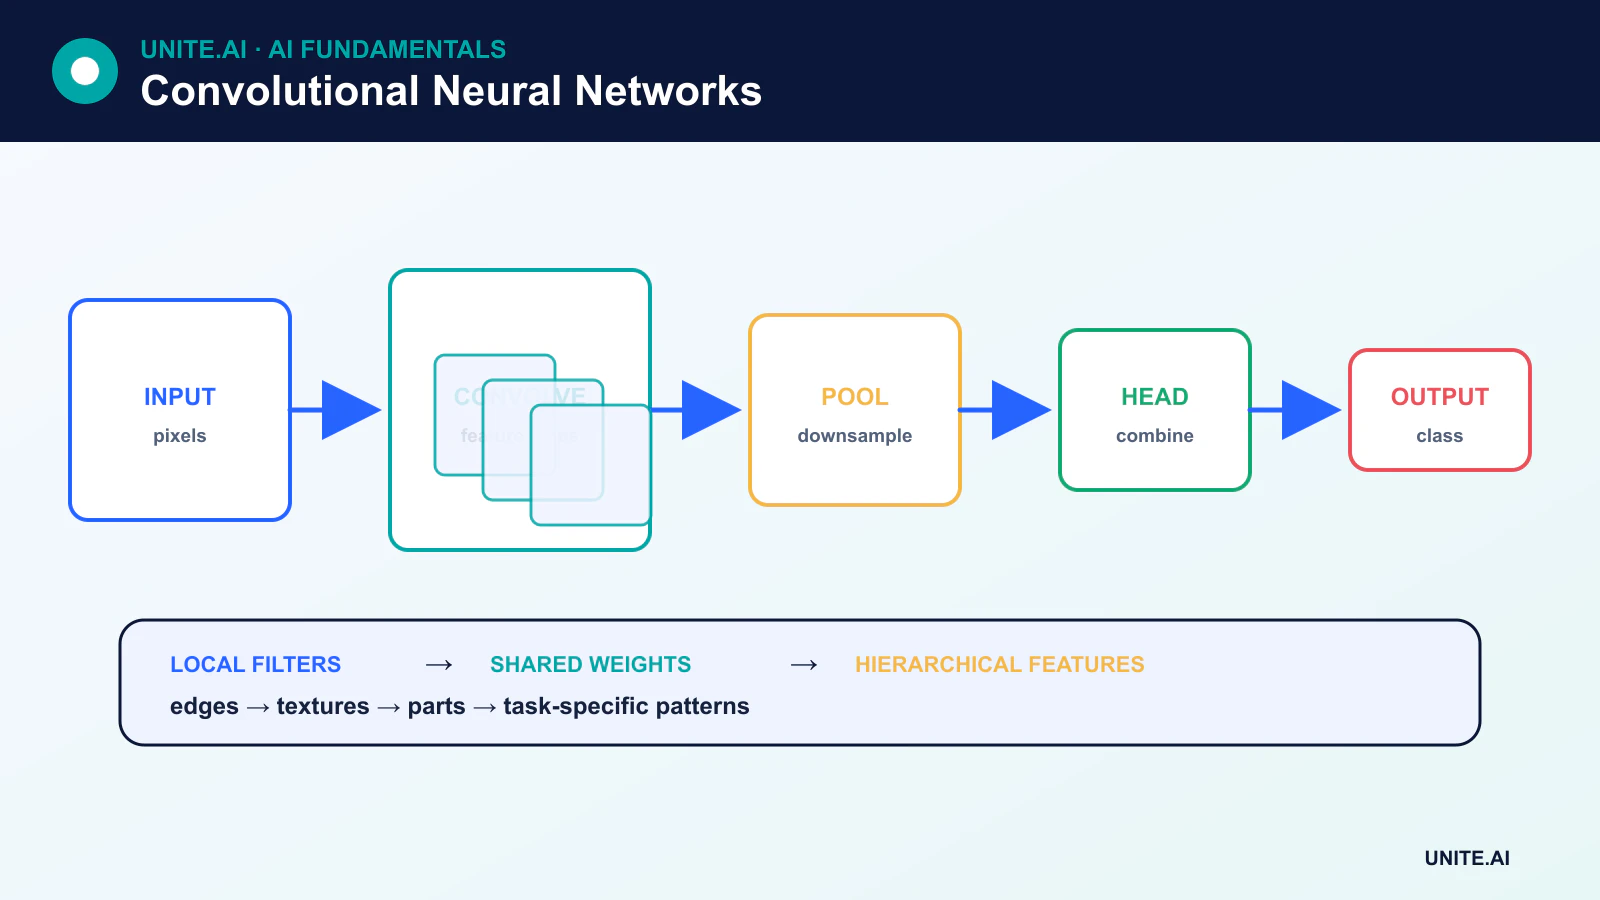
卷积核是由可训练权重组成的小网格。在每个位置,CNN 将卷积核的数值与对应的输入值相乘,求和后通常再加上偏置。将此操作在整个输入上重复,即可生成特征图。
对于彩色图像,卷积核覆盖所有输入通道。一个层使用多个卷积核来产生多个输出通道。在训练期间,反向传播 会计算这些卷积核权重的梯度;卷积操作并不会为每幅图像生成一套新的固定权重。
步幅、填充和膨胀
- 步幅 控制卷积核移动的距离。步幅大于一会降低空间分辨率。
- 填充 在输入周围添加数值,以便处理边缘信息并控制输出尺寸。
- 膨胀 将卷积核元素间隔开来,扩大感受野而不会成比例增加参数量。
感受野是指能够影响某个单元的原始输入区域。堆叠卷积会扩大感受野,使后续特征能够整合更广范围的信息。
激活、归一化和池化
卷积层通常后接非线性激活函数和归一化。池化使用最大值或平均值等操作对局部区域进行汇总。学习得到的带步幅的卷积也可以实现下采样。
池化并非强制要求。许多现代网络在输出附近使用全局平均池化,而不是将大型特征图展平为全连接层。这样可以减少参数,并让网络聚合空间证据。
现代卷积神经网络架构
典型的视觉模型包括一个主干、若干特征块序列、下采样阶段以及任务头。残差连接使得块能够学习对输入的修改,并为信息和梯度提供直接通路。残差网络的成功使得训练更深的 CNN 成为可能。
分类头输出类别得分。检测头预测类别和边界框。分割架构加入解码路径以恢复空间细节。同一 CNN 主干可以通过 迁移学习 进行复用。
CNN 层学到的内容
通常会可视化对边缘或纹理响应的早期滤波器以及与部件或物体相关的后期表示。这是一种有用的直觉,但并非固定规则。特征取决于任务、架构、数据、目标和训练过程,某些单元会组合信息,而这些信息并不一定能清晰映射到人类概念上。
CNN 与视觉 Transformer 的比较
视觉 Transformer 将图像划分为若干块,并使用注意力机制建模它们之间的关系。它们能够在大规模预训练数据集上有效扩展。CNN 则将局部性和平移不变性假设直接嵌入架构,使其在小规模场景下更高效且对数据更友好。
许多实际系统将卷积与注意力相结合。合适的架构取决于精度、延迟、内存、训练数据、硬件和部署需求,而不是取决于哪个系列更新。
局限性与实际考虑因素
CNN 可能对分布漂移、对抗扰动、背景捷径以及偏倚的训练数据敏感。它们并不能对位置、旋转、尺度或视角实现完美不变。数据增强和架构选择可以提升鲁棒性,但并不能保证。
在部署时,需要衡量端到端延迟、内存、吞吐量以及子群体行为。量化和剪枝可以降低成本,尤其是针对 边缘 AI,但压缩模型必须重新验证。
卷积、感受野与现代 CNN 模块
卷积层在网格上滑动学习得到的卷积核,并在不同位置共享权重。卷积核大小、步幅、膨胀和填充决定输出形状和感受野。早期层通常响应局部边缘或纹理;更深层则在更大区域上组合信息,尽管学习到的表示未必能清晰映射到人类概念。池化或带步幅的卷积会降低空间分辨率。通道承载特征图,而分组卷积和深度可分离卷积通过降低跨通道混合来减少计算量。残差连接使得极深网络更易优化。
对于输入的高度和宽度,填充决定边界处理方式,步幅决定采样方式。过度下采样可能会抹去小目标;零填充可能产生边缘伪影;膨胀在不显著增加参数的情况下扩展上下文,但可能导致网格效应。批量归一化依赖于训练统计信息,而其他方法在小批量情况下可能表现更佳。现代架构结合瓶颈、多尺度特征、注意力或反向残差。选择架构时应依据任务分辨率、内存带宽、延迟和目标硬件,而非仅凭图像分类精度。
训练、解释与部署
使用保持标签不变且反映真实变化的增强手段,并在增强前按主体或场景划分数据。迁移学习很常见: 替换任务头并进行训练,然后谨慎解冻主干。评估类别特定的性能、校准、对模糊、压缩、光照、尺度、裁剪以及对抗扰动的鲁棒性。特征图、显著性等可视化方法可以揭示捷径,但它们对方法和基准敏感。可通过反事实图像、遮挡测试或数据集变更来验证怀疑的依赖关系。
导出的 CNN 可能会被融合、量化或编译用于 GPU、NPU、浏览器或微控制器。需在实际设备上验证部署的计算图,包括前处理和后处理。测量端到端延迟、内存、能耗和热行为;对于小模型,输入解码可能占主导。监控相机和图像统计信息、输出分布以及已确认的错误。签名模型工件、受保护的更新通道以及优雅的传感器失效都是生产设计的一部分。CNN 编码了有用的局部性偏置,但并不会自动理解物体或因果场景。
案例演示:在检测相机上部署 CNN
CNN 对高分辨率线扫描图像中的表面缺陷进行分类。工程师对图像进行重叠切片,以便小缺陷在下采样后仍被保留,保存坐标供审查,并针对真实光学变化验证增强效果。将残差 CNN 与更轻量的深度可分离模型在相同召回率下进行比较。测试包括边缘缺陷、眩光、压缩、运动、材料批次以及相机更换,且保留独立的生产批次用于最终评估。
编译阶段将模型融合并量化以适配边缘加速器,但在敏感缺陷案例上仍将部署的计算图与参考模型进行对比。对解码、切片、推理和合并的延迟进行端到端测量。系统会将死像素和曝光漂移与产品缺陷区分标记。操作员可以检查源切片并覆盖结果。模型和相机的更改会逐步推出,当视觉流水线不可用时,生产线仍保留安全的人工检查流程。
实施证据与运营准备度
生产决策需要的不仅是一次成功的演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每种重要失效的后果。在调优前建立可复现的基线和带版本的评估集。测试普通案例、边界条件、畸形或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。测量任务质量以及校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录每一次转换和阈值,以便独立审查者能够复现结果并将证据与吸引人的原型区分开来。
在上线前,需指定发布、例外、变更、回滚和退役的责任人。采用分阶段 rollout,保留安全回退,并通过有意注入故障来验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,同时避免收集不必要的敏感数据。定义警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时都需重新评估。维护中的系统同样需要有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
CNN 是否总是需要池化?
不。CNN 可以通过带步幅的卷积进行下采样,并且能够在密集预测时保持分辨率。池化只是设计工具之一,而非必需条件。
CNN 滤波器是手工设计的吗?
在经过训练的 CNN 中,卷积核的数值通常是从数据中学习得到的。这与传统的视觉滤波器不同,后者的系数是预先为诸如边缘检测等操作手工设定的。
主要参考文献












