AI 基础
什么是神经网络?

 将 Unite.AI 添加到您在 Google 上的首选来源
人工神经网络是一种由层层相连的运算构成的参数化数学模型。训练过程中,网络会调整其参数,使输入映射到有用的输出。神经网络能够近似复杂的非线性关系,并直接从文本、图像、音频、时间序列及其他数据中学习表示。
该名称历史上受生物神经元的启发,但现代网络是工程系统,而非对大脑的真实模拟。诸如“神经元”和“学习”等术语是有用的简写,不应被误认为具有人类般认知的证据。
关键要点
- 神经元计算加权和,加入可训练的偏置,并应用激活函数。
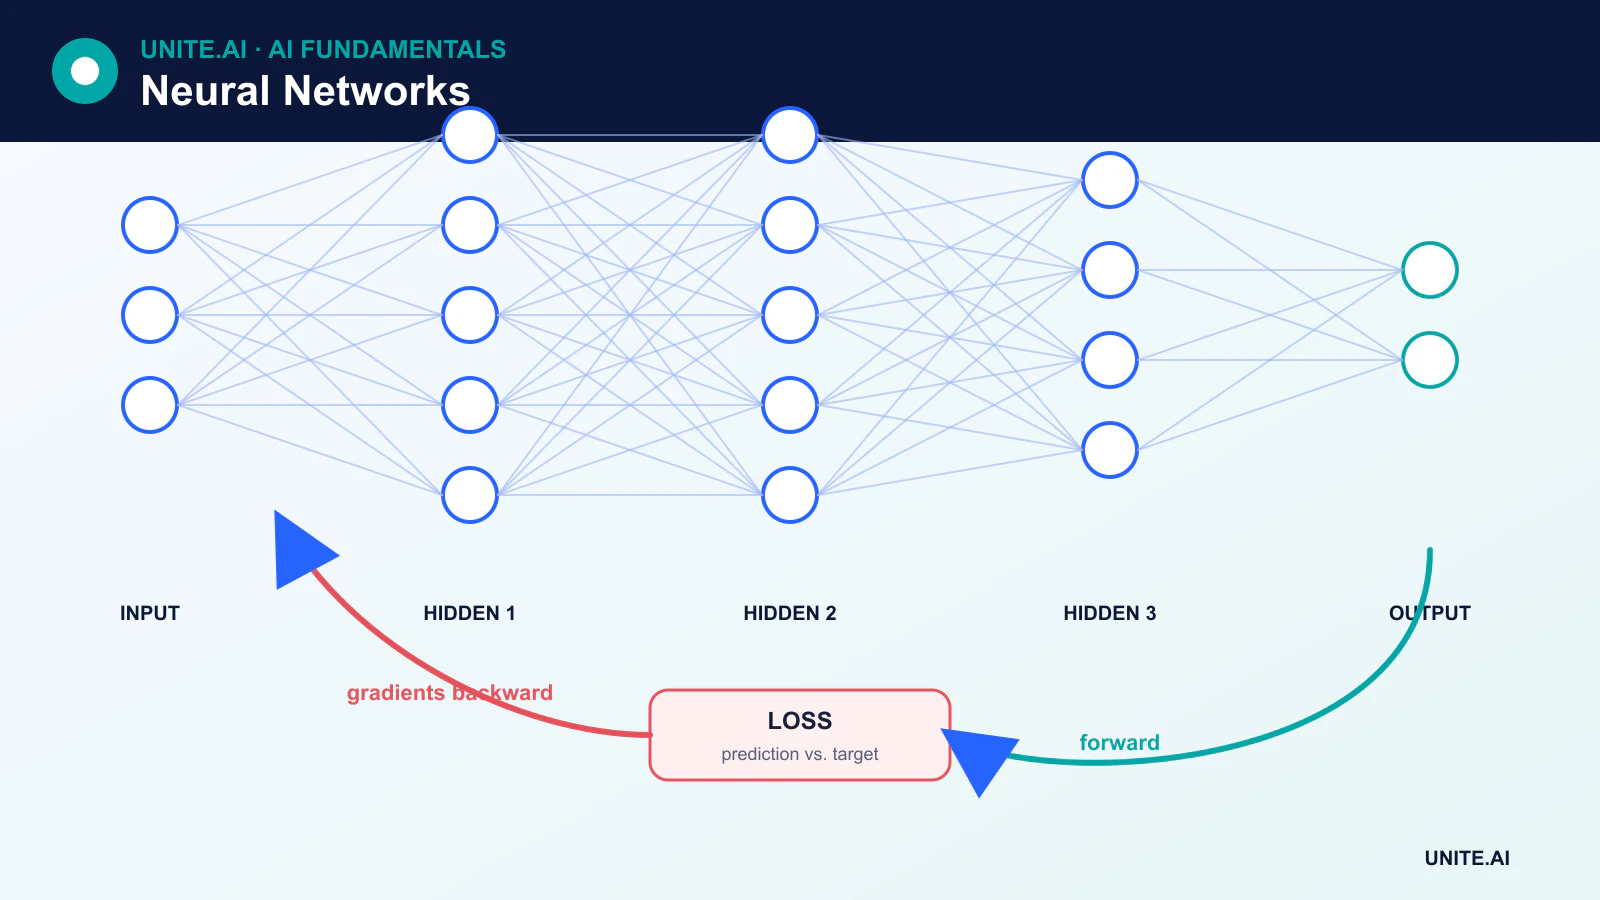
- 前向传播生成预测;损失函数衡量误差;反向传播计算梯度;优化器更新参数。
- 多层感知器(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)和Transformer以不同方式组织连接。
- 更多层或参数并不必然产生更好或更可信的模型。
从单个人工神经元到网络
对于输入向量 x,基本单元计算:
z = Wx + boutput = activation(z)
W 包含可训练的权重,b 是可训练的偏置。激活函数引入非线性。权重本身不会“直接通过”激活函数;激活函数作用于加权和以及偏置。
多层感知器(MLP)堆叠密集层。输入层表示特征,隐藏层对其进行转换,输出层根据任务进行设计——例如类别 logits 或回归值。
神经网络如何学习
- 模型初始化可训练参数。
- 前向传播处理一个批次并产生预测。
- 损失函数将预测与训练目标进行比较。
- 反向传播 使用链式法则计算梯度。
- 优化器(如随机梯度下降或 AdamW)更新权重和偏置。
反向传播通过数十年的研究与推广,成为神经网络训练的核心;它并非在近期的深度学习时代首次出现。现代框架实现了反向模式自动微分,使实践者无需手动推导每个梯度。
激活函数为何重要
如果没有非线性激活函数,多个普通线性层会合并为一个线性变换。ReLU 因其简洁高效而被广泛使用。GELU 和 SiLU 在现代架构中也很常见。Sigmoid 和 softmax 在特定输出解释中仍有用处,但 sigmoid 在隐藏层可能饱和,导致梯度消失。
主要神经网络架构
卷积神经网络
卷积神经网络 在局部邻域上应用学习到的滤波器,并在不同位置共享参数。这些特性使其在图像及其他网格状信号上效率极高。
循环网络
循环神经网络(RNN)、长短期记忆网络(LSTM)和门控循环单元(GRU) 在序列上更新隐藏状态。它们在流式和时间序列任务中仍然有用,尽管循环结构限制了并行处理,并且在处理长期依赖时可能表现不佳。
Transformer
Transformer 使用注意力机制生成上下文相关的表示。残差连接、归一化、位置信息和前馈块是其核心组成部分。Transformer 现在支撑着许多大型语言模型和多模态模型。
自编码器与生成网络
自编码器 通过重构学习表示。生成对抗网络(GAN)、扩散模型和自回归网络使用不同的目标和训练方式生成新样本。
使深度网络可训练的组件
现代系统不仅仅依赖层和激活函数。残差连接使信息和梯度能够绕过块。归一化稳定激活。正则化、数据增强、Dropout 和权重衰减可以降低过拟合。嵌入层将离散项(如 token)映射为向量。注意力机制使表示能够动态依赖其他元素。
优势与局限性
神经网络能够从高维原始数据中学习特征,并随数据量和计算资源的增加而扩展。然而,它们可能需要大量数据、专用硬件以及精细调参。其预测可能校准不足,在分布漂移时脆弱,易受对抗性攻击,且难以解释。
模型架构应符合任务和部署约束。对于许多表格数据问题,树集成或线性模型可能更快且更易验证。对于高风险应用,模型性能必须按子群体和失效模式进行评估,而不仅仅是整体基准。
层、激活和信息流
神经网络由参数化函数组成。每个单元对输入进行加权组合,加入偏置,并通过激活函数(如 ReLU、sigmoid、tanh 或 GELU)传递结果。堆叠层能够实现层次特征和非线性决策边界。宽度控制每层的单元数;深度控制连续的变换;连接方式和权重共享决定架构。网络输出取决于预处理、参数、归一化以及推理模式的综合作用。神经元是一种数学运算,而非字面上的生物神经元或独立有意义的概念。
前向传播计算预测;损失函数量化误差;反向传播利用链式法则计算梯度;优化器更新参数。初始化、学习率、批次统计、残差路径和归一化会影响梯度是消失、爆炸还是保持有用。正则化包括权重衰减、Dropout、数据增强、提前停止以及架构约束。绘制训练和验证曲线,检查梯度和激活统计,并比较多次运行。大型网络可能记住训练数据,而小型网络可能欠拟合或遗漏必要的结构。
架构选择、评估与部署
多层感知器处理固定向量;卷积网络利用局部结构;循环和状态空间模型处理序列;Transformer 使用注意力;图网络沿边缘交换信息。混合模型很常见。选择时需考虑归纳偏置、数据、序列或图像大小、延迟、内存、可解释性以及可用硬件。与线性或树基线进行比较,并通过消融实验了解哪些复杂度重要。仅凭参数数量并不能预测质量、推理成本或数据需求。
部署需要冻结的预处理、导出或编译后的计算图、数值验证以及在真实负载下的资源测试。量化和剪枝可以减小体积,但可能影响罕见类别的行为。监控输入、输出、校准、延迟和确认结果;对抗性和分布漂移数据也需测试。通过签名制品、访问控制和供应链审查来保护模型、依赖和数据。对单个激活或显著性进行解释需要因果和行为验证。神经网络是灵活的函数近似器,但并不保证理解、真实性或鲁棒性。
案例示例:神经需求预测模型
零售商根据销售、促销、价格、节假日、库存可用性和天气预测每周商品需求。使用滚动时间切分,将网络模型与季节性朴素、线性和树基线进行比较。仅在预测时真正已知的未来促销会被纳入,而缺货会被建模,因为观测到的销量可能低估需求。评估采用加权绝对误差、偏差、区间覆盖率,以及按商品周转率和门店划分的结果。
部署流水线的版本包括特征可用性、模型和预测时段,并在必要输入陈旧时拒绝生成预测。计划者可查看区间并以记录的理由进行覆盖。监控能够检测缺失的数据流、误差变化、偏差以及异常预测;业务结果与预测准确度分离,因为订货策略也影响库存。模型更新会在多个周期中进行影子部署,先前的预测器在季节性或供应商中断时仍可回滚使用。
实施证据与运营准备
生产决策需要的不仅是成功演示。需明确预期用户、运行环境、输入、输出、依赖、负责人以及每类关键故障的后果。在调优前建立可复现的基线和带版本号的评估集。测试常规情况、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用,以及最可能被忽视的群体或环境。衡量任务质量时同时考虑校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全。记录每一次转换和阈值,以便独立审阅者能够复现结果,并将证据与诱人的原型区分开来。
上线前,需明确发布、例外、变更、回滚和退役的责任人。采用分阶段发布,保留安全回退,并通过人为注入故障验证监控。运营遥测应展示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及确认结果,且不收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线表现会持续。每当数据源、用户、模型、供应商、政策、硬件或目标发生变化时,都需重新评估。维护中的系统还需要有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
每个神经网络都是深度学习吗?
不是。只有一个隐藏层的小网络仍算神经网络,而深度学习通常指具有多个学习处理阶段的架构。其界限是约定性的,而非严格的科学阈值。
神经网络会存储其训练数据吗?
它们只存储学习得到的参数,而不是可检索的原始数据副本。然而,大模型可能记住并复现单个训练样本,这会带来隐私和版权风险,需要进行测试。
主要参考文献