
Основи ШІ
Що таке машинне навчання?

 Додайте Unite.AI до бажаних джерел у Google
Машинне навчання (ML) — це галузь штучного інтелекту, у якій система вивчає закономірності з даних, щоб робити прогнози, класифікації, рекомендації або приймати рішення без того, щоб розробник писав окреме правило для кожного можливого випадку. Результат — не машина, яка «думає» як людина. Це статистична модель, яка відображає вхідні дані у корисні вихідні дані і може оцінюватися на даних, яких вона не бачила під час навчання.
Машинне навчання входить до ширшої галузі ШІ, тоді як глибоке навчання — це сімейство методів машинного навчання, побудованих навколо багатошарових нейронних мереж. Це розрізнення має значення: не кожна система ШІ використовує машинне навчання, і не кожна задача машинного навчання вимагає нейронної мережі.
Ключові висновки
- ML вивчає залежність з прикладів, а не лише спирається на вручну написані правила.
- Корисна модель повинна узагальнюватися на нові дані, а не просто запам’ятовувати навчальний набір.
- Контрольоване, неконтрольоване, напівавтоматичне, самоконтрольоване та підкріплювальне навчання вирішують різні типи задач.
- Якість даних, дизайн оцінювання та моніторинг так само важливі, як і алгоритм.
Як працює машинне навчання
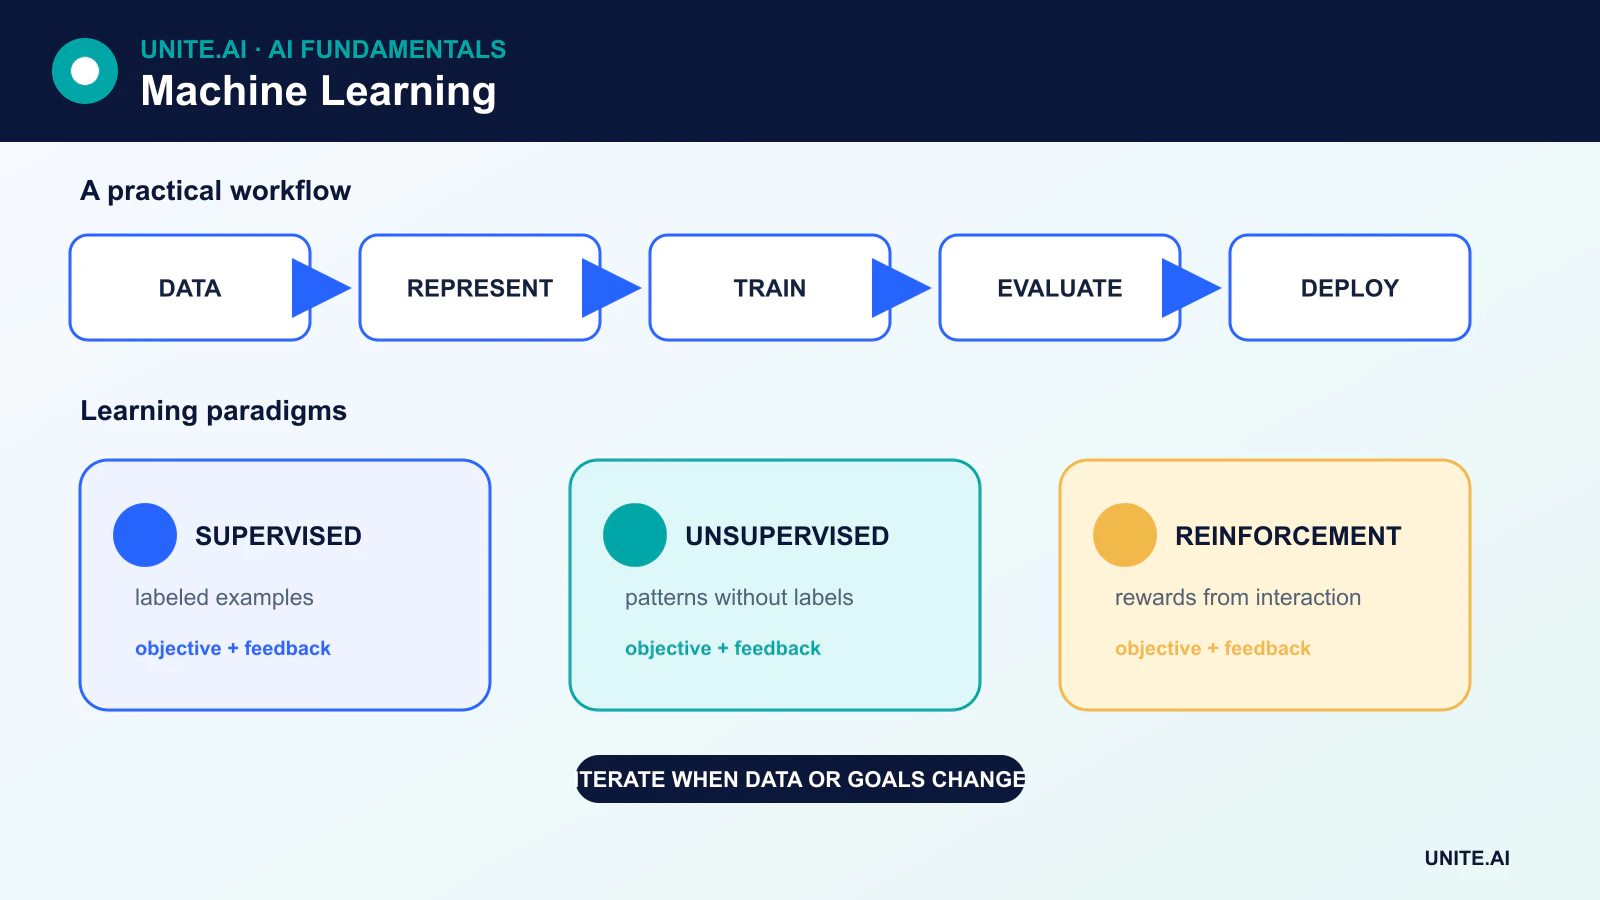
Більшість проєктів машинного навчання можна розглядати як послідовність шести етапів:
- Визначити задачу. Вирішити, що система повинна передбачати або виявляти і що означає успіх у реальному застосуванні.
- Збирати та підготовлювати дані. Очищати записи, обробляти пропущені значення, створювати корисні ознаки та документувати джерело даних.
- Розділити дані. Навчальний набір використовується для підгонки моделі, валідаційний набір допомагає вибрати налаштування, а тестовий набір дає остаточну оцінку на невикористаних даних.
- Навчити модель. Алгоритм коригує параметри моделі, щоб зменшити функцію втрат або задовольнити іншу навчальну мету.
- Оцінити узагальнення. Метрики мають відображати задачу, баланс класів, вартість помилок та популяцію, на якій модель працюватиме.
- Розгорнути та моніторити. Дані у реальному світі можуть змінюватися, тому команди стежать за зсувом, погіршенням продуктивності, упередженістю та операційними збоями.
Змінні, що подаються в модель, зазвичай називаються ознаками. У контрольованому навчанні бажана відповідь називається міткою або цільовою змінною. Параметри, які навчає модель, кодують залежність між ознаками та виходом; це не база даних явних правил.
Основні парадигми навчання
Контрольоване навчання
У контрольованому навчанні приклади містять і вхідні дані, і відомі цілі. Класифікаційна модель передбачає категорії, наприклад, чи є транзакція шахрайською. Регресійна модель передбачає безперервне значення, наприклад, очікуваний попит на енергію.
Серед поширених контрольованих алгоритмів — дерева рішень, метод опорних векторів, K‑найближчих сусідів, лінійна та логістична регресія, градієнтно‑усилені дерева та нейронні мережі. Порог класифікації, наприклад 0,5, — це рішення, обране після того, як модель отримала оцінку або ймовірність; це не незмінна властивість логістичної регресії.
Неконтрольоване навчання
Неконтрольоване навчання працює з даними, які не містять міток цілей. Метою може бути пошук кластерів, виявлення аномальних спостережень, оцінка розподілу або створення низьковимірного представлення. Кластер — це група, запропонована правилом схожості; вона не обов’язково відповідає реальному значущому класу.
Прикладами є кластеризація K‑means, аналіз головних компонент, оцінка густини та деякі форми автокодерів. Автокодер навчається відтворювати вхід через стиснуте представлення. Він не створює автоматично мітки істинної правди.
Напівавтоматичне та самоконтрольоване навчання
Напівавтоматичне навчання поєднує невеликий набори мічених даних з більшим набором немічених. Самоконтрольоване навчання створює навчальний сигнал з самих даних — наприклад, передбачаючи замасковані слова або порівнюючи два трансформовані вигляди одного зображення. Самоконтроль є центральним у багатьох сучасних конвеєрах трансформерів та фундаментальних моделей, оскільки дозволяє використовувати великі колекції тексту, зображень, аудіо чи відео без ручного маркування кожного прикладу.
Підкріплювальне навчання
У підкріплювальному навчанні агент виконує дії в середовищі та отримує нагороди або витрати. Мета — навчити політику, що максимізує очікувану сукупну нагороду. Це відрізняється від контрольованого навчання, оскільки правильна дія не надається для кожного стану, і дія може впливати на те, які дані агент отримає далі.
Навчання, валідація та узагальнення
Модель, яка добре працює на навчальних прикладах, може все ж провалитися на нових даних. Така помилка називається перенавчанням. Команди зменшують його за допомогою відповідної місткості моделі, регуляризації, крос‑валідації, аугментації даних, запобігання витоку та справжнього незалежного тестового набору.
Для кожної задачі машинного навчання немає єдиної метрики. Для класифікації можуть знадобитися точність, повнота, F1, калібрування або вимір, зважений за вартістю, замість простої точності. Для регресії можуть використовуватись середня абсолютна помилка, корінь середньоквадратичної помилки або специфічна для галузі функція втрат. Для кластеризації потрібні різні форми внутрішньої чи зовнішньої валідації. Метрика повинна відображати, що означає помилка для користувача чи організації.
Алгоритми машинного навчання — це інструменти, а не гарантії
Алгоритм несе в собі припущення. Лінійні моделі передбачають певну форму залежності. K‑найближчих сусідів передбачає, що обрана відстань відображає значущу схожість. Наївний Байес припускає, що ознаки умовно незалежні за даних класу. Дерева рішень розбивають простір ознак, використовуючи вивчені правила розбиття; їх листки містять прогнози, засновані на групах навчальних спостережень, а не обов’язково на одній спостереженні.
Вибір моделі залежить від розміру даних, типів ознак, вимог до затримки, потреб у інтерпретованості та вартості помилок. Простішу модель може перевершити більшу, коли дані обмежені або операційні обмеження вимагають швидкості та прозорості.
Де використовується машинне навчання
ML підтримує ранжування пошуку, рекомендації, прогнозування, виявлення аномалій, переклад, розпізнавання мови, комп’ютерний зір, передбачувальне обслуговування, виявлення шахрайства та науковий аналіз. Ті ж техніки можуть посилювати історичні упередження, розкривати конфіденційну інформацію або поводитися непередбачувано при зсуві розподілу. Відповідальне розгортання вимагає документації, людського контролю за потреби, тестування безпеки та постійного моніторингу.
Від визначення проблеми до валідного експерименту машинного навчання
Проєкт машинного навчання має розпочинатися з рішення та вимірюваного результату, а не з алгоритму. Визначте одиницю прогнозу, ціль, час спостереження, час прийняття рішення, доступні ознаки та вартість кожної помилки. Наприклад, у моделі відтоку використання подій, записаних після скасування, призведе до витоку відповіді. Встановіть просте правило або статистичну базу, а потім розділіть дані за часом, клієнтом, місцем або іншим критерієм, що відображає розгортання. Випадкові розподіли рядків можуть розмістити майже ідентичні спостереження у навчальному та тестовому наборах, створюючи оманливу оцінку.
Інженерія ознак перетворює сирі записи у представлення, які може використовувати модель, проте кожна ознака потребує походження та гарантії доступності. Нормалізацію, словник, імпутацію та зменшення розмірності слід підганяти лише на навчальних даних, а потім застосовувати вивчене перетворення до валідаційних та тестових даних. Крос‑валідація оцінює варіації між зразками; остаточний незмінений тестовий набір підтримує рішення про випуск. Обирайте метрики за наслідками: точність і повноту для нерівномірних помилок класифікації, калібрування, коли ймовірності керують дією, та виміри, зважені за вартістю чи корисністю, коли помилки мають різний операційний вплив.
Розгортання, моніторинг та відповідальна експлуатація
Виробниче інференсування повторює повне перетворення, виконане під час навчання, і повертає прогноз в межах обмежень затримки, пропускної здатності та доступності. Пакуйте передобробку разом з моделлю, перевіряйте схеми вхідних даних, версіонуйте артефакти та порівнюйте результати між офлайн‑ та сервісними реалізаціями. Обирайте поріг, орієнтуючись на операційну місткість та компроміс помилок, а не за замовчуванням 0,5. Впроваджуйте через тіньове оцінювання, обмежену когорту або експеримент з метриками‑запобіжниками. Зберігайте детермінований резервний варіант та шлях відкату у випадку збою залежності або неприйнятної поведінки.
Слідкуйте за якістю вхідних даних, зсувом ознак, розподілом прогнозів, калібруванням, результатами підгруп, затримкою, вартістю та підтвердженими мітками, коли вони з’являться. Зсув — це сигнал для розслідування, а не автоматичний доказ, що перенавчання допоможе. Перенавчання потребує переглянутих даних, повторюваних тестів, схвалення та порівняння з поточним лідером. Документуйте передбачувані та недопустимі використання, права на дані, конфіденційність, безпеку, людське втручання та апеляції, коли люди постраждають. Машинне навчання — це підтримувана система прийняття рішень; файл моделі — лише один замінний компонент.
Практичний приклад: прогнозування відмови обладнання
Виробник визначає один прогноз на машину‑день: чи відбудеться підтверджена відмова протягом семи днів, використовуючи лише телеметрію, доступну на початку цього дня. Дані розділяються за машиною та часом, порівнюються з правилами, заснованими на віці та порогах, передобробка підганяється на навчальних даних, а оцінюються відгук подій, хибні тривоги, час попередження, калібрування та потужність обслуговування. Заміну датчиків та планові вимкнення моделюються як операційний контекст, а не як звичайні спостереження.
Модель спочатку працює в тіньовому режимі. Сповіщення показують відповідну телеметрію та невизначеність, але обслуговуючі вирішують, чи проводити інспекцію. Висновки та підтверджені причини стають керованими мітками; відсутність робочого замовлення не вважається означенням відсутності відмови. Поетапне розгортання використовує обмеження сповіщень та ручний резерв, а моніторинг відстежує стан датчиків, зсув вхідних даних, переглянуту точність, простій та непотрібне обслуговування. Перенавчання відбувається лише після того, як перегляд даних та порогів продемонструє ймовірне поліпшення порівняно з поточною розгорнутою системою.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої відмови. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаються без належної підтримки. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та відсторонення. Використовуйте поетапне розгортання, зберігайте безпечний резерв та перевіряйте моніторинг шляхом навмисного внесення збоїв. Операційна телеметрія повинна виявляти якість вхідних даних, поведінку виходу, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переглядайте знову, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Основні джерела












