Основи ШІ
Що таке метод опорних векторів?

 Додайте Unite.AI до бажаних джерел у Google
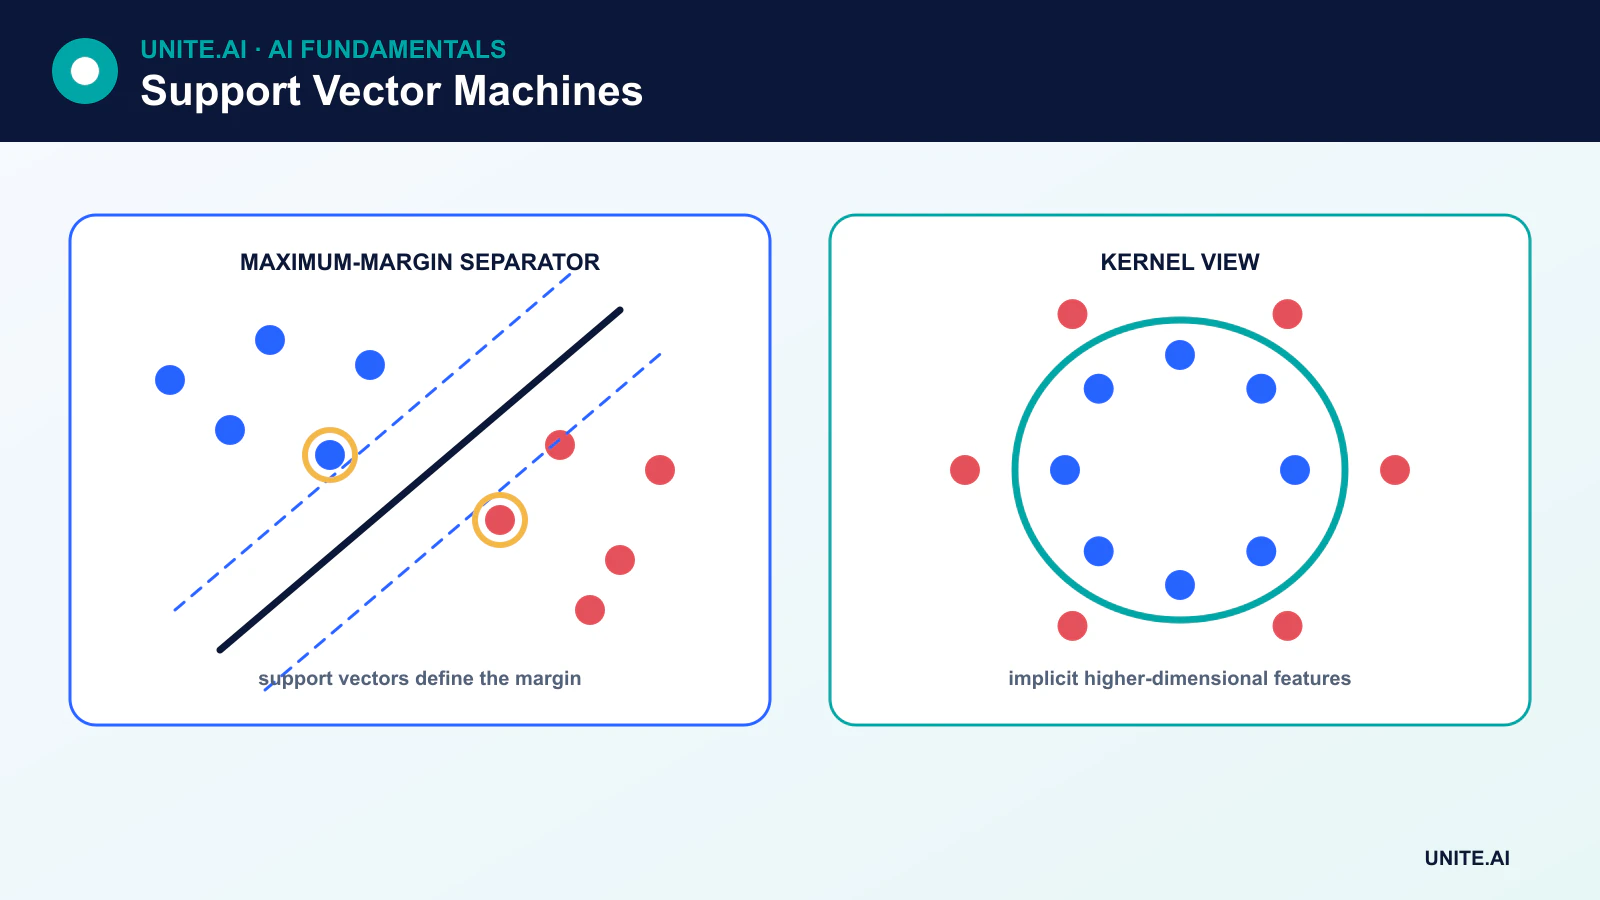
Метод support vector machine (SVM) — це метод навчання з учителем, який знаходить межу рішення з максимально можливою відстанню між класами. Приклади навчання, що визначають цю межу, називаються support vectors.
SVM можуть виконувати лінійне або нелінійне класифікування, регресію та виявлення нових (аномальних) даних. Вони особливо корисні для малих та середніх наборів даних з інформативними ознаками, включаючи високовимірні розріджені дані, проте їхня вартість навчання може стати непрактичною на дуже великих наборах даних.
Ключові висновки
- SVM максимізує мінімальну відстань між межею та найближчими навчальними точками.
- Опорні вектори — це дані, а не додаткові гіперплощини.
- Параметр C балансує ширину відступу проти штрафів за порушення.
- Ядра обчислюють схожість у неявному просторі ознак без явного формування кожної трансформованої ознаки.
Ідея максимального відступу
Для лінійного бінарного класифікатора межа рішення є гіперплощиною:
w · x + b = 0
Вектор w визначає орієнтацію, а b — зсув. Багато гіперплощин можуть розділяти навчальні класи. SVM обирає ту, яка максимізує відстань до найближчих прикладів з обох боків. Ці найближчі приклади — це опорні вектори, і вони мають найбільший вплив на сформовану межу.
Мета не полягає у максимізації відстані від межі до кожної точки окремо. Вона максимізує мінімальний відступ, задовольняючи або штрафуючи обмеження класів.
Жорсткі та м’які відступи
SVM з жорстким відступом вимагає ідеального лінійного розділення і чутливий до викидів. Реальні набори даних зазвичай потребують м’якого відступу, який вводить змінні «slack» для спостережень, що знаходяться всередині відступу або з неправильного боку межі.
Гіперпараметр C контролює штраф за ці порушення:
- Більше значення C сильніше штрафує порушення і часто створює вужчий відступ, який точніше слідує навчальним прикладам.
- Менше значення C дозволяє більше порушень в обмін на ширший, більш регуляризований відступ.
Кількість опорних векторів визначається даними та розв’язком; збільшення C не гарантує певної кількості опорних векторів.
Трюк з ядром
Деякі класи неможливо розділити прямою гіперплощиною у початковому просторі ознак. Ядро обчислює скалярний добуток, що відповідає іншому простору ознак. Це дозволяє SVM підлаштовувати нелінійну межу без явного обчислення кожної трансформованої координати.
Загальні ядра включають:
- Лінійне: ефективне для високовимірних розріджених ознак, таких як текст.
- Поліноміальне: моделює взаємодії до заданого ступеня.
- Радіальна базисна функція (RBF): створює гнучкі локальні межі на основі відстані.
- Сигмоїдне: схоже на нейронну активацію, але рідше використовується за замовчуванням.
Для RBF‑SVM параметр gamma контролює, наскільки локально кожен навчальний приклад впливає на межу. Велике значення gamma може створювати надто деталізовані області та призводити до перенавчання; маленьке gamma забезпечує більш гладкий вплив.
Багатокласова класифікація
Класична цільова функція SVM є бінарною. Бібліотеки розширюють її, використовуючи стратегії, такі як one-vs-rest, яка навчає один класифікатор для кожного класу, або one-vs-one, яка навчає класифікатори для пар класів і комбінує їх рішення. Багатокласові SVM не просто малюють на одну лінію менше, ніж кількість класів.
Регресія опорних векторів та одно‑класовий SVM
Регресія опорних векторів (SVR) підбирає функцію, ігноруючи помилки всередині ε‑широкої трубки та штрафуючи більші відхилення. Одно‑класовий SVM оцінює межу навколо типових даних і може підтримувати виявлення нових (аномальних) випадків. Незвичний пункт не обов’язково є шахрайством чи збоям; він просто є незвичним у межах підгоненої моделі.
Практичні вимоги
SVM залежать від відстаней та скалярних добутків, тому числові ознаки зазвичай потребують масштабування. Параметри C, ядро, gamma та ваги класів слід підбирати за допомогою валідації. Оцінки ймовірності не є вбудованими в відступ і часто вимагають калібрування, що додає витрат і має оцінюватися окремо.
Навчання ядрових SVM може масштабуватись від квадратичного до кубічного часу залежно від кількості зразків, даних та реалізації. Варіанти лінійних SVM або стохастичні лінійні моделі краще підходять для дуже великих наборів даних. Для необроблених зображень, аудіо або тексту більш ефективними можуть бути представлення, отримані за допомогою глибокого навчання, хоча SVM все ще може класифікувати фіксоване вбудовування.
Переваги та обмеження SVM
SVM можуть добре працювати з великою кількістю ознак, пропонують чітку регуляризовану цільову функцію та в основному залежать від опорних векторів під час передбачення. Обмеження включають чутливість до масштабування та гіперпараметрів, потенційно дорогі процеси навчання, знижений рівень інтерпретованості при нелінійних ядрах та вимоги до калібрування ймовірностей.
Відступи, ядра та цільова функція оптимізації
Метод опорних векторів шукає розділяючу гіперплощину з великим відступом між класами. Лише опорні вектори, розташовані на межі або всередині відступу, визначають цю межу. SVM з м’яким відступом вводять змінні slack для перекриття та помилково позначених точок; параметр C обмінює ширший відступ проти порушень під час навчання. Вхідні дані зазвичай треба масштабувати, оскільки рішення базується на відстанях і скалярних добутках. Ваги класів або ресемплінг допомагають, коли вартість помилок і їх частота різняться, проте пороги та ймовірності все одно потребують незалежної валідації.
Трюк з ядром оцінює схожість так, ніби вхідні дані відображаються у простір більшої розмірності. Лінійні, поліноміальні, радіально‑базисні та спеціалізовані ядра кодують різні припущення. Для RBF‑ядра gamma контролює, наскільки локально кожна точка впливає на межу: велике gamma може створювати складні області та призводити до перенавчання, тоді як мале gamma може викликати недонавчання. Ядрові матриці зростають квадратично зі збільшенням кількості зразків, що робить нелінійні SVM дорогими на великих наборах даних. Лінійні розв’язувачі або приблизні карти ознак часто кращі при масштабуванні.
Використання багатокласових моделей, калібрування та операційні обмеження
Бінарні SVM розширюються до багатокласових за допомогою one-vs-rest, one-vs-one або структурних формулювань. Гіперпараметри потрібно налаштовувати в межах крос‑валідації, використовуючи групові або часові розбиття за потреби. Оцінюйте точність та повноту для кожного класу, розподіл відступів, калібрування та стійкість до зсуву даних. Сирові оцінки рішень не є ймовірностями; масштабування Платта або ізотонічне калібрування використовують окремі дані і можуть погіршуватись, якщо змінюється частота класів. Порівнюйте з логістичною регресією, деревами та сучасними методами, що базуються на представленнях, при однакових зусиллях попередньої обробки та налаштування.
Для обслуговування потрібні точний скейлер, порядок ознак, параметри ядра, опорні вектори та мапа класів. Вартість передбачення для ядрового SVM зростає зі збільшенням кількості опорних векторів, тому вимірюйте затримку та пам’ять на реальних пакетах. Вхідні дані, що суттєво відрізняються від навчальних, можуть все ж отримувати впевнені мітки; додавайте перевірки поза розподілом або політику відмови, коли це доцільно. Перевіряйте помилки на предмет чутливих проксі та артефактів набору даних. SVM залишаються потужними для середньо‑розмірних, високовимірних задач, проте максимальний геометричний відступ не є доказом причинної структури чи безпеки.
Практичний приклад: SVM для рідкісного маршрутування документів
Команда юридичних операцій класифікує короткі документи за категоріями маршрутизації, використовуючи ознаки TF–IDF та лінійний SVM. Вона розбиває дані за справою та часом, щоб уникнути витоку шаблонів, масштабує ваги класів відповідно до вартості помилок, і налаштовує C у вкладеній валідації. Лінійна модель порівнюється з логістичною регресією та трансформером. Точність, повнота, калібрування та навантаження на рецензентів для кожного класу важливіші за загальну точність.
Оцінки рішень калібруються на окремих даних, а документи з низьким відступом або неподтримуваною мовою надходять у ручну обробку. Артефакт обслуговування включає токенізатор, словник, ваги, модель, калібрування та мапу міток. Моніторинг відстежує нові терміни, частоту категорій, відступи та виправлені маршрути. Документи та опорні вектори захищені, оскільки текстові ознаки можуть розкривати конфіденційну інформацію. Нелінійне ядро відхиляється, коли його незначне підвищення якості не виправдовує затримку, пам’ять та вартість інтерпретованості.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, відповідального та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені або відсутні дані, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які можуть залишитися без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити доказ від привабливого прототипу.
Перед запуском призначте відповідальних за випуск, винятки, зміни, відкат та завершення. Використовуйте поетапний випуск, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку вихідних результатів, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑результати залишаться незмінними. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткої точки, в якій її слід вимкнути або замінити.
Часті запитання
Чи виконують SVM лише класифікацію?
Ні. Регресія опорних векторів передбачає безперервні цілі, а одно‑класовий SVM може оцінювати межу новизни. Кожен варіант має іншу цільову функцію та набір гіперпараметрів.
Коли лінійний SVM є хорошим вибором?
Лінійні SVM часто ефективні для високовимірних розріджених ознак, включаючи традиційні текстові представлення, коли гнучке ядро додавало б витрати без явної вигоди.
Основні джерела