
Основи ШІ
Що таке глибоке навчання?

 Додайте Unite.AI до бажаних джерел у Google
Deep learning — це сімейство методів машинного навчання, які використовують нейронні мережі з кількома обробними шарами для навчання корисних представлень даних. Ці моделі живлять багато сучасних систем для мови, зображень, аудіо, рекомендацій, наукових прогнозів та генеративного ШІ.
Слово deep стосується кількості перетворень між вхідними та вихідними даними, а не до машини, що має глибше розуміння. Глибока модель навчає числові взаємозв’язки, корисні для її цілі навчання, і її продуктивність все одно треба перевіряти на нових даних.
Ключові висновки
- Глибоке навчання є підмножиною машинного навчання.
- Шари перетворюють тензори, використовуючи навчені параметри, нелінійні активації, нормалізацію та інші операції.
- Зворотне поширення (backpropagation) обчислює градієнти; оптимізатор використовує ці градієнти для оновлення навчальних параметрів, включаючи ваги та зміщення.
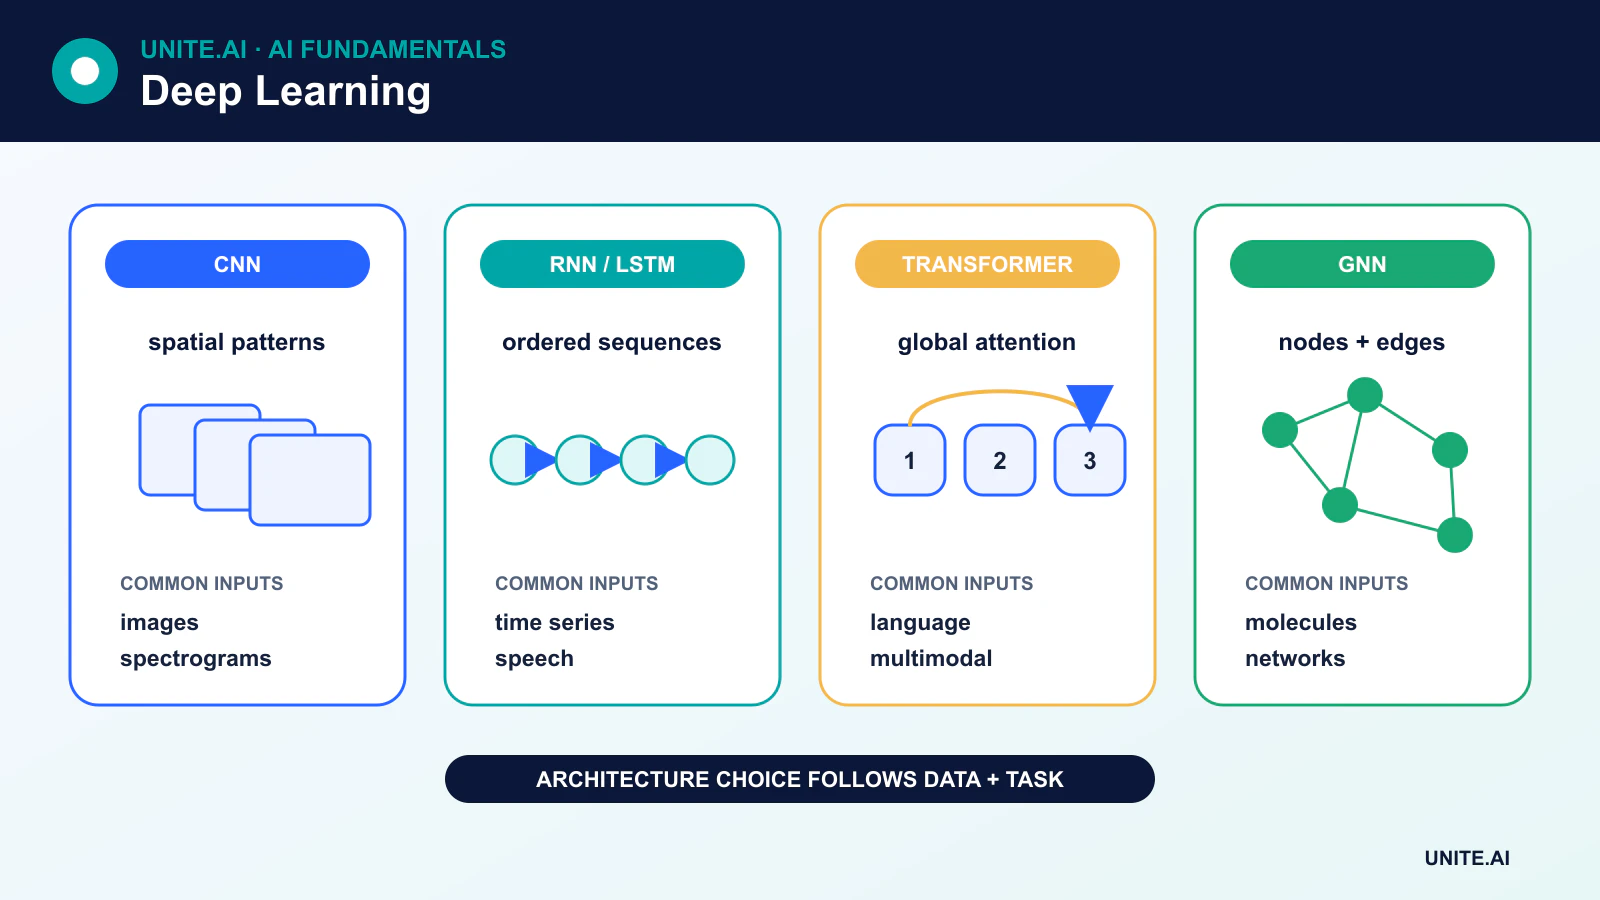
- CNN, рекурентні мережі, трансформери, автокодери та дифузійні моделі мають різні структури та сильні сторони.
Як навчається глибока нейронна мережа
Нейронна мережа отримує дані у вигляді тензорів, або багатовимірних масивів чисел. Тензор зображення може кодувати канали пікселів, тоді як мовна модель використовує вектори, що представляють токени. Кожен шар виконує диференційоване перетворення і передає результат наступному шару.
У базовому щільному шарі модель обчислює зважену суму своїх входів, додає навчальне зміщення і потім застосовує функцію активації:
output = activation(Wx + b)
Функція активації вводить нелінійність. Без неї стекування звичайних лінійних шарів все одно представляло б лише лінійне перетворення. ReLU та його варіанти поширені у прихованих шарах, тоді як активації виходу залежать від завдання.
Навчання зазвичай включає чотири кроки:
- Прямий прохід (forward pass) генерує передбачення.
- Функція втрат (loss function) вимірює, наскільки передбачення відрізняються від цілі.
- Зворотне поширення (Backpropagation) застосовує правило ланцюга для обчислення градієнта втрат щодо кожного навчального параметра.
- Оптимізатор, такий як стохастичний градієнтний спуск або AdamW, оновлює параметри.
Повторення цих кроків над багатьма пакетами може покращити модель, проте нижчі втрати під час навчання не гарантують надійної поведінки у реальному світі. Валідація, регуляризація, представницькі дані та моніторинг залишаються необхідними.
Основні архітектури глибокого навчання
Багатошарові перцептрони
Багатошаровий перцептрон (MLP) використовує повністю зв’язані шари, у яких кожен вихідний елемент залежить від усіх входів попереднього шару. MLP корисні для табличних ознак і як компоненти у більших системах, проте вони не вбудовують припущень про локальність зображень чи порядок послідовності.
Конволюційні нейронні мережі
Конволюційні нейронні мережі (CNN) застосовують навчені фільтри до локальних областей. Спільне використання ваг робить їх ефективними для сіток, таких як зображення та спектрограми. CNN залишаються важливими для комп’ютерного зору та розгортання на краю, хоча трансформери зору та гібридні моделі також широко використовуються.
Рекурентні мережі, LSTM та GRU
Рекурентні нейронні мережі (RNN) оновлюють прихований стан під час обробки послідовності. LSTM та gated recurrent units допомагають зберігати інформацію та зменшують проблему зникання градієнта, яка ускладнює роботу базових RNN з довгими залежностями. Вони не усувають усі обмеження довгого контексту, проте залишаються корисними для потокових сигналів, часових рядів та компактних послідовних моделей.
Трансформери
Трансформери використовують увагу для моделювання взаємозв’язків між елементами послідовності або набору. Їхня здатність паралельно обробляти багато позицій допомогла їм замінити рекуренцію у більшості великих мовних систем, а варіанти трансформерів тепер обробляють зображення, аудіо, відео, білки та мультимодальні дані.
Автокодери та генеративні моделі
Автокодер стискає вхід у представлення і відновлює вхід з нього. Це створює самостійно навчальну задачу реконструкції; вона не перетворює немічені дані автоматично у мічені приклади.
Генеративні змагальні мережі навчають генератор і дискримінатор у конкуренції. Дифузійні моделі навчаються інвертувати поступовий процес шумування. Автокореляційні трансформери генерують один токен або одиницю за раз. Ці підходи мають різну динаміку навчання, контрольованість та вимоги до обчислень.
Чому глибина допомагає — і чому важлива архітектура
Кілька шарів дозволяє моделі комбінувати простіші перетворення у складніші. У візуальних системах деякі навчені ознаки можуть прогресувати від локальних текстур до специфічних для завдання патернів. У мовних моделях шари уваги будують контекстно-залежні представлення токенів. Ці описи є корисними інтуїціями, а не жорсткими правилами того, що кожен шар має навчати.
Сучасні мережі також спираються на залишкові зв’язки, нормалізацію, ретельну ініціалізацію, регуляризацію та оптимізоване обладнання. Простіше додавання шарів або параметрів може ускладнити навчання, сповільнити роботу або підвищити схильність до перепідгонки. Масштаб моделі допомагає лише тоді, коли дані, ціль, оптимізація та умови розгортання це підтримують.
Навчання проти інференсу
Навчання коригує параметри і зазвичай є обчислювально інтенсивним етапом. Інференс запускає навчену модель для отримання вихідного результату. Інференс може залишатися дорогим для великих моделей, саме тому команди використовують квантування, дистиляцію, пакетування, кешування, розрідженість і спеціалізоване обладнання, таке як нейронні процесорні блоки.
Обмеження та відповідальне використання
Глибокі моделі можуть успадковувати упередження, запам’ятовувати конфіденційну інформацію, погано працювати при зсуві розподілу та генерувати переконливі, але неправильні результати. Вони також можуть бути важкими для інтерпретації та дорогими у навчанні. Оцінка повинна охоплювати більше, ніж середнє за бенчмарком: командам потрібна продуктивність за класами чи підгрупами, стійкість, калібрування, безпека, затримка, енергоспоживання та наслідки відмов.
Представлення, оптимізація та вибір архітектури
Глибокі мережі навчаються послідовним представленням через параметризовані шари. Лінійні перетворення змішують входи; нелінійні активації дозволяють мережі апроксимувати складні функції; нормалізація та залишкові зв’язки допомагають оптимізації; увага, згортка, рекуренція або операції станового простору кодують різні структурні припущення. Глибина збільшує кількість перетворень, а не гарантовану інтелектуальність. Архітектура повинна відповідати модальності, об’єму даних, вимогам до затримки, пам’яті та інваріантностям завдання. Менша конволюційна модель може перевершити трансформер, коли даних мало і домінує локальна просторово‑структурна інформація.
Навчання обчислює втрати, диференціює їх за допомогою зворотного поширення та оновлює параметри оптимізатором, таким як стохастичний градієнтний спуск або Adam. Розмір пакету, швидкість навчання, графік, ініціалізація, регуляризація та числова точність взаємодіють. Криві навчальних і валідаційних втрат допомагають розрізнити недонавчання, перепідгонку, нестабільність та витік, проте вони не встановлюють реальну корисність. Використовуйте незалежний оцінковий набір, повторні запуски, коли важлива варіативність, абляції та порівняння з простішими базовими моделями. Велика кількість параметрів також підвищує потребу в управлінні даними, плануванні обчислень та відтворюваній конфігурації.
Безпечне та ефективне обслуговування глибоких моделей
Розгортання може здійснюватися через хостований кінцевий пункт, спеціалізований прискорювач, браузер, телефон або вбудований пристрій. Експорт і компіляція можуть об’єднувати оператори, квантувати ваги та активації або змінювати числову поведінку, тому слід перевіряти артефакт розгортання, а не лише контрольну точку навчання. Вимірюйте холодний старт, стабільну затримку, пропускну здатність, використання пам’яті, енергії та якість при реалістичних розмірах пакетів і послідовностей. Методи компресії — обрізка, дистиляція, квантування та адаптація низького рангу — міняють розмір або швидкість за рахунок точності та складності інженерії і повинні оцінюватися на чутливих класах і крайових випадках.
Глибокі моделі можуть впевнено провалюватися при зсуві розподілу, зловмисному вводі, спуріозних кореляціях та погано представлених групах. Моніторте розподіли входу та виходу, результати завдань, калібрування, використання ресурсів та версії залежностей. Використовуйте контроль доступу, підписані артефакти, захищені навчальні дані, червоне тестування та обмеження швидкості відповідно до моделі загрози. Пояснення, такі як карти важливості або візуалізації уваги, є діагностичними доказами, а не доказом причинності. Поєднуйте їх з поведінковими тестами, контрфактами, людським переглядом, реагуванням на інциденти та явними обмеженнями автоматичних рішень.
Практичний приклад: навчання детектора дефектів зображень
Фабрика збирає зображення продуктів з різних камер, змін, матеріалів та відомих класів дефектів, а потім розбиває їх за виробничими партіями, щоб схожі елементи не перетинали розділи. Малий конволюційний базовий варіант порівнюється з попередньо навченою глибокою мережею. Аугментація відтворює перевірене освітлення та варіації куту без стирання дефектів. Оцінка повідомляє про відновлення по кожному дефекту, рівень хибних відхилень, калібрування, затримку інференсу та стійкість до розмиття, відблисків, заміни камери та рідкісних кольорів матеріалу.
Експортована модель і точний код зміни розміру, кольору та нормалізації тестуються на обладнанні лінії для стабільної пропускної здатності та теплової поведінки. Випадки з низькою впевненістю передаються інспекторам; окреме правило зупиняє лінію у випадку критичної відмови сенсора. Зображення зберігаються лише за дозволом, а артефакти моделі підписуються. Моніторинг зв’язує передбачення з подальшими результатами інспекції та партіями продукції. Нова камера або матеріал ініціює контрольовану переоцінку, а не тихе онлайн‑навчання на неперевірених мітках.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, експлуатаційне середовище, входи, виходи, залежності, власника та наслідки кожної важливої відмови. Встановіть відтворювану базу та версійну оцінкову вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені або відсутні входи, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які, ймовірно, залишаться без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рев’юер міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальних за випуск, винятки, зміни, відкат та відключення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених відмов. Операційна телеметрія повинна виявляти якість входу, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім переглядайте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та збереження, а також чіткої точки, коли її слід вимкнути або замінити.
Основні джерела












