Основи ШІ
Що таке RNN та LSTM у глибокому навчанні?

 Додайте Unite.AI до бажаних джерел у Google
Recurrent neural networks (RNNs) процесують послідовності, оновлюючи прихований стан протягом часу. Long short-term memory (LSTM) мережі є гейтованими RNN, створеними для більш ефективного збереження та контролю інформації порівняно з базовим рекурентним елементом.
RNN та LSTM колись домінували у багатьох завданнях обробки мови, проте сучасні великі чат‑боти в основному базуються на трансформерах. Рекурентні моделі залишаються корисними для потокової обробки, часових рядів, мовлення, керування та систем з обмеженими ресурсами, де важливі інкрементний стан і низька затримка.
Key takeaways
- RNN повторно використовує ті самі параметри на кожному кроці послідовності та передає прихований стан вперед.
- Навчання у часі може призводити до згасання або вибуху градієнтів.
- LSTM додає стан комірки та ворота входу, забуття та виходу.
- Трансформери по‑різному обробляють довготривалі взаємозв’язки та паралельне навчання; жодна архітектура не є найкращою для кожного розгортання.
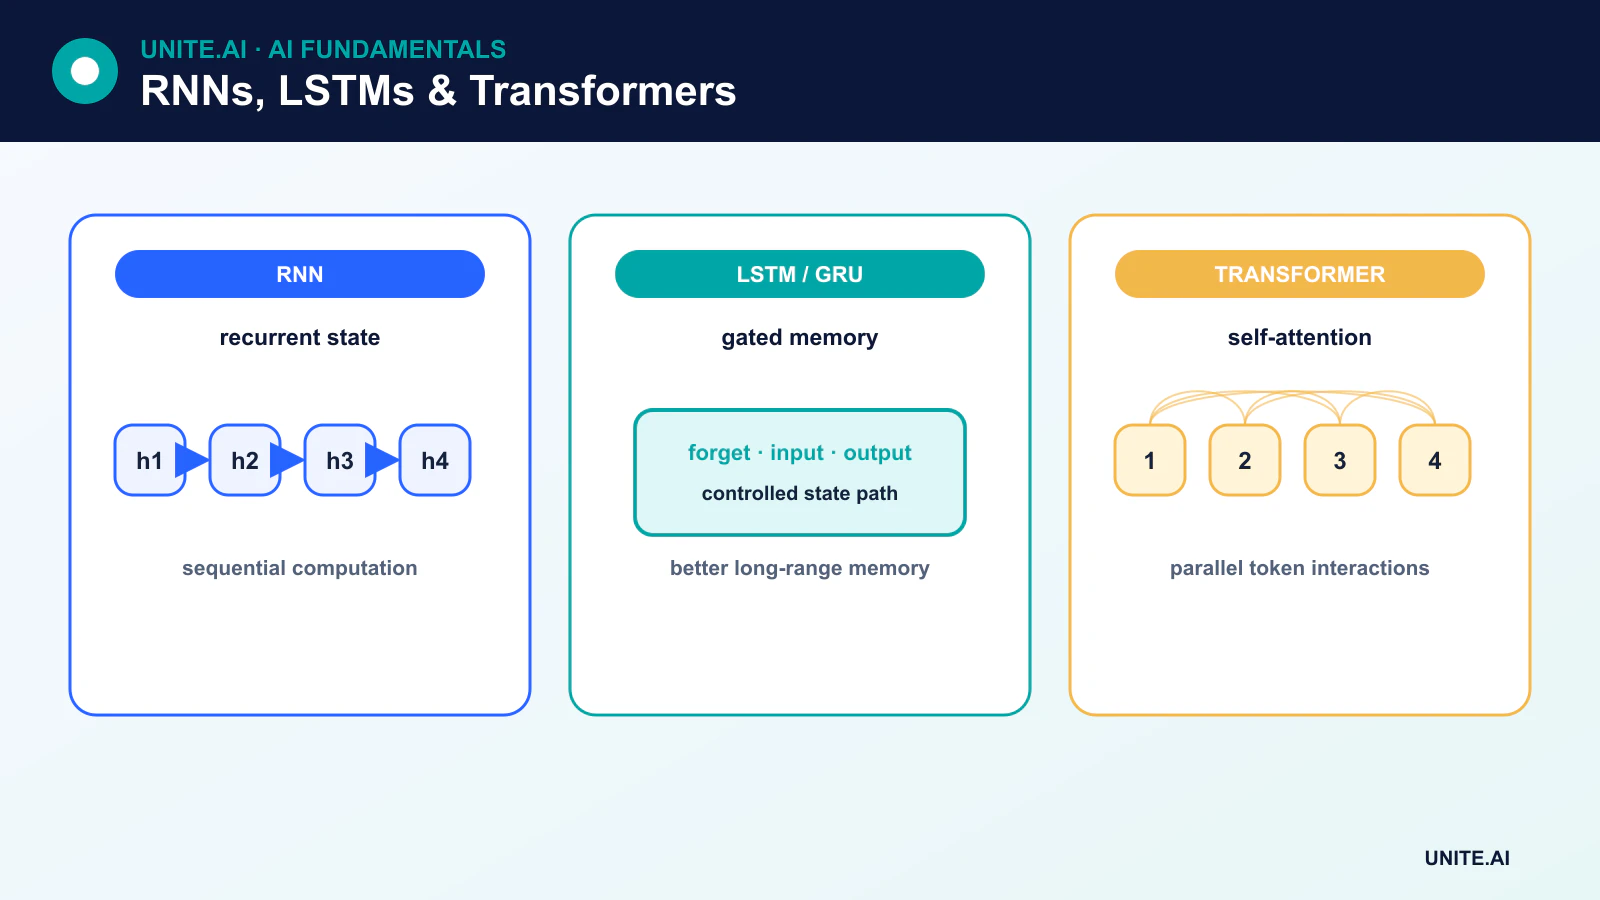
How a basic RNN works
На кроці t простий рекурентний елемент поєднує поточний вхід xₜ з попереднім прихованим станом hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Прихований стан — це навчене узагальнення, що використовується для наступного кроку і, залежно від завдання, як вихід. «Розгорнута» діаграма показує одну копію на кожен крок часу, проте всі копії ділять параметри. Вихід не просто копіюється назад як новий необроблений вхід; рекурентність передає прихований стан через визначену трансформацію.
Backpropagation through time
RNN навчаються за допомогою backpropagation through time (BPTT). Розгорнута послідовність утворює глибокий обчислювальний граф, і зворотне поширення помилки обчислює, як втрата залежить від спільних рекурентних параметрів.
Повторне множення може змусити градієнти згасати до нуля або зростати без обмежень. Згасання градієнтів заважає навчанню довгих залежностей; вибухаючі градієнти створюють нестабільні оновлення. Обрізка градієнтів усуває вибухаючі градієнти, а гейтинг, ініціалізація, нормалізація та коротші вікна навчання можуть допомогти.
Inside an LSTM cell
LSTM підтримує cell state cₜ поряд із прихованим станом hₜ. Його ворота — це навчальні, залежні від даних контролі:
- Ворота забуття контролюють, скільки попереднього стану комірки зберігається.
- Ворота входу контролюють, скільки кандидатної інформації записується.
- Ворота виходу контролюють, скільки інформації комірки впливає на прихований стан.
Сигмоїдні виходи в діапазоні від нуля до одиниці працюють як м’які ворота, тоді як кандидат, трансформований через tanh, постачає новий вміст. Додавальний шлях стану комірки допомагає градієнтам зберігатися, проте LSTM не гарантує необмежену пам’ять і не усуває всі проблеми оптимізації.
GRUs and bidirectional recurrence
Гейтована рекурентна одиниця (GRU) об’єднує механізми гейтингу в простішу рекурентну клітину без окремого стану комірки, характерного для LSTM. GRU можуть навчатися швидше і демонструвати подібну продуктивність у деяких завданнях.
Двосторонній RNN обробляє завершену послідовність в обох напрямках і комбінує стани. Він може використовувати майбутній контекст для тегування чи кодування, проте не підходить для причинного потокового режиму, коли майбутні входи ще недоступні.
Sequence-to-sequence models
RNN‑моделі «енкодер‑декодер» перетворюють одну послідовність у іншу. Увага (attention) була введена, щоб дозволити декодеру звертатися до різних станів енкодера замість того, щоб покладатися на один фіксований вектор. Цей напрямок роботи привів до архітектури трансформера, яка замінила рекурентність блоками на основі уваги.
RNNs versus transformers
Трансформери обробляють позиції під час навчання паралельно та створюють короткі шляхи уваги між віддаленими токенами. RNN обробляють стан послідовно, обмежуючи паралелізм, але забезпечують рекурентний стан постійного розміру під час потокової обробки. При інференсі трансформер може вимагати зростаючий кеш ключ‑значення, тоді як RNN стискає історію у свій прихований стан і може втрачати деталі.
Вибір слід робити, орієнтуючись на довжину послідовності, масштаб даних, апаратне забезпечення, затримку, пам’ять та характер завдання (офлайн чи потокове). Гібридні та архітектури простору станів пропонують додаткові компроміси.
Current use cases
RNN та LSTM залишаються актуальними для прогнозування, виявлення аномалій, обробки датчиків, компонентів мовлення, рукописного вводу, вбудованого керування та низькозатримкових моделей послідовностей. Вони не є типовим поясненням сучасних великих мовних моделей чи AI‑чат‑ботів.
Recurrence, gates, and sequence memory
Рекурентна нейронна мережа обробляє послідовність, поєднуючи поточний вхід із прихованим станом, що переноситься з попередніх кроків. Спільні ваги дозволяють змінну довжину послідовності, а розгортання відкриває обчислення у часі для навчання. Базові RNN можуть представляти часову залежність, проте градієнти, що багаторазово множаться протягом довгих послідовностей, схильні до згасання або вибуху. Обрізане зворотне поширення обмежує пам’ять та обчислення, а обрізка градієнтів контролює екстремальні оновлення. Прихований стан — це навчений підсумок, а не точне сховище кожного попереднього токена.
Мережі довгої короткострокової пам’яті додають стан комірки та ворота входу, забуття та виходу, які регулюють запис, збереження та відкриття інформації. Гейтовані рекурентні одиниці використовують простішу структуру скидання та оновлення. Двосторонні варіанти використовують майбутній контекст і тому не можуть потоково працювати причинно без затримки. Складені, залишкові та доповнені увагою рекурентні моделі підвищують місткість. Заповнення (padding) та маски мають запобігати впливу штучних елементів послідовності на стан або втрату, а стан слід скинути на реальних межах послідовності, щоб уникнути витоку між прикладами.
Training, comparison, and stateful serving
RNN та LSTM залишаються корисними для потокової обробки, компактних моделей на пристрої, часових рядів та навантажень, де послідовний стан є ефективним. Трансформери паралелізують навчання та моделюють довготривалі взаємодії інакше, але можуть вимагати більше пам’яті та кешу. Порівнюйте архітектури за точністю, затримкою, пропускною здатністю, пам’яттю, енергоспоживанням та продуктивністю при зміні довжини послідовності. Оцінюйте прогнозування за допомогою скользящих часових розбиттів, мову — за метриками, що враховують послідовність, а виявлення аномалій — за подієвими показниками. Перевіряйте помилки після довгих перерв, змін режиму, відсутніх зразків та різких меж послідовності.
Стан‑залежне розгортання повинно пов’язувати прихований стан з правильною сесією, встановлювати термін його дії, шифрувати його у випадку чутливості та скидати після помилок або змін моделі. Події, що надходять не в порядку або дублюються, можуть пошкодити стан; включайте мітки часу, номери послідовності та ідемпотентність. Слідкуйте за віком стану, довжиною послідовності, відсутністю даних, зсувом виходу та затримкою. Квантування потребує перевірки, чутливої до воріт, оскільки невеликі числові зміни можуть накопичуватись з часом. Пам’ять RNN забезпечує контекст, але може також зберігати приватну або застарілу інформацію, тому управління збереженням та користувацькими налаштуваннями має бути передбачене у дизайні.
Worked example: an LSTM for streaming sensor sequences
Один сервіс використовує LSTM для прогнозування короткострокового навантаження за даними недавніх вимірювань, календаря та погоди. Послідовності формуються у строгому хронологічному порядку; прихований стан скидається на межах підключень, а заповнення (padding) маскується. Сезонно‑наївні та градієнтно‑підсилені базові моделі порівнюються з LSTM у скользячих вікнах. Тести охоплюють пропущені інтервали, затриману погоду, святкові дні, відключення та довжини послідовностей, що перевищують типове навчання.
Потоковий сервіс прив’язує стан до одного підключення, відхиляє дублікати, що надходять не в порядку, та скасовує стан після довгих перерв або оновлень моделі. Безпечний статистичний прогноз замінює вихід, коли датчики або стан недійсні. Квантизований інференс перевіряється на довгих послідовностях щодо накопиченого зсуву. Моніторинг відстежує вік стану, відсутність даних, затримку, упередженість та помилку інтервалу. Модель перенавчається лише після змін у мережі, і результати показують, що вивчені часові зв’язки більше не узагальнюються.
Implementation evidence and operational readiness
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, робоче середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відсутність залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаться без належної підтримки. Оцінюйте якість завдання разом з калибруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рев’юер міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат і виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та збереження, а також чіткого моменту, коли її слід вимкнути або замінити.
Frequently asked questions
Is an LSTM always better than a basic RNN?
Ні. Гейтинг допомагає вирішувати багато проблем довгих залежностей, але додає обчислювальні витрати та параметри. Базовий RNN може бути достатнім для коротких, простих послідовностей, а інша архітектура може бути кращою для дуже довгого контексту.
Can an LSTM process an unlimited history?
Ні. Його стан має обмежену місткість, градієнти та навчальні дані накладають обмеження, а важливі деталі можуть бути перезаписані. Продуктивність у довгому контексті слід вимірювати, а не робити висновки лише за назвою архітектури.
Primary references