
Основи ШІ
Що таке навчання з малою кількістю прикладів?

 Додайте Unite.AI до бажаних джерел у Google
Few-shot learning досліджує, як модель може адаптуватися до нової задачі або класу, використовуючи лише невелику кількість позначених прикладів. У класичних бенчмарках епізод надає набір підтримки — наприклад, п’ять класів з одним або п’ятьма прикладами на клас — і просить модель класифікувати невідомі запити.
Термін також використовується для навчання в контексті, коли попередньо навчена мовна модель отримує кілька демонстрацій у підказці без оновлення параметрів. Такі налаштування мають спільну мету — працювати з малою кількістю прикладів, але застосовують різні механізми адаптації та потребують різних підходів до оцінки.
Ключові висновки
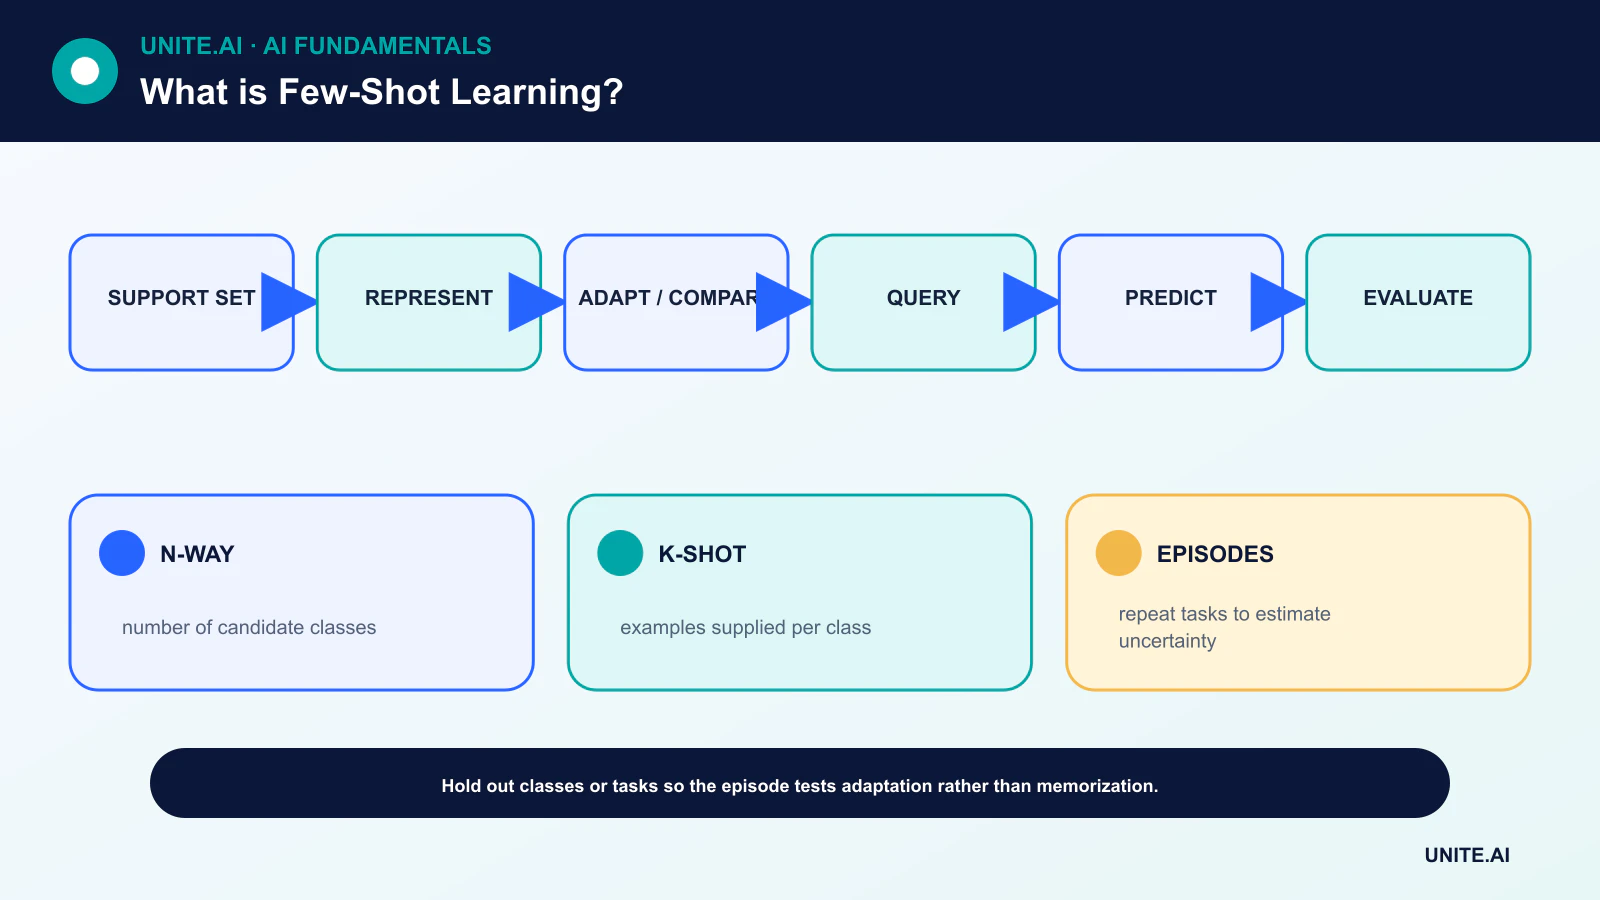
- N‑way K‑shot описує N класів і K позначених прикладів підтримки на клас.
- Методи метричного навчання порівнюють запити з вивченими представленнями прикладів підтримки.
- Мета‑навчання оптимізує модель на багатьох задачах, щоб нову задачу можна було швидко вивчити.
- Невелика кількість прикладів підсилює помилки міток, витік даних, неоднозначність класів та невизначеність, тому важливі базові лінії та повідомлення про довіру.
Епізоди, набори підтримки та набори запитів
Епізод у few-shot навчанні розділяє невеликий позначений набір підтримки та набір запитів, що використовується для оцінки. Під час мета‑тренування модель бачить безліч таких епізодів. Надійна оцінка відокремлює цілі класи, задачі або домени, щоб тестовий епізод вимірював адаптацію, а не запам’ятовування.
Звітуйте розподіл точності по багатьом епізодам, а не лише по одному зручному зразку. Порівнюйте зі простими базовими методами, такими як найближчий сусід та лінійний класифікатор; складний підхід, який не перевершує добре навчене представлення плюс базовий класифікатор, може не виправдати свою складність.
Метричне навчання та прототипи
Мережі збігів та подібні методи вбудовують приклади підтримки і запиту у простір, де близькі вектори мають мати однакову мітку. Прототипічні мережі усереднюють вбудовування підтримки для кожного класу і класифікують запит за відстанню до цих прототипів класу.
Це пов’язує few-shot навчання з якістю представлення. Попередньо навчена глибоке навчання модель може вже добре організовувати релевантні ознаки, тоді як невідповідне представлення може спотворювати всі відстані.
Оптимізаційне мета‑навчання
Model-Agnostic Meta-Learning шукає параметри, які можна адаптувати за кілька кроків градієнта. Інші методи навчають оптимізатор, ініціалізацію або правило оновлення параметрів. Зовнішній цикл оцінює продуктивність після адаптації на різних задачах.
Мета‑навчання передбачає, що корисна структура спільна між навчальними та цільовими задачами. Коли цільовий розподіл різко відрізняється, швидка адаптація може зазнати невдачі. Валідація має варіювати кількість прикладів, класи, домени та складність задач, а не розглядати один бенчмарк як універсальний.
Трансферне навчання та стратегії на рівні даних
Трансферне навчання часто є найсильнішою практичною відправною точкою: заморозьте попередньо навчений енкодер, навчіть невеликий голівку, а потім при достатній кількості даних вибірково донастройте. Аугментація даних може ввести інваріанти, проте нереалістичні синтетичні приклади можуть посилити упередженість або створити «шорткати».
Активне навчання може пріоритезувати, які приклади позначати, тоді як напівавтоматичне навчання використовує додаткові непозначені дані. Це комплементарні стратегії, а не синоніми few-shot навчання.
Few-shot підказка відрізняється
Трансформер може вивести патерн з демонстрацій, розташованих у його контексті. Не потрібне постійне оновлення параметрів. Порядок, формулювання та баланс міток можуть суттєво змінити вихід, а приклади можуть займати значну частину вікна контексту.
Використовуйте репрезентативний набір оцінки, версіонуйте кожну підказку та демонстрацію, і тестуйте zero-shot, few-shot та донастроєні альтернативи. Крихітний набір підтримки не підтримує сильні заяви для всього населення, особливо для рідкісних або критичних безпеки випадків.
Парадигми few-shot навчання та побудова задач
Few-shot навчання прагне виконати задачу, маючи дуже мало позначених прикладів. У методах, заснованих на метриці, енкодер відображає приклади у простір, де найближчі прототипи або сусіди представляють класи. Оптимізаційне мета‑навчання навчає ініціалізацію або правило оновлення для швидкої адаптації. Трансферне навчання донастроює попередньо навчений модель на невеликому цільовому наборі. Навчання в контексті подає приклади у підказці без оновлення ваг. Ці механізми різняться, тому твердження мають уточнювати, чи змінюються параметри, яке попереднє навчання проводилось і як обираються приклади.
Оцінка має розділяти навчальні та тестові класи, задачі, суб’єкти або домени згідно з заявленою генералізацією. Епізод N‑way K‑shot містить N класів і K прикладів підтримки на клас, а також приклади запитів для оцінки. Повторювані епізоди оцінюють дисперсію від вибору підтримки. Для підказок порядок прикладів, формулювання міток, формат та схожість демонстрації можуть суттєво впливати на результати. Порівнюйте зі zero-shot, найближчим сусідом, лінійним пробуванням та звичайними донастроєними базовими лініями, використовуючи однакове представлення та бюджет даних.
Якість даних, невизначеність та негативний трансфер
При малій кількості прикладів помилкові або нетипові випадки мають надмірний вплив. Визначте правила анотації, перевірте кожен елемент підтримки та збережіть варіант «невідомо» або «відмовитися». Аугментація даних і синтетичні приклади допомагають лише коли вони зберігають задачу і додають реалістичну варіацію. Попередньо навчена модель може переносити шорткати або упередженість зі свого вихідного домену. Тестуйте випадки поза доменом, рідкісні групи та чутливість до видалення одного прикладу підтримки. Звітуйте довірчі інтервали по задачах і випадкових зернах, а не один сприятливий промпт.
Активне навчання може запитувати мітки на інформативних випадках, тоді як напівавтоматичні методи використовують непозначені дані за додаткових припущень. Пошук може динамічно обирати релевантні демонстрації, але має уникати витоку міток тесту. Адаптація може швидко переобучитися, тому обмежуйте оновлення, використовуйте регуляризацію та валідуйте на окремих прикладах. Для високоризикових задач кілька міток рідко виправдовують автономні рішення; використовуйте модель для пріоритезації або допомоги у перегляді, доки не з’явиться достатньо доказів результату.
Операція у продакшені
Версіонуйте базову модель, вбудовування або шаблон підказки, демонстрації, схему міток та параметри адаптації. Захищайте приклади, оскільки підказки або градієнти можуть розкривати конфіденційні записи. Моніторьте продуктивність у міру зміни класів і мови, і оновлюйте приклади підтримки через керовану ревізію, а не автоматичне самостійне маркування. Few-shot навчання зменшує потребу у позначених цільових даних, використовуючи попередню структуру; воно не усуває потребу у репрезентативній оцінці, ретельному визначенні задач, доменної експертизи чи безпечному резервному варіанті, коли нова задача виходить за межі попереднього досвіду.
Практичний приклад: класифікація few-shot для нового продукту
Команда підтримки потребує міток маршрутизації для продукту, маючи лише п’ять переглянутих прикладів на проблему. Вони порівнюють найближчі прототипи у попередньо навченому вбудовуванні, лінійний голова, параметрично‑ефективне донастроювання та підказку в контексті. Сімейства продуктів, клієнти та подальші повідомлення виключені з мета‑тренування та вибору моделі. Повторне вибіркове формування набору підтримки звітує про відновлення класу, калібрування, дисперсію та чутливість до однієї помилкової демонстрації.
Повідомлення з низькою довірою та без підтримки перенаправляються до загальної підтримки, а рецензенти виправляють мітки через керовану чергу. Приклади анонімізовані, версіонуються і ніколи не беруться з фінального тестового набору. Моніторинг відстежує нову лексику, частоти класів, виправлення та розбіжності. Коли накопичується достатньо міток, система few-shot порівнюється зі звичайним контрольованим навчанням. Швидке налаштування корисне, проте не виправдовує автоматизацію, якщо продуктивність залишається нестабільною або новий продукт суттєво відрізняється від попередніх сімей задач.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої помилки. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені або відсутні вхідні дані, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які, ймовірно, залишаться без належного обслуговування. Вимірюйте якість задачі разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Зафіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв, і перевірте моніторинг шляхом навмисного введення збоїв. Операційна телеметрія повинна виявляти якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень і відповідального за реакцію, а потім переглядайте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часто задавані питання
Чи є one-shot learning тим же, що і few-shot learning?
One-shot learning — це спеціальний випадок, коли на кожен клас або задачу є лише один позначений приклад підтримки. Zero-shot learning використовує жодних позначених цільових прикладів.
Чи усуває few-shot learning потребу у даних?
Ні. Воно переносить залежність на дані попереднього навчання, пов’язані задачі, представлення та припущення. Цільових міток небагато; загальна історія навчання зазвичай велика.
Основні посилання












