Основи ШІ
Що таке великі мовні моделі (LLM)?

 Додайте Unite.AI до бажаних джерел у Google
Велика мовна модель (LLM) — це нейронна мережа, навчена на великих збірках послідовностей для передбачення токенів або пов’язаних мовних завдань. Більшість сучасних LLM використовують архітектури трансформерів і можуть генерувати, класифікувати, підсумовувати, перекладати, отримувати та трансформувати мову через спільний інтерфейс.
LLM не є базою даних або гарантованим логічним рушієм. Її вихід — це умовне передбачення, сформоване даними навчання, пост‑тренуванням, контекстом, інструментами та декодуванням. Вільність мови може співіснувати з фактичними помилками, невизначеністю, упередженістю або небезпечною поведінкою.
Основні висновки
- Токенізація перетворює текст у дискретні одиниці; ембедінги та увага створюють контекстуальні представлення.
- Попереднє навчання вивчає широкі патерни, тоді як донастройка та методи уподобань формують поведінку завдання.
- Отримання та інструменти можуть додавати актуальні докази або дії, але вимагають окремих дозволів та валідації.
- Оцінюйте розгорнуту систему за якістю, обґрунтованістю, безпекою, затримкою, вартістю та дрейфом.
Токени, трансформери та попереднє навчання
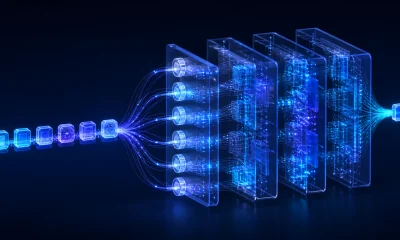
Текст розбивається на токени. Трансформер перетворює їх у вектори, змішує інформацію за допомогою шарів уваги та прямого проходу, і створює розподіл ймовірностей для наступного або відсутнього токена.
Само‑контрольовані цілі створюють навчальні сигнали з необроблених послідовностей. Масштабування параметрів, даних та обчислень може передбачувано зменшувати втрати, проте якість набору даних, архітектура, оптимізація та оцінка визначають, які можливості виникають на практиці.
Пост‑тренування та інференція
Тюнінг за інструкціями використовує демонстрації; оптимізація уподобань може робити вихід більш відповідним людським оцінкам або політиці. Під час інференції підказка та історія розмови визначають контекст, а параметри температури та вибірки впливають на варіативність.
RLHF та подібні методи формують поведінку, а не встановлюють повний факт‑чекер. Модель все ще може генерувати правдоподібну, але непідтримувану відповідь.
Отримання, інструменти та агенти
Генерація з підсиленням отриманням надає уривки, обрані з зовнішньої колекції. Виклик інструментів дозволяє коду застосунку запитувати бази даних, виконувати обчислення, пошук або дії. Ці патерни розділяють частину знань та виконання від ваг моделі.
Застосунок повинен перевіряти аргументи інструментів, забезпечувати дозволи, зберігати цитати та розглядати отриманий контент як ненадійний ввід. Vector similarity search допомагає отриманню, але не доводить, що уривок підтримує відповідь.
Обмеження та оцінка
LLM можуть галюцинувати, розкривати запам’ятований контент, виконувати шкідливі інструкції, відтворювати упередження та провалюватися у завданнях, схожих на приклади навчання. Довгий контекст не гарантує, що кожен факт буде використаний або правильно узгоджений.
Оцінюйте на репрезентативних приватних завданнях з задокументованими підказками та версіями. Вимірюйте підтримку джерел, відмови, калібрування, безпеку, результати підгруп, навантаження на людей, затримку та вартість. Слідкуйте після випуску, оскільки моделі, дані та поведінка користувачів змінюються.
Навчальні дані та розробка моделі
Корпуси попереднього навчання поєднують веб‑сторінки, книги, код, академічні матеріали, розмови та ліцензовані або куровані джерела. Конвеєри визначають мову, видаляють дублікати, фільтрують якісний та небезпечний контент, обробляють персональні дані та обирають ваги міксу. Ці рішення формують знання, охоплення мов, стиль, упередження та запам’ятовування.
Оптимізаційні процеси обробляють пакети токен‑послідовностей і мінімізують втрату передбачення за допомогою градієнтного спуску. Розподілене навчання розподіляє дані, тензори моделі, етапи конвеєра або експертів між прискорювачами. Збереження чекпоінтів, числова стабільність, мережеве спілкування та відновлення після збоїв стають ключовими інженерними питаннями при масштабуванні.
Оцінка під час навчання відстежує втрати та набори можливостей, проте забруднення бенчмарків може завищувати результати. Відокремлюйте часові періоди та пропрієтарні завдання, шукайте перекриття та повідомляйте точні підказки, декодування, інструменти та оцінювання. Модель може покращити середню втрату, тоді як регресії з’являються у безпеці або в мовах з низькими ресурсами.
Контекстні вікна, декодування та інференція
Під час інференції кеш ключ‑значення зберігає проекції уваги для попередніх токенів, тому їх не треба перераховувати на кожному кроці. Пам’ять кешу зростає зі збільшенням кількості шарів, довжини послідовності, батчів та представлення. Квантування та сторінкування зменшують навантаження, проте можуть змінити якість або затримку.
Жадібне декодування обирає токен з найвищою ймовірністю; температура пере масштабовує ймовірності; top‑k та top‑p обмежують набір кандидатів; пошук по променях відстежує кілька послідовностей. Найкраща стратегія залежить від того, чи цінує завдання детермінізм, різноманітність, структурований вихід чи ймовірність послідовності. Завжди валідовуйте схему після генерації.
Довгий контекст збільшує обсяг доступної інформації, але не гарантує відтворення чи міркування. Позиція, відволікання, протиріччя та структура підказки впливають на використання. Отримання може обирати менший набір доказів, тоді як підсумовування стискає історію з ризиком втрати деталей. Вимірюйте продуктивність за довжиною та розташуванням контексту.
Адаптація, розгортання та економіка
Повна донастройка оновлює всі параметри; параметр‑ефективні методи оновлюють адаптери або низько‑рангові матриці; продовжене попереднє навчання адаптує розподіл домену; інструкційна та уподобальна донастройка формують відповіді. Отримання часто кращий для часто змінюваних фактів, тоді як донастройка краща для поведінки та формату завдань. Методи можна комбінувати.
Варіанти розгортання включають хостовані API, керовані кінцеві точки, самостійно розгорнуті відкриті ваги, моделі на пристрої та гібриди. Порівнюйте обробку даних, контроль версій, затримку, пропускну здатність, регіони, доступність, портативність моделі, підтримку та загальну вартість. Самостійне розгортання передає відповідальність за безпеку, масштабування, оновлення та моніторинг зловживань.
Вартість за токен є неповною. Слабка модель може потребувати повторних спроб, довших підказок, більшого перегляду або дорогих помилок. Вимірюйте вартість за успішно виконане завдання при необхідній якості та рівні ризику. Використовуйте кешування, батчування, менші маршрутизовані моделі та детермінований код там, де вони покращують повний робочий процес.
Практичний приклад: прив’язка LLM до корпоративних документів
Помічник документів має починатися з корпусу, що враховує дозволи, стабільних ідентифікаторів документів, дат версій та набрання чинності, структури, придатної до парсингу, та набору оцінювальних питань, на які можна відповісти, не можна відповісти, неоднозначних та конфліктних. Індекси отримання розбивають документи на фрагменти та метадані, проте розмір фрагмента та перекриття мають відповідати структурі документу. Якість пошуку вимірюється окремо перед генерацією, тому вільна модель не може приховати відсутні докази.
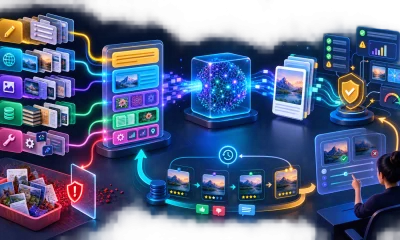
Під час виконання автентифікуйте користувача, фільтруйте отримання за доступом, отримуйте та переранжируйте докази, створюйте обмежену підказку, генеруйте цитовану відповідь та перевіряйте необхідний вихід. Модель повинна вказувати, коли джерела конфліктують або не підтримують відповідь. Використання інструментів та зовнішніх дій вимагає окремого дозволу. Захистіть від інструкцій, вбудованих у отримані документи, розглядаючи вміст як дані, а не як пріоритетну системну політику.
Оцінюйте відтворення отримання, точність цитувань, правильність відповіді, обґрунтованість, відмови, затримку та вартість за ролями та типами документів. Відстежуйте версії моделі, підказки, індексу, парсера та корпусу для кожного тесту. У продакшн‑середовищі реєструйте ідентифікатори доказів та відгуки без розкриття приватного тексту, стежте за новими питаннями без відповіді після змін контенту та підтримуйте безпечний резерв. Інтерфейс LLM не замінює управління записами, контроль доступу чи відповідний експертний перегляд.
Планування місткості має моделювати розподіли довжини підказок та вихідних даних, одночасних користувачів, поведінку кешу, затримку інструментів та рівень повторних спроб. Стрімінг покращує сприйману затримку, але ускладнює модерацію та скасування, оскільки небезпечний або неправильний контент може дістатися користувача до того, як повна відповідь буде перевірена. Встановіть бюджети токенів та інструментів, ізолюйте орендарів, захистіть облікові дані постачальника та відпрацюйте переключення між версіями моделей без тихого зміни поведінки, на яку покладаються користувачі.
Практичний чек‑лист впровадження
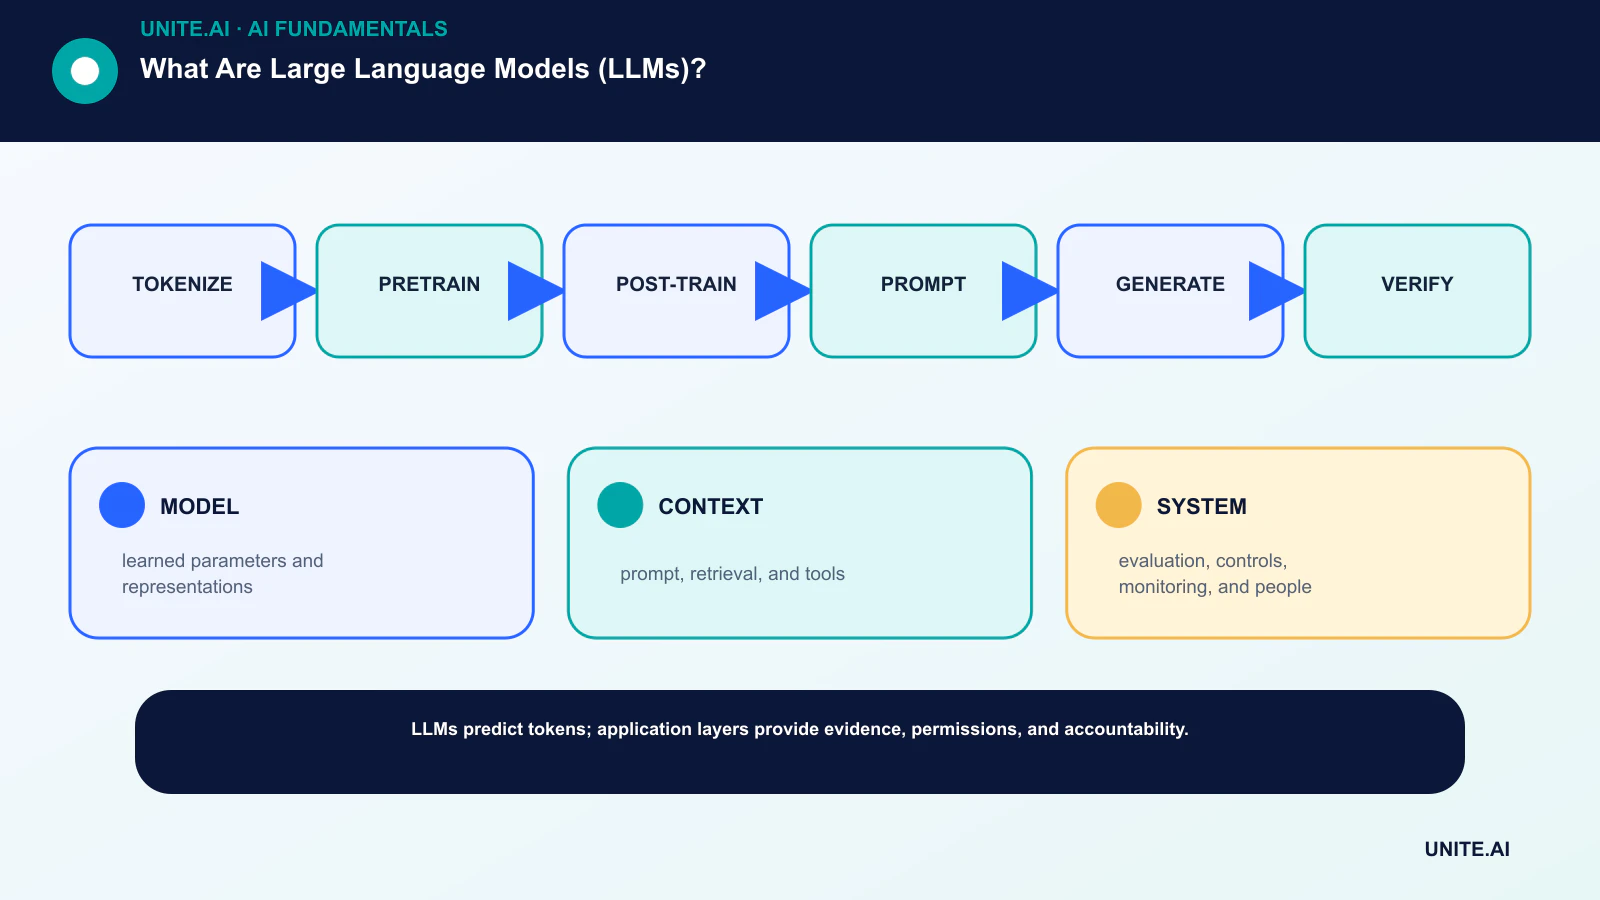
Перетворіть концепцію у обмежений, тестований робочий процес: токенізувати → попереднє навчання → пост‑тренування → підказка → генерація → перевірка. Призначте відповідального власника, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії приймання та зупинки, протестуйте репрезентативні відмови та визначте моніторинг, відкат і перегляд перед розширенням сфери. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності за участю людей, які будують, експлуатують, захищають та постраждають від системи. Протестуйте звичайні випадки, граничні умови, відмови залежностей та зловживання; збережіть докази та невирішені ризики. Визначте, хто може затвердити випуск, змінити поріг, перевизначити вихід або зупинити роботу. Перегляньте рішення після надходження реальних даних, оскільки технічно успішний пілот не гарантує надійної продуктивності у масштабі.
- MODEL: навчені параметри та представлення.
- CONTEXT: підказка, отримання та інструменти.
- SYSTEM: оцінка, контролі, моніторинг та люди.
Часті запитання
Чому LLM називаються великими?
Не існує універсального порогу параметрів. «Великий» означає масштаб у порівнянні з раннішими мовними моделями, включаючи кількість параметрів, навчальні дані, обчислювальні ресурси та широту використання.
Чи розуміють LLM мову?
Вони створюють корисні внутрішні представлення та демонструють складну поведінку, проте слово «розуміти» має кілька значень. Продуктивність слід демонструвати завдання за завданням, а не робити висновки лише за вільністю мови.
Основні джерела