Основи ШІ
Що таке перенесення навчання?

 Додайте Unite.AI до бажаних джерел у Google
Transfer learning повторно використовує знання, отримані для однієї задачі, щоб покращити навчання на пов’язаній задачі. Замість випадкової ініціалізації всіх параметрів, практик починає з попередньо навченого моделі або представлення і адаптує її до цільового завдання.
Такий підхід особливо корисний, коли цільовий набір даних малий, маркування дороговартісне, або передтренування вимагає більше обчислювальних ресурсів, ніж команда може виправдати. Навчання моделі з нуля є альтернативою перенесенню навчання — а не його типом.
Ключові висновки
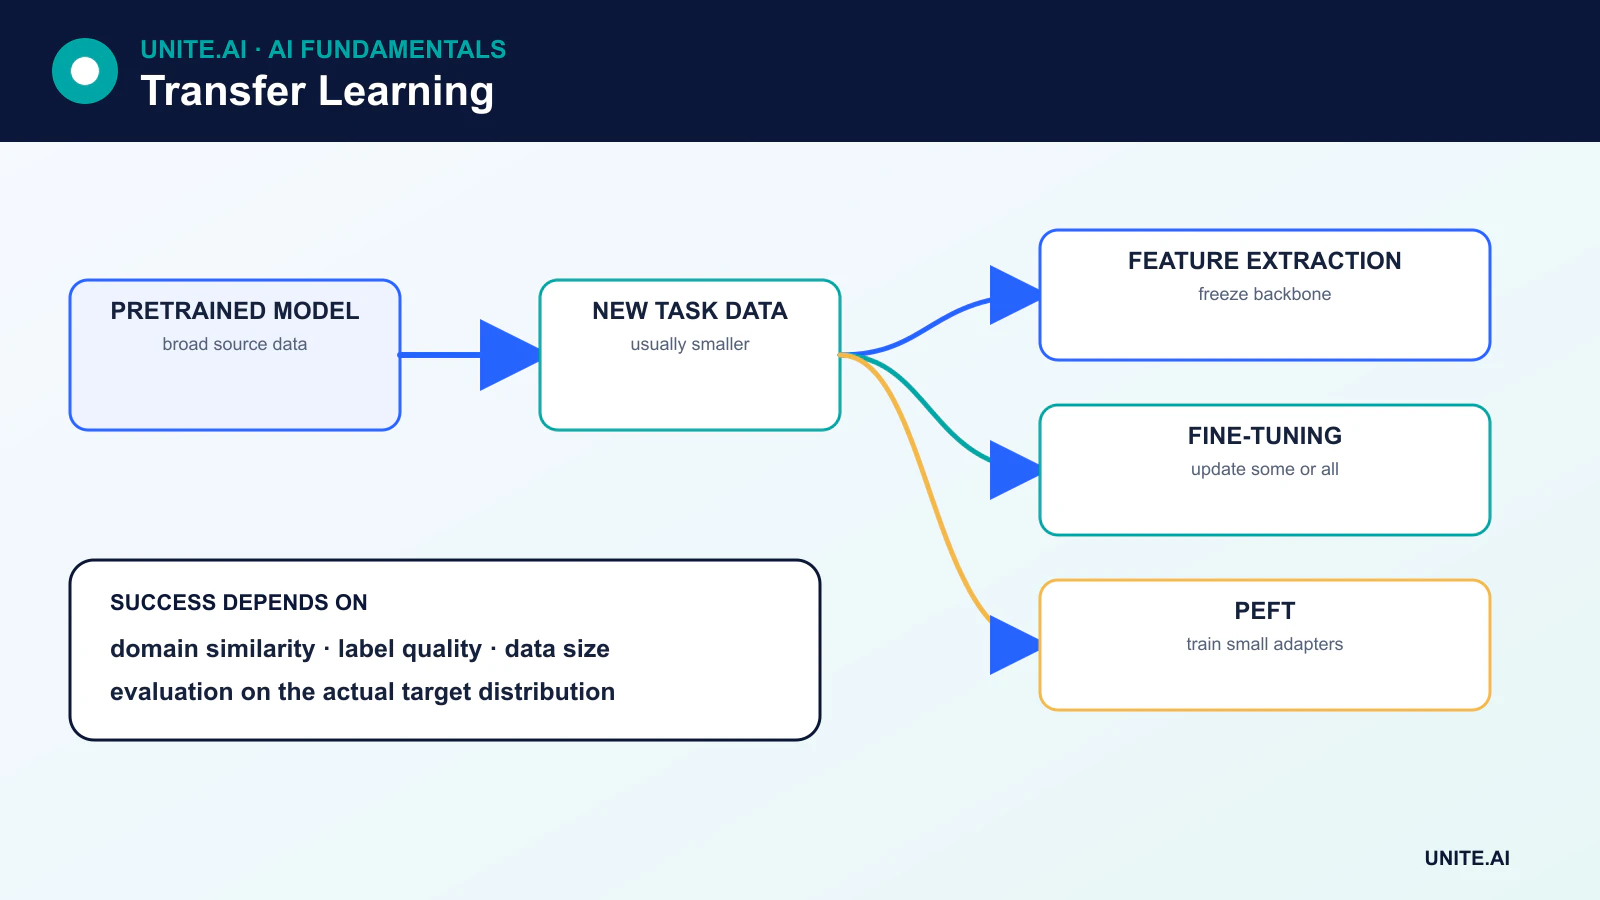
- Видобуток ознак залишає попередньо навчену основу замороженою та навчає нову головку, специфічну для завдання.
- Тонке налаштування оновлює частину або всі попередньо навчені параметри, використовуючи дані цільової області.
- Методи, ефективні за кількістю параметрів, такі як адаптери та LoRA, оновлюють лише невелику частину моделі.
- Перенесення може зазнати невдачі, коли джерело та цільова області різняться, ліцензії конфліктують або вихідна модель містить недоречне упередження.
Чому перенесення навчання працює
Моделі часто навчаються представленням, корисним за межами точних даних, на яких їх тренували. Перші шари модель зображень можуть захоплювати повторно використані локальні патерни; мовна модель може вивчати синтаксис, семантику та широкі асоціації завдяки самостійно контрольованому передбаченню. Цільове завдання може будуватися на цих представленнях, а не переучувати все з обмежених прикладів.
Користь залежить від схожості між вихідними та цільовими завданнями, масштабу та якості передтренування, а також способу адаптації моделі. Повторне використання не гарантовано: передані ознаки можуть бути нерелевантними або навіть шкідливими.
Видобуток ознак
У видобутку ознак попередньо навчена основа заморожується, тому її параметри не змінюються. Її вихід стає входом для нового класифікатора, регресора або іншої головки, специфічної для завдання. Навчатися лише нова головка.
Це швидко і ефективно з точки зору даних, а також знижує ризик знищення корисних попередньо навчених представлень. Воно може також недоадаптуватися, коли цільова область суттєво відрізняється від передтренування. Шари, такі як пакетна нормалізація, потребують особливої уваги, оскільки їхні збережені статистики та поведінка під час навчання можуть впливати на адаптацію, навіть коли більшість ваг заморожені.
Тонке налаштування
Fine-tuning оновлює попередньо навчені параметри на даних цільової області. Типовий робочий процес виглядає так:
- Завантажте попередньо навчену модель та замініть або додайте вихідну головку.
- Заморозьте основу і навчайте нову головку.
- Розморожуйте вибрані шари — або всю модель — і продовжуйте з меншою швидкістю навчання.
- Перевірте на перенавчання, забування та продуктивність у цільовій області.
Не існує універсального правила, що лише останні шари слід налаштовувати. Найкращий вибір залежить від архітектури, розміру даних цілі, схожості доменів, шарів нормалізації, пам’яті та обчислювальних ресурсів. Повне тонке налаштування може надати більше місткості, але вимагає більше ресурсів і може спричинити катастрофічне забування.
Ефективне за кількістю параметрів тонке налаштування
Великі трансформери роблять повне тонке налаштування дорогим. Ефективне за кількістю параметрів тонке налаштування (PEFT) модифікує або додає невеликий набір параметрів, залишаючи більшість базової моделі замороженою.
- Adapters вставляють невеликі навчальні модулі у мережу.
- LoRA представляє оновлення ваг за допомогою низькорангових матриць, зменшуючи кількість навчальних параметрів та пам’ять оптимізатора.
- Prompt and prefix tuning навчає безперервні вхідні дані, специфічні для завдання, або внутрішні префікси.
PEFT може зберігати багато адаптацій завдань навколо однієї базової моделі, хоча обслуговування інференсу, сумісність адаптерів та управління злитими вагами все ще вимагають ретельної інженерії.
Перенесення навчання між типами даних
Класифікатори зображень зазвичай починаються з моделей, попередньо навчених на великих наборах зображень. Мовні системи стартують з фундаментальної моделі та адаптуються за допомогою контрольованого тонкого налаштування, оптимізації переваг, пошуку чи використання інструментів. Моделі для мови, аудіо, білків та мультимодальні моделі слідують подібним патернам.
Перенесення також може відбуватися без зміни оригінальної моделі. Заморожена модель може генерувати векторні представлення для нижчого класифікатора, системи пошуку векторної схожості або конвеєра пошуку.
Зміна домену та негативне перенесення
Зміна домену виникає, коли вхідні дані цільової області відрізняються від даних джерела. Наприклад, модель медичних зображень може стикатися з обладнанням, популяціями або протоколами отримання, яких не було під час передтренування. Негативне перенесення означає, що повторне використання погіршує продуктивність цільової задачі порівняно з відповідною базовою моделлю, навченою з нуля.
Команди повинні порівнювати стратегії адаптації, оцінювати значущі підгрупи та зберігати тестовий набір у цільовій області. Якщо вихідна задача погано підходить, менша модель, специфічна для домену, може перевершити більшу загальну модель.
Ліцензування, походження та безпека
Завантажувана модель не автоматично безпечна для розгортання. Перевірте ліцензію, дозволені використання, розкриття даних навчання, обмеження в model‑card та ланцюжок залежностей. Моделі можуть відтворювати упередження, запам’ятовувати конфіденційні дані або містити шкідливий серіалізований код. Використовуйте довірені формати, скануйте артефакти та завантажуйте недовірені ваги в ізольованому середовищі.
Коли варто використовувати перенесення навчання
Перенесення навчання є надійним варіантом за замовчуванням, коли існує релевантна попередньо навчена модель і дані цілі обмежені. Навчання з нуля може бути кращим, коли домен дуже спеціалізований, ліцензії несумісні, розмір моделі перевищує обмеження розгортання або просте завдання не отримує користі від великого попередньо навченого представлення. Рішення слід перевіряти емпірично, а не припускати лише за масштабом моделі.
Що переноситься і як це адаптувати
Перенесення навчання повторно використовує представлення, навчені на вихідному завданні або наборі даних, для цільового завдання. У комп’ютерному зорі ранні ознаки часто захоплюють контури та текстури; у мові попередньо навчені моделі кодують статистичні патерни токенів та контекстів. Перенесення працює, коли вихідні представлення містять інформацію, релевантну цілі, проте різниця домену, міток, модальності та способу отримання може спричинити негативне перенесення. Почніть з попередньо навченої базової моделі, перевірте її ліцензію та документацію, і порівняйте з навчанням невеликої моделі, специфічної для цілі, з нуля.
Видобуток ознак заморожує основу та навчає нову головку; часткове тонке налаштування розморожує вибрані шари; повне тонке налаштування оновлює всю модель. Методи, ефективні за кількістю параметрів, додають адаптери або низькорангові оновлення, зменшуючи кількість навчальних параметрів, але не обов’язково пам’ять інференсу. Використовуйте нижчу швидкість навчання для попередньо навчених ваг, зберігайте поведінку нормалізації та уникайте катастрофічного забування за допомогою графіків, регуляризації, репетиції або обмежених оновлень, коли це потрібно. Обирайте контрольні точки за даними валідації цілі та тестуйте кілька випадкових ініціалізацій, оскільки малі набори цільових даних створюють високу дисперсію.
Компроміси даних, оцінки та розгортання
Цільові дані мають відображати умови розгортання та важливі підгрупи, а не лише бути зручним маркованим зразком. Розділяйте за суб’єктом, джерелом, часом або місцем, щоб запобігти перетину схожих прикладів між частинами. Тестуйте як у домені, так і у зміщених умовах. Порівнюйте заморожені, частково налаштовані та повністю налаштовані варіанти за якістю, калібруванням, вартістю навчання, затримкою та стійкістю. Покращення середнього балу може приховувати втрату на рідкісних класах, успадкованих від упередження джерела. Перегляньте приклади провалів щодо специфічних для джерела скорочень, прогалин у словнику чи різниць у датчиках.
Відстежуйте базову модель, ваги, токенізатор або передобробку, адаптер, дані та ліцензію як один граф залежностей. Хостовані базові моделі можуть змінювати поведінку; відкриті ваги можуть створювати відповідальність за ланцюжок постачання та виправлення. Перевірте злитий або експортований артефакт і скануйте файли моделі з недовірених джерел. У продакшені моніторьте зсув цілі та продуктивність, і зберігайте можливість відкотити як адаптацію, так і базову версію. Перенесення зменшує потребу у цільових даних; воно не усуває маркування, оцінку, конфіденційність чи експертизу домену.
Практичний приклад: адаптація моделі зору до нової клініки
Клініка адаптує попередньо навчений кодер зображень для класифікації якості зображення перед діагностичним оглядом. Вона перевіряє ліцензію вихідної моделі та передбачувану модальність, збирає локальні пристрої та умови отримання, і розбиває дані за пацієнтами. Варіанти з замороженими ознаками, адаптером, частковим та повним тонким налаштуванням порівнюються з невеликим локальним базовим рівнем. Метрики включають відгук класу, калібрування, поведінку підгруп, обчислювальні витрати та чутливість до пристрою, місця та рідкісних артефактів.
Адаптована модель не може ставити діагноз і перенаправляє зображення з низькою впевненістю або без підтримки до технічних спеціалістів. Експортна валідація підтверджує локальну передобробку та числову еквівалентність. Версії моделі, адаптера, пристрою та набору даних пов’язані в записі. Моніторинг виявляє нові сканери, зміни протоколу та зсув вихідних даних, а періодичні перевірені зразки оцінюють реальну продуктивність. Оновлення вихідної моделі розглядається як нова залежність, що потребує валідації; перенесення навчання не виправдовує автоматичне повторне використання старих доказів.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, експлуатаційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаться без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Записуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно інжектованих збоїв. Операційна телеметрія повинна виявляти якість вхідних даних, поведінку вихідних результатів, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткого моменту, коли її слід вимкнути або замінити.
Основні джерела