Основи ШІ
Що таке ансамблеве навчання?

 Додайте Unite.AI до бажаних джерел у Google
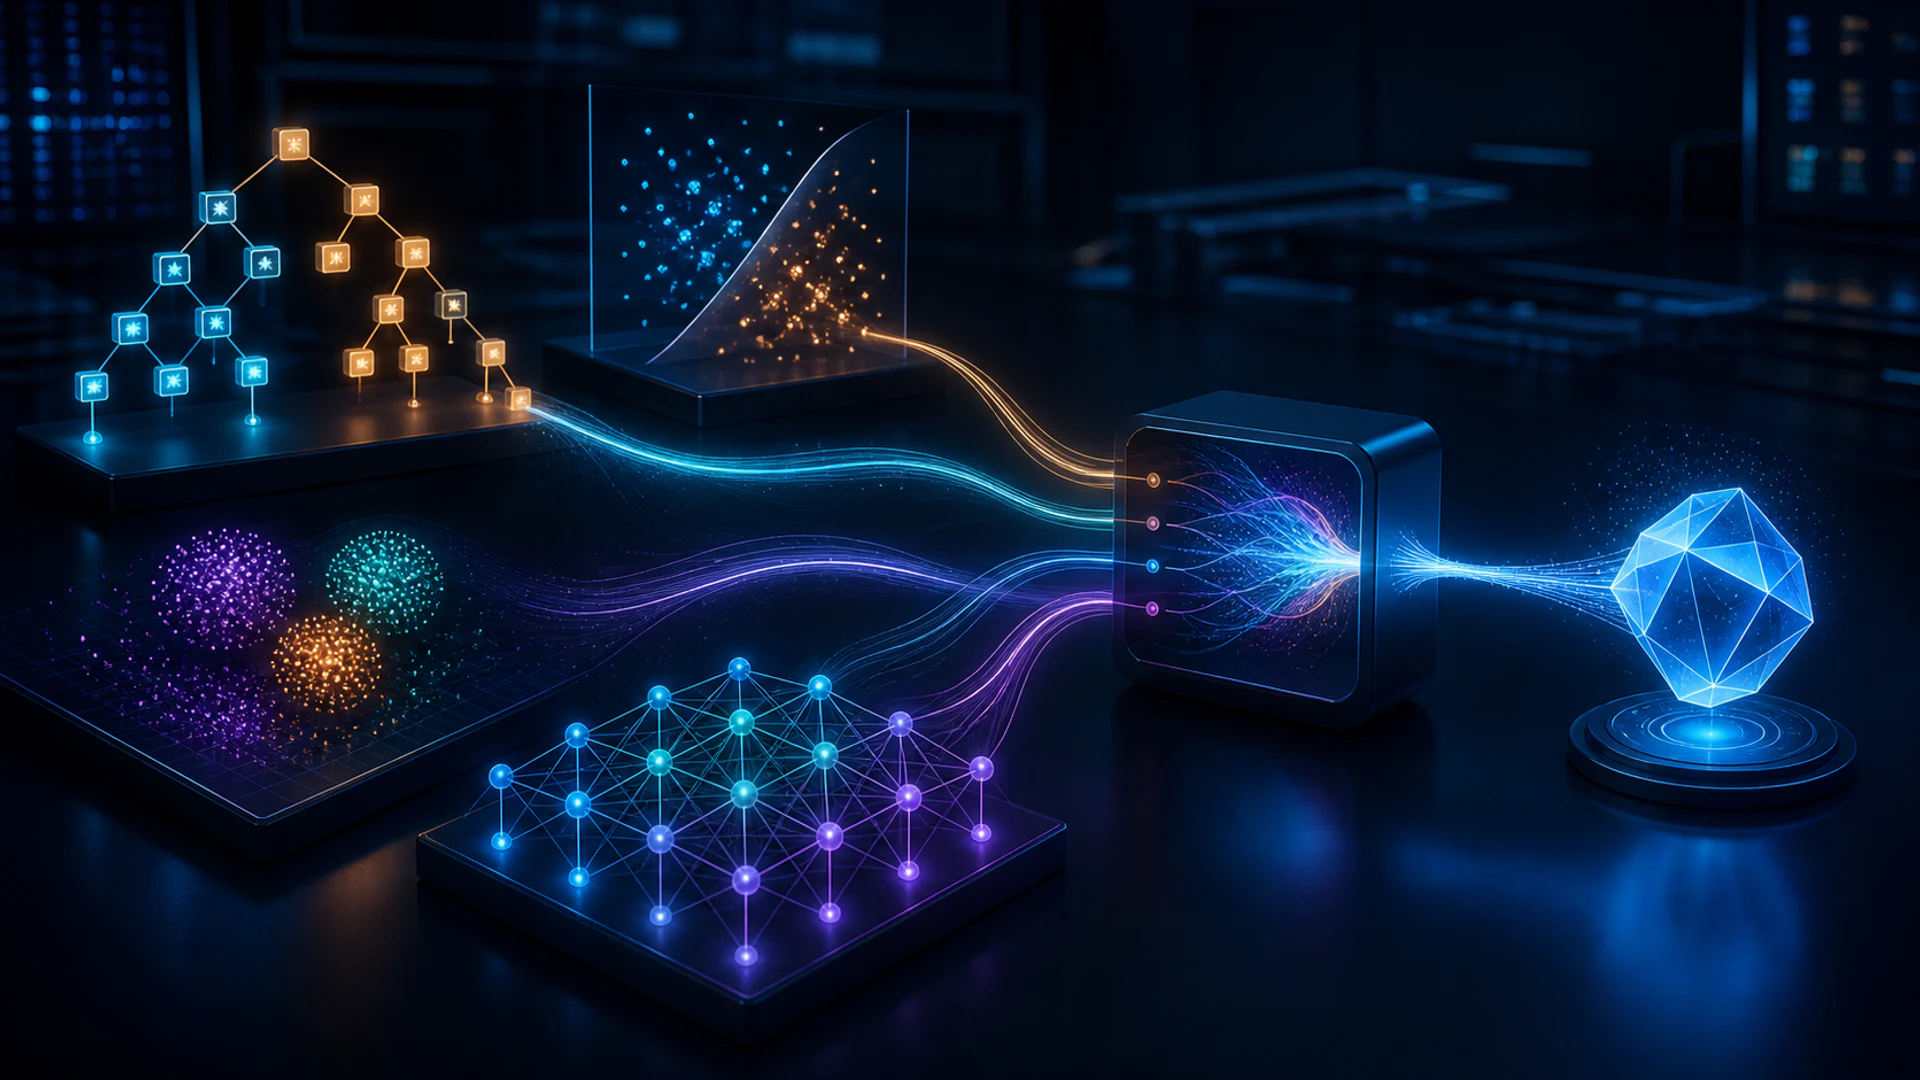
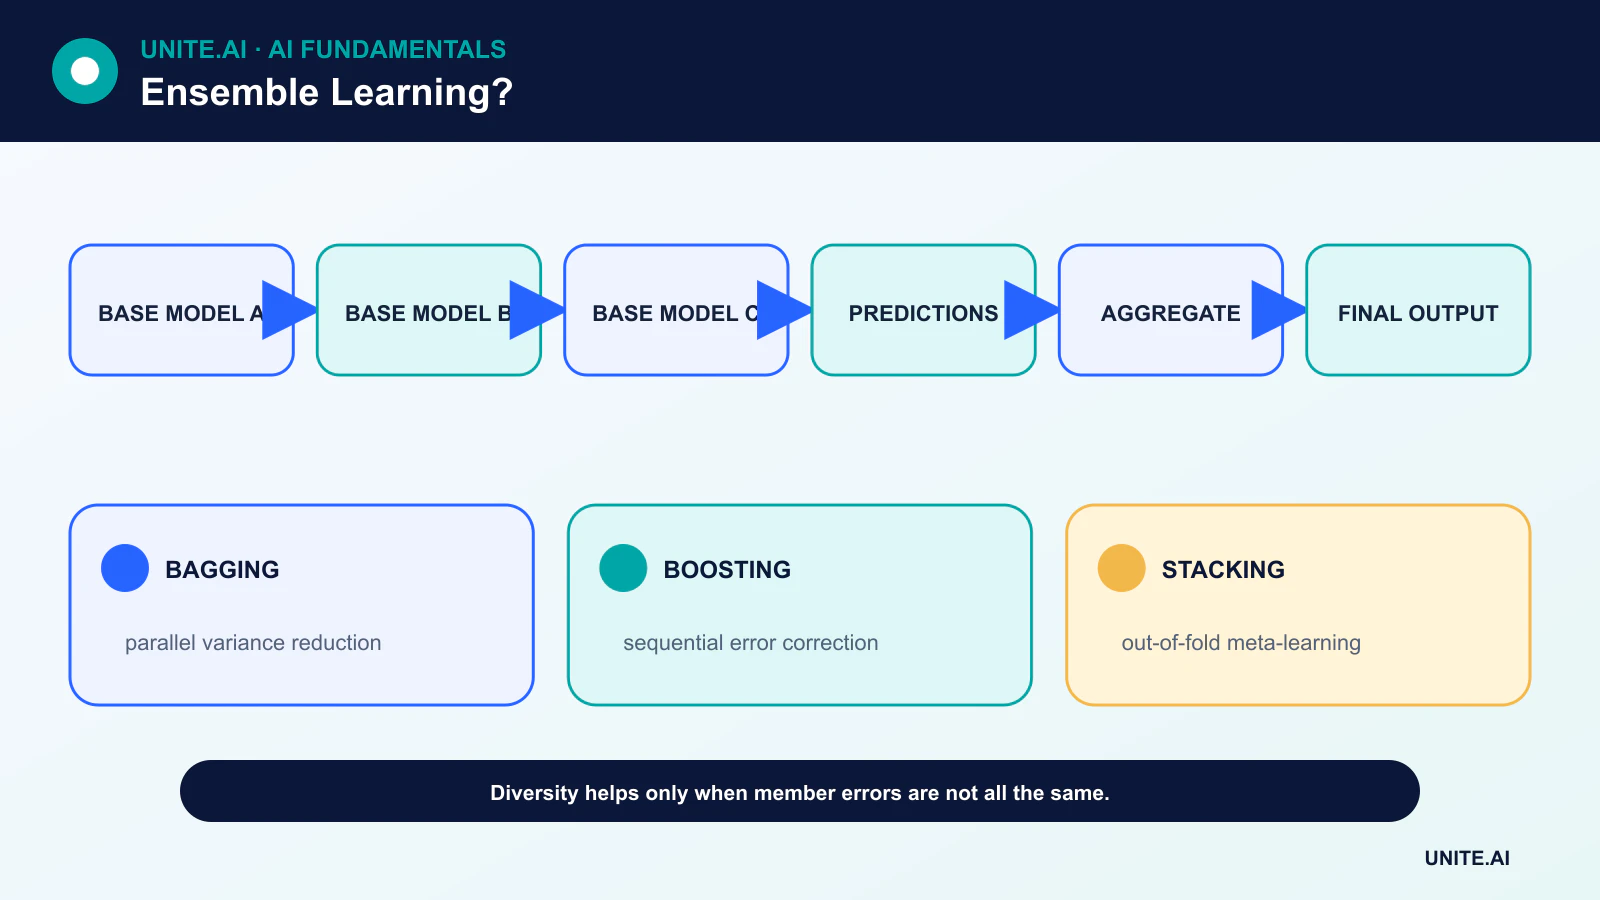
Ensemble learning поєднує прогнози кількох моделей. Основна ідея полягає в тому, що моделі з різними помилками можуть дати більш точний або стабільний результат, коли їхні виходи усереднюються, голосуються або передаються мета‑навчальнику.
Додавання моделей недостатньо. Якщо кожен учасник навчився одному й тому ж скороченню, їхні помилки будуть корельовані, і ансамбль може просто стати впевненішим у тій самій помилці.
Ключові висновки
- Ансамблі працюють найкраще, коли окремі моделі корисні і роблять суттєво різні помилки.
- Bagging навчає учасників паралельно на переобраних даних; boosting навчає їх послідовно, виправляючи помилки.
- Stacking навчає мета‑модель на передбаченнях «з‑поза‑складки», а не на передбаченнях у вибірці.
- Приріст точності треба зважувати проти затримки, калібрування, інтерпретованості та вартості підтримки.
Голосування та усереднення
Жорстке голосування обирає клас з найбільшою кількістю голосів. М’яке голосування усереднює ймовірності класу, зазвичай після калібрування. Регресійні ансамблі часто усереднюють числові прогнози. Зважені варіанти надають більший вплив сильнішим учасникам.
Усереднення може знизити дисперсію, коли помилки не повністю корельовані. Воно не виправляє спільний дефект даних, помилку мітки чи відсутню підгрупу. Різноманітність слід вимірювати через розбіжність та перекриття помилок, а не припускати її лише за різними назвами моделей.
Bagging та випадкові ліси
Bootstrap aggregating навчає моделі на переобраних наборах даних і усереднює їх. Дерево рішень має високу дисперсію, що робить його природним кандидатом для bagging.
Випадкові ліси додають випадковий вибір ознак під час розщеплень, зменшуючи кореляцію між деревами. Приклади out‑of‑bag можуть оцінювати продуктивність, але остаточний незмінний тестовий набір залишається цінним для вибору моделі та підтвердження її готовності до розгортання.
Boosting
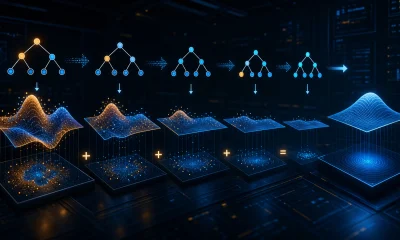
Boosting будує адитивну модель поетапно. Пізніші навчальні алгоритми зосереджуються на прикладах або залишкових патернах, які поточний ансамбль обробляє погано. AdaBoost змінює ваги прикладів; градієнтний бустинг навчає алгоритми на негативних градієнтах обраної функції втрат.
Бустовані дерева можуть моделювати складні табличні взаємозв’язки, проте глибокі дерева, надмірна кількість раундів і витік даних можуть призвести до перепідгонки. Швидкість навчання, глибина дерева, підвибірка та рання зупинка — ключові параметри керування.
Stacking та blending
Stacking створює модель другого рівня, яка навчається комбінувати базові передбачення. Щоб уникнути витоку, кожен рядок навчальних даних для мета‑моделі має походити від базової моделі, яка не навчалась на цьому рядку. Крос‑валідація генерує такі out‑of‑fold передбачення.
Blending використовує окремий hold‑out набір для мета‑моделі, що простіше, але зменшує кількість даних, доступних для навчання. Обидва підходи вимагають однакової передобробки та контролю версій під час інференсу.
Операційні компроміси
Ансамбль може збільшити використання пам’яті, обчислювальних ресурсів та кількість можливих збоїв. Його складніше пояснювати, калібрувати та оновлювати послідовно. Дистиляція може стиснути ансамбль у меншу модель, проте студента треба оцінювати окремо.
Практичний вибір порівнює продуктивність, хвостову затримку, калібрування, використання ресурсів та вартість помилок. Іноді один добре регуляризований модель кращий, ніж незначне підвищення точності від крихкого стеку.
Чому працюють ансамблі
Ансамблеве навчання об’єднує кілька моделей, щоб їхні помилки частково нейтралізувалися або їхні сильні сторони покривали різні області. Bagging навчає моделі на переобраних даних і усереднює передбачення, знижуючи дисперсію; випадкові ліси додають випадковий вибір ознак для декореляції дерев. Boosting навчає алгоритми послідовно, фокусуючись на залишкових помилках, часто знижуючи упередженість, але підвищуючи чутливість до шуму та налаштувань. Stacking навчає мета‑модель на передбаченнях базових моделей. Різноманітність має бути корисною: усереднення ідентичних моделей додає витрати без суттєвого зниження помилки.
Кореляція помилок визначає вигоду. Різноманітність може походити від різних вибірок даних, ознак, алгоритмів, гіперпараметрів, випадкової ініціалізації або часових вікон. Жорстке голосування відкидає впевненість; м’яке голосування усереднює ймовірності, але вимагає сумісної калібрування. Регресія може усереднювати або використовувати стійку агрегацію. У stacking out‑of‑fold передбачення є необхідними — навчання мета‑моделі на передбаченнях з тієї ж підготовленої вибірки створює витік. Спершу використовуйте просту усереднену базу, перш ніж впроваджувати складний комбінатор.
Оцінка, калібрування та невизначеність
Порівнюйте кожного учасника та ансамбль на відкладеній вибірці з ідентичною передобробкою. Подавайте метрики завдання, калібрування, помилки підгруп, дисперсію по фолдах або насінам, а також вартість ресурсів. Ансамбль може підвищити середню якість, приховуючи спільну «сліпу зону», викликану однаковими даними або мітками. Перевіряйте розбіжність: вона може виявити невизначеність, проте корельовані впевнено неправильні моделі можуть погоджуватись. Калібруйте кінцевий ансамбль, а не лише окремих учасників, і валідовуйте пороги відмови щодо можливостей перегляду та наслідків.
Оцінки out‑of‑bag корисні для bagged моделей, проте не замінюють остаточний тест, репрезентативний для розгортання. Для часових даних уникайте переобрання, що порушує порядок. Для безпекових застосувань тестуйте відмову учасників, застарілі моделі та атакувальні входи. Зважені ансамблі можуть перепідгоняти валідаційні дані, коли випробовується багато кандидатів. Фіксуйте вибір кандидатів і використовуйте вкладену валідацію, коли налаштування інтенсивне.
Обслуговування та підтримка
Ансамблі множать використання пам’яті, затримки, енергії та операційних залежностей. Дистиляція може стиснути комбіновану поведінку в одну модель, створюючи нову вимогу до валідації. Версіонуйте учасників, передобробку, ваги та маршрутизацію як один артефакт; визначте поведінку, коли учасник не відповідає або повертає недійсний результат. Моніторьте передбачення учасників та їх розбіжність, щоб «тихі» збої були помітними. Виводьте зайві учасники та навмисно переобучайте. Ансамблі підвищують якість прогнозу, коли різноманітність помилок реальна, але вони не перетворюють упереджені навчальні дані чи недійсну ціль у надійний доказ.
Практичний приклад: ансамбль для сповіщень про суворі погодні умови
Команда прогнозистів поєднує набір фізичних моделей, градієнтне дерево, нейронну послідовну модель та калібровану статистичну базу. Out‑of‑fold передбачення навчають просту мета‑модель, а оцінка використовує майбутні штормові події, повністю виключені з навчання учасників. Метрики включають відгук події, хибні тривоги, час попередження, калібрування, географічну продуктивність та надійність у рідкісних екстремальних умовах. Кореляція помилок учасників аналізується, оскільки спільні вхідні дані можуть створювати спільні «сліпі зони».
Сервіс зберігає кожне передбачення та комбінований результат. Якщо учасник недоступний, система використовує попередньо перевірену деградовану конфігурацію, а не безшумно перенормовує. Розбіжність викликає додатковий перегляд, проте не розглядається як невизначеність у всіх випадках. Моніторинг відстежує дрейф учасників, затримку та результати штормів, ваги оновлюються лише через контрольовану валідацію. Публічні попередження залишаються під уповноваженими метеорологічними процесами; ансамбль підвищує доказову базу, але не змінює політику сповіщень самостійно.
Докази впровадження та готовність до експлуатації
Рішення для продакшну потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, експлуатаційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої відмови. Встановіть відтворювану базу та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректні або відсутні вхідні дані, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які найчастіше залишаються без належного обслуговування. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний ревізор міг відтворити результат і розрізнити доказ від привабливого прототипу.
Перед запуском призначте відповідальність за реліз, виключення, зміни, відкат та виведення з експлуатації. Використовуйте поетапне розгортання, зберігайте безпечний резерв і перевірте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має показувати якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих чутливих даних. Визначте пороги тривог та відповідального за реакцію, а потім переглядайте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Frequently asked questions
Is a random forest an ensemble?
Yes. It combines many randomized decision trees, usually by voting or averaging.
Can identical models form a useful ensemble?
They can if training data, initialization or sampling creates sufficiently different errors, but mere duplication adds no benefit.
Primary references