Основи ШІ
Що таке зменшення розмірності?

 Додайте Unite.AI до бажаних джерел у Google
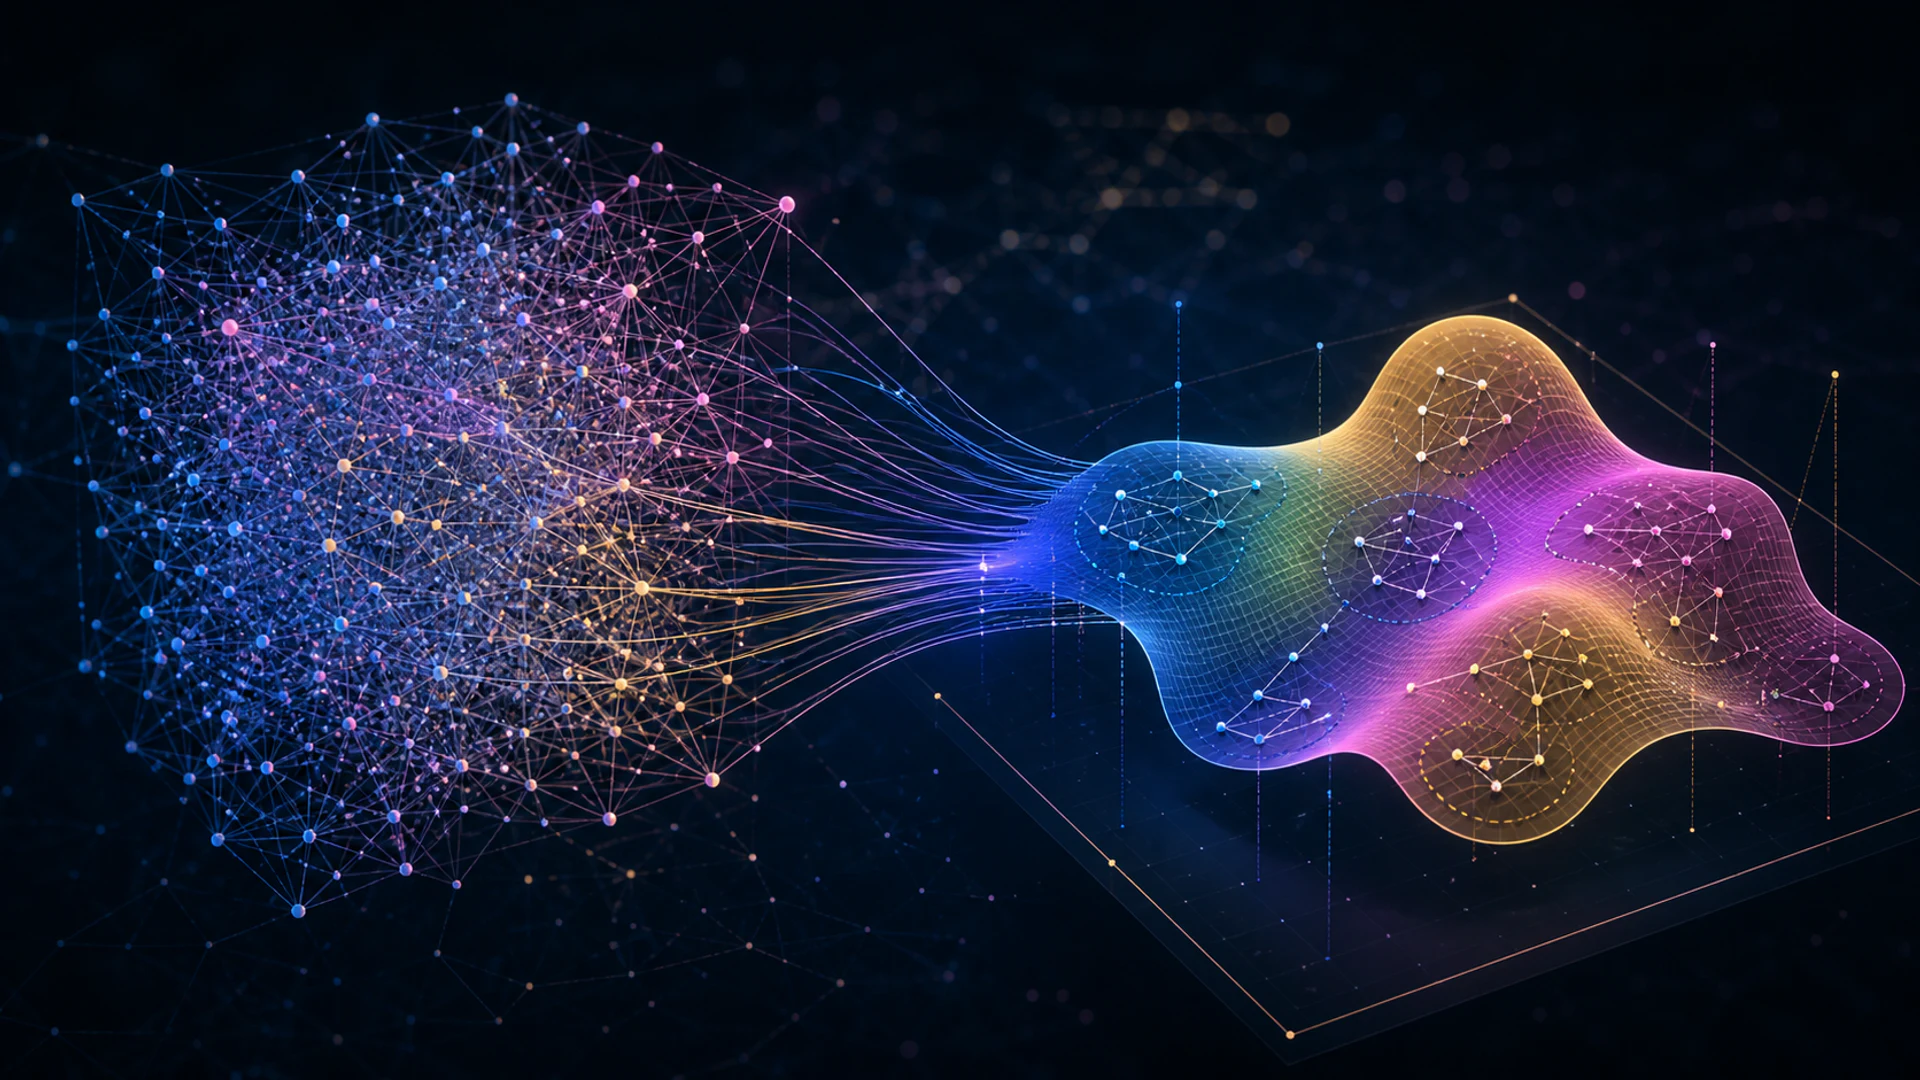
Зменшення розмірності представляє дані з меншою кількістю змінних, зберігаючи інформацію, корисну для завдання. Воно може зменшити обсяг сховища та шум, покращити візуалізацію, усунути надмірні ознаки та спростити навчання подальших моделей.
Жоден метод не зберігає всі взаємозв’язки. Корисне зменшення починається з визначення того, що має залишитися: дисперсія, розділення класів, локальні околиці, глобальна геометрія, якість відновлення або інтерпретованість.
Ключові висновки
- Вибір ознак зберігає початкові змінні; видобуток ознак створює нові координати нижчої розмірності.
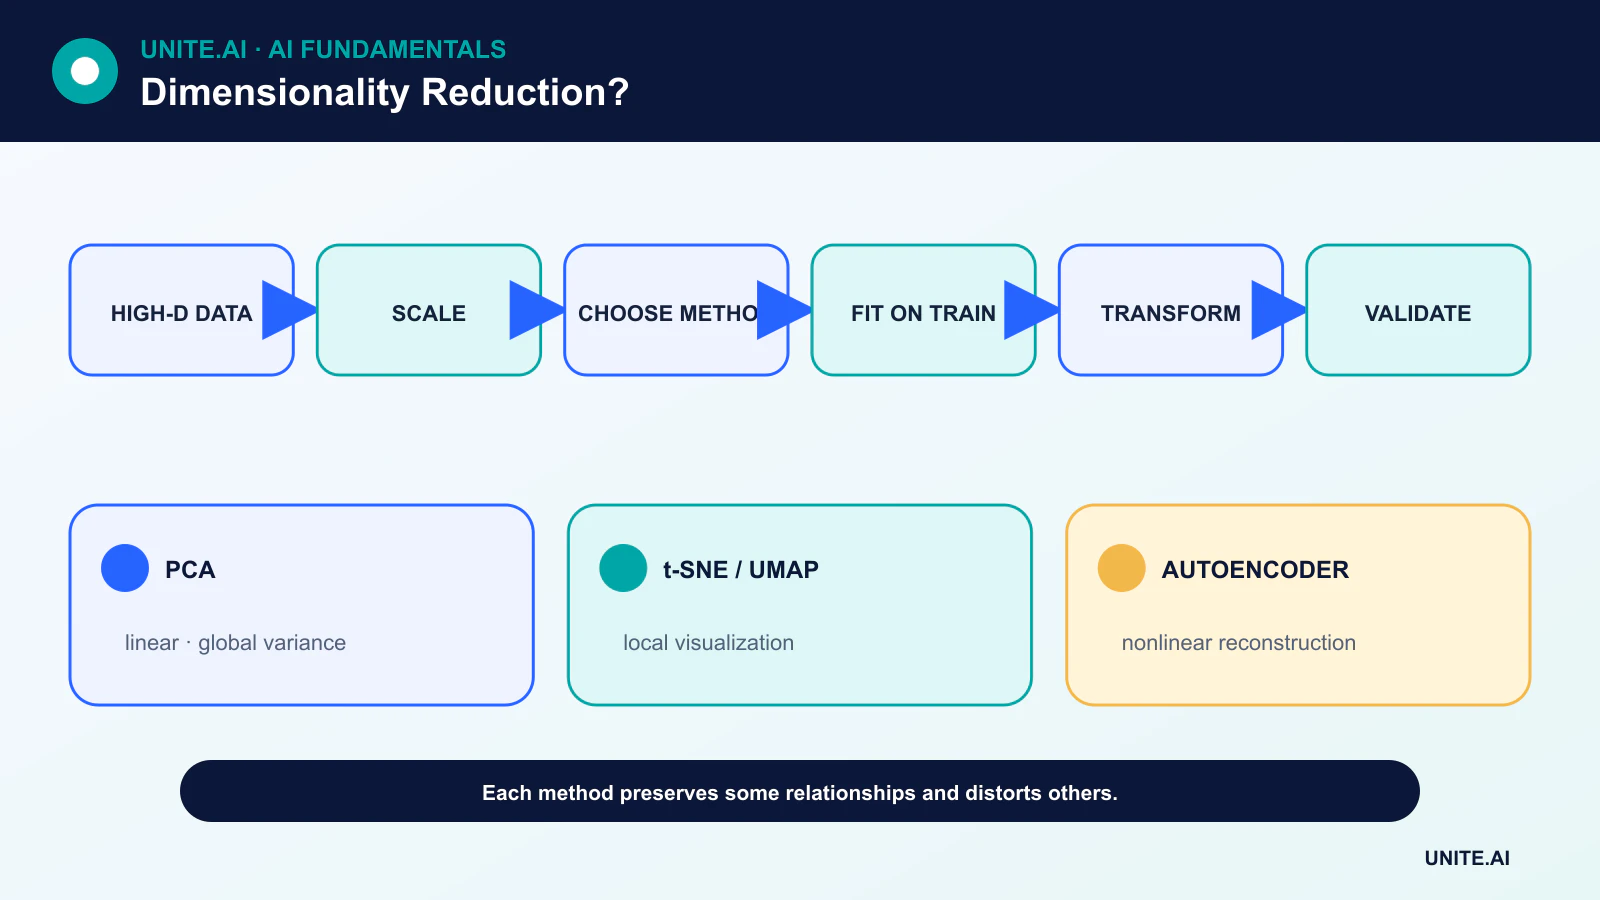
- PCA є лінійним і орієнтованим на дисперсію; t-SNE і UMAP підкреслюють структуру околиць для візуалізації.
- Візуалізаційні вбудовування можуть спотворювати відстані, розміри кластерів та глобальне розділення.
- Навчайте зменшення лише на навчальних даних, а потім застосовуйте отримане перетворення до валідаційних та тестових даних.
Вибір ознак проти проекції
Вибір ознак видаляє змінні, використовуючи доменні правила, пропуски, надмірність, предиктивні тести або регуляризацію. Він зберігає первинне значення, що може допомогти у керуванні та поясненні.
Методи проекції комбінують змінні у нові координати. Вони можуть захоплювати розподілену структуру, але кожна координата може бути важчою для інтерпретації. Автокодер навчає нелінійну проекцію через відновлення.
PCA та SVD
Аналіз головних компонент (PCA) визначає ортогональні напрямки зі спадною дисперсією після центрирування даних. Сингулярний розклад (SVD) забезпечує загальний числовий шлях. Масштабування важливе: одиниця вимірювання з високою дисперсією може домінувати над компонентами.
PCA детермінований, за винятком знаку та повторюваних власних значень, підтримує трансформацію поза вибіркою та надає підсумки поясненої дисперсії. Висока дисперсія не завжди релевантна до завдання, і лінійні компоненти не можуть розгорнути кожну вигнуту багатовимірну поверхню.
t-SNE та UMAP
t-SNE створює ймовірнісні розподіли над сусідами та оптимізує низьковимірну карту, що підкреслює локальну схожість. UMAP будує зважений граф околиць і оптимізує нижчовимірне представлення з урахуванням цілей локальної структури.
Обидва є потужними інструментами дослідження, проте чутливі до попередньої обробки, метрики відстані та гіперпараметрів. Порожній простір, площа кластера та відстань між кластерами у 2‑вимірному графіку не повинні автоматично трактуватись як реальні значення.
Контрольовані методи та представлення, орієнтовані на завдання
Лінійний дискримінантний аналіз (LDA) використовує мітки класів для пошуку розділення, що відрізняє його від неконтрольованого PCA. Навчання нейронних представлень може оптимізувати предиктивні або контрастивні цілі замість відновлення.
Якщо мітки керують зменшенням, усі процеси навчання та налаштування мають залишатися в межах навчального процесу. Інакше інформація з тестового набору може потрапити у вибір моделі та створити надто оптимістичний результат.
Вибір та валідація методу
Почніть з попередньої обробки та простого базового підходу. Для стиснення вимірюйте відновлення або продуктивність подальших моделей у різних розмірностях. Для візуалізації тестуйте стабільність за різних ініціалізацій та гіперпараметрів і порівнюйте збереження околиць з доменною експертизою.
Для виробництва запитайте, чи може метод трансформувати нові записи, як він обробляє пропущені значення, чи змінюється при перенавчанні та чи потрібні користувачам пояснення оригінальних ознак. Переобучення може виникнути на етапі зменшення так само, як і в кінцевій моделі.
Лінійні та нелінійні методи зменшення
Зменшення розмірності відображає дані високої розмірності у меншу кількість координат, зберігаючи вибрану структуру. Аналіз головних компонент знаходить ортогональні напрямки максимальної дисперсії після центрирування; потрібне масштабування, коли одиниці вимірювання мають вносити порівнянний внесок. Сингулярний розклад обчислює пов’язану низькорангову структуру та підтримує розріджені матриці. Лінійний дискримінантний аналіз використовує мітки для пошуку напрямків, що розділяють класи. Ці методи дають явні перетворення, проте дисперсія чи розділення класів можуть не зберігати інформацію, необхідну для подальшого завдання.
Методи багатовимірних поверхонь, такі як t-SNE та UMAP, створюють околиці та оптимізують низьковимірне розташування. Вони потужні для дослідження, проте спотворюють глобальну відстань, густину, розмір кластеру та іноді розділення. Результати залежать від попередньої обробки, метрики, кількості сусідів або perplexity, ініціалізації та випадковості. Привабливий кластер у двох вимірах може виникнути навіть без дискретних груп. Використовуйте кілька налаштувань, розфарбовуйте лише за метаданими, які не використовувалися під час навчання, і валідуйте очевидну структуру у вихідному просторі або за допомогою незалежних міток.
Вибір ознак, вбудовування та оцінка
Вибір ознак зберігає початкові змінні за допомогою фільтрів, обгорток або важливості, заснованої на моделі; навчання представлень створює нові латентні ознаки за допомогою автокодерів або контрольованих моделей. Випадкові проекції приблизно зберігають відстані за певних умов і пропонують ефективні базові лінії. Обирайте метод, орієнтуючись на стиснення, візуалізацію, зменшення шуму, швидкість, сховище або продуктивність моделі. Навчайте зменшувач лише на навчальних даних, а потім трансформуйте валідаційні та тестові набори. Контрольоване зменшення має бути вбудованим у крос‑валідацію, щоб уникнути витоку міток.
Оцінюйте пояснену дисперсію або відновлення для лінійного стиснення, довірливість та збереження околиць для візуалізації, а також точність, калібрування, затримку та стійкість у подальшому передбаченні. Вимірюйте стабільність за різних вибірок та випадкових ініціалізацій. Перевірте, чи рідкі класи або чутливі групи не зведені в один та чи можливо зворотне відображення. Зменшені координати можуть все ще містити приватну інформацію; двовимірний графік не є анонімізацією. Документуйте перетворення, масштабатор, порядок ознак та обмеження.
Використання у виробництві
Обслуговування вимагає точного навченого перетворення та схеми вхідних даних. Слідкуйте за відсутніми ознаками, зсувом діапазону, розподілом оцінок компонент, помилкою відновлення та підсумковими результатами. Якщо з’являються нові категорії або датчики, переобучайте та версіонуйте весь конвеєр, а не тихо додавайте стовпці. Зменшення може підвищити обчислювальну ефективність та зменшити шум моделі, але також може відкинути слабкі сигнали, важливі для рідкісних подій. Ставте це за крок вимірювання, який навчається, і його збережена та втрачені дані мають бути перевірені щодо прийняття рішення.
Практичний приклад: зменшення ознак поведінки клієнтів
Аналітик стандартизує 200 поведінкових показників і навчає PCA лише на навчальних клієнтах. Крос‑валідація обирає кількість компонент за продуктивністю щодо відтоку клієнтів та стабільністю, а не за двовимірним діаграмою розсіювання. Завантаження (loadings) перевіряються на домінуючі джерела та пропуски. PCA, вибір ознак, випадкова проекція та незменшена регуляризована модель порівнюються за калібруванням, затримкою та результатами для рідкісних сегментів клієнтів. Повторювані вибірки також тестують, чи залишаються провідні компоненти та підсумкові висновки стабільними.
Розгорнутий конвеєр фіксує порядок ознак, масштабатор та компоненти і відхиляє відсутні версії схеми. Моніторинг відстежує розподіл компонент, помилку відновлення та підсумкові результати. Візуалізація з очевидними кластерами використовується для формування питань, а не для призначення персон клієнтів. Оскільки латентні компоненти все ще кодують поведінку, доступ і утримання залишаються під контролем. Якщо визначення джерела змінюються, повне перетворення та модель перебудовуються та валідуються, а не проєктуються несумісні дані у старі компоненти.
Докази впровадження та готовність до експлуатації
Рішення щодо впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відмову залежностей, неправильне використання та групи чи середовища, які, ймовірно, залишаться без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Зафіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно внесених збоїв. Операційна телеметрія повинна розкривати якість вводу, поведінку виводу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних чутливих даних. Визначте пороги тривоги та відповідального за реакцію, а потім перегляньте реальні докази після впровадження, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткої точки, коли її слід вимкнути або замінити.
Часто задавані питання
Чи завжди зменшення розмірності покращує модель?
Ні. Воно може відкинути предиктивну інформацію або ускладнити інтерпретацію. Порівнюйте зі стандартом без зменшення на відкладених даних.
Чи доводять розділені кластери t-SNE існування реальних класів?
Ні. Карта — це оптимізована візуалізація взаємозв’язків околиць і може створювати видиме розділення. Перевіряйте кластери за допомогою незалежних доказів.
Основні джерела