
Основи ШІ
Що таке генеративна змагальна мережа (GAN)?

 Додайте Unite.AI до бажаних джерел у Google
A генеративна змагальна мережа (GAN) навчає дві нейронні мережі у конкуренції. Генератор перетворює випадковий або умовний вхід у синтетичні зразки. Дискримінатор намагається розрізнити згенеровані зразки від реальних навчальних прикладів. Зворотний зв’язок кожної мережі змінює навчальну задачу іншої.
GAN можуть створювати чіткі зображення та контрольовані синтетичні дані, проте змагальне навчання важко стабілізувати. Візуальна реалістичність не є доказом різноманітності, фактичної достовірності чи дозволу на використання навчальних даних.
Ключові висновки
- Генератор створює зразки; дискримінатор навчається розпізнавати сигнал реального проти згенерованого.
- Навчання прагне до рівноваги, проте зміна супротивників може спричиняти нестабільність, осциляції або колапс режиму.
- Умовні GAN керують генерацією за допомогою міток, тексту чи іншого контексту.
- Оцінка має перевіряти достовірність, охоплення, запам’ятовування та ризики у подальшому використанні — а не лише якість зображень.
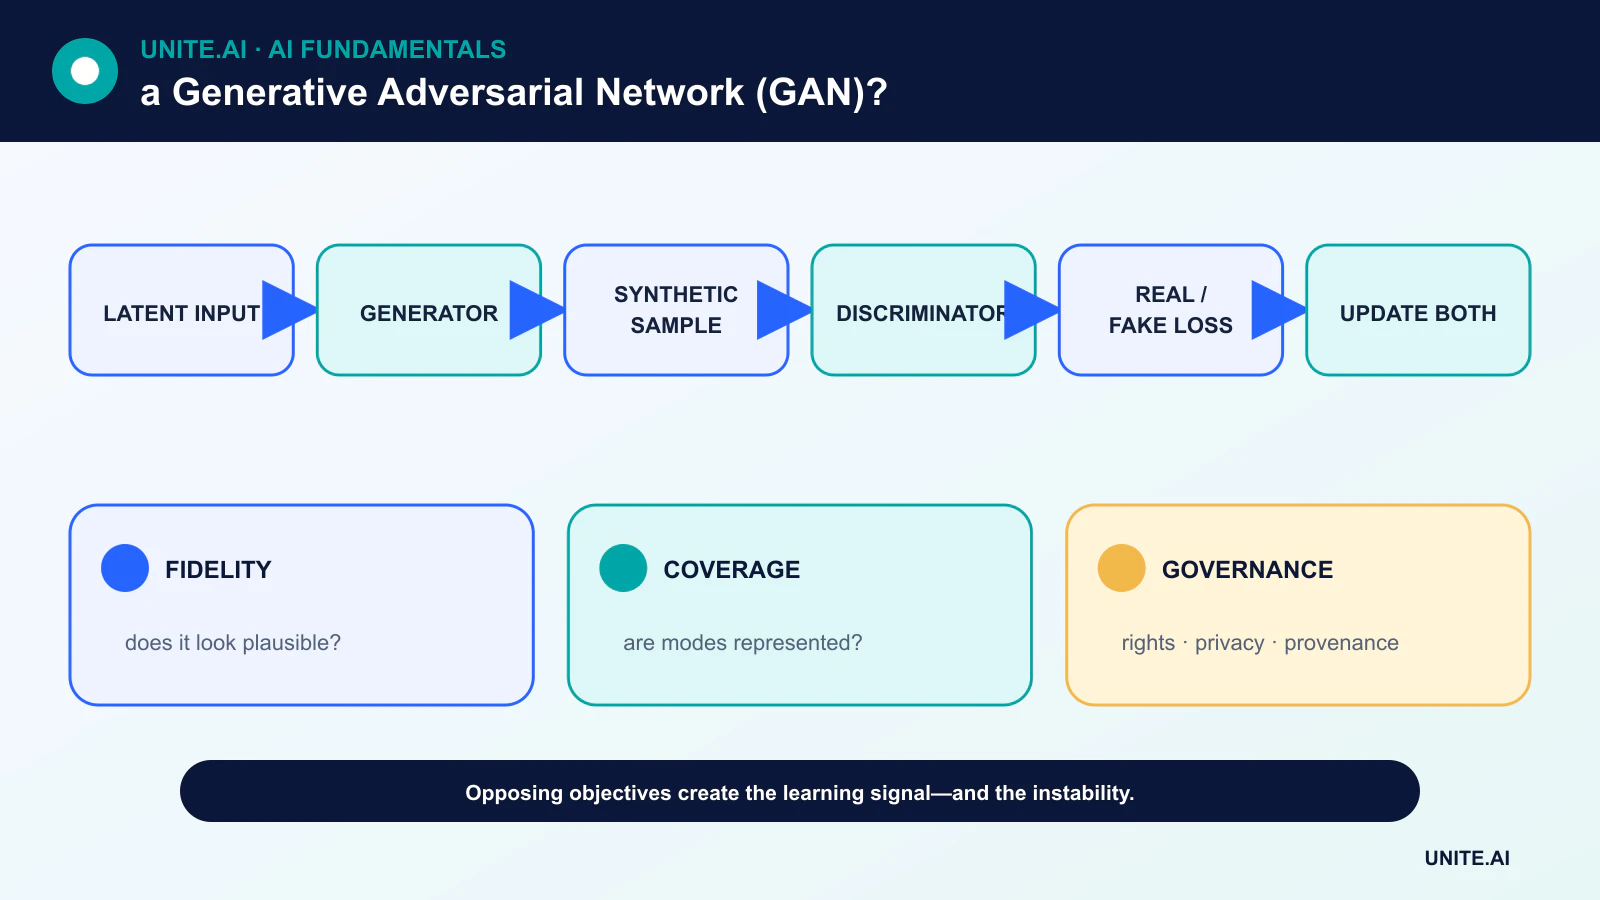
Змагальна гра
Початкова формулювання — це двоосібна мінімакс‑гра. Дискримінатор покращує розрізнення реальних даних від згенерованих, тоді як генератор удосконалює створення зразків, які дискримінатор класифікує як реальні. Обидві мережі навчаються за допомогою зворотного поширення.
Якщо дискримінатор стає надто точним, його зворотний зв’язок до генератора може бути не корисним. Якщо він надто слабкий, генератор може скористатися простими ухилами. Тому навчання чергує оновлення та ретельно балансувує потужність, втрати та налаштування оптимізації.
Колапс режиму та стабільність навчання
Колапс режиму виникає, коли багато латентних входів дають схожі виходи, тож зразки виглядають правдоподібними, але охоплюють лише частину розподілу даних. Інші збої включають осциляції, вибухові градієнти та чутливість до випадкової ініціалізації.
Цілі Вассерштейна, штрафи за градієнти, спектральна нормалізація, зміни архітектури та налаштовані коефіцієнти оновлень можуть підвищити стабільність. Однак вони не усувають потребу перевіряти різноманітність та повторювати експерименти з кількома випадковими зернами.
Умовна генерація та латентний контроль
Умовна GAN надає генератору та дискримінатору мітку або інший контекст, що дозволяє цілеспрямовано генерувати класи чи атрибути. Архітектури на основі стилю розділяють аспекти латентного контролю на різних роздільних здатностях і створювали надзвичайно реалістичні зображення.
Латентні напрямки можуть корелювати з людськими поняттями, проте редагування однієї властивості може змінювати інші, оскільки навчальні дані містять корельовані ознаки. Твердження про контрольованість слід перевіряти на різноманітних ідентичностях та контекстах.
Оцінка, конфіденційність та походження
Метрики, такі як Fréchet Inception Distance, порівнюють розподіли ознак, проте вони успадковують припущення моделі ознак і можуть не виявляти запам’ятовування чи збої підгруп. Аналіз найближчих сусідів, тести охоплення у стилі precision/recall та людська експертиза надають додаткові докази.
GAN може запам’ятовувати рідкісні приклади, відтворювати упередження або створювати оманливі медіа. Команди мають документувати набори даних, права, фільтрацію, водяні знаки або механізми походження та контролю зловживань. Синтетичні дані не є автоматично анонімними.
GAN, VAE та дифузійні моделі
Варіаційні автокодери оптимізують латентну ціль, засновану на правдоподібності, і часто жертвують різкістю зразків заради структурованого латентного простору. Дифузійні моделі навчаються інвертувати процес шумування і стали поширеною основою для генерації зображень.
GAN залишаються корисними, коли важливі швидке однопрохідне семплювання, специфічні перетворення зображення в зображення або компактне розгортання. Правильний метод залежить від якості, різноманітності, затримки, стабільності навчання та управління — а не від того, яка архітектура найновіша.
Змагальні цілі та динаміка навчання
Генеративна змагальна мережа навчає генератор створювати зразки, а дискримінатор розрізняти згенеровані дані від реальних. У оригінальній мінімакс‑грі дискримінатор оцінює сигнал, пов’язаний з відношенням щільностей, а генератор намагається його обдурити. Навчання чергує оновлення, тому кожна мережа навчається проти рухомого супротивника, а не фіксованої втрати. Якщо дискримінатор стає надто сильним, градієнти генератора можуть стати не корисними; якщо надто слабким, якість згенерованих зразків застоює. Саме значення втрати не відповідає безпосередньо якості зразка.
Колапс режиму виникає, коли генератор створює обмежений спектр варіантів, які обманюють дискримінатор. Осциляції, чутливість до гіперпараметрів та нестабільна нормалізація також поширені. Цілі Вассерштейна, штрафи за градієнти, спектральна нормалізація, збіг ознак, статистика мінібатчів та ретельно збалансовані графіки оновлень вирішують різні механізми збоїв. Умовні GAN використовують мітки, текст або зображення для керування виходом; архітектури на основі стилю розділяють латентний вплив. Якість та охоплення набору даних залишаються фундаментальними, оскільки генератор відтворює і перебудовує розподіл, який він бачить.
Оцінка та відповідальне використання
Оцінюйте достовірність та різноманітність окремо. Fréchet Inception Distance порівнює розподіли ознак, але залежить від розміру вибірки, моделі ознак, попередньої обробки та домену; Inception Score не включає порівняння з реальними даними. Точність і повнота для генеративних моделей, аналіз найближчих сусідів, перевірки запам’ятовування та оцінка завдань людьми додають докази. Для наукового чи медичного синтезу використовуйте доменні метрики та подальшу валідацію. Зберігайте відкладений реальний набір і порівнюйте з дифузійними або автокореляційними базовими моделями при однакових обчислювальних ресурсах і роздільній здатності.
GAN можуть доповнювати дані, переводити домени, підвищувати роздільну здатність зображень, синтезувати медіа та підтримувати симуляції, проте синтетичні дані можуть посилювати упередження або витікати навчальні приклади. Перевіряйте ліцензування, згоду, ідентичність та походження. Захищайтеся від нелегального імітування та оманливого використання, позначайте або підписуйте вихідні дані за потреби та зберігайте метадані генерації. Фотореалістне зображення не є документальним доказом; невизначеність і синтетичне походження мають залишатися помітними, коли результати впливають на рішення.
Розгортання та відтворюваність
Фіксуйте генератор, дискримінатор, оптимізатор, набір даних, випадкове зерно, параметр обрізання та налаштування семплювання. Квантування або експорт можуть змінити нормалізацію та вихід, тому валідуйте артефакт сервісу. Слідкуйте за розподілом підказок або умов, безпековими фільтрами, різноманітністю виходів, затримкою та звітами. Використовуйте обмеження швидкості та захист ідентичності у публічних системах. Навчання GAN — це взаємопов’язаний експеримент оптимізації: вибрані демонстраційні зображення не можуть підтвердити стійкість, охоплення чи відсутність запам’ятовування, і модель слід оцінювати за повним розподілом запланованих завдань генерації.
Практичний приклад: синтетичні зображення дефектів за допомогою GAN
Виробник навчає умовну GAN створювати рідкісні зображення поверхневих дефектів. Він перевіряє, що навчальні зображення мають права, та розділяє виробничі партії перед навчанням і оцінкою. Згенеровані зразки перевіряються на запам’ятовування найближчих сусідів, геометрію дефекту, артефакти фону, різноманітність та експертну правдоподібність. Класифікатор, навчений з синтетичним збільшенням, оцінюється лише на незалежних реальних дефектах, у порівнянні з тим же класифікатором, навчений традиційним збільшенням.
Синтетичні дані приймаються лише за умови, що реальний recall покращується без збільшення хибних відхилень або помилок підгруп. Налаштування генерації та походження залишаються прив’язаними до кожного зображення, і синтетичні файли ніколи не потрапляють у тестовий набір чи архів доказів як реальні інспекції. Оператори не можуть використовувати генератор для підробки аудиторських записів. Команда порівнює дифузійні альтернативи та вартість збору більшої кількості реальних прикладів, усвідомлюючи, що реалістичний вигляд не доводить, що GAN захопив фізичний процес відмови.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які можуть залишитися без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходів, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги тривог та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткої точки, коли її слід вимкнути або замінити.
Часто задавані питання
Чи розуміє GAN зображення, які він створює?
GAN вивчає статистичну структуру, корисну для генерації. Це саме по собі не встановлює семантичне чи причинно‑наслідкове розуміння, подібне до людського.
Чи безпечно використовувати згенеровані GAN зразки як навчальні дані?
Лише після перевірки охоплення, коректності міток, запам’ятовування, упереджень та того, чи синтетичний розподіл допомагає на реальному відкладеному тестовому наборі.
Основні джерела












